Command Palette
Search for a command to run...
PaperScorer:论文录用结果有多可预测?
PaperScorer:论文录用结果有多可预测?
Sachin Konan Jonathan Liu Zhuang Liu
摘要
自动化研究在很大程度上通过基准性能来评估,但研究的价值很少能归结为单一分数。人类通过同行评审来判断一项工作的整体贡献,而这一过程很难建模,因为它噪声较大且依赖许多因素。然而,如果仅凭论文本身,我们能否直接预测其同行评审决定?我们提出了 PaperScorer,这是一个模型系列,可根据论文的提取文本或页面截图预测其录用或拒稿决定;模型在去除作者身份和排版捷径后,仅以录用或拒稿决定作为训练目标。视觉模型最具预测能力(在 ICLR 论文上准确率为 68%,在 arXiv 的机器学习论文上为 77%),优于纯文本模型和前沿推理模型。与纯文本不同,页面图像保留了图表、版式和呈现方式。这一信号相当稳健,在较小模型上仍然存在,甚至将整篇论文压缩为单张图像后依然有效。但准确预测的分布并不均匀。PaperScorer 在评分最低和最高的论文上表现最强,而评分居中的论文对我们的模型和前沿系统而言都难以预测。此外,其置信度经过校准,因此置信度最高的预测也最准确。总体而言,PaperScorer 展示了论文本身在多大程度上承载了录用决定,标志着迈向 AI 驱动研究评估的第一步。
一句话总结
普林斯顿大学的研究人员提出了 PaperScorer,这是一个模型家族,在移除作者身份和格式捷径后,从提取文本或页面截图中预测论文接受或拒绝决定;视觉模型在 ICLR 论文上达到 68% 准确率,在 arXiv 机器学习论文上达到 77% 准确率,校准后的置信度在评分最低和最高的论文上最强,标志着向 AI 驱动的研究评估迈出了第一步。
核心贡献
- 本文介绍了 PaperScorer,这是一个文本和视觉模型家族,直接从提取文本或页面截图中预测论文的最终接受或拒绝决定,使用的数据集标签只能从论文内容中恢复。基于视觉的 PaperScorer 模型在 ICLR 论文上达到 68% 准确率,在 arXiv 机器学习论文上达到 77% 准确率,优于纯文本和前沿推理基线。
- 本文表明页面截图比纯文本提供更强的决定信号,因为截图保留了布局、图表和展示线索,这一信号在较小模型下以及在整篇论文被压缩为单张图像时仍然稳健。预测在评分最低和最高的论文上最为准确,模型置信度经过校准。
- 本文展示了 PaperScorer 作为科学工作流中的校准接受概率先验:将 PaperScorer-Vision 与稠密检索结合,在 LitSearch 基准上将前 10 引用召回率提高了 8.7%,以该先验为条件的 agentic 评审器将决定准确率从 63.0% 提高到 70.6%。
引言
大型语言模型 agents 日益自动化端到端研究,因此评估必须超越基准并反映人类同行评审。然而同行评审具有噪声且理解不足:一致性实验表明委员会经常持有不同意见,LLM 辅助评审还会增加更多变异。先前预测论文结果的工作经常通过格式、作者识别文本、来源痕迹或多数类别捷径来泄露标签,而不是仅隔离论文自身内容。作者通过提出 PaperScorer 来解决这一问题,这是一个在完全匿名、平衡的 ICLR 和 arXiv 论文上训练的文本和视觉模型家族,仅从论文内容预测最终接受或拒绝决定。其主要贡献是证明文档包含可恢复但有限的决策信号,最佳视觉模型在 ICLR 上达到 68% 准确率,在 arXiv 上达到 77% 准确率,优于前沿基线并产生校准的接受概率。
数据集
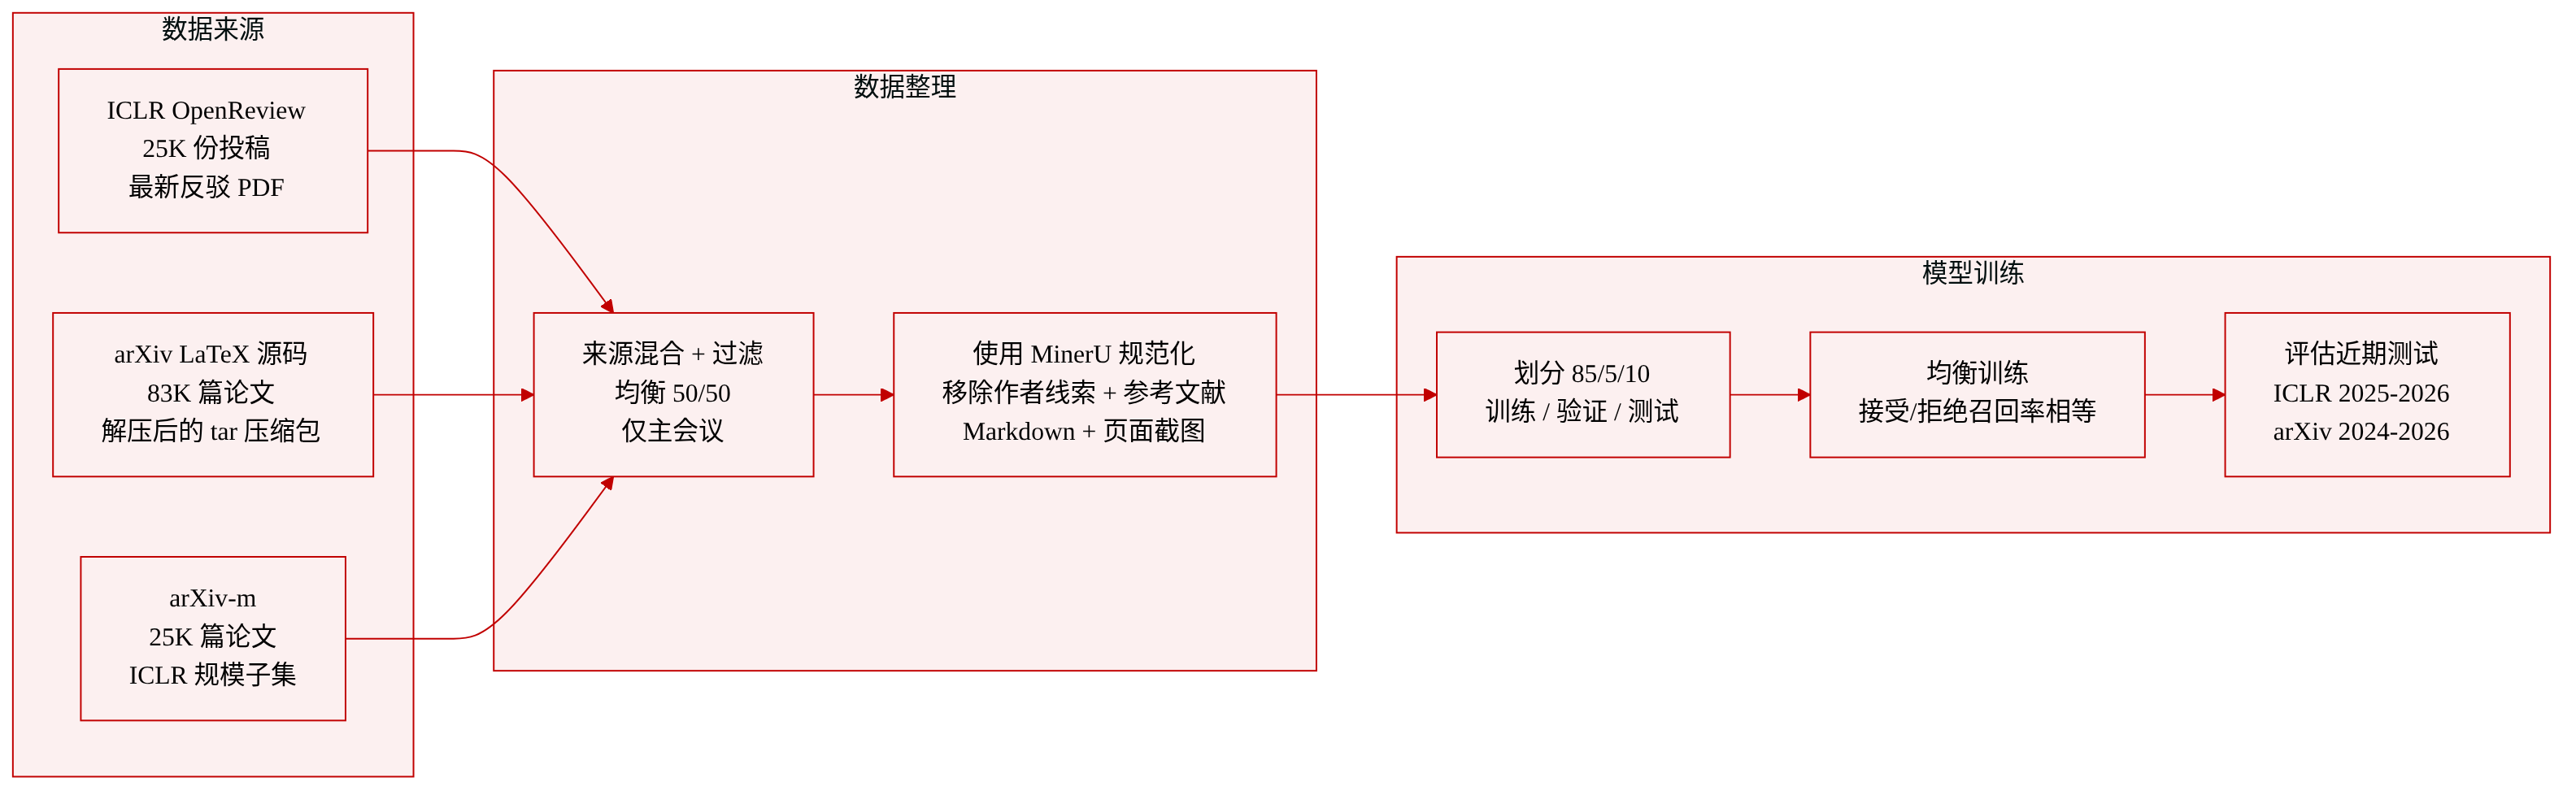
作者描述了用于 PaperScorer 的两个平衡的接受/拒绝数据集。每个数据集将匿名 Markdown 文本与页面截图和接受/拒绝标签配对。
数据集组成与来源
- ICLR:来自 OpenReview 的 25K 份投稿,50/50 平衡,按 85/5/10 划分,在 ICLR 2025-2026 上评估。
- arXiv:从 LaTeX 源码衍生的会议论文集论文,50/50 平衡,按 85/5/10 划分,在 2024-2026 上评估,以包含 ECCV 等双年度会议。
- arXiv 训练使用一个 83K 集合(arXiv)和一个按 ICLR 比例缩小的 25K 集合(arXiv-m)。
ICLR 子集
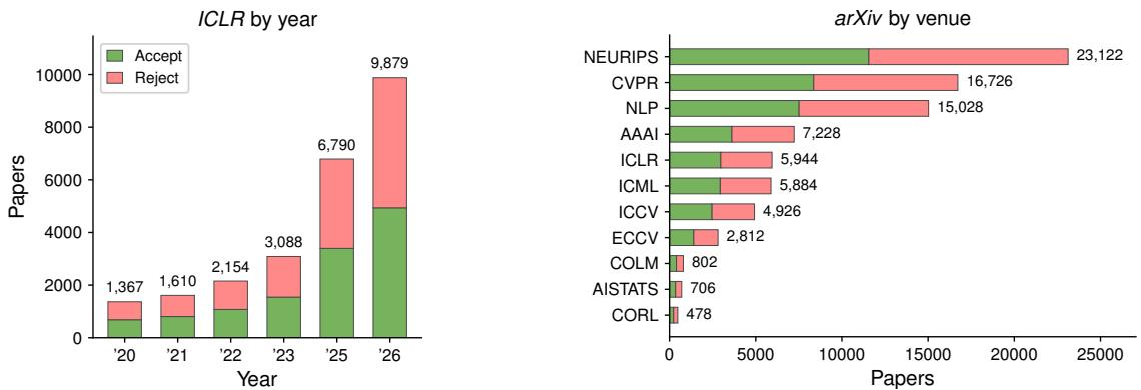
- 使用 ICLR 2020-2023、2025 和 2026;ICLR 2024 被排除,因为接受的论文只有 camera-ready 版本。
- 使用最新反驳 PDF 作为匿名化产物。
- 过滤要求匿名性、主会场范围以及对接受和拒绝论文的一致处理;拒绝论文在每个年度内进行二次采样以保持平衡,同时保留年度分布。
arXiv 子集
- 从 434,579 篇机器学习 arXiv 论文开始;使用 NeMo Curator 提取 434,443 个 LaTeX 源码压缩包。
- 接受标签来自与会议论文集的标题匹配。
- 隐含拒绝是指使用所覆盖会议模板、通过主会场过滤但未出现在论文集中的可编译 LaTeX 论文。
- 过滤移除非主会场、研讨会、已撤回、工业赛道和短格式论文;要求匿名渲染、参考文献部分以及 6 到 30 页主内容。
- 101,659 篇过滤后论文被二次采样为 83,656 篇平衡论文,保留起始会议分布而非按年份平衡。
处理与输入模式
- 两个来源使用相同的 MinerU 规范化,并移除页眉、行号旁注、作者识别片段及参考文献中或之后的内容。
- 文本输入使用省略排除区域的 Markdown,最大上下文长度为 24,480。
- 视觉输入使用页面截图,相同排除区域被涂白;每页降采样至最多 1,003,520 像素,每页约 1,240 个视觉 tokens。
- 典型论文约 10 页,最多 33 页,因此视觉输入平均约 12,420 个 tokens。
训练与评估中的使用
- 训练使用 50/50 平衡划分,使接受和拒绝召回率获得同等权重,模型不会默认过度预测拒绝。
- 评估使用最近的测试年份:ICLR 2025-2026 和 arXiv 2024-2026。
- arXiv 也用于迁移实验:在 arXiv 内部评估多样化监督,以及跨来源,即将 arXiv 训练的模型在 ICLR 上测试,将 ICLR 训练的模型在 arXiv 上测试。
方法
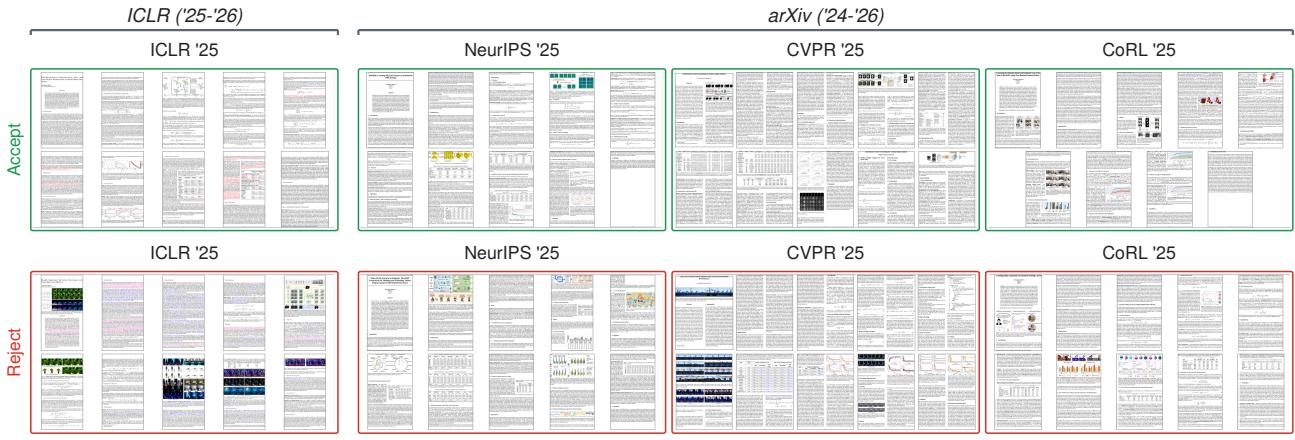
作者在来自 ICLR 和 arXiv 的两个平衡、匿名的接受/拒绝语料库上构建 PaperScorer。为确保模型评估与最终决策者可获得的相同证据,数据管线强制执行严格匿名性、将输入限制为主会场投稿,并确保接受和拒绝论文的一致处理。对于 arXiv 语料库,作者提取 LaTeX 源码压缩包、检测会议特定样式文件并编译匿名审稿模式 PDF。两个来源随后经过 MinerU 规范化管线。页眉、行号旁注和作者识别片段被移除。文本模型接收清理后的 Markdown,视觉模型接收排除区域被涂白的页面截图。
如下图所示:
这些数据集的覆盖范围经过精心管理以支持迁移学习实验。ICLR 池对拒绝论文进行二次采样以保持跨年份平衡分布,而 arXiv 池进行二次采样以保留起始会议分布。
如下图所示:
作者采用 Qwen2.5 文本和 Qwen2.5-VL 视觉骨干作为主要模型。对于文本输入,使用完整 Markdown,最大上下文长度为 24,480 个 tokens。对于视觉输入,每页被渲染并降采样至约 1,240 个视觉 tokens。鉴于典型论文约十页,总视觉输入平均约 12,420 个 tokens。
监督微调(SFT)是研究数据表示和校准的主要方法。作者在 3B、7B 和 14B 规模上微调 Qwen2.5 文本模型,在 3B 和 7B 规模上微调 Qwen2.5-VL 模型。令 Pθ(⋅∣x) 表示论文 x 在决策 token 处的模型下一个 token 分布。由于 Accept 和 Reject 是 Qwen2.5 词汇表中的单个 tokens,作者读取各自的概率并对二者归一化以计算接受概率:
paccept=Pθ(Accept∣x)+Pθ(Reject∣x)Pθ(Accept∣x).SFT 后,决策质量几乎完全集中在这两个 tokens 上,使 paccept 可作为可用的二元接受概率。
对于强化学习变体,作者使用 Group Relative Policy Optimization (GRPO) 微调策略。策略使用推理提示,为每篇论文采样一组补全,并使用组内相对奖励而非学习奖励模型进行更新。这使模型能够在产生最终标签之前进行推理。论文 x 的每个补全 y 使用以下奖励函数评分:
r(y,x)=0.8⋅1[d(y)=d⋆(x)]+0.2⋅1[FORMAT(y)],其中 d(y) 提取方框中的 Accept/Reject 决定,d⋆(x) 是真实决定,FORMAT(y) 验证补全包含所需的思考块后跟方框答案。
作者将其方法与若干基线进行比较,包括 DeepReview、Gemini、GPT 和前沿 coding-agent 评估框架。他们观察到若干基线模型在默认提示下对某一决定类别表现出强烈偏向。为解决这一问题,作者使用少量留出论文样本在基线分数上调校阈值。当该校准阈值提高准确率时被用作硬标签,从而纠正开箱即用决定阈值的偏斜,同时保留预测评级的良好有序性。全程使用平衡训练和评估,以确保准确率同样加权接受和拒绝召回率,防止预测器仅通过拒绝大多数论文来获得高分。
实验
评估在 ICLR 和 arXiv 接受/拒绝预测和排序上测试 PaperScorer,使用准确率、AUC、校准和评审评分相关性,并与简单论文特征逻辑回归模型、前沿提示模型和 coding agents 进行比较。直接接受/拒绝监督产生最强的决定和排序信号,视觉变体始终优于文本和前沿基线,这可能是因为视觉布局和展示线索即使在重度压缩下也携带可恢复的决定信号。经过温度缩放后,PaperScorer 置信度与准确率一致,并且比 Jev 覆盖更多高置信预测,而会议分析显示在大多数高覆盖会议上与前沿模型持平或更优,除了视觉密集型 CV 会议,在这些会议上通用视觉模型具有竞争力。
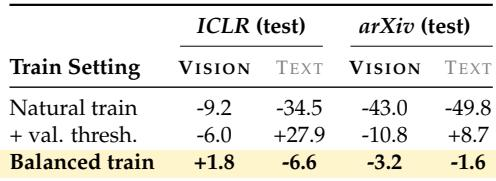
平衡训练在每个测试配置中产生最小的绝对接受-拒绝召回率差距,使偏差接近零。自然训练产生较大的负召回率差距,特别是对文本和 arXiv,而添加验证阈值减少了几个差距但使符号方向在不同模态间不一致。平衡训练在 ICLR 和 arXiv 上具有最低的绝对接受-拒绝召回率差距,无论视觉还是文本。自然训练显示较大的负召回率差距,arXiv 文本偏差最严重。添加验证阈值缓和了视觉和 arXiv 文本差距,但使文本域差距转为正。
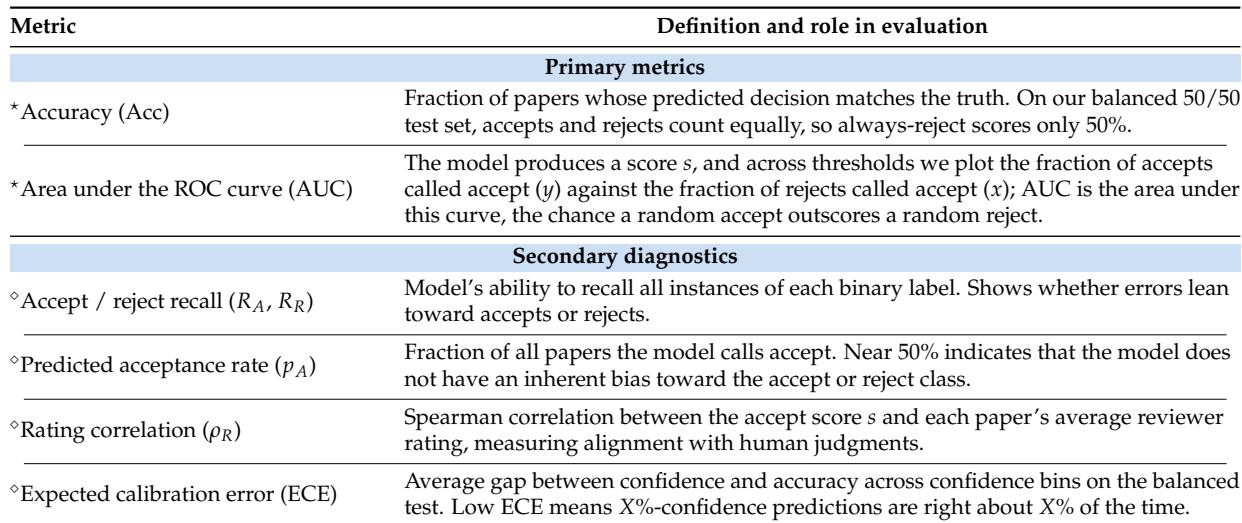
评估将指导训练的主要指标与用于行为分析的次要诊断分开。PaperScorer 模型经过良好校准并提供选择性置信度,在高置信度下比 Jev 覆盖更多论文并保持准确。准确率随人类评分和会议变化,PaperScorer-Vision 除视觉密集型 CV 会议外具有竞争力。转变到真实接受率后校准急剧改善,拒绝判断比接受判断更可靠。所有模型在评分最低的论文上最准确,在评分范围中间接近随机,但 PaperScorer-Vision 在评分最高的论文上仍然准确。在高覆盖会议中,PaperScorer-Vision 与最佳前沿模型持平或更优,视觉密集型 CV 会议除外。
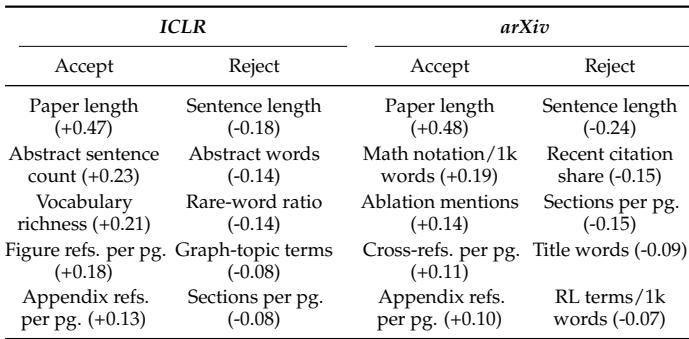
表格报告了预测 ICLR 和 arXiv 投稿接受与拒绝决定的逻辑回归特征权重。更长的论文和更多结构化元素(如图表、附录和交叉引用)倾向于提高预测接受概率,而更长的句子和每页更多节倾向于降低接受概率。会议特定模式包括 arXiv 上数学符号和消融提及的正权重,以及近期引用比例和 RL 相关术语的负权重。论文长度是 ICLR 和 arXiv 最强的正向特征,而句子长度是两者最强的负向特征。ICLR 接受信号包括摘要句子数、词汇丰富度和每页图表引用数;arXiv 接受信号包括数学符号、消融提及和每页交叉引用数。
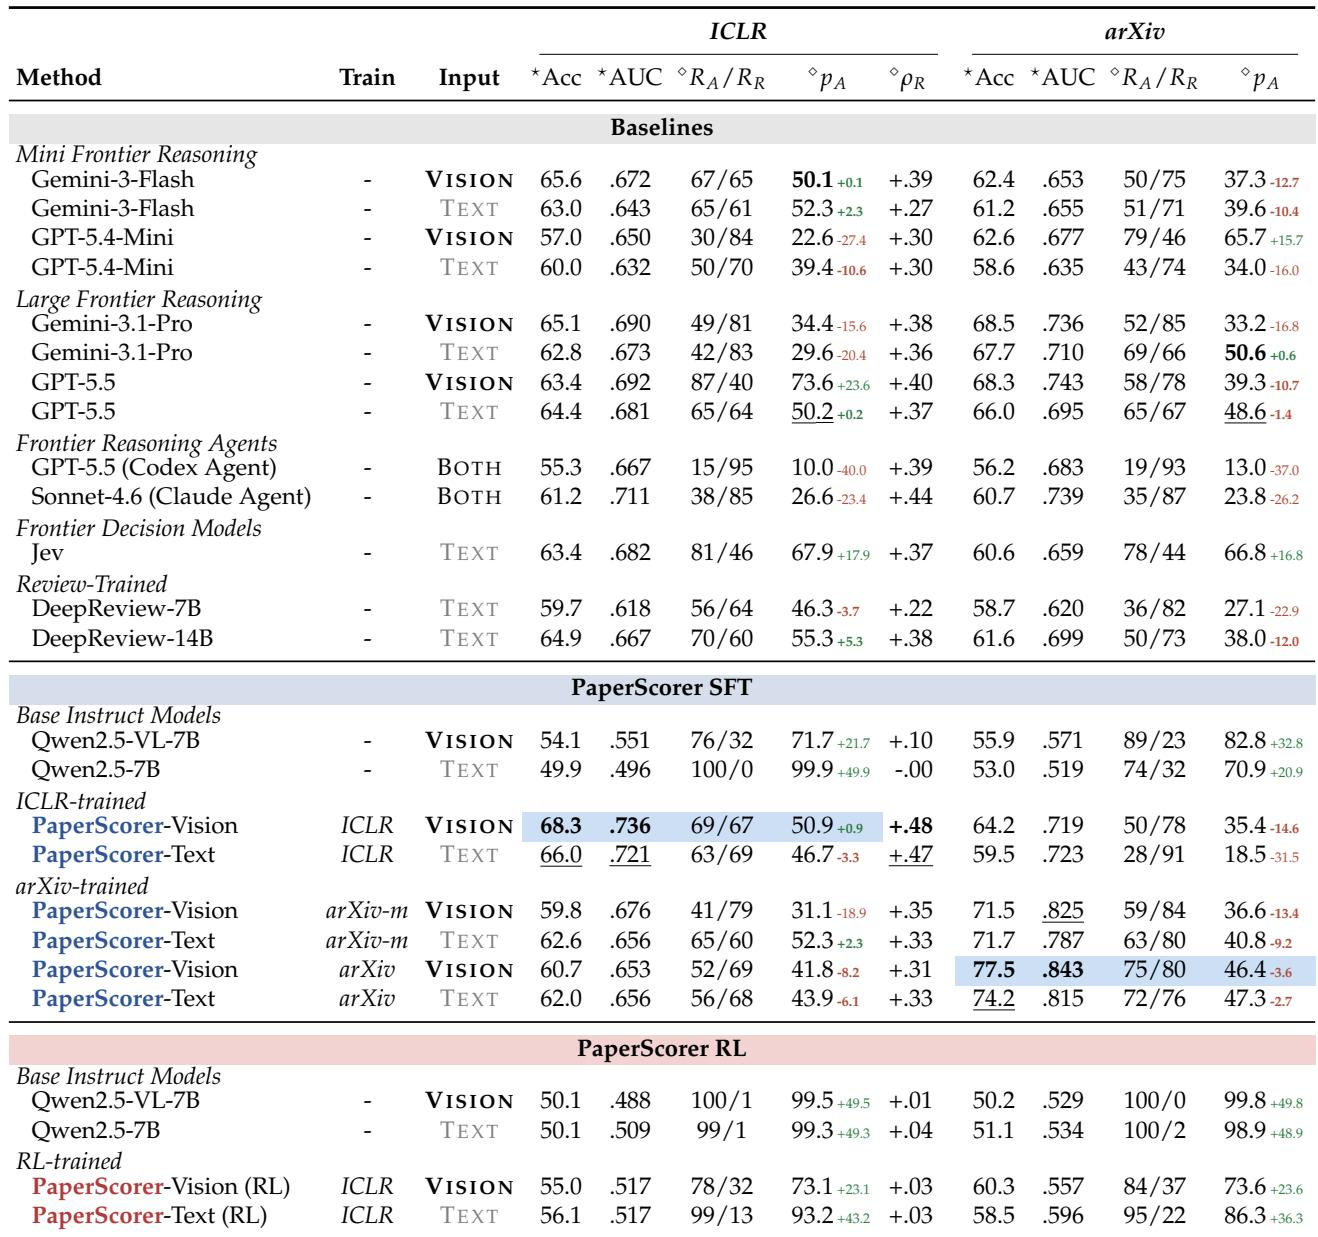
PaperScorer 的直接接受/拒绝监督产生比提示基线、训练评审器和前沿推理系统更强的决定和排序信号。在 ICLR 和 arXiv 测试集上,PaperScorer 变体在准确率和 AUC 上领先,视觉输入总体最强,模型在其训练的源域上表现最佳。前沿和 coding-agent 基线可以合理地对论文进行排序,但经常将这些排序转化为偏斜的接受/拒绝决定。较小的推理模型默认严重偏斜,一个几乎接受每篇论文而另一个几乎拒绝每篇论文。大型前沿系统更准确,但仍产生不稳定的接受率,根据设置在接受不足三分之一和近四分之三的论文之间摆动。coding agents 取得了很强的排序相关性和有竞争力的 AUC,但其接受/拒绝准确率仍低于最佳的 non-agent 前沿基线。PaperScorer-Vision 在两个数据集上均优于最佳前沿视觉模型,在 arXiv 数据上训练时优势更大。PaperScorer 保持接受和拒绝召回率平衡,而前沿系统排序良好但天然偏斜其决策。一个 7B 监督决策模型可以通过从论文内容学习直接决策信号来击败大型前沿推理系统。
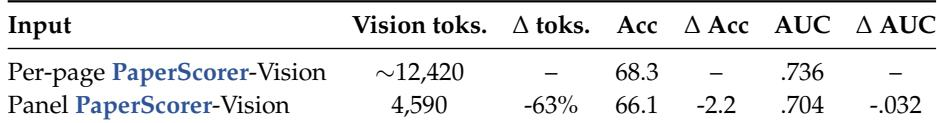
在 ICLR 测试集上,面板式输入将视觉 token 使用量降低到每页成本的三分之一左右,同时保留大部分决策质量。准确率和排序质量的下降相对 token 节省较小。该消融仅限于 ICLR 训练的模型,因为没有训练 arXiv 面板模型。将十页平铺为一个面板图像可将视觉 token 成本降低约三分之二,而准确率保持在每页基线的几个百分点以内。面板模型保留了大部分排序质量,AUC 仅小幅下降,这些发现仅适用于 ICLR 训练的模型。
实验在 ICLR 和 arXiv 接受/拒绝决定上评估 PaperScorer,比较训练策略、校准、特征可解释性、基线以及面板图像效率消融。平衡训练在很大程度上消除了接受-拒绝召回率偏差,而直接监督产生比提示基线、训练评审器和前沿推理系统更强的决定和排序,特别是在视觉输入下。定性诊断显示模型校准良好且具有选择性,拒绝判断比接受判断更可靠,更长的结构化论文预测接受而更长的句子预测拒绝。面板图像输入将视觉 token 成本降低约三分之二,仅带来较小的准确率和排序损失,不过这一结果仅限于 ICLR 训练的模型。