Command Palette
Search for a command to run...
Sensorimotor Alignment(感觉运动对齐):一种用于具身策略成功的柏拉图式代理指标
Sensorimotor Alignment(感觉运动对齐):一种用于具身策略成功的柏拉图式代理指标
Yunfei Xie Howard H. Qian Shiyi Lan Kaiyu Hang Chen Wei
摘要
机器人基础模型通常通过成本高昂的闭环 rollout 进行评估,这促使研究者寻求低成本的离线代理指标来衡量模型能力。柏拉图表示假说(Platonic Representation Hypothesis,PRH)[21] 认为,随着表示质量的提升,视觉和语言等模态会收敛到关于现实的共享统计模型。我们探究运动轨迹是否构成另一种此类模态:随着具身模型能力的增强,其感知表示是否应收敛到物理运动的结构?为检验这一点,我们提出 Sensorimotor Alignment(感觉运动对齐,S2)——一种无需训练的离线度量,用于衡量模型的感知表示与物理运动几何结构的对齐程度。我们发现,在多个模型系列中,S2 与下游机器人任务成功率正相关,因而可作为一种低成本离线代理指标,用于在闭环评估之前对模型进行优先级排序。S2 还能够在将模型微调为视觉-语言-动作模型(VLA)这一昂贵过程之前,识别出有前景的视觉-语言模型(VLM)骨干网络。除上述相关性之外,S2 还能为 VLA 和世界动作模型(WAM)中观察到的现象提供表示层面的解释。借助 S2,我们将 PRH 扩展至机器人领域,并使感觉运动对齐可度量,从而提供一种仅凭闭环成功率无法揭示的、低成本的、表示层面的机器人基础模型视角。
一句话总结
莱斯大学和 NVIDIA 的研究人员提出了感知运动对齐 (S2),一种免训练离线指标,用于衡量模型的感知表示与物理运动几何之间的对齐程度,与下游机器人任务成功率正相关,并能在昂贵的微调为视觉-语言-动作模型(VLA)之前筛选视觉-语言模型(VLM)骨干,从而将柏拉图表示假说(PRH)扩展到机器人领域。
核心贡献
- 提出感知运动对齐(S^2),一种衡量感知表示与末端执行器轨迹之间对齐程度的免训练离线指标,将柏拉图表示假说扩展到机器人领域。
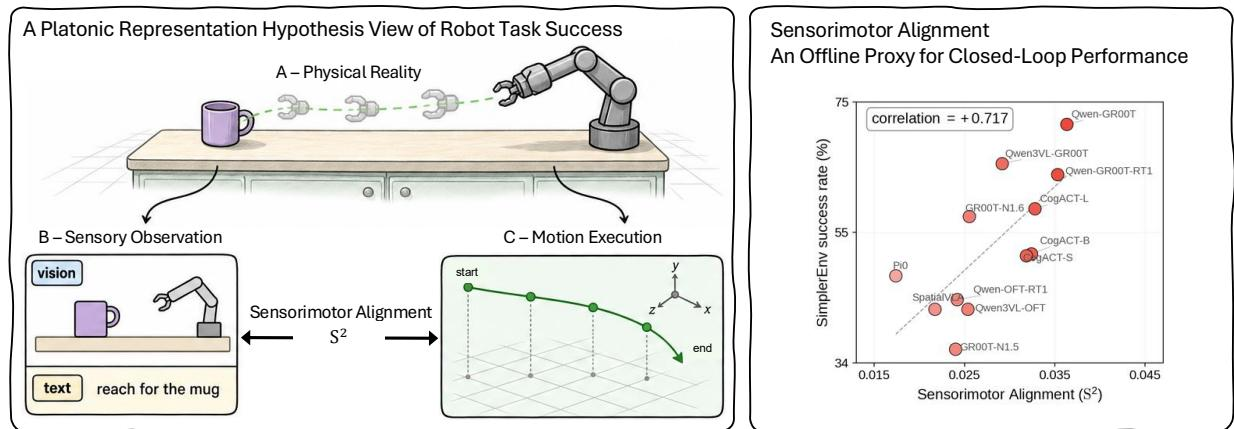
- 在 VLA、原始 VLM、仿真中的 WAM 以及真实机器人策略上,S^2 与下游任务成功率正相关,可作为低成本离线代理,用于在昂贵的微调或闭环评估之前对模型排序并识别有潜力的 VLM 骨干。
- 与 VQA 分数和视频质量指标相比,S^2 与任务成功率的相关性更强,并为 VLA 和 WAM 现象提供表示层面的解释,包括模态主导性、冻结视觉编码器导致的性能下降、跳过迭代去噪带来的较小任务成功代价,以及中等深度块对语义推理的重要性。
引言
机器人基础模型越来越多地构建在大规模预训练的视觉-语言模型、视频模型和世界动作模型之上,但在它们之间进行选择仍然依赖缓慢、噪声大且依赖基准的闭环 rollout。现有的离线代理指标,例如视觉问答或视频质量指标,衡量的是被动感知或生成质量,而不是感知表示是否面向动作进行组织;此前的机器人表示研究大多只考察视觉编码器,而没有考虑实际执行轨迹。作者通过将柏拉图表示假说扩展到具身模型并提出感知运动对齐(S^2)来填补这一空白;S^2 是一种免训练离线指标,衡量在感知特征空间中相近的片段是否在运动轨迹空间中也相近。在仿真和真实机器人环境中,S^2 与下游任务成功率的相关性比 VQA 或视频质量指标更强,并且还可作为 VLA 和 WAM 行为的表示层面诊断工具。
方法
作者提出了一个名为感知运动对齐(S2)的指标,用于评估具身模型,其动机来自柏拉图表示假说。他们假设,能力更强的模型在其感知表示(图像和文本特征)与运动表示(末端执行器轨迹)之间表现出更紧密的对齐。为了使这种对齐可度量,他们构建两种表示,并使用成对的感知输入和物理运动参考数据集比较它们的邻域。
对于每个采样片段 i,作者通过将随机采样的图像帧与任务指令配对来形成感知输入 xi。他们使用机器人基础模型的视觉编码器和文本编码器对该输入进行编码,以获得感知嵌入:
zi=f(xi)∈Rd,其中 f 应用相应的编码器,并将输出的 token 特征平均池化为单个 d 维向量。
同时,他们从采样帧起提取接下来 h 步内的末端执行器位置、姿态和夹爪状态,以形成运动表示:
τi=(xi,yi,zi,ϕi,θi,ψi,gi)∈Rh×7,其中变量分别表示位置坐标、滚转角、俯仰角和偏航角,以及夹爪坐标。位置被编码为 R3 中的向量,姿态角被编码为 SO(3) 中的旋转,以确保距离反映平移和旋转的几何性质。
为了衡量对齐程度,作者采用一种相互最近邻指标,比较感知空间和运动空间中的 k-最近邻集合。他们在感知空间中使用余弦距离,在运动空间中使用动态时间规整(DTW),以适应速度变化的轨迹。片段 i 和 j 之间的距离定义为:
dsensory(i,j)=1−cos(zi,zj),dmotor(i,j)=DTW(τi,τj).利用这些距离度量,他们为每个片段构造感知 k-最近邻集合 Nsensory(i) 和运动 k-最近邻集合 Nmotor(i)。对齐分数通过取这两个集合的交集、将其大小除以 k,并对所有 N 个片段取平均来计算:
mNN=Nk1i=1∑N∣Nsensory(i)∩Nmotor(i)∣.作者可视化了这一邻域比较过程,以说明共享邻居如何反映对齐。如下图所示:
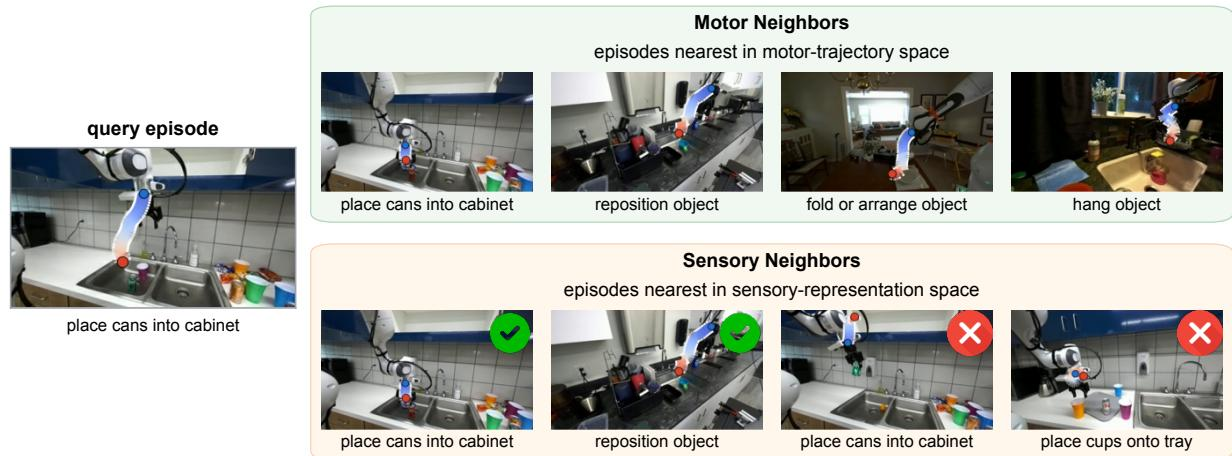
重叠越大,表明感知表示相似的片段也遵循相似的运动轨迹。实际报告中,S2 指标使用该最近邻方法的中心化、归一化变体,并取 k=10 个邻居。
实验
实验评估了感知运动对齐,即比较感知与运动片段邻域的指标,作为下游机器人操作成功率的离线预测指标。在视觉-语言-动作模型、视觉-语言模型骨干、世界动作模型和真实机器人策略上,更高的对齐一致地对应更高的任务成功率,并且与 VQA 或视频质量指标相比,它能更可靠地跟踪成功率,同时在数据集、时间范围和评估选择上保持稳定。具身不匹配对照会削弱相关性,支持该指标对具身具有敏感性。表示层面的分析进一步表明,微调后的策略在运动上主要依赖视觉特征而非语言特征,冻结视觉编码器会限制对齐增益,并且早期去噪特征和视频骨干的中等深度块已经携带最强的感知运动对齐。