Command Palette
Search for a command to run...
WeVisOne-VL:从目标到像素的统一视觉感知
WeVisOne-VL:从目标到像素的统一视觉感知
Tianming Liang Junyi Pan Yuxi Li Canmiao Fu Zhipeng Huang Chong Sun Chen Li Jing Lyu
摘要
现有的视觉语言模型(VLM)在细粒度视觉感知方面仍不可靠。在本报告中,我们提出 WeVisOne-VL(WeChat Vision All-in-One),一个通过结构化下一 token 预测统一目标级与像素级感知的强大 VLM。它支持多种视觉任务,包括目标检测、指代定位、计数、OCR、分割和抠图,能够在任意用户指定的粒度上进行定位,从点、框到掩码和 alpha 遮罩。在架构上,我们通过特殊的 token 将轻量级像素解码器集成到 VLM 中,以生成实例级像素输出。我们采用三阶段课程 SFT 和随后的混合任务 RL 对模型进行训练。在 30 多个基准测试中,WeVisOne-VL 在目标级和像素级任务上均展现出领先性能,同时对目标缺失的查询保持稳健拒绝。通过将 WeVisOne-VL 开源发布,我们希望推动 VLM 从广泛的视觉理解走向面向真实世界部署的、真正可靠的感知系统。
一句话总结
来自腾讯公司微信视觉团队的研究人员提出了 WeVisOne-VL,这是一个视觉语言模型,通过结构化 next-token 预测和由特殊 <OBJ> token 激活的轻量级像素解码器来统一目标级与像素级感知,并经过三阶段课程式 SFT 和混合任务 RL 训练,在 30 多个基准上取得了领先性能,可用于可靠的现实部署。
核心贡献
- 提出了 WeVisOne-VL,这是一个视觉语言模型,通过结构化 next-token 预测统一目标级和像素级视觉感知,支持目标检测、指代定位、计数、OCR、分割和抠图,输出涵盖点、框、掩码和 alpha matte。
- 轻量级像素解码器通过特殊
<OBJ>token 集成到 VLM 中,专用坐标 token 对实例预测进行编码,从而在单个语言引导模型中支持实例级掩码和 alpha matte 输出。 - 模型经过三阶段课程式 SFT 和混合任务 RL 训练;在 30 多个基准上,相比同规模 VLM,它提升了平均检测 F1 和计数精度,推进了文本 grounding 和指代定位,并在指代分割和图像抠图上超过所评估的基线,同时对目标缺失查询保持稳健拒绝。
引言
计算机视觉系统必须识别图像内容、识别用户指定的目标并确定目标位置,以支持内容创作、工业检测、自动驾驶和具身智能等应用。从传统检测和分割模型到开放世界感知模型和大型视觉语言模型的进展拓宽了模型可识别的概念,但当前系统仍然经常幻觉出不存在的目标、误解不熟悉的描述,并忽略非显著实例,导致召回不完整。作者提出 WeVisOne-VL,一个基于 Qwen3-VL 2B 和 4B 规模的视觉语言模型,通过单一自然语言接口统一目标级和像素级视觉感知。它将各种视觉任务构建为结构化 next-token 预测,并使用轻量级像素解码器进行稠密输出,在约 1 亿张带有细粒度标注的图像上通过多阶段课程进行训练。
数据集
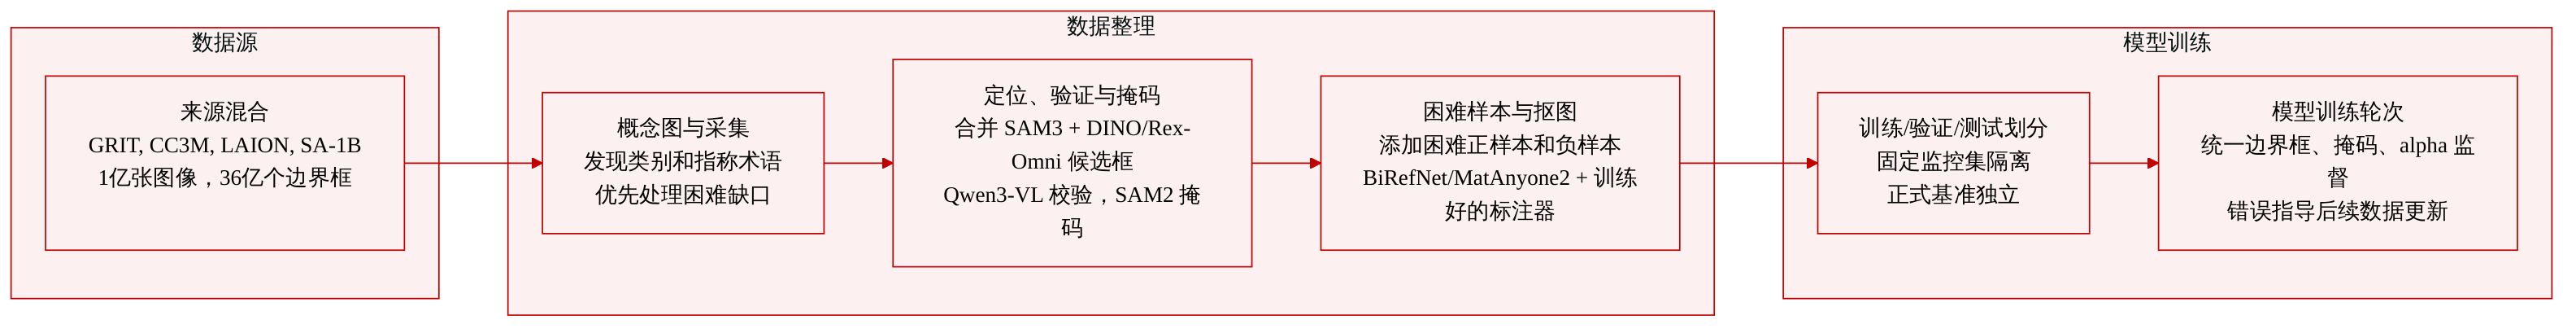
作者构建了 WeVisOne-VL Data Engine(WDE),数据来源包括 GRIT、CC3M、LAION、SA-1B 和任务特定数据集。标注总量覆盖超过 1 亿张图像和约 36 亿个边界框标注。
数据来源与组成
- 使用优化的 Tokenize Anything 模型发现类别级概念。
- 通过提示 Qwen3-VL 生成指代表达,使用属性、状态、动作和关系。
- 两类查询都被组织在一个知识图谱中,该图谱从 Wikipedia 和 WordNet 初始化,包含规范名称、别名、分类关系和整体与部分关系。
- 新术语只有在经过文本检索、视觉语言验证和稳定视觉证据后才会加入;等效类别会被规范化,同时保留描述性约束。
- 定向采集使用概念名称/别名、视觉检索和模型错误信号,优先考虑概念覆盖、图像域、目标尺度、遮挡、密集场景、易混淆类别和反复出现的指代失败。
- 本节没有报告 GRIT、CC3M、LAION、SA-1B 或任务特定子集的单独规模。
标注处理
- 检测:候选框来自 SAM3 和一个内部开放词汇 DINO 风格检测器,合并到同一个候选池;Qwen3-VL 验证类别匹配并解决重复/冲突。
- 指代:SAM3 Agent 和 Rex-Omni 提出候选区域;Qwen3-VL 验证完整表达含义,包括属性、状态、动作、关系、整体目标与部分,以及上下文与目标。
- 二值掩码:SAM2 为每个已定位实例预测掩码,并继承相同的查询和边界框。类别查询监督检测和类别分割;指代表达监督指代定位和指代分割。
- 质量:部分掩码和框会进行人工抽查;记录标注来源以便追溯。
- 困难样本:查询来自易混淆概念、视觉相似类别、变化的描述条件和模型失败。只有当没有目标满足全部条件时,才接受负样本。困难负样本的目标集合为空,没有框或像素目标;困难正样本保留针对漏检、拥挤或遮挡目标的可靠标注。
- 抠图:每个二值掩码 S 会在同一裁剪区域上获得来自 BiRefNet 和 MatAnyone2 的 alpha 候选。仅当 BiRefNet 的二值化前景通过 IoU、覆盖率、前景精度、面积、框 IoU 和质心检查时才会被接受;否则,当 MatAnyone2 的二值化掩码与 S 的 IoU 至少为 0.9 时,管道回退到 MatAnyone2,否则保留 S。
- 专用抠图标注器通过等比例采样初始标签和高质量抠图数据进行训练。它使用冻结的 SAM2.1-Base+ 骨干网络,以及可训练的 alpha 细化头、多尺度图像特征、提示掩码引导和 RGB 细节特征。
- 训练后的抠图标注器应用于所有已标注训练实例,生成最终的 alpha 伪标签,并保持与原始实例描述和边界框的关联。
在模型中的使用与数据治理
- 统一标注将同一实例的语言查询、框、二值掩码和 alpha matte 关联起来,支持检测、指代定位、类别分割、指代分割和抠图监督。
- 每轮训练后,按概念、域、尺度、遮挡、任务和失败类型审查模型错误。标注只有在审查后才会被纠正或重新生成;未解决的样本会被排除。
- 每次数据发布都会记录标注来源、暴露每个错误的模型版本以及审查/修订历史。
- 原始图像、识别出的近似重复图像以及派生任务记录在更新过程中保持在同一数据分区。固定的监控集保留用于内部回归,并排除在训练和阈值校准之外。正式基准与训练及反馈驱动的数据构建相互隔离。
- 本节没有提供精确的整体训练混合比例,抠图标注器训练期间的等比例采样除外。
方法
作者开发了一个统一的视觉感知综合框架,包括用于大规模数据构建的 WeVisOne-VL Data Engine(WDE),以及具有多阶段训练流程的专用模型架构。
如下图所示:
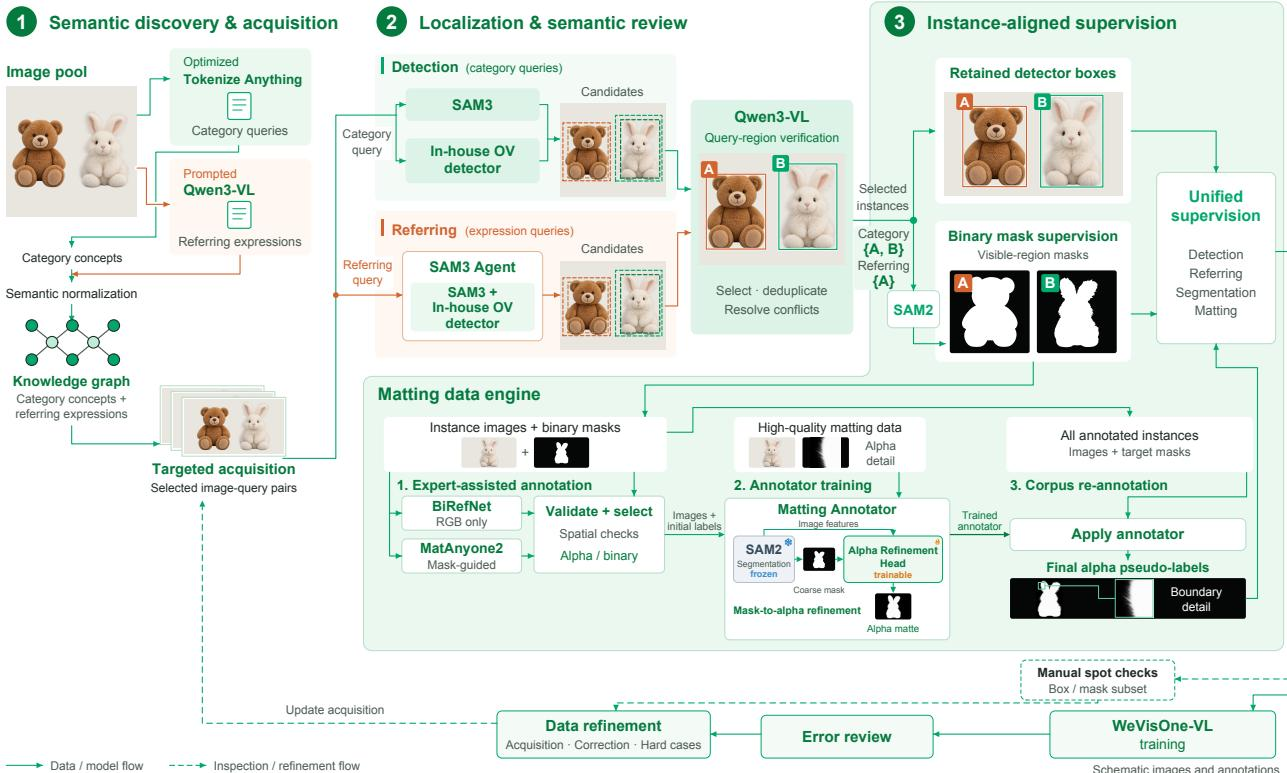
WDE 编排了一个系统化流程,为类别级识别和上下文相关目标选择生成高质量标注。该过程从语义发现开始,优化的 Tokenize Anything 模型和经过提示的 Qwen3-VL 模型提取类别概念和指代表达。这些内容被组织到共享知识图谱中,以指导定向图像采集。采集到的图像-查询对经过任务特定的定位。对于检测,来自 SAM3 和内部开放词汇检测器的候选框会合并并由 Qwen3-VL 验证。对于指代任务,SAM3 Agent 和 Rex-Omni 提供候选区域,并通过语义验证进行类似的整合。定位之后,SAM2 为每个实例生成二值掩码。为了支持细粒度边界监督,作者引入了专用抠图数据引擎。该引擎结合使用 BiRefNet 和 MatAnyone2 的专家辅助标注,基于冻结的 SAM2.1-Base+ 模型训练一个轻量级抠图标注器,并将其应用于整个语料库以生成连续 alpha 伪标签。最后,闭环反馈机制在每轮训练后分析模型错误,以指导后续数据采集和标注细化。
基于这一丰富的数据基础,作者设计了 WeVisOne-VL 模型,它在 Qwen3-VL 基础上扩展了专用坐标 token 和一个轻量级像素解码器。所有视觉任务都被表述为结构化 next token 预测,使用从 <0> 到 <1000> 的 token 表示归一化坐标,并使用 <OBJ> token 连接自回归定位与像素级解码。轻量级解码器包含约 960 万个参数,将离散 token 表示转换为稠密预测。它由三个核心模块组成。第一,视觉特征适配器从 ViT 中间层提取多尺度特征,将其映射到带有位置和层级嵌入的共享解码器空间。输出被展平并拼接成视觉记忆。第二,框引导查询解码器直接从生成的 <OBJ> token 的隐藏状态及其预测边界框初始化实例查询。它使用六个可变形块,包含自注意力和多尺度可变形交叉注意力,从记忆中聚合视觉特征。第三,实例条件稠密预测阶段融合多尺度视觉特征,并利用动态掩码头生成实例感知核。从粗到细的细化模块逐步上采样和调制特征,以产生最终的分割或抠图预测。
训练流程遵循三阶段监督微调课程,随后是混合任务强化学习。在阶段 1,作者通过在 9000 万个样本上训练语言模型来适应新 token 和结构化输出,建立预测实例与 <OBJ> token 之间的初始对应关系。阶段 2 解冻视觉编码器,并提高输入分辨率和最大框数量,以处理密集和小尺寸目标。阶段 3 建立 VLM 与像素解码器之间的桥梁。解码器首先在分割样本上使用 focal loss 和 Dice loss 的组合进行预热:
随后,VLM 和解码器通过交替的 next token 预测和像素级任务进行联合训练:
Ljoint=LNTP+10Lseg之后,解码器使用抠图样本和组合损失进行连续 alpha 预测专业化训练,该损失结合 L1、梯度、拉普拉斯和困难像素项。
SFT 之后,作者执行混合任务 RL 以直接优化任务奖励。采用一种不确定性感知的样本选择策略,根据组奖励的均值和标准差计算不确定性分数,以识别中等难度样本。所选数据用于 Group Relative Policy Optimization(GRPO),并带有 grounding 奖励。对于每个提示,采样多个响应并解析为预测目标集合。grounding 奖励通过预测框和真实框之间的一对一匈牙利匹配计算,使用立方交并比(IoU)指标来强调精确定位:
ri=Ngt+Npred2∑(b^,b∗)∈MiIoU(b^,b∗)3该奖励结构惩罚漏检和重复目标,确保模型学习生成高精度结构化输出。
实验
实验在五个目标级任务(目标检测、指代目标检测、目标计数、目标指向和 OCR)和两个像素级任务(指代分割和可提示抠图)上评估 WeVisOne-VL,使用 1,960 个视觉 token 的贪心解码,并与 Qwen 系列 VLM、Rex-Omni、LocateAnything、LISA/UniPixel 和基于 SAM2 的抠图基线进行比较。在拥挤、长尾、指代、计数、指向、OCR、分割和抠图基准上,WeVisOne-VL 一致优于可比较基线,在精确定位、细粒度计数、负目标拒绝和边界敏感抠图方面具有显著优势。定性结果进一步表明,该模型保留实例级区分,遵循细致的语言描述,并生成将描述关联到特定图像区域的 grounded 说明文字。
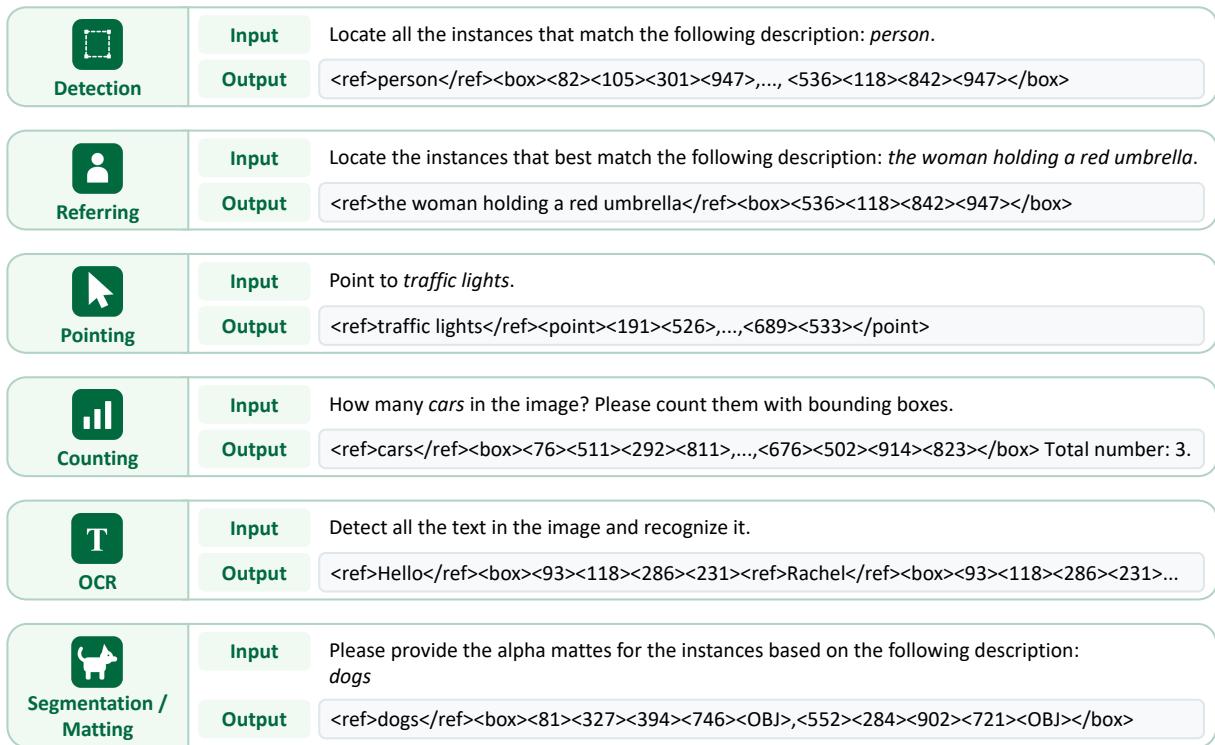
WeVisOne-VL 使用统一的基于坐标的输出格式,在单一接口中覆盖检测、指代、指向和计数任务。定性比较显示,与基线方法相比,它通常能更完整地定位文本和被指代目标,在抠图中分割出细节,并且可在目标缺失时不返回掩码。它也会生成将描述与图像区域关联的 grounded 说明文字。该统一格式将输出表示为目标描述,后接跨检测、指代、指向和计数的边界框或点坐标。在指代分割中,WeVisOne-VL 能在属性、关系和多实例情况下分割目标对象,并在目标缺失时不返回掩码。在文本密集图像中,与所比较的基线相比,WeVisOne-VL 能更完整地定位和转录弯曲或细小文本。在框提示和文本提示抠图中,它能更好地保留胡须、发丝和标志等细微边界,并在基线漏检或包含干扰项时选择多个预期实例。
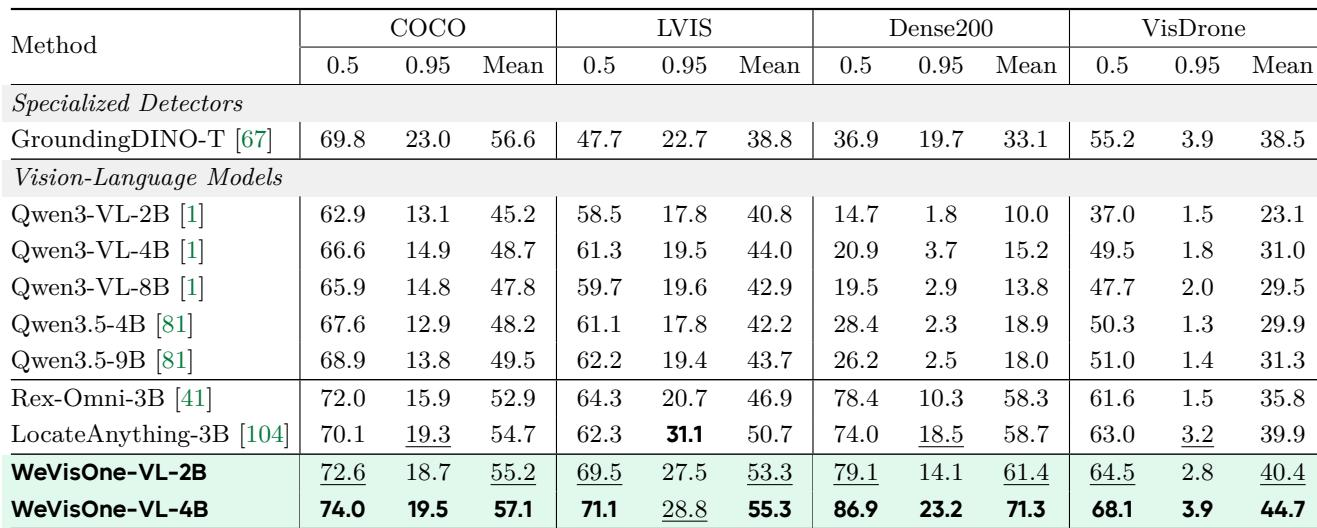
WeVisOne-VL 在零样本 COCO 和 LVIS 以及密集 Dense200 和 VisDrone 基准上,比可比较的视觉语言模型获得更高的平均 F1。优势在密集和小目标数据集上最大,这些数据集中许多小且拥挤的实例需要准确识别。在严格 IoU=0.95 下的强劲结果表明,提升既来自目标覆盖范围,也来自精确定位。相比 VLM 的平均 F1 提升在 Dense200 和 VisDrone 上尤为明显。严格 IoU=0.95 阈值下的表现表明定位得到改善,而不仅仅是扩大检测覆盖范围。在通用、长尾和密集检测基准上,WeVisOne-VL 在可比较模型规模上优于 VLM。
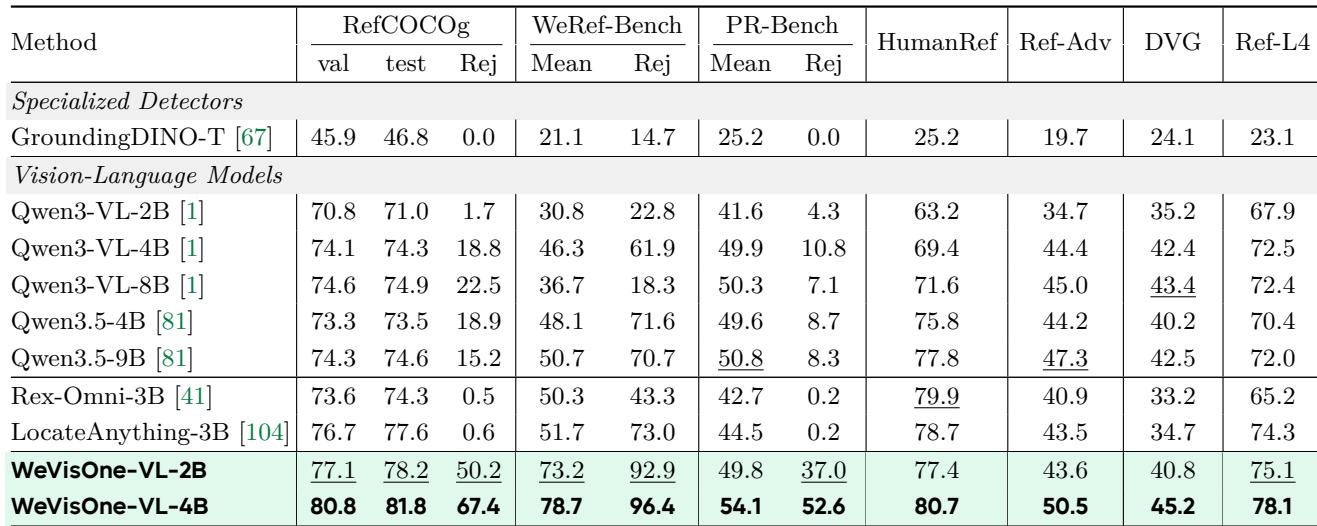
表格报告了多个基准上的指代目标检测 F1 和目标缺失拒绝率。据报告,WeVisOne-VL 在单目标、多目标和目标缺失设置中一致优于现有 VLM。在所列 VLM 中,Qwen3-VL-8B 在大多数目标存在 F1 基准上领先,而 Qwen3-VL-4B 在 WeRef-Bench 和 PR-Bench 目标缺失拒绝上领先。WeVisOne-VL 在单目标、多目标和目标缺失指代目标检测设置中一致优于现有 VLM。在所列 VLM 中,Qwen3-VL-8B 取得最佳 RefCOCOg、HumanRef、Ref-Adv、DVG 和 Ref-L4 F1,而 Qwen3-VL-4B 取得最佳 WeRef-Bench 均值和拒绝率。GroundingDINO-T 未能拒绝 RefCOCOg-Rej 目标缺失查询,并在指代目标检测 F1 上落后于 VLM 条目。
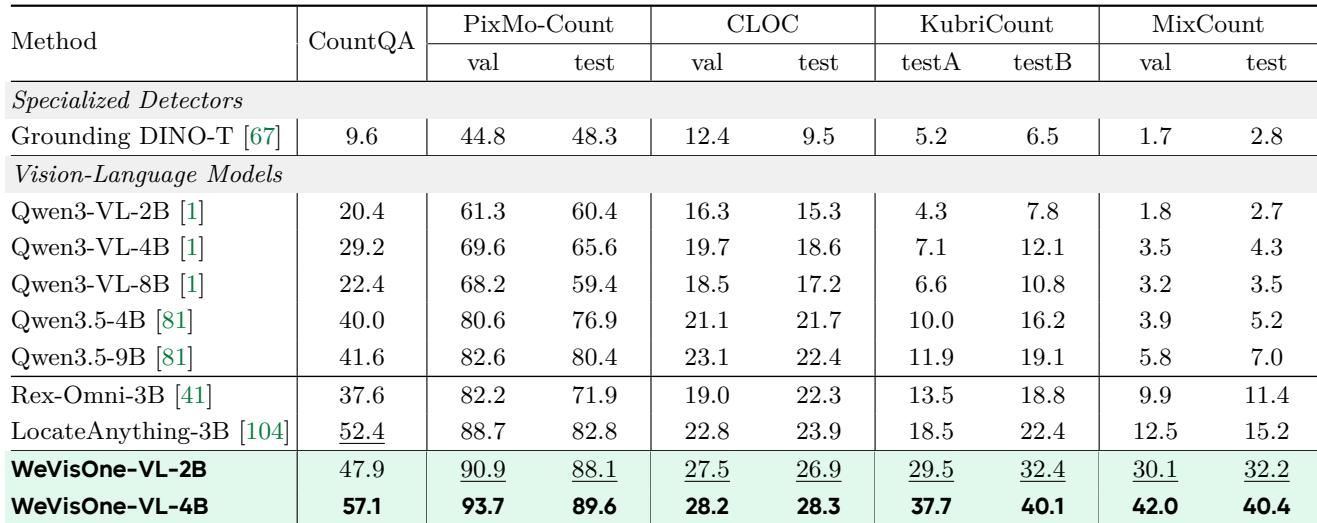
WeVisOne-VL 在每个报告的目标计数基准和划分上都取得了最高的精确匹配精度,领先于 VLM 基线和一个专用检测器。在所示 VLM 基线中,Qwen3-VL-4B 在 CountQA、PixMo-Count、CLOC、KubriCount 和 MixCount 上始终表现最佳。与 PixMo-Count 相比,在 CLOC、KubriCount 和 MixCount 等跨域和细粒度计数任务上准确率低得多。WeVisOne-VL 在每个目标计数划分上优于所有报告模型,而专用 Grounding DINO-T 检测器不计入 VLM 排名。Qwen3-VL-4B 是比较中最强的 VLM 基线,与 PixMo-Count 相比,CLOC、KubriCount 和 MixCount 上的精确匹配分数大幅下降。
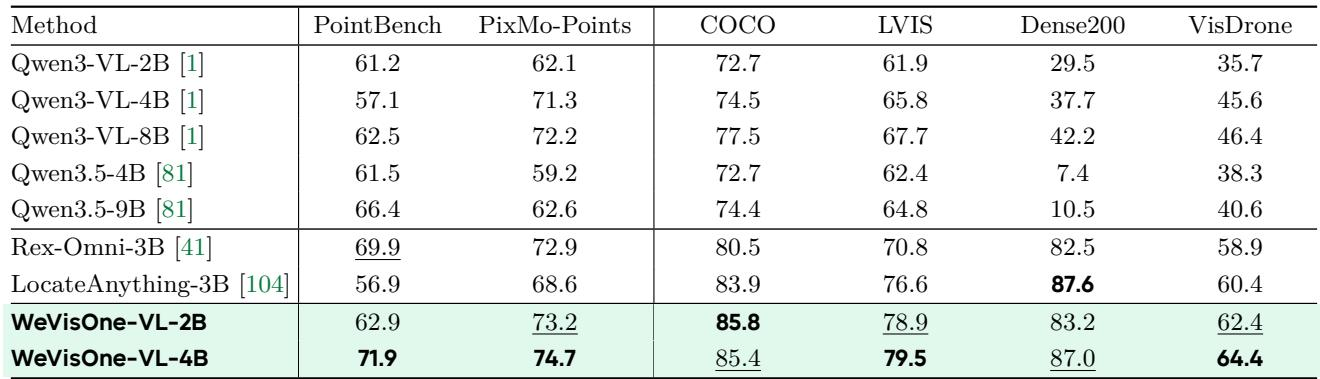
该目标指向评估覆盖专用指向基准和若干检测派生基准。WeVisOne-VL 在 PointBench 和 PixMo-Points 上取得最佳报告结果,并在 COCO、LVIS、Dense200 和 VisDrone 上表现强劲。这表明它在自然图像和细粒度混合目标场景中都能准确指向。WeVisOne-VL 在 PointBench 和 PixMo-Points 上优于所有报告基线。在检测派生基准上的强劲结果表明其目标指向能力可扩展到多样化和细粒度场景。在报告基线中,Qwen3-VL 模型随着模型规模增大在检测派生基准上趋于改善,而 Rex-Omni 和 LocateAnything 在 Dense200 上尤其强劲。
实验使用通用、密集和细粒度基准,在检测、指代、指向和计数任务上评估统一基于坐标的接口。定性结果显示,文本和被指代目标的定位更完整,抠图边界更精细,目标缺失时正确拒绝,以及生成将描述与图像区域关联的 grounded 说明文字。定量上,WeVisOne-VL 在检测、带目标缺失拒绝的指代检测、目标计数和指向基准上一致优于可比较的视觉语言模型,提升归因于精确定位和更广泛的覆盖。