Command Palette
Search for a command to run...
HiSTEVE 1.0:利用人类接口 VLA 智能体应对开放世界游戏
HiSTEVE 1.0:利用人类接口 VLA 智能体应对开放世界游戏
Zecong Tang Zian Guan Yuncheng Guo Zhanqiu Zhang Yiwen Guo Bo Dai
摘要
构建像人类玩家一样在开放式游戏中行动的虚拟具身智能体是一个长期目标,既需要长时程自主性,也需要可靠的原生接口控制。作为程序化生成的开放世界,Minecraft 为研究这些能力的集成提供了天然测试平台。现有智能体通常要么提供缺乏长时程自主性的原生视觉运动控制,要么提供通过环境 API 或预定义技能执行的高层规划。为弥补这一差距,我们提出了 HiSTEVE,一种配备能力感知型智能体执行框架的层次化 VLA 智能体。在编排层,我们为该执行框架配备用于跟踪进度的结构化记忆,以及用于在 VLA 能力范围内选择子任务的 VLM 规划器。为可靠判断子任务是否完成,我们进一步引入策略耦合的任务完成状态检测器,该检测器以 VLA 策略上下文为条件来发出候选完成信号。在控制层,单个 VLA 仅通过视觉感知和原生键盘、鼠标动作执行所有子任务。为减少异构 GUI 与非 GUI 交互之间的干扰,我们引入了特定于交互模式的 RMSNorm 分支和独立的鼠标移动 token 嵌入。我们还通过世界知识注入、模仿学习以及利用环境反馈的强化学习来训练 VLA,以提高可靠性和恢复能力。HiSTEVE 实现了最先进的原子任务性能,在 MineStudio Bench 上得分为 85.0%,在 OpenHA 上平均成功率为 37.4%,同时还能像人类玩家一样从零开始完成制作铁镐等长时程任务。
一句话总结
来自香港大学的研究者与合作者提出了 HiSTEVE,一种面向开放世界游戏的 hierarchical VLA agent,它结合了能力感知 harness、结构化记忆、VLM planner 和 policy 耦合的完成检测器,使单个仅视觉 VLA 能够通过 regime 特定的 RMSNorm 分支和独立的鼠标移动 token 嵌入执行原生键盘鼠标控制,并在 MineStudio Bench 上达到 85.0%,在 OpenHA 上达到 37.4% 的平均成功率。
核心贡献
- HiSTEVE 是一个带有能力感知 harness 的 hierarchical VLA agent,它结合了结构化记忆、VLM planner 和 policy 耦合的任务完成状态检测器,用于长时程执行与恢复。
- 单个 VLA 通过 regime 特定的 RMSNorm 分支、独立的鼠标移动 token 嵌入,以及包含世界知识注入、模仿学习和强化学习的三阶段训练策略,提供仅视觉的原生键盘鼠标控制。
- HiSTEVE 在 MineStudio Bench 上达到 85.0% 的原子任务性能,在 OpenHA 上平均成功率为 37.4%,达到最先进水平,并能完成从零开始制作铁镐等长时程任务。
引言
构建能够以与人类相同的键盘鼠标约束游玩 Minecraft 等开放世界游戏的虚拟具身 agent,既需要长时程自主性,也需要可靠的原生接口控制。此前工作往往只关注其中一面:视觉运动或视觉-语言-动作模型可以将像素映射为动作,但难以持续跟踪任务和恢复;语言模型 planner 通常依赖环境 API 或预定义技能,而这些在大多数游戏中不可用。作者提出了 HiSTEVE,一个 hierarchical vision-language-action agent,它将能力感知的规划 harness 与用于原生控制的单一低层 policy 结合。该 harness 维护结构化任务记忆,验证完成情况,并决定何时推进、恢复或重新规划;而 regime 特定的归一化分支和独立的鼠标移动嵌入帮助 policy 同时处理非 GUI 和 GUI 交互,避免负迁移。
方法
作者提出了一个能力感知 agent harness,用于协调 VLM planner 和低层 VLA policy,以实现长时程自主性。该 harness 集成能力受限规划、证据驱动的交接与恢复,以及结构化记忆。VLA policy 执行原生视觉运动控制,而 policy 耦合的任务完成状态检测器通过判断 VLA 调用应何时结束来支持该 harness。
规划过程不依赖参考轨迹:不提供预定义子任务序列或专家路径。在每个决策步骤,harness 维护一个结构化规划状态,总结已验证进展、未解决需求和先前执行结果。它将 VLM planner 限制在一组参数化的原子子任务 schema 中,这些 schema 已知可由 VLA 执行。每个 schema 编码适用条件、语义参数、可观察的进展与完成条件、可识别的失败条件以及执行预算。给定长时程目标、当前与近期视觉观测、规划状态、可允许的 schema 集合和检索到的上下文记忆,VLM planner 选择并实例化下一个子任务,如下:
uj=PVLM(G,Oj,hj,Sj,Rj).输出是语义目标,而不是可调用技能或脚本化动作序列。harness 将其转换为固定的自然语言指令,VLA 在有界调用内通过原生键盘鼠标动作执行该指令。
在控制交接方面,系统使用证据驱动协议。在每次有界 VLA 调用期间,任务完成状态检测器估计当前指令的完成概率。当该概率超过置信阈值,或执行预算耗尽时,控制权返回给 harness。该机制检测候选完成,而不是执行失败。随后,harness 使用当前与近期视觉观测验证进展和完成条件,并将结果记录为成功、失败或中断。验证后,当完成条件满足时推进;当子任务仍可恢复时尝试局部恢复;当恢复不可行、子任务不再适用或视觉状态发生显著变化时,从更新后的状态重新规划。
harness 还围绕经过验证的状态转移维护紧凑的结构化记忆。工作记忆对应当前规划状态,记录活动目标、当前原子子任务、已验证进展、未解决需求和近期失败。情节记忆存储每次 VLA 调用前后的规划状态,以及所选子任务、结果、执行成本和诊断信息。程序记忆存储从经过验证的成功执行中推导出的参数化子任务之间的可复用依赖关系。世界记忆存储从视觉观测推断出的地标和空间关系。在每个高层步骤中,工作记忆被直接使用,并从其他存储中检索相关条目以形成上下文记忆。
低层 VLA policy 将子任务指令和第一人称观测映射为原生键盘鼠标动作。该 policy 从 Qwen2.5-VL-7B 初始化,并以 20 Hz 自回归运行。由于非 GUI 和 GUI 交互需要不同的视觉运动技能,作者提出了 Regime-Specific RMSNorm,即 RS-Norm,它在每个 decoder 层的 pre-attention 和 pre-MLP RMSNorm 模块中,为非 GUI 和 GUI 交互维护独立可学习的缩放向量。对于交互类型 c∈{NG,GUI},decoder 层 ℓ 和模块 q∈{attn,mlp} 处的归一化为
RMSNormℓ,q(c)(h)=γℓ,q(c)⊙d1∑i=1dhi2+ϵh,其中 γℓ,q(c) 是交互特定的缩放向量,其他所有参数保持共享。对于具有 L 个 decoder 层和隐藏大小 d 的模型,这仅增加 2Ld 个参数。
在动作表示方面,该 policy 使用 VPT 风格动作空间中的离散动作 token。键盘和点击输入被表示为离散选择,鼠标位移经过变换并量化到类别分箱中。为解决非 GUI 交互中的相机旋转与 GUI 交互中的光标移动之间的歧义,作者分配了不相交的鼠标位移 token 集合,并在序列开头插入交互类型 token。这些 token 解码到同一物理动作码本,因此分支只发生在表示层面。该设计被称为 Dual-Mouse。
VLA 分三个阶段训练。第一阶段注入世界知识,使 policy 具备 Minecraft 概念和视觉基础。第二阶段使用模仿学习教授以指令为条件的原生键盘鼠标控制。第三阶段使用带环境反馈的强化学习来提高可靠性,尤其是精确 GUI 交互。对于给定初始条件,训练器采样多条轨迹,使用经验证的完成情况、最大已验证进展、执行成本和失败惩罚进行评分,并计算组内相对优势:
B(s0)={τi}i=1K,τi∼πb(⋅∣s0),Ai=σB+εARi−μB.该方法使用裁剪的 GRPO 风格更新优化信息量大的分支组,并从成功和失败分支构建局部偏好对,以 DPO 风格损失针对发散的动作片段。非 GUI 能力通过交错世界动作回放并对固定参考 policy 进行正则化来保持,即
Lpost=Lbranch+λworldLworld+λrefDKL(πθ∥πref).任务完成状态检测器是 policy 耦合的,并共享 VLA 图像编码器。它使用 Qwen2.5-VL-3B backbone,并通过在每第四个检测器 decoder 层之后经交叉注意力注入第一个动作 token 之前的最后一层隐藏状态,以 VLA policy 上下文为条件。对于第 ℓ 层检测器隐藏状态 Zt(ℓ),注入方式为
Zt(ℓ)=Zt(ℓ)+MHAℓ(LNℓ(Zt(ℓ)),Htπ,Htπ).检测器处理在查询之前采样的历史帧,将前馈网络宽度裁剪到约三分之一,并将 final-token 隐藏状态映射为两个 logits 以产生完成概率。仅当概率连续两次查询均超过阈值时,检测器才发出候选完成信号。
实验
HiSTEVE 以 GPT-4o 作为 planner、Qwen2.5-VL-7B 作为低层 VLA,在 MineStudio Bench 和 OpenHA 上进行原子执行评估,并在 LongBench 上进行长时程 agency 评估。结果表明,相比原生控制和 OpenHA baseline,该方法持续取得提升,在具身原子任务以及长时程资源、制作和探索任务上提升最大,而多步 GUI 操作、恢复和开放目标仍然困难。专门的完成检测器比经过提示的通用 VLM 提供更均衡、更准确的任务完成信号,消融实验表明 regime 特定表示、分阶段 policy 训练和 harness 编排各自都有贡献,其中 harness 对长时程协调尤为重要。
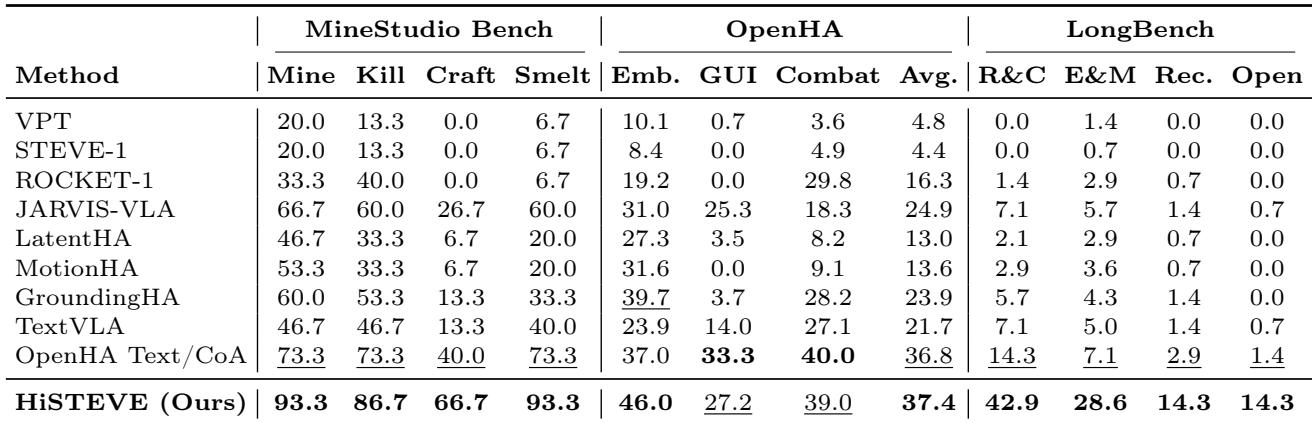
HiSTEVE 在 MineStudio 上带来大幅原子任务提升,相比 OpenHA Text/CoA baseline 有广泛改进,其中 Craft 类别绝对提升最大,但该类别仍然是最薄弱类别。在 OpenHA 上,平均提升不大且集中在具身任务上,而 GUI 和战斗仍略低于 baseline,多步 GUI 执行仍是瓶颈。LongBench 最终目标成功率在先前列出的方法中非常低,而完整 HiSTEVE harness 取得明显更高的长时程性能,这更多来自编排和验证,而非仅靠 executor 训练。最大的原子改进出现在 Craft 上,但 Craft 仍是 MineStudio 中得分最低的类别,说明多步 GUI 操作比采矿或战斗更困难。长时程成功主要来自 agent 级 harness,而不是更强的低层执行;早期 baseline 的最终目标成功率非常低。
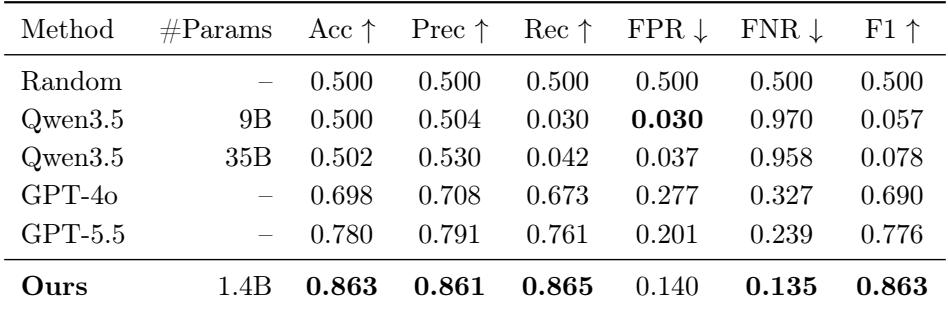
在均衡的原子子任务完成检测基准上,专门的 1.4B 检测器优于经过提示的通用视觉语言模型。通用模型的表现从强烈偏向不完成类别到中等完成检测不等,其中 GPT-5.5 是最强 baseline。该专门检测器取得最高准确率和 F1,同时保持均衡的精确率和召回率,以及最低的假阳性和假阴性率。该专门检测器比所有经过提示的 VLM baseline 取得更高的准确率和 F1,同时使用的参数少于 Qwen3.5 模型。Qwen3.5 baseline 强烈偏向不完成预测,导致召回率和 F1 非常低。在通用模型中,GPT-5.5 提供最强的完成检测性能,但仍低于专门检测器。与 GPT-4o 和 GPT-5.5 相比,该专门检测器同时降低假阳性和假阴性率,表明过早完成和漏检完成更少。
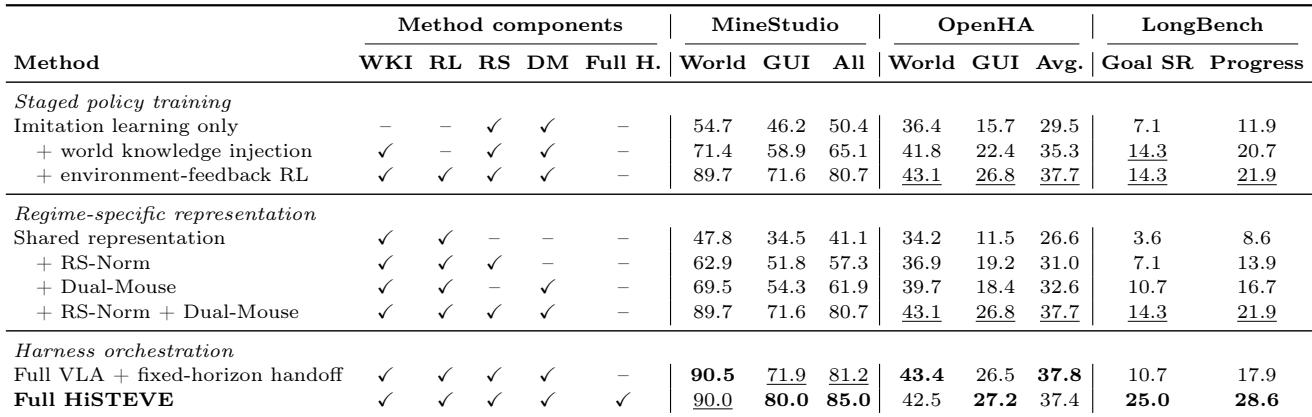
该消融分离了分阶段 policy 训练、regime 特定表示和 agent harness 编排。Regime 特定表示和世界知识注入在原子基准和长时程目标成功率上带来明显提升,而环境反馈 RL 主要改善原子执行。完整 harness 对原子指标只带来适度变化,但显著改善长时程成功率和诊断进展。共享表示是最弱配置,加入 regime 特定归一化和 dual-mouse 处理在 MineStudio、OpenHA 和 LongBench 目标成功率上产生互补提升。世界知识注入改善 MineStudio 和 OpenHA 上的低层执行,并提高 LongBench 目标成功率,但进一步的环境反馈 RL 改善原子性能,而未带来额外的长时程目标提升。在学习到的 executor 固定后,完整 agent harness 对原子基准平均值改变不大,但显著提高 LongBench 目标成功率和隐藏诊断进展。
在 MineStudio、OpenHA 和 LongBench 上,HiSTEVE 在 MineStudio 上取得最大的原子任务提升,尤其是在困难的 Craft 类别上;而长时程成功主要来自编排和验证,而非低层 executor 训练。在均衡的原子子任务完成检测基准中,专门的 1.4B 检测器优于经过提示的通用视觉语言模型,后者往往偏向不完成类别;该检测器取得更高的准确率和 F1,同时假阳性和假阴性率更低。消融实验表明,regime 特定表示和世界知识注入改善原子和长时程性能,环境反馈 RL 主要提升原子执行,而完整 agent harness 在 LongBench 目标成功率和诊断进展上带来最大提升。