Command Palette
Search for a command to run...
IQuest-Q1:提升智能体 CLI 系统的基础能力
IQuest-Q1:提升智能体 CLI 系统的基础能力
摘要
我们提出了 IQuest-Q1,一个稀疏混合专家(MoE)智能体基础模型,总参数量为 320B(激活 15B)。IQuest-Q1 通过三阶段流程开发而成:(1)稳定高效的预训练,结合 Stable SplitNorm、Muon 和 μP,并采用两阶段课程,其中第二阶段提高编程数据的混合比例,从而在安全学习率与最优学习率之间保持较宽的稳定性裕度;(2)细粒度的中期训练,扩展跨领域和跨格式的数据混合并逐步延长上下文;以及(3)多脚手架、多版本的后训练,结合 SFT、领域专用强化学习和 MOPD,跨多种脚手架整合互补的训练信号,增强智能体编程能力。此外,模型合并将不同专家和不同阶段的检查点组合起来,同时缓解其参数更新之间的冲突。最终得到的 IQuest-Q1 在编程和通用任务上均展现出能力。我们将 IQuest-Q1 作为开源模型发布,以支持社区研究与开发。
一句话总结
IQuest Research 推出 IQuest-Q1,这是一个 320B 参数稀疏 Mixture-of-Experts agentic 基础模型,每个 token 激活 15B 参数,通过 Stable SplitNorm、Muon 和 μP 预训练(采用以编码为主的两阶段课程)、领域扩展且渐进式扩展上下文的 mid-training,以及多 scaffold 的 post-training(结合 SFT、领域专用 RL 和 MOPD,并通过缓解冲突的模型合并)训练而成,并以开源形式发布,用于 agentic CLI、编码和通用任务。
核心贡献
- 该论文介绍了 IQuest-Q1,一个开放权重稀疏 Mixture-of-Experts agentic 模型,总参数 320B,每个 token 激活 15B,针对 CLI 交互进行优化,并发布以支持社区研究。在 DeepSWE v1.1、CyberGym、NL2Repo、JobBench、Agents’ Last Exam 和 Humanity’s Last Exam 上的评估报告了其在编码、通用 agentic 任务和推理方面的能力。
- 该论文提出了一套以 CLI 为中心的多阶段训练流水线:使用 Stable SplitNorm、Muon、μP 和两阶段课程进行稳定预训练;通过扩展数据和上下文进行细粒度 mid-training;以及结合 SFT、领域专用强化学习和多教师 on-policy 蒸馏的 multi-scaffold post-training。模型合并进一步整合来自不同阶段的专家模型和检查点,同时缓解参数更新冲突。
- 该论文展示了一种 human-on-the-loop 递归自我改进过程,其中 IQuest-Q1 参与内部模型开发基础设施,在人类监督下评估能力并提出改进建议,从而助力后续模型开发并缩短开发周期。
引言
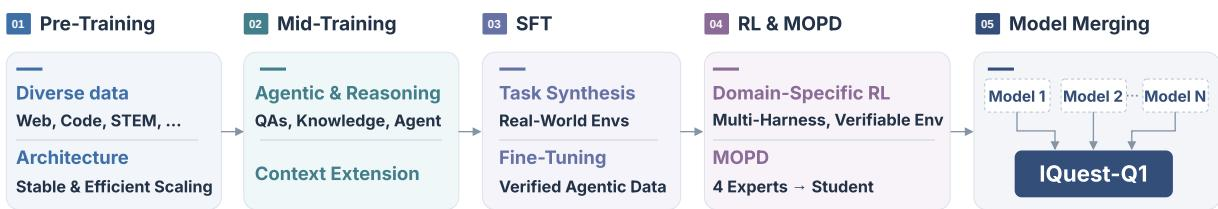
基于 LLM 的 agent 越来越需要通过命令行界面操作,以使用工具、访问文件和执行代码,这使得 CLI 能力成为通用和软件工程 agent 的核心要求。先前工作仍在可靠的长周期 CLI 执行、跨不同 agent 执行框架的稳健工具使用,以及从编码到网络安全任务的广泛覆盖方面面临挑战。作者推出 IQuest-Q1,这是一个开放权重稀疏 Mixture-of-Experts 模型,总参数 320B,每个 token 激活参数 15B,并通过以 CLI 为中心的多阶段流水线训练,该流水线结合了课程预训练、长上下文 mid-training 以及带强化学习和多教师蒸馏的 CLI 聚焦 post-training。
数据集
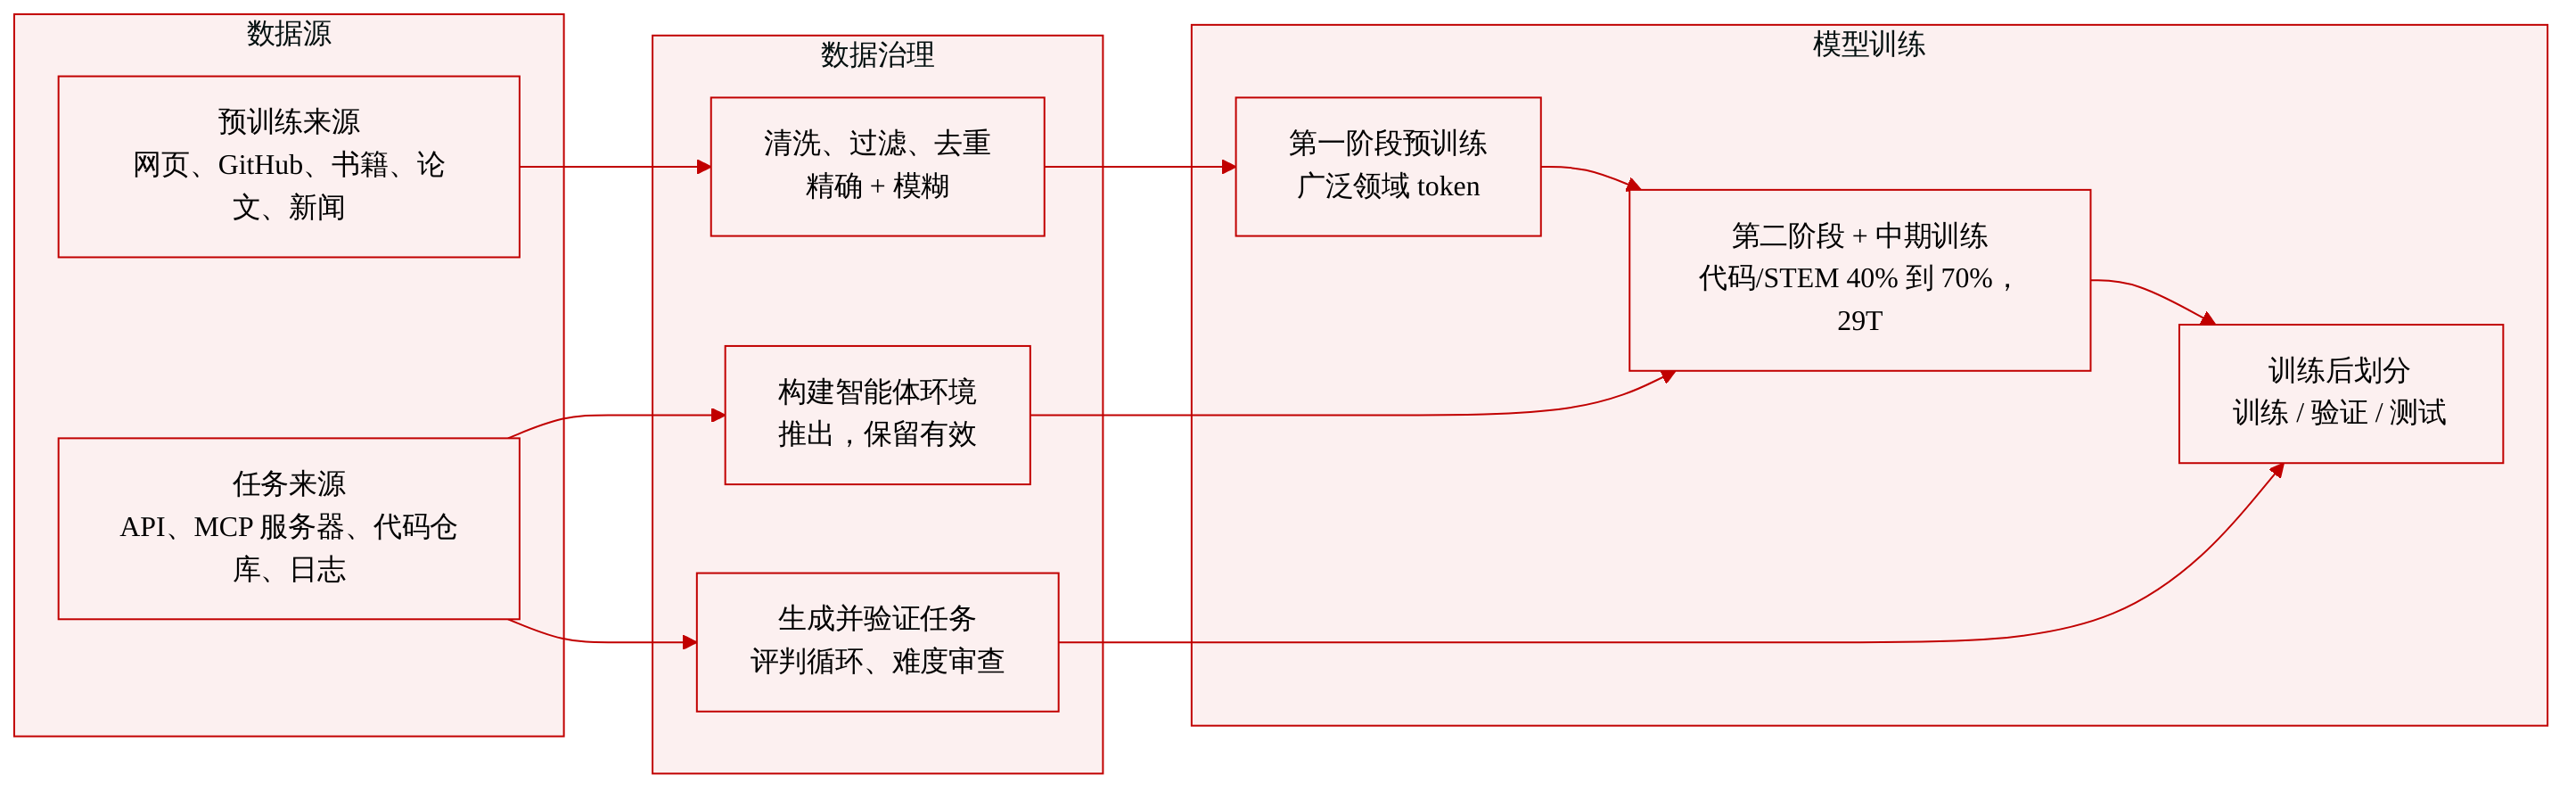
作者描述了跨 pre-training、mid-training 和 post-training 的数据集构建。
-
预训练语料库
- 来源:网页、公开 GitHub 代码、书籍、学术论文、新闻和领域特定材料。
- 代码数据保持编程语言、模态和任务粒度方面的多样性。
- 处理流程:统一流水线,包括清洗、质量过滤、精确去重和模糊去重。
- 使用方式:
- 阶段 1 使用多样语料构建基础语言和通用知识,最大化跨领域的唯一 token 数。
- 阶段 2 增加代码和 STEM 数据,通过四阶段流水线将代码数据占比从 40% 提高到 70%。
- Mid-training 结合高质量自然语料、QA 对和 agentic 轨迹。
- 预训练和 mid-training 总量:29T tokens。
-
用于 mid-training 的 agentic 轨迹数据
- 来源:选定的轨迹用作行为锚点,加上预训练文档以扩展技术和任务覆盖。
- 构建方式:从兼容代码仓库构建可执行、容器化的实例。
- 规模:超过一百万个实例。
- 过滤:在每个实例上运行 agent,仅保留有效且完整的轨迹用于 mid-training。
-
Post-training 任务合成
- 通用 agent:
- 来源:来自 RapidAPI 和 Smithery 的 API 与 MCP 服务器、来自网络的公开技能以及工作区文件。
- 覆盖范围以《标准职业分类》为指导。
- 任务和环境通过先求解后细化的循环进行改进。
- 推理 agent:
- 基于文档的流水线将概念清单扩展为细粒度科学主题。
- 文档在转换为带参考答案的任务之前,经过检索、整理和过滤。
- 编码 agent:
- 来源:GitHub 仓库、工业数据、PR/issue、仓库知识图谱、文档以及清洗后的去标识化使用日志。
- 可执行环境使用 coding agent 执行框架和领域专用运行时构建。
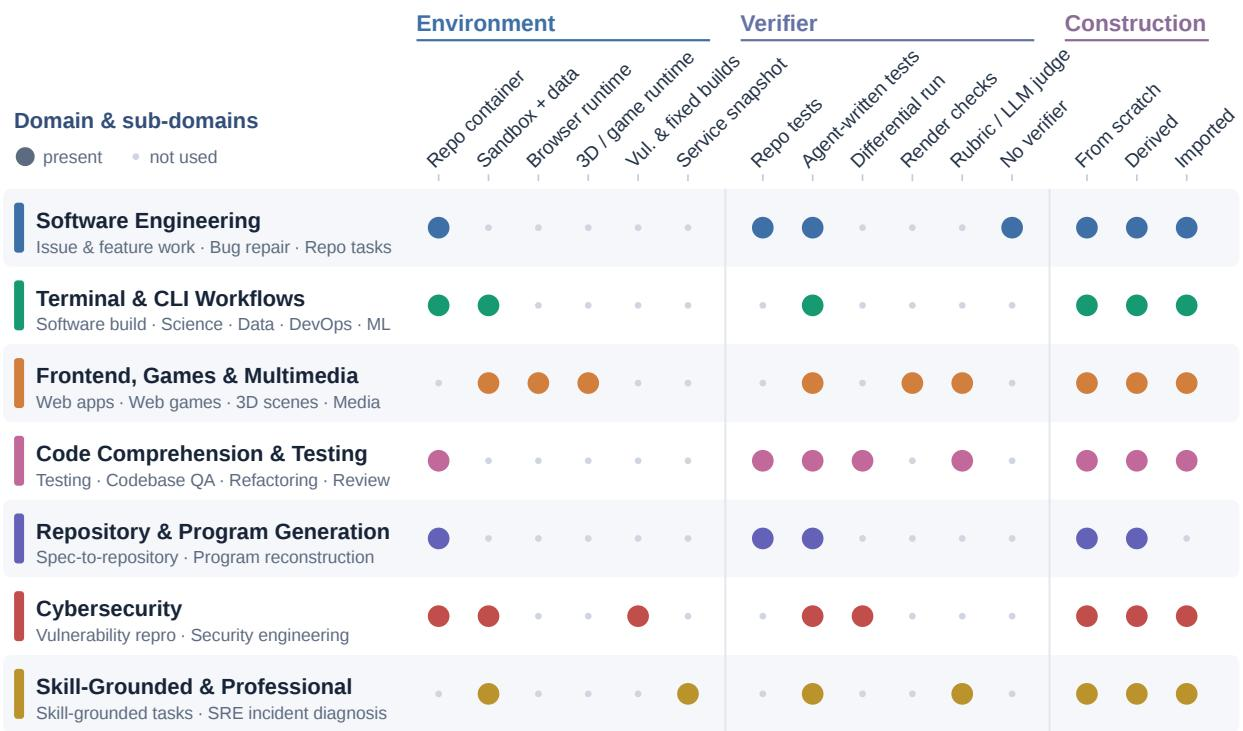
- 验证器结合 agent 编写的测试、改编的仓库测试以及来自文档化行为的检查。
- 离线实例用本地 fixture 或 mock 替换外部依赖。
- agent 评审循环检查可执行性、泄漏和一致性。
- 参考解法必须通过,而 no-op 解法必须失败。
- 基于评分标准的轨迹审查过滤作弊和低质量执行。
- 多次运行 agent 以估计难度;过于简单的实例会通过增加额外技能或约束来丰富。
- 构建模式包括从原始来源构建新环境,以及通过重新定义任务、重写、故障注入、演化、加固、修复和选择性重跑更新已验证环境。
- 最终覆盖范围包括软件工程、交互式和多模态任务、网络安全以及基于技能的专业工作。
- 通用 agent:
方法
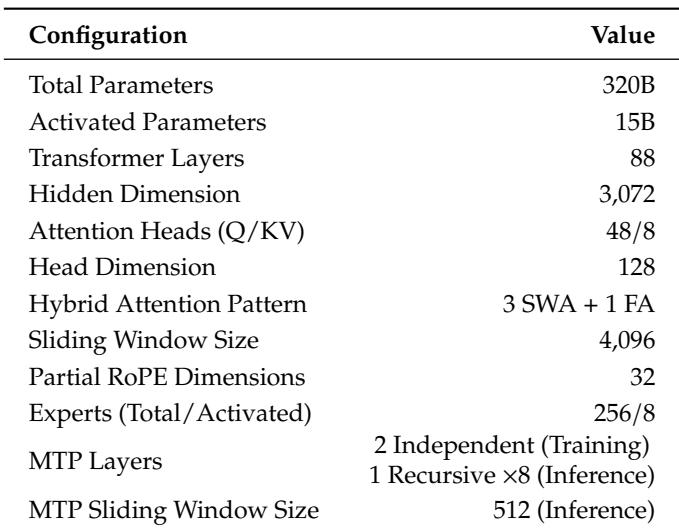
IQuest-Q1 基于 Transformer 架构,并增强了稀疏 Mixture-of-Experts (MoE) 层和混合滑动窗口注意力机制。详细架构见框架图。
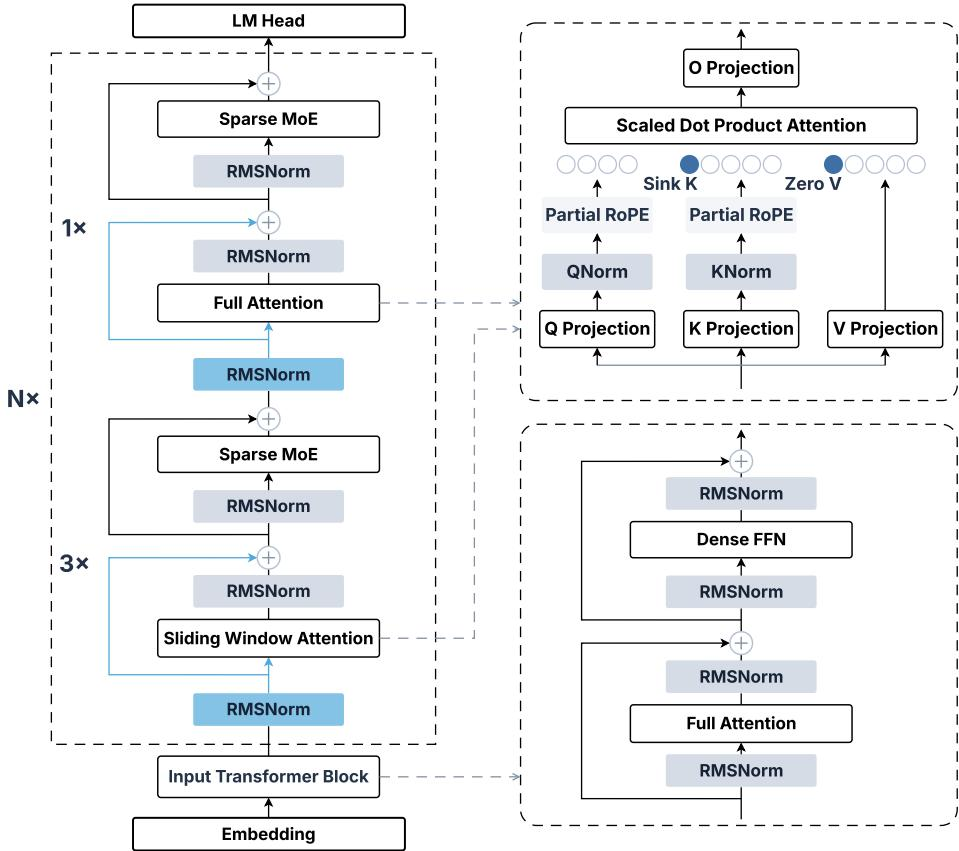
注意力栈交替使用 Grouped-Query Attention (GQA) 和 Sliding Window Attention (SWA)。在每个注意力模块中,query-aware sink token 为过量注意力质量提供自适应汇聚目标。Query-key normalization (QKNorm) 通过控制 query 和 key 的尺度来稳定注意力,并应用 QKNorm Clip 以防止仿射参数过大。Partial RoPE 仅对每个注意力头中的部分维度应用旋转位置嵌入。在前馈侧,第一个 Transformer 层用 dense MLP 替代稀疏 MoE 路由,以缓解最早期层的专家负载不均衡。为提升扩展效果,作者采用 Stable SplitNorm,这是一种混合归一化设计,在 Transformer 子层之间拆分归一化策略:进入注意力子层的残差流被归一化,而进入前馈网络 (FFN) 的残差流保持未归一化。这结合了 Pre-Norm 的稳定性优势与 Post-Norm 更强的深度利用能力。为实现高效稳定扩展,模型将 Muon 优化器与 μP 参数化相结合,支持高效优化和跨模型规模的学习率迁移。
post-training 过程通过在生产环境中执行的合成任务构建多样化的 CLI 能力。如下图所示,该流水线整合了监督微调 (Supervised Fine-Tuning, SFT)、强化学习 (Reinforcement Learning, RL)、多教师 on-policy 蒸馏 (Multi-Teacher On-Policy Distillation, MOPD) 和模型合并。
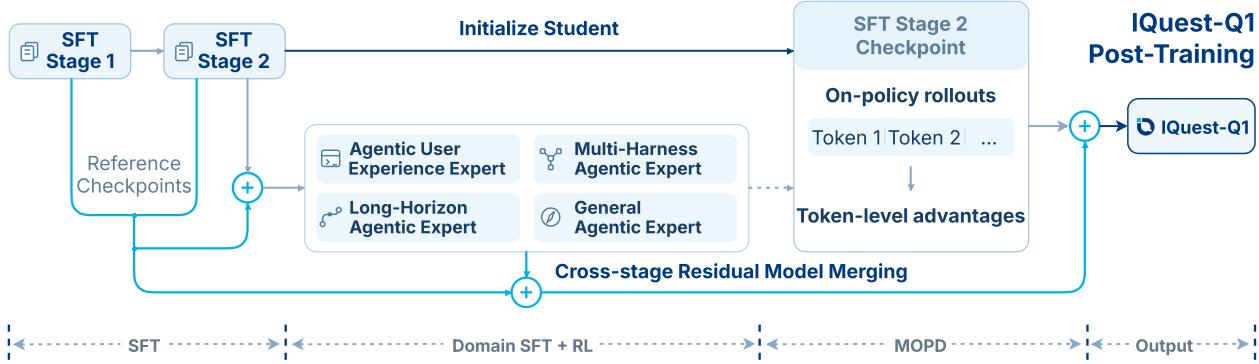
SFT 从 mid-trained checkpoint 初始化,并分两个阶段进行,以为 RL 准备策略。作者在助手回复(包括 tool-call tokens)上优化自回归交叉熵损失,同时屏蔽用户指令和工具观察。SFT 之后,模型进行以环境为中心的 RL,目标是可验证的任务完成。为整合专用策略,作者采用 MOPD,从 SFT Stage 2 checkpoint 初始化 student,并从四个冻结的专家模型中蒸馏知识,这些模型覆盖 agentic 用户体验、multi-harness 操作、长周期任务和通用 agentic 能力。蒸馏过程收集 rollouts,并根据任务领域为每个任务选择一个冻结的教师模型,使用 clipped distillation advantages 优化长度归一化的替代损失。在 post-training 各阶段中,作者将训练与跨阶段及专家模型分支内部的残差模型合并交错进行,最终将专家模型和 MOPD 检查点合并到最终模型中。
为支持这一 post-training 流水线,作者将任务合成框架组织为通用、推理和编码三类设置。对于 coding agent,作者从 GitHub 仓库和工业数据构建可执行环境。如下图所示,由此产生的任务库覆盖软件工程、终端和 CLI 工作流、前端与多媒体、代码理解、仓库生成、网络安全以及基于技能的专业工作等多个领域,每个领域使用特定的环境、验证器和构建方法。
实验
实验从受控扩展对比到 agentic 基准和应用 CLI 工作流对 IQuest-Q1 进行评估。扩展实验表明,该模型比 Qwen3-MoE 风格基线获得更好的训练效率,并在模型规模增大时保留了可观的稳定性余量。预训练通过留出轨迹似然和原子能力检查进行跟踪,下游评估覆盖仓库级编码、通用工具使用、搜索和推理;结果表明其具有广泛的 agentic 能力,但专家级推理仍是剩余差距。其他研究验证了交互式前端生成、人类监督下的迭代模型开发以及防御性网络安全支持,包括在真实部署中经专家验证的漏洞报告。
IQuest-Q1 使用深度混合注意力 transformer,其前馈层为稀疏 Mixture-of-Experts。注意力在滑动窗口注意力和全注意力之间交替,全注意力集中在模型边界并在内部周期性重复。该架构总参数量非常大,但每个 token 仅激活一小部分参数。重复的混合注意力模式使用三个滑动窗口注意力层后接一个全注意力层,而前两层和后两层使用全注意力。大多数前馈层是包含数百个被路由专家的稀疏 Mixture-of-Experts 层,第一层保持 dense。总参数远大于激活参数,体现了稀疏专家路由。注意力层中应用 Partial RoPE 和 query-aware sink attention,滑动窗口注意力和全注意力使用不同的旋转基底。
IQuest-Q1 展现出强大的仓库级编码能力,在 CyberGym 上处于领先,并在多语言和仓库生成基准上取得有竞争力的结果,不过 Claude Opus-5 和 GPT-5.6 Sol 在若干更难的编码任务上仍保持明显领先。在通用能力方面,模型表现出较强的科学与数学推理以及搜索或工具使用性能,而专家级推理仍是相对短板,尤其在无工具支持时。在已有结果可比较的模型中,IQuest-Q1 报告了最高的 CyberGym 分数,略高于 GPT-5.6 Sol。在 SWE-bench Multilingual 和 NL2Repo-Bench 上,IQuest-Q1 仅次于 Claude Opus-5,并优于其他比较模型。Claude Opus-5 在 SWE-Bench Pro 和 ProgramBench 上大幅领先,而 IQuest-Q1 在这些基准上处于中等到较低区间。IQuest-Q1 在 GPQA Diamond 和 IMOAnswerBench-Verified 上得分超过 90,但 HLE 在无工具时 39.2、有工具时 55.7 的得分表明专家级推理仍有提升空间。
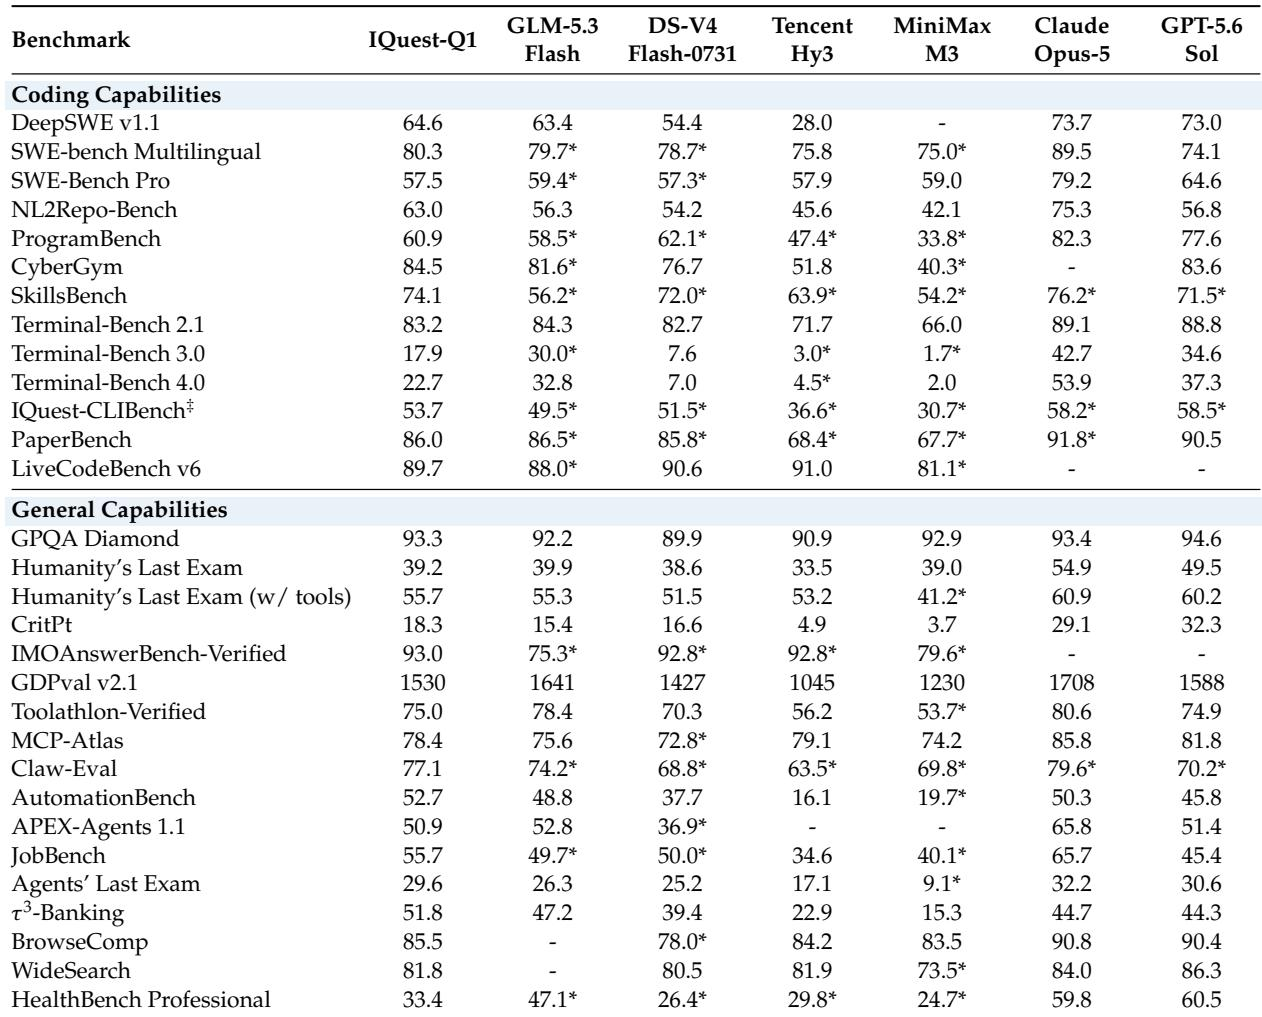
IQuest-Q1 被评估为一种稀疏 Mixture-of-Experts 混合注意力 transformer,交替使用滑动窗口注意力和全注意力,兼具大总容量和低每 token 激活。评估覆盖仓库级编码、多语言和仓库生成基准,以及通用推理、科学、数学、搜索和工具使用。该模型在 CyberGym 上展现出领先的仓库级编码性能,并在多语言和仓库生成任务上取得有竞争力的结果,同时通用能力在科学推理和工具使用方面表现强劲。专家级推理仍是相对薄弱环节,尤其在无工具支持时。