Command Palette
Search for a command to run...
USERARENA:面向长时程购物智能体的交互式用户模拟基准评测
USERARENA:面向长时程购物智能体的交互式用户模拟基准评测
Jujia Zhao Jiakai Tang Jing Yu Wen Chen Jian Wu Han Zhu Fei Sun Suzan Verberne Zhaochun Ren
摘要
智能体式推荐通过一系列上下文相关的决策来达成购物者目标。开发与评估此类策略需要高保真的推荐世界模型,这些模型既要刻画交互式购物环境,也要刻画用户在长程交互中的行为响应。现有资源很少提供长时程、细粒度的真实用户轨迹,也很少支持轨迹级别的评估以及对照生产环境 A/B 结果的离线验证。我们提出了 USERARENA,一个真实电商交互式基准,包含来自 11,010 名用户的 64,729 条会话轨迹,覆盖 566,102 个商品和 13 种动作类型。USERARENA 将这些轨迹与一个交互式环境相结合,并支持对照受控生产环境 A/B 测试结果进行离线验证,从而实现从输出有效性和局部决策到序列行为、个性化以及结果五个层面的评估。为了在这些长时程交互中提高模拟器保真度,我们进一步提出了 On-Policy Trajectory Distillation(OPTD)方法,该方法利用轨迹级意图在由学生模型生成的展开轨迹上提供密集的教师目标。实验表明,在 USERARENA 的评估协议下,OPTD 在所评估的模拟器中取得了最强的整体保真度,并在离线模拟中最接近地复现了生产策略效果。
一句话总结
来自莱顿大学、中国人民大学、阿里巴巴集团和中国科学院计算技术研究所的研究人员提出了 USERARENA,一个真实世界电商交互基准,包含来自 11,010 名用户的 64,729 条会话轨迹,涉及 566,102 个商品和 13 种动作类型;并提出 On-Policy Trajectory Distillation (OPTD),利用轨迹级意图对学生生成的 rollout 进行蒸馏,在所评估的模拟器中取得最强的整体保真度,并最接近地复现生产 A/B 策略效果。
核心贡献
- 论文提出了 USERARENA,一个真实世界电商交互基准和环境,包含来自 11,010 名用户的 64,729 条长程会话轨迹,涉及 566,102 个商品和 13 种动作类型,并提供五级评估协议和针对受控生产 A/B 测试的离线验证。
- 该工作提出 On-Policy Trajectory Distillation (OPTD),利用轨迹级意图和对学生生成 rollout 的密集教师目标,解决长程用户模拟中的稀疏奖励和曝光偏差问题。
- 实验表明,OPTD 在 USERARENA 评估协议下取得最强的整体模拟器保真度,并在离线模拟中最接近地复现生产策略效果。
引言
语言和多模态 agent 的近期进展使 agentic 推荐成为可能,其中策略会做出一系列依赖上下文的决策。评估和优化此类策略需要一个可扩展的推荐世界模型,同时模拟购物环境和用户响应,从而减少对昂贵在线实验的依赖。先前资源提供行为数据和交互式评估,但很少提供跨多次会话对齐真实用户画像、视觉观察、商品上下文和动作的长程轨迹。评估也倾向于衡量逐步的下一动作一致性,而非长程行为保真度,并且很少验证基于模拟器的策略比较是否与生产 A/B 结果一致。为解决这些不足,作者提出了 UserArena,一个具有基于生产环境的购物环境和来自大型电商平台真实用户轨迹的交互式基准,并配有五级评估协议。作者还提出 On-Policy Trajectory Distillation (OPTD),利用轨迹级意图和对学生生成 rollout 的密集教师监督,改善高保真的长程用户模拟。
数据集
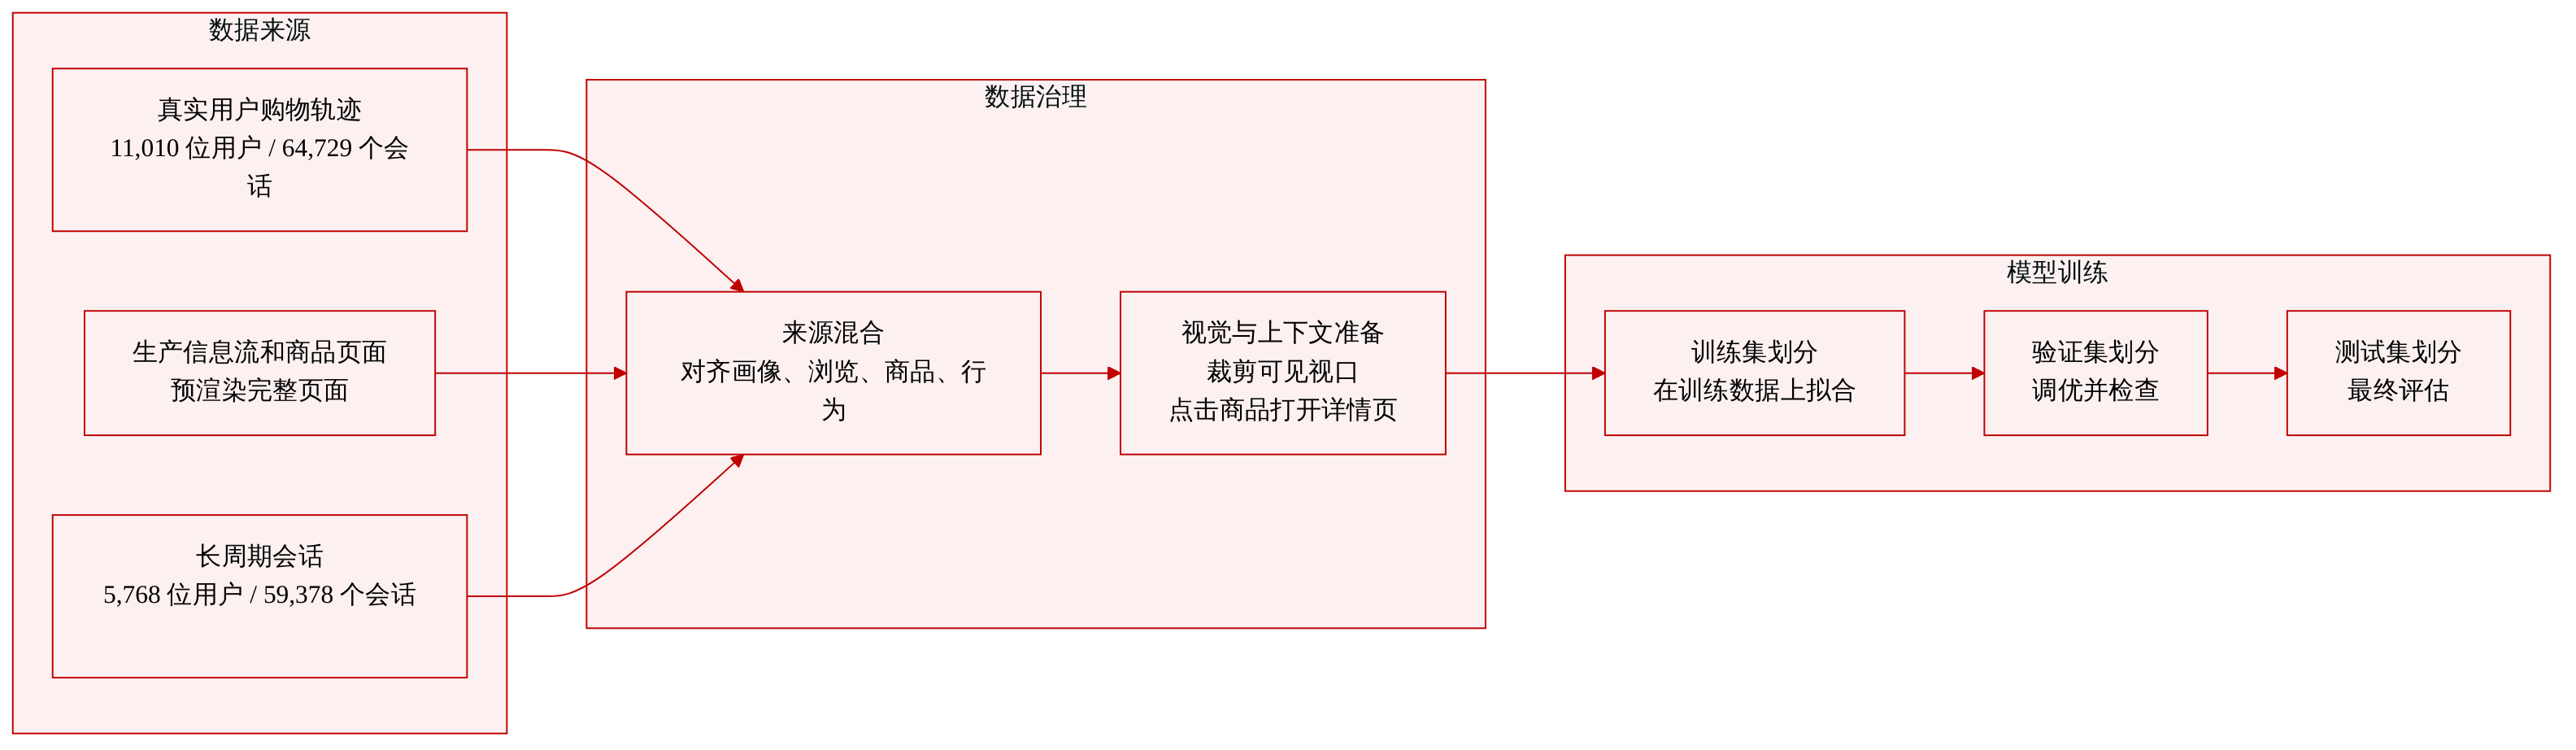
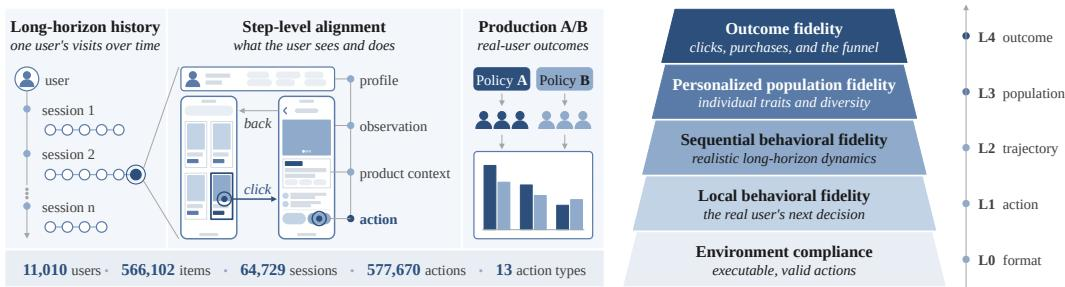
作者将 USERARENA 介绍为一个基于生产环境构建的电商交互基准,构建自真实用户购物轨迹。数据集描述重点关注其组成、规模、处理方式和评估用途。
-
总体组成与规模:数据集包含 11,010 名用户、64,729 个会话、577,670 个动作和 566,102 个商品。它包含 6 种用户属性,并记录跨 41 个商品类别的 73,717 次商品点击。
-
来源与交互设计:数据来自重建推荐信息流和商品详情页的生产购物环境。动作空间包含 13 种动作类型,包括信息流导航、商品查看、加入购物车和购买。每条记录决策都对齐购物者画像、视觉观察、可见商品上下文与动作。
-
视觉处理:推荐信息流被预渲染为完整页面。在模拟过程中,随着模拟器滚动,可见视口从预渲染的完整信息流中裁剪出来。点击露出商品会打开一个交互式详情页,该详情页由该商品的预渲染视图和记录的商品内容重建。
-
长程子集:为了跨会话评估,USERARENA 将来自 5,768 名用户的 59,378 个按时间排序的会话组织为长程轨迹。这些轨迹平均每个用户包含 10.29 个会话和 86.36 个动作。
-
评估用途:该数据集用于轨迹级评估,而不仅是下一动作一致性评估。它还支持与同一推荐策略对的受控生产 A/B 结果进行离线模拟比较。
方法
作者提出 On-Policy Trajectory Distillation (OPTD),通过提取轨迹级意图,并利用它为学生策略提供密集的 token 级监督,来建模长程购物行为。该方法解决了标准监督微调中固有的训练与测试不匹配问题,以及强化学习方法中粗粒度信用分配问题。
如下图所示:
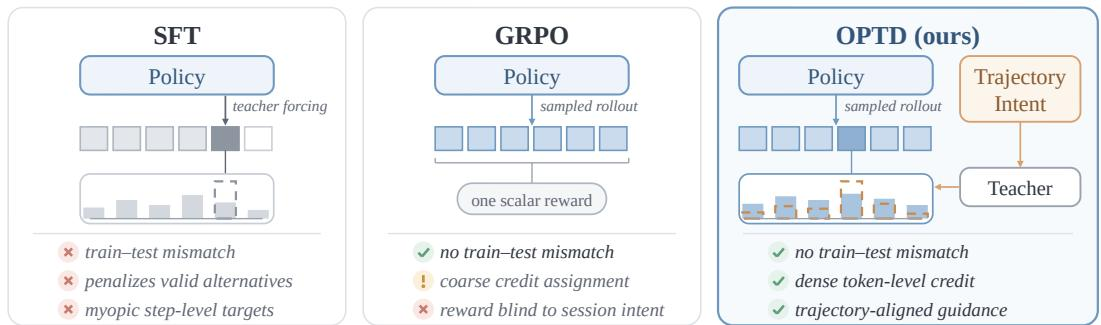
为使训练与自回归推理对齐,作者将学生策略 πθ 视为生成器,并使用 on-policy 采样对其进行优化。在每个训练步骤中,从经验分布中抽取真实状态 xt,并从当前策略中采样完整响应 yt:
yt=(yt,1,…,yt,∣yt∣)∼πθ(⋅∣xt)这使模型在训练期间暴露于自身生成的前缀,从而缓解教师强制训练与实际推理之间的差异。
为引导学生策略朝向覆盖整个会话的行为模式,该框架引入轨迹级意图监督。一个大语言模型作为提取器 E,将完整训练轨迹 τu 映射为抽象意图摘要 zu=E(τu)。该结构化记录捕捉轨迹范围内的偏好和决策倾向,而不会泄露具体动作或未来状态。参数为 ϕ 的冻结教师模型随后计算以意图为条件的下一 token 分布:
qt,kI(v)=Pϕ(v∣xt,zu,yt,<k)学生策略从不直接观察 zu;只能通过教师生成的 token 分布获得引导。
为防止学生策略过度依赖仅在训练中可用的特权信息,作者实施逐 token 的信赖域正则化。通过在没有意图上下文的情况下查询教师,构建无条件参考分布 qt,k0(v)=Pϕ(v∣xt,yt,<k)。最终目标分布通过对两个分布在对数概率空间中进行插值形成:
qt,kλ(v)=softmax(logqt,k0+λ(logqt,kI−logqt,k0))对于每个 token,算法选择最大插值系数 λt,k⋆∈[0,λmax],使得 Kullback-Leibler 散度 DKL(qt,kλ∥qt,k0) 保持在预定义预算 ϵ 内。这确保意图引导在每个生成步骤都受到自适应约束。
总体训练目标将蒸馏项与基础项结合:
L=Ldist+γLGT蒸馏损失 Ldist 使用广义 Jensen-Shannon 散度在每个生成 token 上匹配正则化目标 qt,kλt,k⋆,即使在学生与目标差异较大时也保持有界。基础损失 LGT 对记录响应 yt⋆ 应用标准教师强制交叉熵,以提供步骤级监督。这两个损失共同将会话范围意图与状态级行为基础有效结合。
实验
USERARENA 基准重建了基于生产环境的购物环境,具有细粒度真实用户轨迹,并在从下一动作解析到长程结果的五个保真度级别上评估模拟器。在使用相同基础模型的受控比较中,OPTD 在单会话和跨会话设置下的大多数行为保真度指标上优于基于文本和基于 GUI 的模拟器。生产 A/B 验证进一步表明,OPTD 最接近地复现真实用户策略效果,同时消融实验确认每个训练组件都有贡献,人工评估也将其生成的轨迹评为比强基线更接近人类行为。
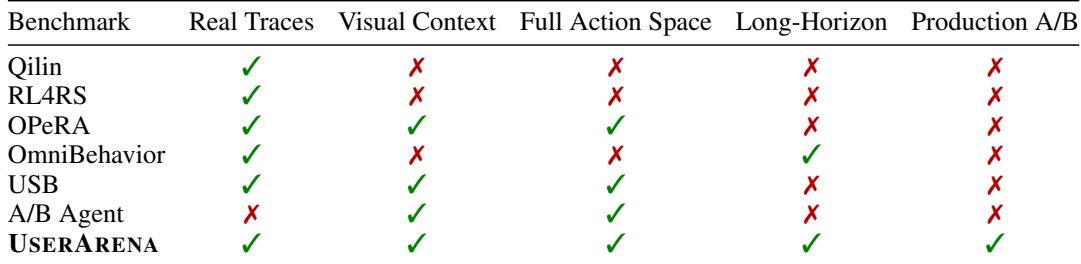
在代表性交互式推荐基准中,大多数提供真实用户轨迹,但对视觉上下文、完整动作空间、长程历史和生产 A/B 验证的覆盖不均衡。长程覆盖和生产 A/B 验证尤其罕见,且没有其他所列基准同时具备全部五项能力。USERARENA 是唯一同时包含真实轨迹、视觉上下文、完整动作空间、长程行为和生产 A/B 验证的系统。几乎在所有所列基准中都有真实用户轨迹,唯一例外是 A/B Agent。视觉上下文和完整动作空间同时出现在 OPeRA、USB、A/B Agent 和 USERARENA 中。长程覆盖并不常见,仅出现在 OmniBehavior 和 USERARENA 中。生产 A/B 验证在所有其他所列基准中都缺失,仅出现在 USERARENA 中。
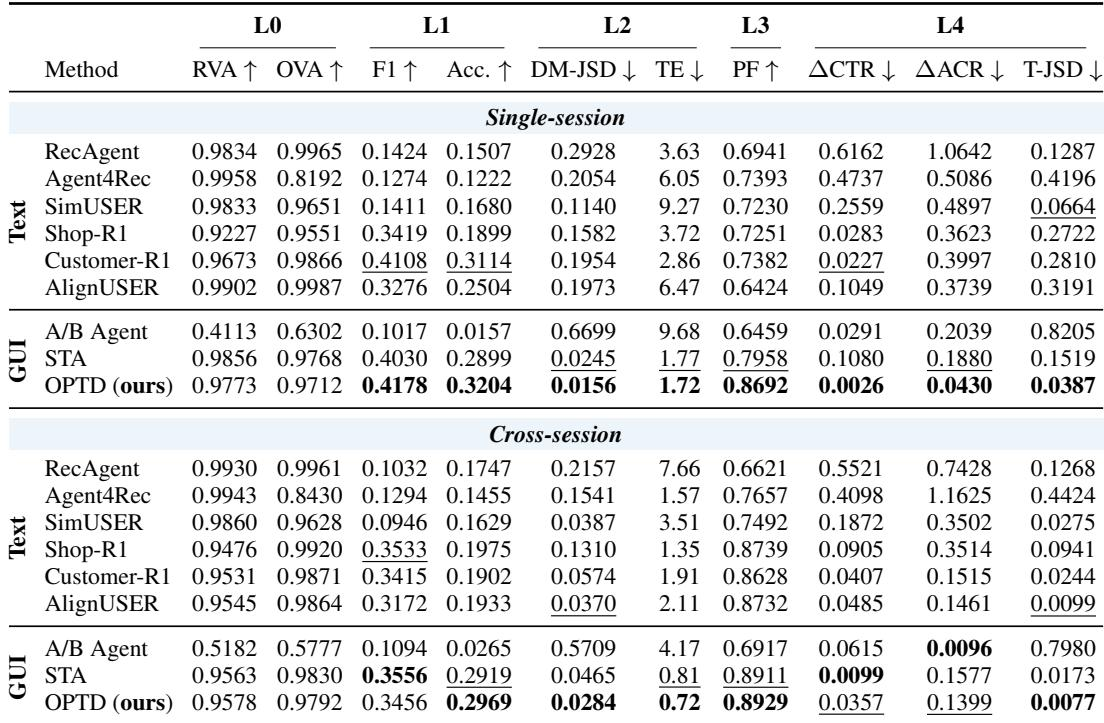
OPTD 在单会话和跨会话评估中均取得最佳整体表现。在单会话中,它在所有报告的 L1-L4 指标上排名第一;在跨会话中,它在八个指标中的五个上排名第一,并在另外两个上排名第二,尤其是顺序和个性化人群保真度表现突出。其他模拟器表现出较窄的优势,例如 STA 在部分局部和结果指标上占优,Customer-R1 在局部预测上占优。OPTD 在所有八个单会话 L1-L4 指标上排名第一,覆盖局部、顺序、个性化人群和结果保真度。在跨会话评估中,OPTD 取得最强的顺序行为保真度和最高的个性化人群保真度。STA 在跨会话的 macro-F1 和 CTR 误差上领先,而 A/B Agent 在 ACR 误差上保持竞争力,但在 replay 和 rollout 有效动作率上的迁移表现较弱。
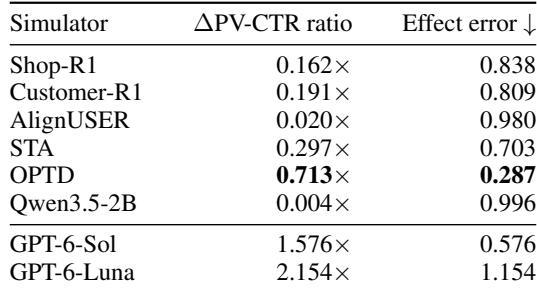
在对排名策略对的生产 A/B 验证中,OPTD 最接近地复现了页面浏览点击率的在线变化,在所评估的模拟器中取得最小的效应误差。大多数其他用户模拟器大幅低估策略效应,而 GPT-6-Sol 则高估了它。模拟器效应比率与记录的在线结果差异很大,表明行为校准存在较大差异。OPTD 在所有比较的模拟器中效应误差最低,因此与生产 A/B 结果最一致。GPT-6-Sol 是唯一效应比率高于 1 的比较模拟器,高估了在线响应。包括 AlignUSER 和 Qwen3.5-2B 在内的多个模拟器产生接近零的效应比率,表明严重低估策略效应。效应比率的分布表明,模拟器的选择会强烈影响策略比较是否与真实用户行为一致。
基准比较评估了对真实用户轨迹、视觉上下文、完整动作空间、长程行为和生产 A/B 验证的覆盖情况,并发现只有 USERARENA 同时具备全部五项能力,而长程和生产验证在其他基准中仍然罕见。在模拟器保真度实验中,OPTD 在单会话和跨会话设置下均取得最佳整体表现,在所有单会话指标和大多数跨会话指标上领先,而其他模拟器则表现出较窄的优势。排名策略对的生产 A/B 验证进一步表明,OPTD 最接近地复现了页面浏览点击率的在线变化,并取得最小的效应误差,而大多数模拟器大幅低估策略效应,一个模拟器则高估了它。