Command Palette
Search for a command to run...
让 MLLM 潜在表示发挥作用:面向电影级视频生成的因子感知预测学习
让 MLLM 潜在表示发挥作用:面向电影级视频生成的因子感知预测学习
摘要
电影级视频生成既需要从有限输入中进行时序推断(即稀疏引导而非逐帧引导),也需要对角色、场景、动作和镜头进行因子感知控制。多模态大语言模型(MLLM)为这两种能力提供了有用的先验,但其表示并不会自动适用于视频生成:视频扩散 Transformer(DiT)可能通过原生条件通路绕过这些表示,而使用这些表示也不能保证因子感知控制或与生成兼容的时序预测。我们提出因子感知预测学习(FAPL),该方法将有效利用 MLLM 潜在表示确立为共同前提,并通过互补学习信号针对上述两种能力进行优化。第一,仅潜在表示的生成器对齐(latent-only generator grounding)在冻结 MLLM 和连接器的条件下训练 DiT,增强 DiT 在生成中对 MLLM 潜在表示的利用。第二,针对因子感知控制,成对视频指定目标因子变化和非目标因子保持,因子跨度替换(factor-span replacement)训练 DiT 在其输出中实现这种关系。第三,针对时序推断,仅文本观测和文本加完整视频观测共享同一视频目标;随后冻结训练好的 DiT,并通过它优化 MLLM 和连接器。最后一个阶段训练面向生成的有限输入表示,同时保留完整观测重构作为互补训练模式。大量实验表明,在三个电影级视频生成任务(即 sparse-to-video、因子感知编辑和多镜头生成)上,我们的方法持续优于基线,并验证了 FAPL 在 MLLM 特征利用、时序控制和因子协调方面的贡献。
一句话总结
Tencent Video、LIX 和 École Polytechnique 的研究人员提出了 Factor-Aware Predictive Learning (FAPL),该方法通过仅潜在训练将冻结的多模态大语言模型(MLLM)和连接器接入视频扩散 Transformer(DiT),随后利用因子跨度替换和 DiT 冻结优化,实现稀疏到视频生成、因子感知编辑和多镜头生成中的因子感知控制与时间推理。
核心贡献
- Factor-Aware Predictive Learning (FAPL) 首先通过仅潜在生成器训练,将视频扩散 Transformer 建立在冻结的 MLLM 潜在表示之上,增强生成器在电影级视频生成中对多模态表示的利用。
- 在成对视频上进行因子跨度替换,监督目标因子的变化,同时保留非目标内容,从而实现对角色、场景、动作和镜头的因子感知控制。
- FAPL 通过冻结的生成器、利用仅文本和文本加完整视频观测的共享视频目标来训练 MLLM 和连接器,生成与生成兼容的有限输入表示;实验表明,在稀疏到视频生成、因子感知编辑和多镜头生成任务上,其性能优于基线。
引言
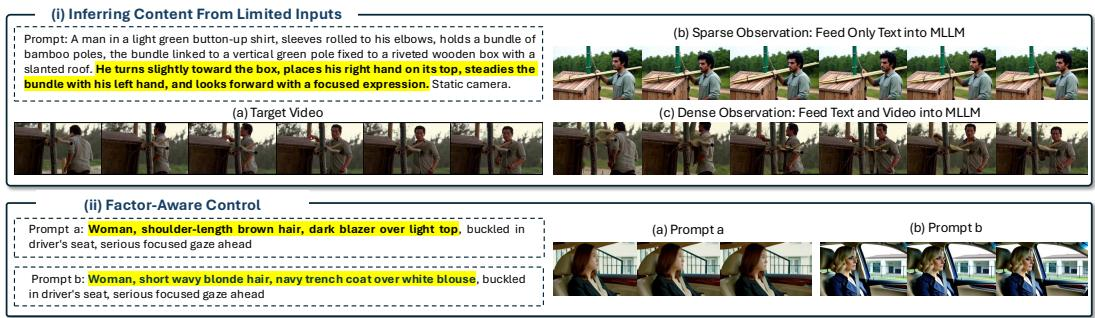
电影级视频生成帮助创作者在制作前预览内容、表演和镜头选择,但要求模型从稀疏输入中推断合理的动作和镜头运动,同时独立控制角色、场景、动作和镜头。以往基于 MLLM 条件的扩散模型常常难以让多模态特征真正发挥作用:文本和 VAE 参考通路可能绕过 MLLM 潜在表示,视频级监督也不会显式地将特定因子干预与预期变化和保留关联起来,或训练 MLLM 从有限证据中生成具有时间信息量的表示。作者提出了 Factor-Aware Predictive Learning (FAPL),一种三阶段训练策略:首先让视频 DiT 仅基于 MLLM 潜在表示,然后在成对视频之间使用因子跨度替换来监督选择性编辑和保留,最后通过固定的生成器用稀疏观测和完整观测训练 MLLM 和连接器。这在不要求完全解耦表示或增加架构复杂度的情况下,改善了电影级视频生成中的时间推理和因子感知控制。
数据集
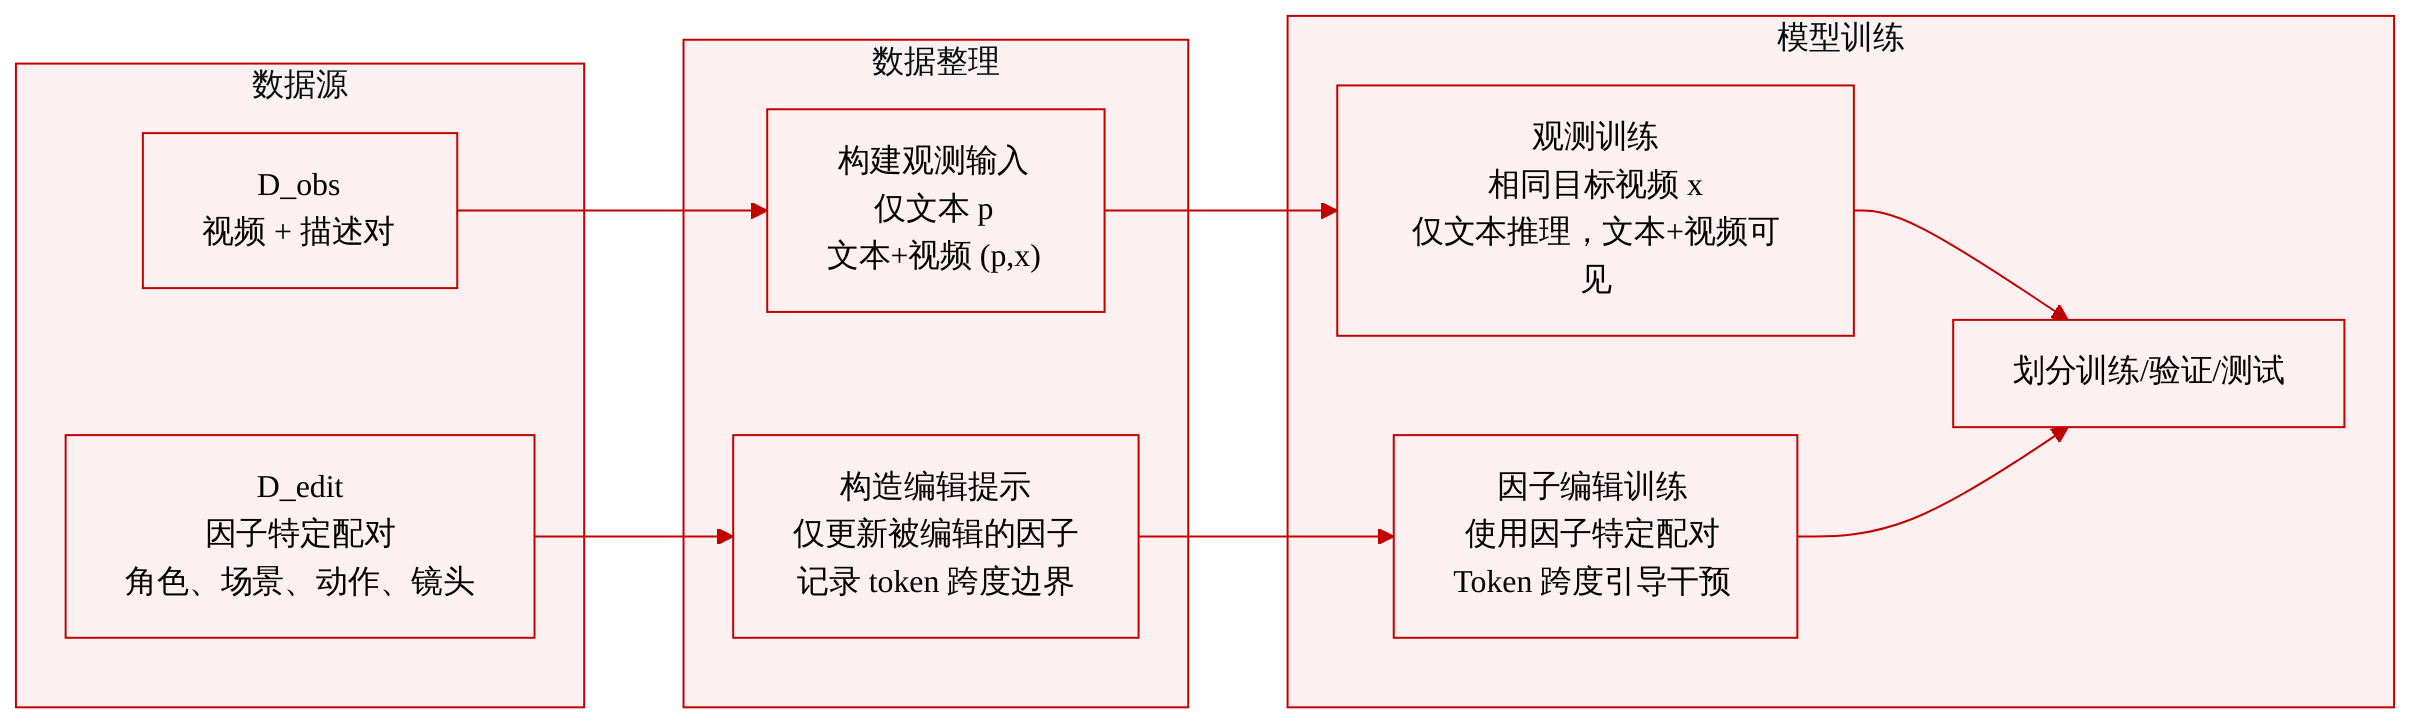
作者描述了两种成对数据组成部分:Dobs 和 Dedit。本摘录未说明底层视频数据集名称、总规模或来源筛选规则。
Dobs:观测成对数据
- 针对每个训练视频 x 和描述 p,作者创建两种输入:
- ut=p:仅文本分支。
- utv=(p,x):文本加视频分支。
- 两种输入均以同一目标视频 x 进行监督。
- 仅文本分支从不接收完整目标视频,因此必须根据描述进行推断;文本加视频分支则获得直接视觉证据。
Dedit:因子特定编辑数据
- 每个元组为 (xa,pa,xb,pb,k),包含两个视频和两个描述。
- k 属于 {character, scene, action, camera};从源到目标仅更改所选因子。
- 字幕被改写为具有四个有序字段的结构化提示:character、scene、action、camera。
- pb 仅更新被编辑的因子字段,其他字段保持不变。
- 字段标签和边界定位 MLLM 隐状态和投影潜在表示中的 token 跨度,为每个因子提供显式的干预地址。
- 跨度长度随文本变化,不同示例可能不同;作者并不假设这些上下文化跨度完全解耦。
处理与模式
- 成对示例围绕视频、结构化描述、因子标签和 token 跨度边界构建。
- 本节未描述裁剪、筛选或数据集统计信息。
数据使用方式
- Dobs 支持共享目标视频的两种观测模式。
- Dedit 支持因子特定编辑,并为后续干预提供 token 级因子位置。
方法
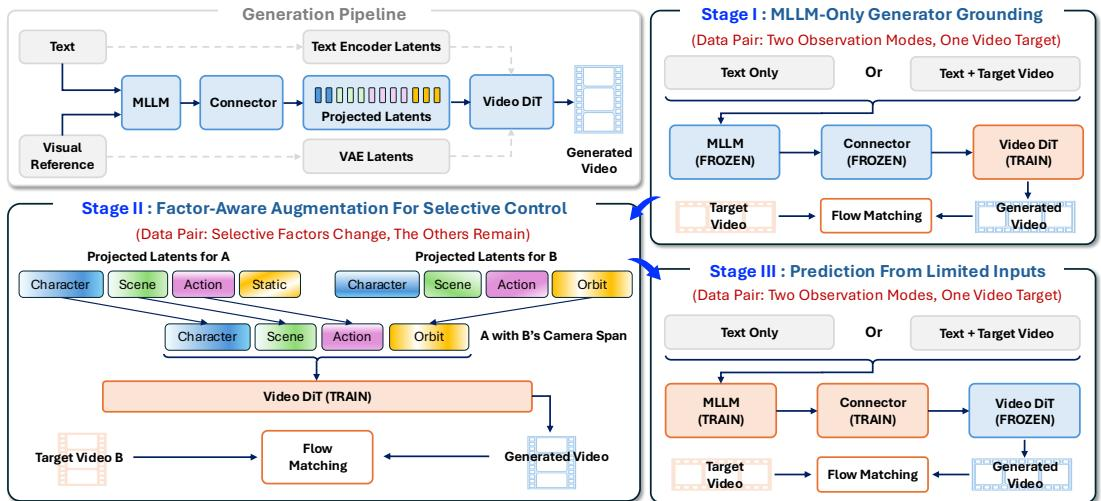
作者提出 Factor-Aware Predictive Learning (FAPL),用于训练多模态大语言模型表示,以实现有限输入的时间推理以及对角色、场景、动作和镜头的因子感知控制。该框架通过连接器将 MLLM 与预训练的视频扩散 Transformer 连接。DiT 通过流匹配训练,并接收由文本编码器特征、MLLM 特征和 VAE 编码视觉特征拼接而成的条件。MLLM 条件通过将 MLLM 隐状态 Hθ(u) 输入连接器 Pη 映射到 DiT 条件空间而得到:
Cmllm=Zθ,η(u)=Pη(Hθ(u))对于具有 VAE 潜在变量 z0 的目标视频 x,流匹配构造 zt=αtz0+σtϵ,DiT Gϕ 使用流匹配目标预测目标速度 v∗=∂zt/∂t:
LFM(x∣C;ϕ)=Et,ϵ[∥Gϕ(zt,t∣C)−v∗∥22]训练过程分为三个阶段,仅使用 MLLM 潜在表示作为内容条件,以强制依赖 MLLM 通路。
阶段 I:仅 MLLM 的生成器基础训练
为确保 DiT 可靠地解码和使用 MLLM 潜在表示,而不是依赖原生文本编码器或 VAE 参考通路,作者隔离了 MLLM 通路。他们冻结预训练的 MLLM 和连接器,仅更新 DiT 参数 ϕ。对每个视频和描述,作者同时使用仅文本和文本加完整视频输入。混合观测目标在两种模式下最小化流匹配损失:
Lground(ϕ)=E(x,p)∼Dobsm∈{t,tv}∑ρmLFM(x∣Zθ0,η0(um);ϕ)这迫使 DiT 在有限观测和密集观测两种模式下从 MLLM 潜在表示中学习。
阶段 II:因子感知控制改进
为了教会 DiT 哪些输出变化对应特定条件变化,作者引入因子级潜在增强。他们构造仅修改两个描述中一个因子的成对数据。设 Za 和 Zb 为两个描述的投影潜在表示。他们定义替换操作 Rk(A,B),将 A 中的因子 k 跨度替换为 B 中对应的跨度。增强后的条件为:
Zka←b=Rk(Za,Zb),Zkb←a=Rk(Zb,Za)DiT 使用编辑目标进行更新:
Ledit(ϕ)=E(xa,pa,xb,pb,k)∼Dedit[LFM(xb∣Zka←b;ϕ)+LFM(xa∣Zkb←a;ϕ)]这监督生成器对受控替换的响应,确保目标因子发生变化,同时保留其他内容。
阶段 III:从有限输入进行预测
在 DiT 参数固定为 ϕ∗ 的情况下,作者联合微调 MLLM 和连接器。目标是从有限观测中生成与生成过程兼容的表示。采用与阶段 I 相同的混合观测设置,他们最小化:
Lobs(θ,η)=E(x,p)∼Dobsm∈{t,tv}∑πmLFM(x∣Zθ,η(um);ϕ∗)梯度通过冻结的 DiT 回传以适配 MLLM 通路,使其能够从有限证据中重建语义、运动和时间内容,同时保持与完整视频观测的兼容性。
在推理阶段,该框架支持根据脚本和参考进行生成、通过结构化提示中的跨度替换进行因子感知控制,以及使用共享角色和场景参考进行多镜头生成。
实验
FAPL 在 13B DiT 上训练,并与 Omni-Video 2 和 UniVideo 在留出的 CineFactor-10K 样本上进行比较,覆盖稀疏到视频生成、因子感知编辑和多镜头生成。比较表明,FAPL 更忠实地遵循镜头特定的动作和镜头指令,在不干扰无关属性的情况下施加单因子编辑,并在跨镜头中保持更强的角色、场景和面部身份一致性。消融实验证实每个训练阶段都有不同收益:阶段 I 改善有限输入下的时间和镜头控制,阶段 II 的因子交换增强因子感知编辑,阶段 III 的混合完整视频观测增强仅提示的动作和镜头表现,同时保持编辑精度。
FAPL 在稀疏到视频生成、因子感知编辑和多镜头一致性方面始终优于 Omni-Video 2 和 UniVideo。仅从文本出发,它实现了更好的动作顺序和镜头轨迹保真度、更高的请求因子变化准确率,以及跨镜头中更强的主体、场景和面部身份一致性。这些结果表明指令遵循和跨镜头一致性得到改善。FAPL 在稀疏到视频生成上超过了对比模型,具有最高的运动顺序得分以及最低的平移和旋转误差。FAPL 在因子感知编辑和多镜头一致性方面领先,∩-Acc、主体一致性、场景一致性和 FaceSim-Arc 均高于 Omni-Video 2 和 UniVideo。
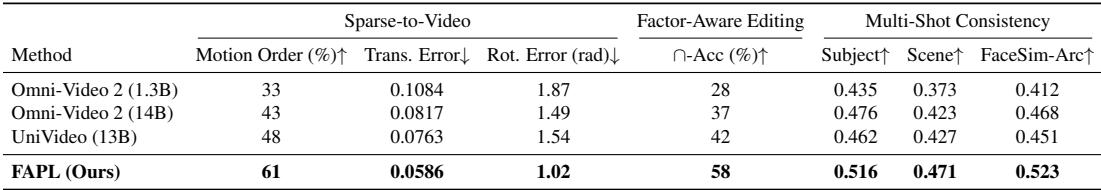
FAPL 的每个训练阶段在 UniVideo 上都有明显改进。阶段 I 改善运动和镜头质量,阶段 II 主要通过因子交换增强因子感知编辑,阶段 III 的混合观测训练进一步改善动作顺序和镜头控制,同时保持编辑精度稳定。与预训练模型相比,阶段 I 训练改善动作顺序并降低平移和旋转误差。阶段 II 中的因子交换相比不进行因子交换的训练大幅提高编辑精度,而运动和镜头指标没有明显改善。阶段 III 的混合观测训练进一步改善运动顺序和镜头误差,编辑精度与阶段 II 检查点保持相当。
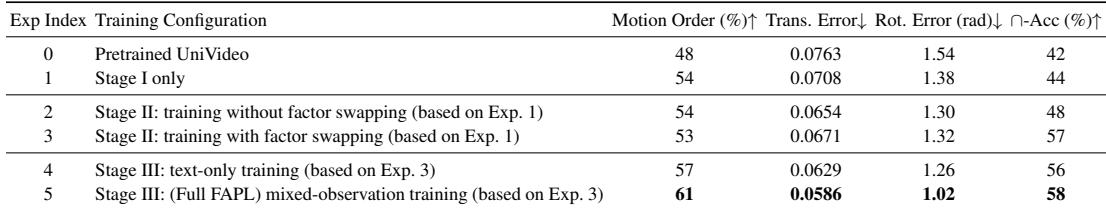
实验在稀疏到视频生成、因子感知编辑和多镜头一致性方面将 FAPL 与 Omni-Video 2 和 UniVideo 进行比较。FAPL 从文本中实现了更好的动作顺序和镜头轨迹保真度、更准确的因子编辑,以及跨镜头中更强的主体、场景和面部身份一致性。消融结果表明,阶段 I 改善运动和镜头质量,阶段 II 主要通过因子交换增强编辑精度,阶段 III 的混合观测训练进一步优化运动和镜头控制,同时保持编辑性能。总体而言,这些发现验证了 FAPL 改善的指令遵循、跨镜头一致性以及各训练阶段的互补收益。