Command Palette
Search for a command to run...
真实世界 Web 环境中的深度搜索
真实世界 Web 环境中的深度搜索
摘要
尽管 Deep Search 智能体已取得显著进展,但它们在真实世界开放 Web 环境中开展端到端研究的能力仍未得到充分评估。与静态检索场景不同,真实世界 Web 中的信息分布在多样化的来源、模态和异构格式中,往往涉及复杂的交互机制,要求智能体在执行过程中自主搜索、获取并整合相关证据。为弥补这一空白,我们提出了 OpenDS 任务,旨在评估智能体在实时、开放的 Web 中执行多步深度搜索的能力。该任务要求智能体自主探索真实 Web,通过 Web 搜索、浏览器交互和证据处理,发现并关联来自多个独立来源的相关证据,并最终确定唯一的事实性答案。基于这一任务设定,我们构建了 OpenDS-World,一个包含 200 个挑战性任务的基准,覆盖多样化的信息模态、异构文件格式和交互式访问需求,并通过独立的人工验证确保证据有效性与答案唯一性。我们在统一的工具环境和执行协议下评估了 12 个前沿模型。表现最佳的模型达到 39.0% 的准确率,而在 1,000 次独立尝试中的人类评估准确率为 21.1%。对工具使用、搜索成本、终止行为和失败恢复的进一步分析表明,不同模型在研究策略上存在显著差异,同时在工具协调和长时程搜索管理方面仍面临持续挑战。OpenDS-World 为系统评估和提升智能体在真实世界开放 Web 环境中的自主深度搜索能力提供了统一的评估平台。
一句话总结
来自香港科技大学(广州)、复旦大学、华盛顿大学等机构的研究人员提出了 OpenDS-World,这是一个包含 200 项任务的基准,用于在实时开放 Web 中进行多步深度搜索,并报告最佳前沿模型仅达到 39.0% 的准确率,而人类为 21.1%,这凸显了工具协调和长程搜索管理中持续存在的挑战。
核心贡献
- 论文提出了 OpenDS 任务,用于在实时开放 Web 上评估自主多步深度搜索,要求 agents 从多个独立来源发现、访问并整合证据,以确定唯一的事实性答案。
- 论文构建了 OpenDS-World,这是一个包含 200 项人工验证任务的基准,其证据链跨越四种模态、42 种文件格式和七种访问类型,覆盖异构在线资源与交互式访问要求。
- 论文在统一的工具环境和执行协议下评估了 12 个前沿模型。最强模型达到 39.0% 的准确率,人类评估在 1,000 次独立尝试中达到 21.1%;分析揭示了工具协调、搜索成本、终止行为和长程搜索管理中持续存在的挑战。
引言
深度搜索旨在让 AI agents 自主获取、分析并整合开放 Web 中的证据,以完成复杂研究任务,而基于 LLM 的工具增强型 agents 的发展,使得在真实 Web 环境中进行可靠评估变得越来越重要。现有基准考察工具使用、检索、持续搜索和 Web 导航,但对多种信息模态、HTML、PDF、XML 和 Parquet 等异构文件格式以及交互式访问要求的组合挑战覆盖不足;这些要求迫使 agents 在证据可用之前进行导航、操作界面或处理工件。为弥补这一不足,作者提出了 OpenDS 任务和 OpenDS-World 基准,这是一个经过人工验证的 200 项任务集合,涵盖八个领域,要求 agents 从视频锚点出发,连接来自多个开放 Web 来源的证据,这些来源具有不同模态、格式和访问机制。作者对 12 个前沿模型的评估显示,当前系统仍然面临困难,最佳模型仅达到 39.0% 的准确率。
数据集
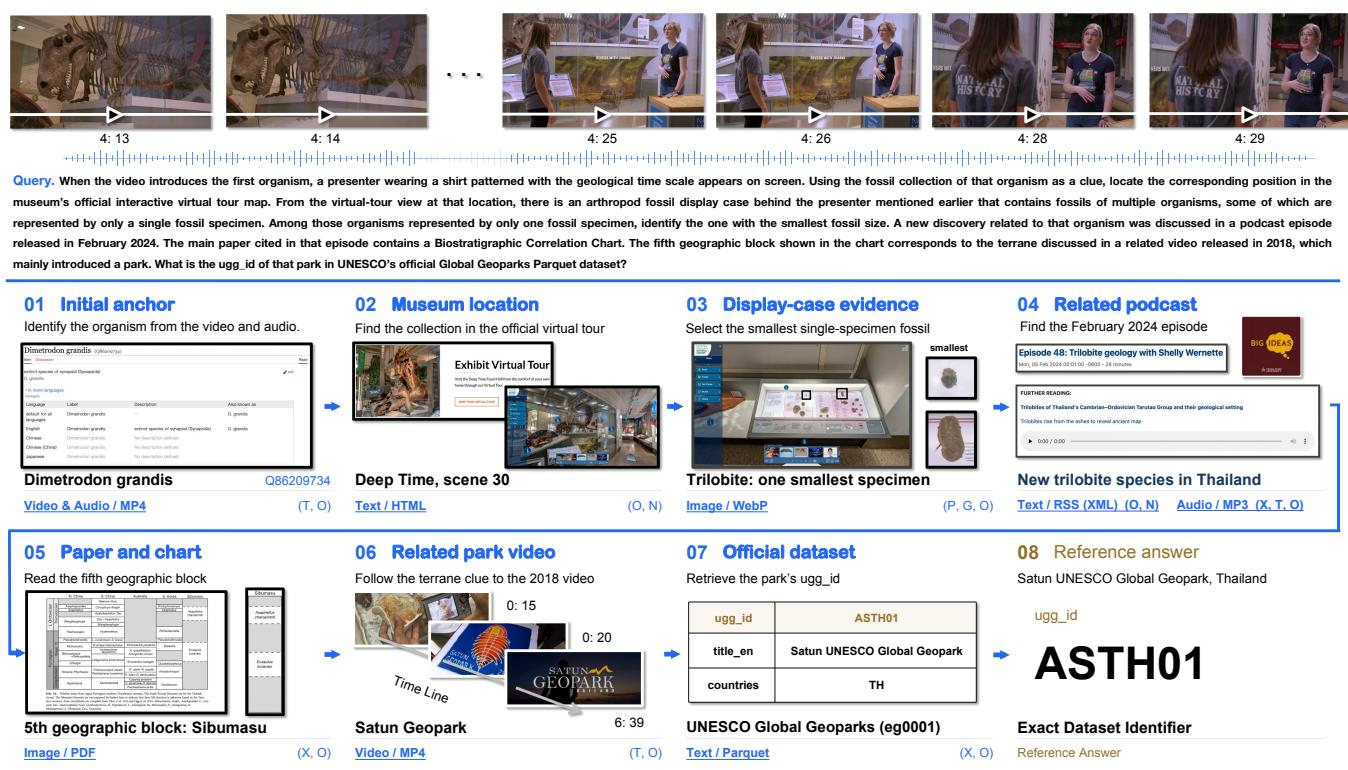
OpenDS-World:数据集概览
OpenDS-World 被提出作为一个事实型问答基准,用于在真实世界 Web 环境中评估 AI agents 的深度搜索能力。它包含 200 项任务,涵盖文化、日常生活、科学、经济、历史、自然、社会和技术。论文中的文本列出了这八个领域,但未报告每个领域的任务数量。
-
组成与来源:
- 200 项基准任务,沿证据链标注了 787 个网页或在线资源条目,平均每项任务 3.94 个条目。
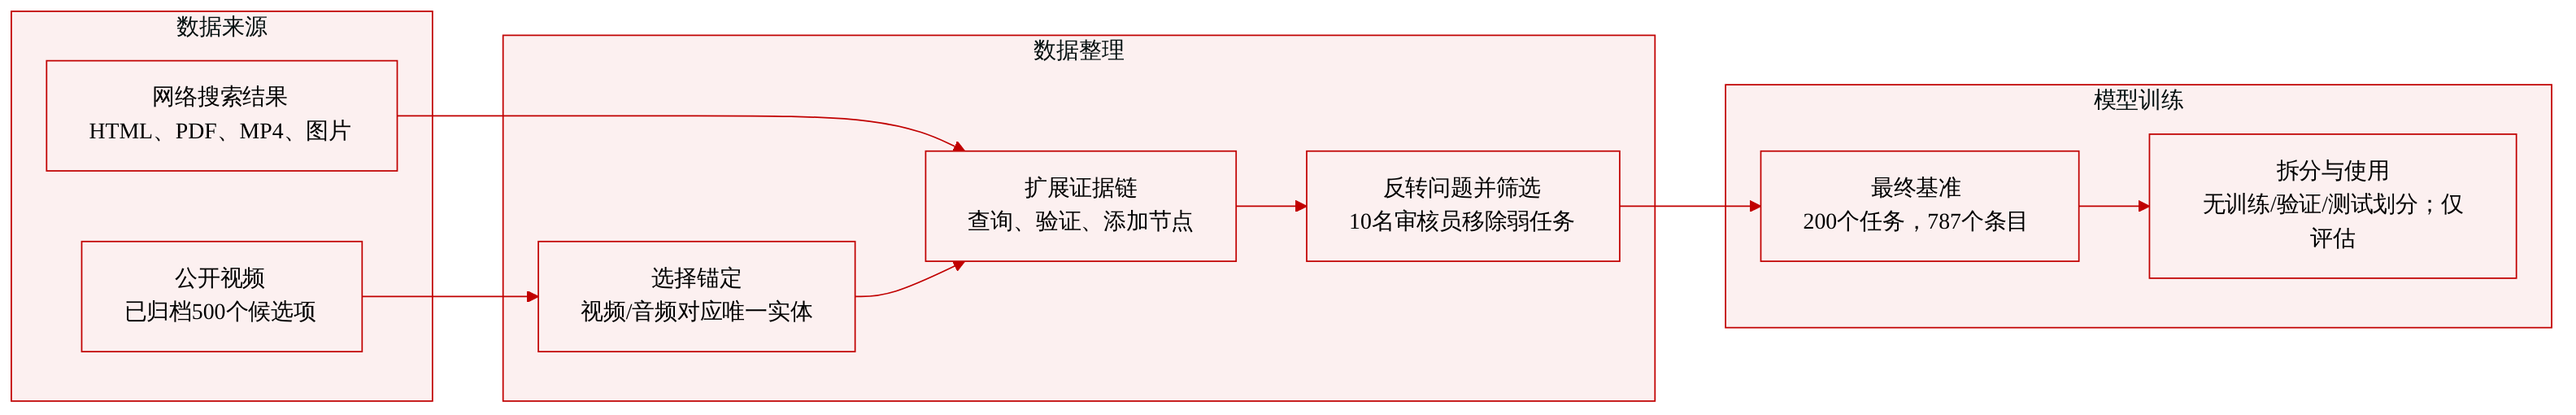
- 初始线索来自可公开访问的视频。构建阶段选择了 500 个候选视频,最终任务使用按任务 ID 匹配的存档视频输入。
- 后续证据来源通过 Google Search 发现,包括 HTML 页面、PDF、WebP 图像、MP3 音频、MP4 视频、RSS/XML、Parquet 和结构化交互资源。
-
构建流程:
- 阶段 1:标注者选择一个可公开访问的视频,并从视觉和音频内容中识别出初始锚点。该锚点必须映射到唯一有效的 Wikidata 条目,防止简单的文本页面搜索。
- 阶段 2:标注者迭代地构造搜索查询、检查 Google Search 结果、选择可验证来源、提取新实体并扩展证据链,直到到达唯一的终端节点。每个节点都必须由多个 Web 来源独立佐证。
- 阶段 3:终端节点成为参考答案。问题通过将证据路径反转为相互依赖的约束来构建,中间节点被隐藏在间接指称描述之后。
-
筛选与验证:
- 十名独立审核者检查证据有效性和任务有效性。
- 他们确认实体、关系和答案在事实上准确,并得到可访问、独立的 Web 证据支持,同时确认初始锚点能够从视频和音频内容中唯一识别。
- 存在事实错误、证据不足、关系不一致、问题含糊或答案不唯一的任务会被移除。
-
元数据与处理:
- 每个资源条目都标注了三个属性:证据模态、资源格式和访问类型。
- 该基准覆盖 4 种模态、42 种格式和 7 种访问类型。
- 视频被存档并与基准一起分发,以支持可复现性。
- 所提供的章节中未描述裁剪策略。
-
任务统计:
- 文本出现在 99.5% 的任务中,图像出现在 44.5%,视频出现在 35.5%,音频出现在 16.0%。
- 82.5% 的任务涉及至少两种证据模态。
- HTML 出现在 98% 的任务中,MP4 出现在 35%,PDF 出现在 31%。
- 96.0% 的任务涉及至少两种资源格式。
- 访问要求包括:每项任务都需要直接观察,67.0% 需要链接或页面导航,60.0% 需要工件转移,47.5% 需要时间索引,42.0% 需要参数化状态更新。
- 95.5% 的任务涉及多种访问类型。
-
在评估中的使用:
- 论文使用 OpenDS-World 评估 AI agents 在自主多步证据搜索和跨来源推理上的表现。
- 在人类测试中,50 名参与者进行了 1,000 次独立尝试,总体准确率为 21.10%。在任务层面,200 项任务中有 115 项被至少一名解答者解决,表明难度较大。
- 所提供的章节未描述训练划分、数据混合比例或模型训练用途;OpenDS-World 被呈现为一个评估基准。
方法
作者通过多阶段标注与验证流程构建 OpenDS-World,该流程生成由真实 Web 内容上的可验证证据路径所支持的问题。方法包含两个主要阶段:任务构建和人工验证。
任务构建流程
任务构建遵循三个阶段:真实世界锚点、开放 Web 证据扩展和问题反转。
阶段 1:真实世界锚点。 每条证据路径始于一个可公开访问的视频。标注者检查视频的视觉帧和音频内容,以识别初始锚点实体;该实体的识别必须依赖于视听信号,而不是页面级文本搜索。锚点被映射到唯一 Wikidata 条目,相应视频被存档并与基准一起分发,以保持可复现性。该锚点作为后续证据扩展的起点。
阶段 2:开放 Web 证据扩展。 从当前锚点实体出发,标注者构造搜索查询,并通过 Google Search 检索候选 Web 来源。他们检查候选来源,选择与当前节点具有明确语义关系并提供可验证证据的来源。在选择过程中,标注者还考虑模态、格式和访问类型属性,以增加证据多样性。他们从所选来源中提取新实体,并将其指定为证据路径中的下一个节点。
一项关键要求是,每个节点都必须由多个 Web 来源独立佐证,而不仅仅由首次提取出它的来源佐证。扩展过程被递归地应用,直到证据路径到达一个唯一且稳定的、适合作为参考答案的终端节点。这种设计确保最终链路是通过在真实 Web 信息源上进行迭代搜索、访问和验证而动态构建的。
阶段 3:问题反转。 一旦确定了终端节点,作者将其指定为参考答案,并通过将完整证据路径反转为一组相互依赖的约束来构建文本问题。中间节点不会被显式揭示。相反,每个节点会基于路径中此前积累的证据被转换为间接指称描述。这些描述被组合起来,使得任何单一线索都不会直接暴露目标实体,而它们的组合会逐步约束候选空间并唯一确定答案。因此,解决问题需要恢复中间实体之间的潜在对应关系并沿底层证据链推进,而不是从单一显式线索中直接检索答案。
人工验证与筛选
在任务构建之后,每个候选任务都会经过十名审核者的独立验证。审核者重新检查保存的证据路径,包括初始锚点、中间实体、实体间关系以及最终参考答案。验证涵盖两个方面:证据有效性和任务有效性。
证据有效性。 审核者检查实体、关系和最终答案在事实上是否准确,并得到真实、可访问且可独立验证的 Web 证据支持。他们会在原始来源之外的多个额外来源中交叉核对信息。相邻节点之间的每次转移都必须有明确证据支持,从而确保证据路径全程的事实和逻辑一致性。对于初始锚点,审核者还确认:该实体能够从视频内容中唯一识别,它被正确映射到 Wikidata 条目,以及答案无法直接从视频页面的文本内容中获得。
任务有效性。 审核者评估每个候选任务是否满足构建原则。他们验证问题是否清晰,线索是否与证据路径对应,以及所有约束是否由可验证证据支持且不存在事实或逻辑冲突。他们还确认这些约束共同确定了唯一的事实性答案,并且不允许存在多个合理答案。任何存在事实错误、证据不足、关系不一致、表述含糊、答案不唯一或违反构建原则的候选任务都会被排除。
通过这一筛选过程,最终基准被构建出来,并具有明确定义的参考答案和可验证的证据路径。
实验
评估包括由人类独立解答 200 个问题,这些问题被分为 10 组、每组 20 个,每组由五名解答者尝试;解答者可以访问 Web,但不能使用 LLM 工具,以确定任务难度和基线表现。随后,在相同的搜索、GUI 和视频工具下评估 12 个前沿模型,时间限制为一小时,工具调用预算为 100 次,使用 Qwen3.8-27B 判断答案准确率。结果表明,即使最佳模型也仅达到 39.00% 的准确率;随着任务难度增加,性能会下降;更高的 token 或时间消耗并不能可靠地改善结果。对成本、工具使用、错误和预算耗尽的进一步分析表明,低效的搜索策略、有限的工具使用效果,以及在约束条件下频繁无法完成任务是核心挑战。
前沿模型在真实世界深度搜索任务上仍然能力有限,最强模型的总体准确率仅为 39.00%。随着任务难度增加,性能显著下降,模型排名在不同难度级别上也会发生变化。更高的 token 消耗或实际耗时并不始终对应更高的准确率。GPT-6 Astra 以 39.00% 的总体准确率领先,紧随其后的是 Claude Opus 5.5 的 38.00% 和 Gemini 3.8 Flash 的 36.50%。在所有被评估模型上取平均,准确率从低难度任务的 39.66% 下降到中等难度任务的 23.50% 和高难度任务的 16.76%,而 Gemini 3.8 Flash 在高难度任务上表现最佳,为 28.24%。
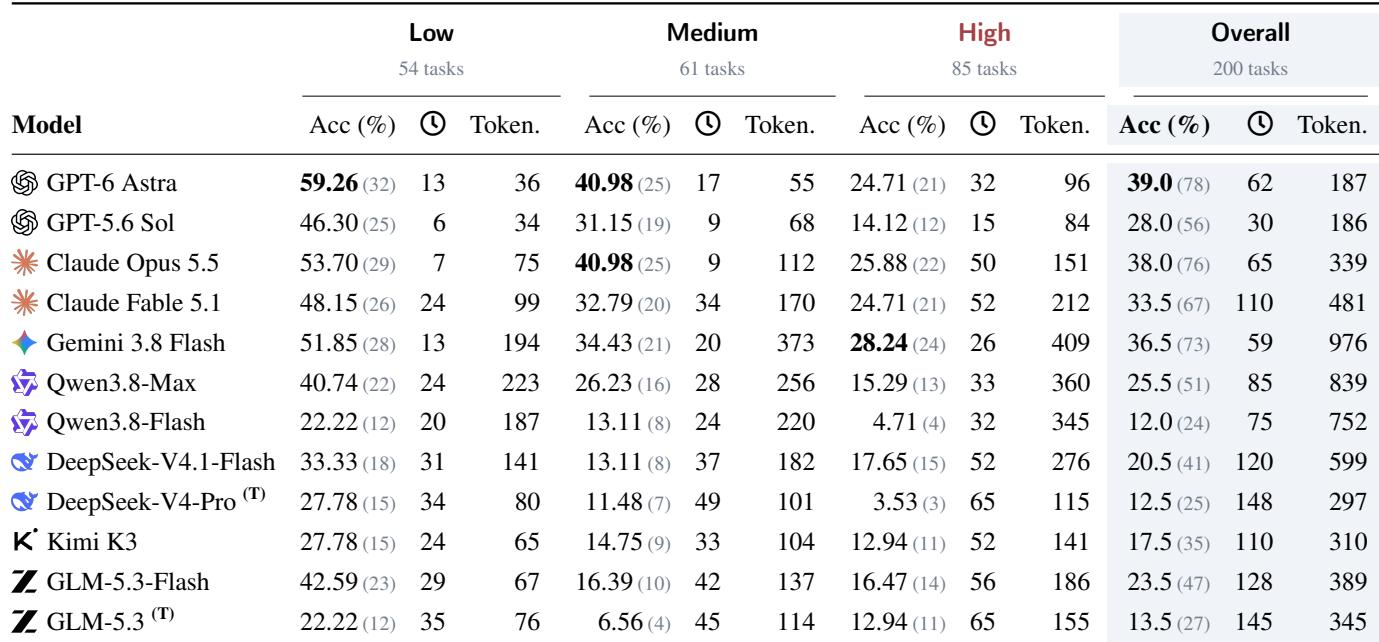
该评估在真实世界深度搜索任务上对前沿模型进行基准测试,并发现它们仍然能力有限:GPT-6 Astra 以 39.00% 的总体准确率领先,其后是 Claude Opus 5.5 和 Gemini 3.8 Flash。平均准确率从低难度任务的 39.66% 急剧下降到中等难度任务的 23.50% 和高难度任务的 16.76%,而模型排名在不同难度级别上会发生变化。更高的 token 或实际耗时并不始终对应更高的准确率,Gemini 3.8 Flash 在高难度任务上表现最佳,为 28.24%。