Command Palette
Search for a command to run...
面向可泛化智能体强化学习的 Harness Scaling
面向可泛化智能体强化学习的 Harness Scaling
Fei Bai Huatong Song Chuan Hao Ran Tao Jian Yang Bryan Dai Wayne Xin Zhao Ji-Rong Wen
摘要
智能体执行框架已成为现代智能体系统的核心组件,塑造着模型如何使用工具、管理上下文以及协调长时程交互。这些框架优势的实现取决于底层模型对其有效利用的程度,因而需要直接通过框架开展强化学习。然而,现有方法通常仅在单一固定框架中训练,容易导致特化,并限制了跨框架配置的迁移能力。为解决该问题,我们提出 Harness Scaling,一种面向智能体 RL 的新型扩展维度,将训练从单一框架扩展至多样化执行配置。具体而言,我们构建可因子分解的框架空间,选取具有平衡析因覆盖的紧凑训练子集,并组织跨框架训练,以在相同任务上兼顾全局覆盖与受控变化。在多个基准、模型规模和 RL 算法上,Harness Scaling 一致提升了模型对未见白盒配置的泛化能力。此外,通过结构化白盒变化训练的模型能够有效迁移至未见的外部黑盒框架,优于仅在单一复杂黑盒框架中训练的模型。这些结果确立了框架多样性作为智能体 RL 中一个有意义的扩展维度,并强调了这种多样性的组织方式对跨框架泛化的重要性。
一句话总结
中国人民大学、IQuest Research 和北京航空航天大学的研究人员提出 Harness Scaling,这是一种 agentic 强化学习扩展维度,通过构造分解式 harness 空间、选择具有平衡因子覆盖的紧凑训练子集,以及以受控变化组织跨 harness 训练,将训练从单一固定 harness 扩展到多样化执行配置,从而在多个 benchmark、模型规模和 RL 算法上提升对未见白盒配置的泛化能力,并有效迁移到未见外部黑盒 harness。
核心贡献
- 引入 Harness Scaling,这是面向 agentic RL 的扩展维度,能够在多样化执行 harness 配置上训练策略,而不是在单一固定 harness 上训练,从而解决过度专门化和迁移能力有限的问题。
- 建立结构化框架,对 harness 变化进行分解,选择具有平衡因子覆盖的紧凑训练子集,并在跨 harness 训练期间将结构上相近的配置分配给同一任务。
- 在多个 benchmark、模型规模和 RL 算法上,Harness Scaling 提升了针对未见白盒 harness 的泛化能力,并能有效迁移到复杂外部黑盒 harness,性能优于使用单一复杂黑盒 harness 进行训练。
引言
Agent harnesses 会塑造语言模型 agents 如何使用工具、管理上下文,以及如何从错误中恢复,因此是长时程 agentic 系统的核心。已有工作主要扩展用于强化学习的任务和环境,或者在单一固定 harness 内训练策略,这会导致对特定执行设置的过拟合,以及向新 harness 的迁移能力较差。作者引入 Harness Scaling,将 harness 视为可训练的变异维度,把它分解为系统提示、工具接口、观测、上下文管理和工作流。作者利用正交设计构建一组紧凑且多样的 harness 配置,并在 RL 期间将每个任务与结构上相近的配置配对。该方法提升了针对未见白盒 harness 的泛化能力,并能有效迁移到外部黑盒 harness。
方法
作者提出 Harness Scaling,这是一种将执行 harness 视为新的扩展轴的方法论,旨在提升策略泛化能力。该框架不依赖单一的整体执行环境,而是系统性探索多样化执行配置,以训练更鲁棒的策略。
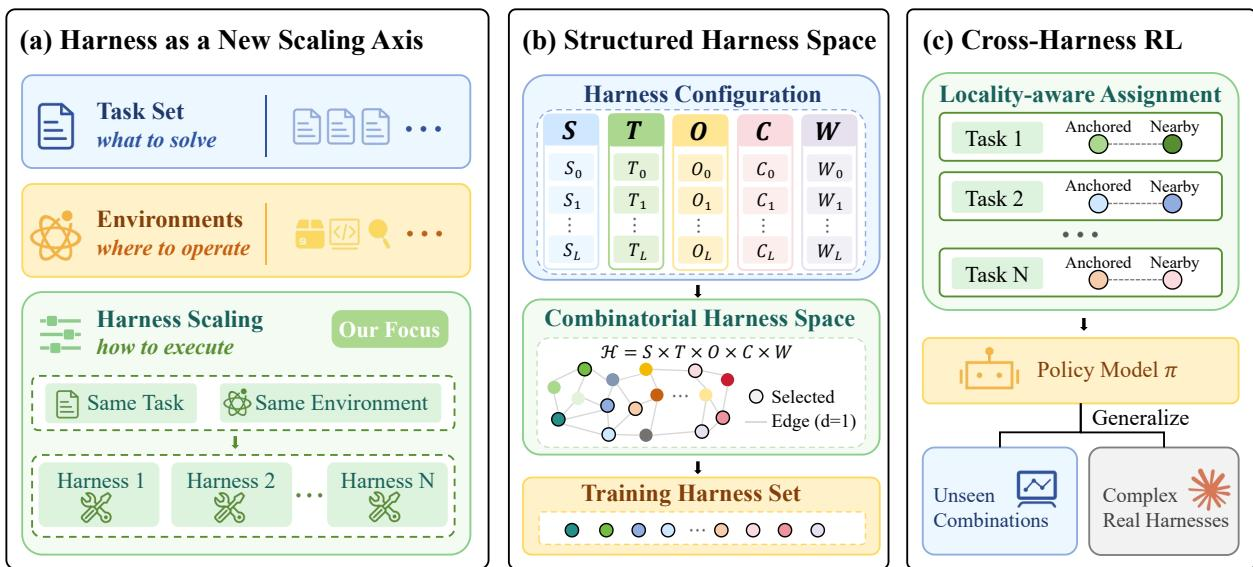
如框架图所示,该方法包含三个核心阶段:将 harness 概念化为扩展轴,构造结构化组合 harness 空间,以及执行跨 harness 强化学习,以在未见配置和复杂现实 harness 上实现泛化。
为了系统研究这一问题,作者将执行配置空间形式化为分解 harness 的五个不同组件:系统提示 (S)、工具接口 (T)、观测 (O)、上下文管理 (C) 和工作流 (W)。每个组件通过在基础实现上应用特定变换家族来实现。完整 harness 配置 h 从每个组件集合中选择一个实现,从而将分解式 harness 空间定义为:
H=S×T×O×C×W该空间的乘积结构诱导了一种自然的结构邻近性概念,由汉明距离 dH(hi,hj) 衡量,其计算两个配置在多少个组件维度上不同。泛化目标聚焦于两种互补形式:在 H 内对保留配置的空间内组合泛化,以及对超出所构建设计空间的复杂现实世界黑盒 harness 的空间外泛化。
由于分解式 harness 空间以组合方式增长,穷尽式训练在计算上不可行,并会引入冗余。为解决该问题,作者构造一个紧凑训练集,在固定优化预算下保留广泛因子覆盖。作者将 harness 空间视为因子设计,并强制执行强度 2 平衡。这要求组件平衡,确保每个实现都被均匀表示,以及成对组合平衡,即任意两个组件的每一对实现在所选集合中均等出现。作者对组件实现实例化强度 2 正交设计,直接构造训练 harness 集 Htr⊂H。该设计满足 Rao 界,并保证低阶投影完全平衡,同时许多完整 harness 组合仍不可见,从而支持评估空间内组合泛化。
训练过程通过局部感知分配策略和多 harness 策略优化,使策略在相同底层任务下接触多个执行配置。对于跨 harness 任务分配,作者为每个任务分配一小批结构相关的配置。对于给定任务 x,从训练集 Htr 中均匀采样一个锚定 harness hx。其余 K−1 个配置选择为与锚定配置汉明距离最小的配置。由此得到任务特定的 harness 集合:
Hx={hx,hx(1),…,hx(K−1)}该方法将局部跨 harness 变化与广泛全局覆盖结合起来,因为不同任务分布在训练空间的不同区域。
在多 harness 策略优化期间,每个任务-harness 实例 (x,h) 被执行以生成轨迹 τ 和相应奖励。分配给同一任务的 K 个 harness 会在连续训练步骤中被利用。对于由任务-harness 训练分布诱导出的策略更新 batch B,作者优化标准裁剪策略目标:
L(θ)=NB1(x,h,τ)∈B∑t=1∑∣τ∣Mtmin(ρt(θ)At,clip(ρt(θ),1−ϵ,1+ϵ)At)其中,NB 是由策略生成的有效 tokens 的总数,ρt(θ) 是概率比,Mt 是掩码变量,At 是由底层强化学习算法计算的优势。这一跨 harness 训练过程可无缝应用于 PPO 和 GRPO,使策略能够学习超越任何单一 harness 配置的鲁棒行为。
实验
实验比较 Harness Scaling 与单 harness 基线和黑盒基线,覆盖多个 agent benchmark,测试针对未见 harness 配置的空间内泛化,以及向外部黑盒 harness 的迁移。结果表明,在结构化、多样化 harness 配置上训练,可提升对执行设置的鲁棒性,而无需接触每一种组合,并且这一优势在不同模型规模、RL 算法和外部 harness 上仍然存在。消融实验表明,harness 选择、每个任务的 harness 多样性以及局部感知分配都很重要;行为分析显示,增益主要来自状态跟踪、工作流遵循和错误恢复,而不是对基础 harness 的过拟合。
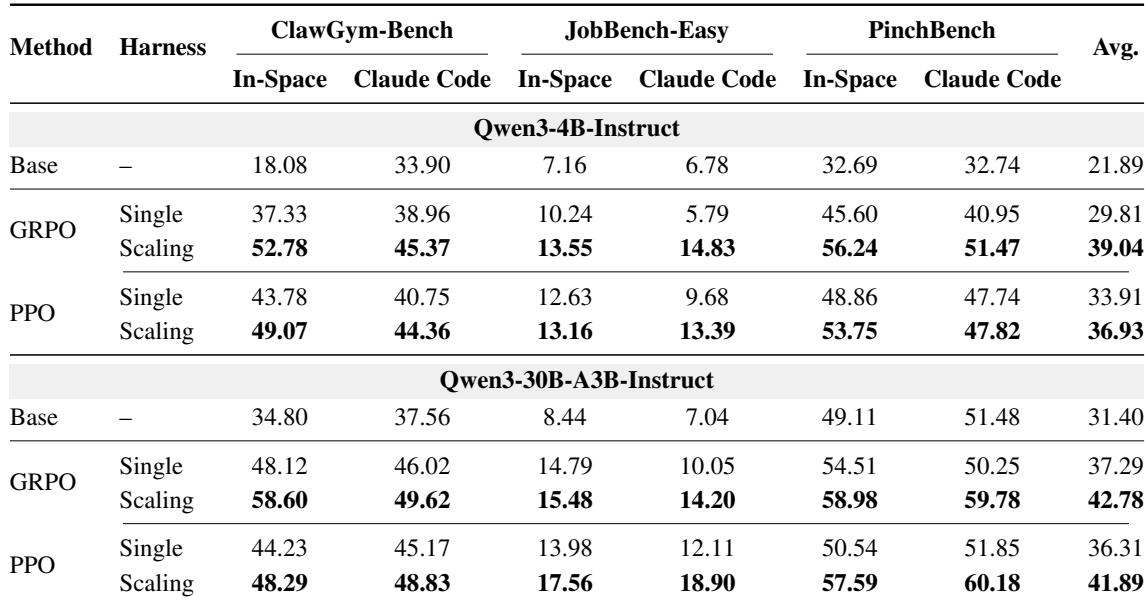
与单 harness 训练相比,Harness Scaling 在保留配置和外部黑盒 harness 上提升了 pass@1 结果。该优势在较小和较大 backbone 上均出现,并且在 GRPO 和 PPO 中均存在,表明其具有跨模型规模和优化方法的鲁棒性。这一趋势还表明,在多样化结构化 harness 上训练,比为通过单一复杂 harness 直接训练能够支持更好的跨 harness 迁移。Harness Scaling 在两种评估模型规模上都提高了保留 harness 配置上的平均性能。该提升在 GRPO 和 PPO 下成立,而不是依赖某一优化器。扩展 harness 方法在外部黑盒 harness 上仍然有效,并优于直接黑盒训练基线。
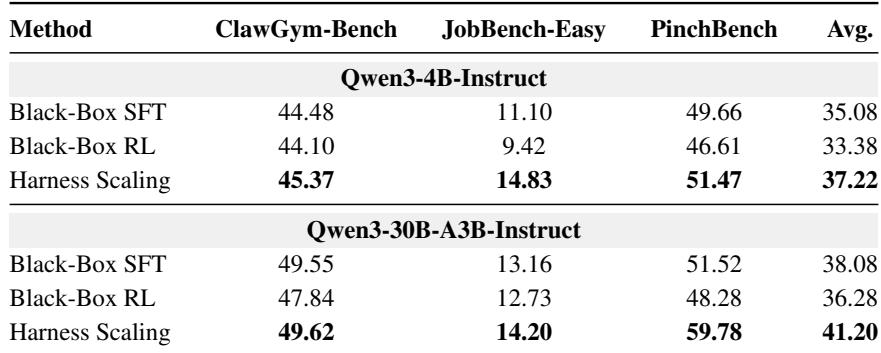
在 Claude Code 上,使用 Harness Scaling 训练的模型在两种 Qwen 模型规模上均取得最高平均 Pass@1,优于通过 OpenClaw 训练的黑盒 SFT 和黑盒 RL 基线。结果表明,在多样化白盒 harness 配置上进行结构化训练,比为通过单一复杂黑盒 harness 直接训练,能更有效地迁移到未见黑盒 harness。Harness Scaling 在两种模型规模上都提升了向未见黑盒 harness 的迁移能力。在该迁移设置下,黑盒 SFT 的平均 Pass@1 高于黑盒 RL。
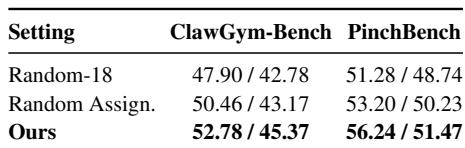
对 18 个 harness 训练集进行结构化选择,在两个 benchmark 的两种评估设置下都优于随机选择的 18 个 harness 集合。局部感知分配也优于随机分配,支持将广泛 harness 覆盖与受控的每个任务变化相结合。结构化 18 个 harness 选择在 ClawGym-Bench 和 PinchBench 上均产生高于 Random-18 的 In-Space 和 Claude Code 分数。局部感知分配在两个 benchmark 和两种评估设置下都优于随机分配。
对于使用 GRPO 训练的 Qwen3-30B-A3B-Instruct,跨 harness 扩展几乎不会改变基础 harness 性能,同时提升 in-space benchmark 和 Claude Code 分数。相比基础 harness 的轻微下降,替代 harness 上的更大增益表明对执行变化具有更好鲁棒性,且不会显著损害专门化能力。经过扩展后,基础 harness 性能仅发生轻微变化。In-Space 和 Claude Code 性能在扩展后均有提升,其中 in-space 增益尤其明显。
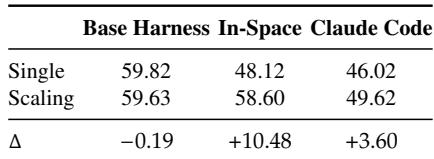
实验评估使用 GRPO 和 PPO 训练的 Qwen backbone 在保留 harness 配置、外部黑盒 harness 和 benchmark 套件上的 pass@1 性能。Harness Scaling 始终提升向未见 harness 的迁移,同时保持基础 harness 性能,表明其在模型规模和优化方法上都具有鲁棒性。采用局部感知分配的结构化 harness 选择也优于随机选择,说明广泛但受控地接触执行环境能够支持更好的跨 harness 泛化。