Command Palette
Search for a command to run...
自动化面向科学的 ML:前沿智能体能否在真实开放场景中攀登科学高峰?
自动化面向科学的 ML:前沿智能体能否在真实开放场景中攀登科学高峰?
Ming Zhong Stacy Li Nicholas Carlini Matthew Jagielski
摘要
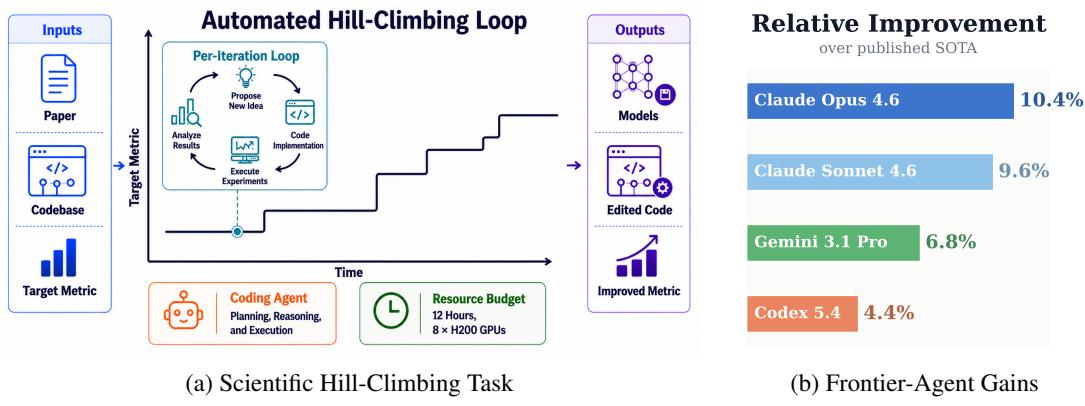
前沿代码智能体日益被视为端到端自动化研究员,而面向科学的 ML 对这一承诺提出了严苛检验:改进科学模型通常需要超越常规 ML 工程的领域洞见。我们推出 AGENT4SCI,这是一个长时程测试平台,用于衡量当前智能体在科学 ML 基准上对已发表最佳模型所能达到的改进程度,涵盖 11 个领域的 20 个基准。AGENT4SCI 并不在排行榜上对智能体进行排名,而是追问智能体在真实开放条件下能够在这类任务上取得何种进展,以及它们在哪些方面存在不足。实证结果显示,当前前沿智能体在每个基准上均超越了已发表最佳成绩,其中 Claude Opus 达到 10.4% 的平均相对提升,且没有任何运行被标记为学术不端。然而,这些提升几乎完全来自一组 ML 工程技巧,而非研究层面的洞见。轨迹分析在该场景下揭示了三个反复出现的局限:新颖性校准偏差、资源利用不足,以及迅速陷入局部工程化扫描。面向研究构思、实验管理和定时检查清单的轻量级插件技能,可将 Claude Opus 从 10.4% 提升至 20.1%,并将 Codex 从 4.4% 提升至 8.1%,同时产生更具多样性、更贴合领域的干预。AGENT4SCI 为社区提供了一种方法,用于在真实世界面向科学的 ML 问题上跟踪并推动前沿智能体从 ML 工程迈向领域洞见。代码与数据已在 GitHub 和 Hugging Face 上发布。
一句话总结
Anthropic Fellows Program 和 Anthropic 推出 AGENT4SCI。这是一个覆盖 11 个领域、20 个基准的长时程、真实开放环境测试平台,用于衡量前沿编程 agent 如何改进已发表的最佳科学机器学习模型。研究发现,性能提升主要来自机器学习工程技巧,而轻量的研究构思、实验管理和检查清单技能能将 Claude Opus 从 10.4% 提升到 20.1%,并将 Codex 从 4.4% 提升到 8.1%,同时带来更丰富、更贴合领域特征的干预。
核心贡献
-
AGENT4SCI 是一个经人工验证的长时程测试平台,包含覆盖 11 个领域的 20 个科学机器学习基准,用于评估从已发表最佳基线出发的自动科学爬山优化,并通过审计轨迹减少评测博弈。
-
实验表明,前沿编程 agent 能改进每个 AGENT4SCI 基准,其中 Claude Opus 的平均相对提升达到 10.4%。轨迹分析还揭示了新颖性误判、资源利用不足,以及策略迅速坍缩到局部工程化扫描的问题。
-
面向研究构思、实验管理和定时检查清单的轻量插件技能,将 Claude Opus 的平均提升从 10.4% 提高到 20.1%,并将 Codex 的平均提升从 4.4% 提高到 8.1%,从而带来更丰富、更贴合领域特征的干预。
引言
前沿编程 agent 正越来越多地把自动研究变成可执行循环:它们阅读论文和代码、运行实验、解读指标并进行迭代。这对科学机器学习很重要,因为许多科学机器学习任务依赖真实研究代码库、多样模态和固定指标目标,在这些场景中,自动改进可以加速实验。然而,以往的演示大多面向结构清晰的计算机科学任务、单任务设定和经过精心打磨的基准,而真实科学代码常常会带来评测博弈,例如测试集污染、指标操纵或硬编码输出。作者贡献了 AGENT4SCI,这是一个经人工验证的测试平台,面向覆盖 20 个基准、25 个任务和 11 个科学领域的自动科学爬山优化,并提供标准化复现、隔离的留出集评估和轨迹审计。评估显示,前沿 agent 可以改进已发表基线,但这些提升大多体现机器学习工程能力,而非更深层的科学洞察。
方法
作者通过一个名为插件技能的外部行为层修改默认编程 agent。该方法不改变底层模型,而是在 agent 工作流的具体阶段插入精心编写的技能文档。每个技能都是一个简短的 Markdown 指令文件,用于塑造 agent 的规划、实现和自评行为。这套技能主要面向 Claude Code 调优,也适配 Codex 使用。
插件框架针对前沿编程 agent 中三种常见失败模式。第一种是新颖性误判,即 agent 将标准技术误认为创造性贡献。第二种是资源利用不足,即在实验执行过程中 GPU 处于空闲或分配不当状态。第三种是探索坍缩,即 agent 最初会产生多样想法,但随后将策略收窄到超参数调优、集成,或重复进行微小变化。
第一个模块是研究构思,在运行开始时调用。该技能让 agent 在并行文献回顾中立足,覆盖目标科学领域以及更广泛的 AI 或机器学习方法。它还会为 agent 设定一个夸大的研究科学家人格,强烈反对常规超参数调整,并优先考虑真正新的方法论方向。完成文献回顾后,agent 会生成一份计划,将大胆想法与更安全的备选方案分开,并把更具雄心的干预置于常规默认方案之上。该模块旨在纠正新颖性误判,把 agent 从众所周知的技术引导到更像科研的假设形成过程。
第二个模块是实验管理,在实现和执行阶段应用。该技能包含关于高效使用计算资源的操作性指令。它指导 agent 实时监测运行中的任务,将优先资源分配给更具雄心的实验,并避免并发任务之间的 CPU 或 GPU 争用。它还鼓励运行时优化,例如更快的数据加载和混合精度执行。该模块旨在保持较高的 GPU 利用率,并避免低效的实验调度限制进展。
第三个模块是定时检查清单,通过工具调用钩子周期性触发。每小时一次,agent 会使用诊断性问题进行结构化自我评估,例如是否在设计有创造力的实验、是否只是在调整超参数,以及领域专家是否会认为当前策略有意思。当 agent 的行为开始偏向低风险局部改进时,该机制会迫使 agent 重新考虑自身轨迹。该模块旨在防止探索坍缩,通过反复重新引入实质性研究想法,而不是渐进式调参,来维持研究性探索。
实验
实验在受控、全自动的爬山协议下,于科学基准上评估前沿 agent,以检验它们能否在无人干预的情况下改进已发表基线。结果显示,每个基准都至少能被一个 agent 改进;不过,多数提升来自调参、架构变更、数据增强和损失调整等标准工程手段。不同 agent 展现出明显不同的工作风格,且没有评测博弈证据。进一步分析发现,agent 在新颖性、资源使用和探索方面反复出现弱点,而插件技能显著提升性能,有时能引发面向具体任务的科学推理,尽管多数提升仍偏实用而非科研式。
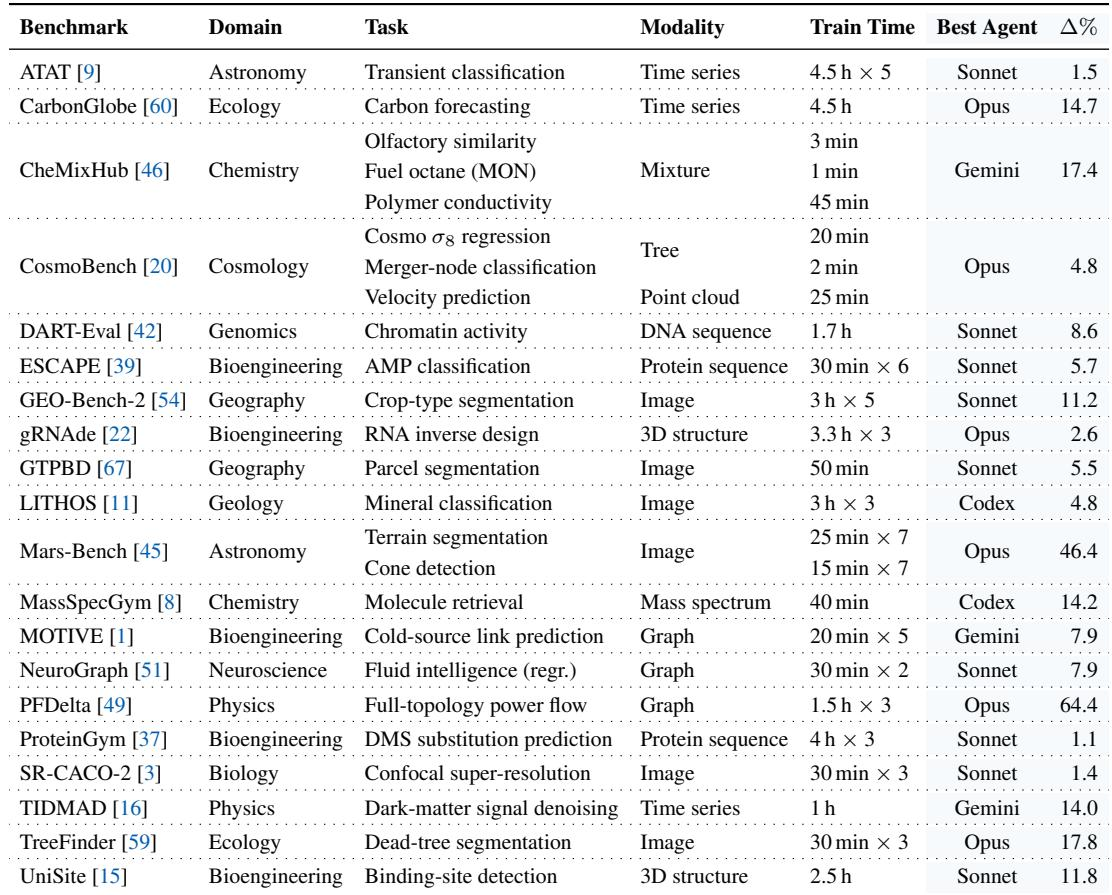
AGENT4SCI 覆盖 20 个基准中的 25 个任务,其中生物工程的基准代表性最强,还覆盖天文学、化学、生态学、地理学、物理学及其他若干科学领域。这些任务包括分类、分割、检测、回归、链接预测和检索,训练成本从分钟级运行到单加速器上数小时不等。某些评估还使用多个随机种子或折数的平均结果,体现基准协议的多样性。该测试套件有意在科学领域、机器学习任务类型、模态和训练预算上保持广泛覆盖。每个基准都至少能被一个前沿 agent 在无人干预下改进。提升幅度差异很大,从小幅提升到大幅损失下降不等,而最佳 agent 也会随基准变化。
插件技能改善了两种 agent 的爬山优化表现,并使平均相对提升接近翻倍。对 Claude Opus 而言,收益较广,而 Codex 的提升更集中,在 PFDelta、Mars-Bench、GEO-Bench-2、TIDMAD、MOTIVE 和 CarbonGlobe 等基准上提升最强。当技能促使 agent 使用领域特定推理时,这些技能尤其有帮助,尽管许多基准上的提升仍然有限。插件技能使两种 agent 的平均爬山提升接近翻倍。Opus 在各基准上的提升较广,而 Codex 的提升更集中。PFDelta 因物理信息推理而表现出尤其显著的由技能带来的提升。
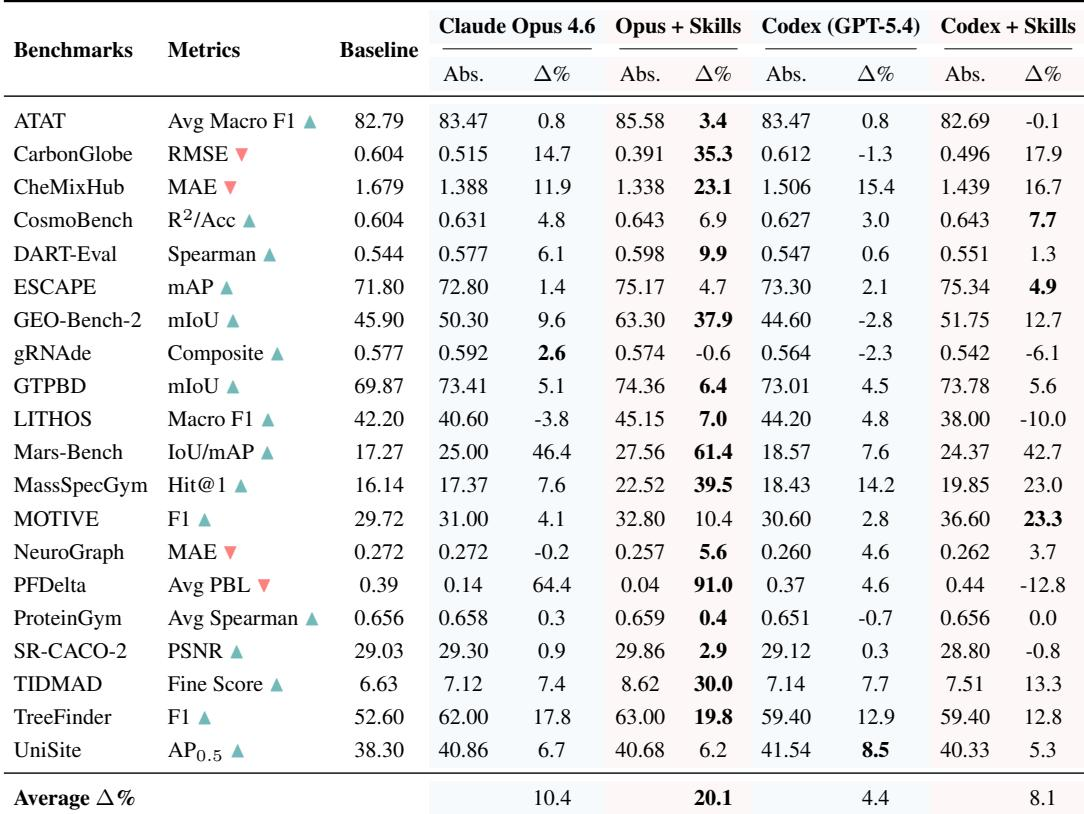
该评估引入 AGENT4SCI,这是一个包含 20 个科学基准、25 个任务的广泛基准套件,覆盖多样领域、任务类型、模态和训练预算。实验验证了前沿 agent 能在无人干预下改进每个基准,尽管提升幅度与最佳 agent 差异很大。另一组实验表明,插件技能显著增强爬山优化表现,使平均相对提升接近翻倍,其中 Claude Opus 的收益更广,而 Codex 的收益更集中但有时幅度很大,尤其在受益于领域特定推理的基准上。