Command Palette
Search for a command to run...
面向智能体的缓存工程
面向智能体的缓存工程
Tianyu Fu Ruoxi Wang Zihan Min Zhongqi Ren Zhihao Li Tengxuan Liu Shengxu Mu Hanling Zhang Yu Wang
摘要
大语言模型(LLM)智能体能够处理日益复杂的任务,在由观察和动作构成的长轨迹中导航。随着这些轨迹增长,键值(KV)缓存 I/O 与存储成为主要成本。轨迹还可能超过 LLM 的最大上下文长度,因此需要对活跃缓存增长进行控制。先前工作采用上下文工程,通过裁剪或总结历史来减小缓存规模。然而,修改轨迹前缀会使后续缓存状态失效,并触发对保留上下文的高成本重新预填充。当为限制重新预填充成本而保留的上下文过少时,任务准确率也会受损。我们提出缓存工程作为一种新方案。它允许智能体直接控制其活跃 KV 缓存,而无需修改轨迹或对保留的上下文进行重新预填充。具体而言,智能体可以主动使用 drop 将选定缓存从未来注意力中排除,并使用 repos 调整保留键的位置编码。我们形式化了这些缓存操作,并指出历史依赖性是一个推理服务挑战:相同的 token 序列在不同的缓存操作序列下可能产生不同的缓存状态,使得仅靠前缀匹配不足以实现正确的缓存复用。因此,我们协同设计了 AKV 推理服务引擎。它提供与现有推理服务 API 兼容的无状态接口,同时在内部管理有状态的缓存复用、淘汰与恢复。实验表明,一种工具响应滚动丢弃(toolresponse rolling-drop)缓存策略与传统的阈值触发的总结方法相比,将平均基准分数提高了 1.7分,并将平均成本降低了 27.7%。借助 AKV,它实现了最高 1.2倍的输出吞吐量,并在 P95 请求延迟上实现了 1.5倍加速。缓存策略的递归自我改进相较专家设计进一步将成本降低了 7.1%。我们的代码位于 https://github.com/thu-nics/AKV。
一句话总结
清华大学和香港中文大学的研究者提出了缓存工程,使 agent 能够通过 drop 和 repos 直接控制活跃 KV cache,而无需对保留上下文重新进行 prefill,并共同设计了用于有状态缓存复用的 AKV 服务引擎;其工具响应滚动丢弃缓存策略将平均 benchmark 得分提高 1.7 分,平均成本降低 27.7%,与传统阈值触发摘要相比,输出吞吐量最高达 1.2×,P95 请求延迟实现 1.5× 加速。
核心贡献
- 提出了缓存工程,该方案使 agent 能够通过 drop 和 repos 操作直接控制其活跃 KV cache,而无需修改轨迹或对保留上下文重新 prefill;该方案形式化了这些缓存操作以及由此产生的依赖历史的缓存状态,说明为什么仅靠前缀匹配不足以实现正确的缓存复用。
- 提出了 AKV,一个服务系统,对外提供与现有 serving API 兼容的无状态接口,同时在内部通过扩展基数树和 segment-batch attention 管理有状态缓存复用、驱逐和恢复。
- 在三个 LLM 和四个 agent benchmark 上,工具响应滚动丢弃缓存策略相比阈值触发摘要,将平均 benchmark 得分提高 1.7 分,平均成本降低 27.7%;在 AKV 上,输出吞吐量最高达 1.2×,P95 请求延迟实现 1.5× 加速,递归自我改进还进一步将成本降低 7.1%。
引言
随着 LLM agent 承担更长、工具密集的任务,其累积的 KV cache 成为主要瓶颈:KV cache 读取在 API 成本中占主导地位,而对过多或位置被拉伸的状态执行 attention 可能损害任务准确性。此前的工作主要通过摘要或裁剪来修改文本轨迹,但修改较早消息会使后续 KV 状态失效,并迫使进行昂贵的重新 prefill,这在重新 prefill 成本与保留有用中间上下文之间造成两难。作者提出了缓存工程,它直接从未来 attention 中丢弃选定的 KV 条目,或调整它们的编码位置,同时复用所有保留的 KV 状态而无需重新 prefill。作者共同设计了 AKV,一个具有无状态接口、扩展基数树和 segment-batch attention 的服务系统,使该控制对真实 agent 工作负载具有实用性。该方法还支持递归自我改进,让 agent 能够搜索、评估和优化缓存管理策略。
方法
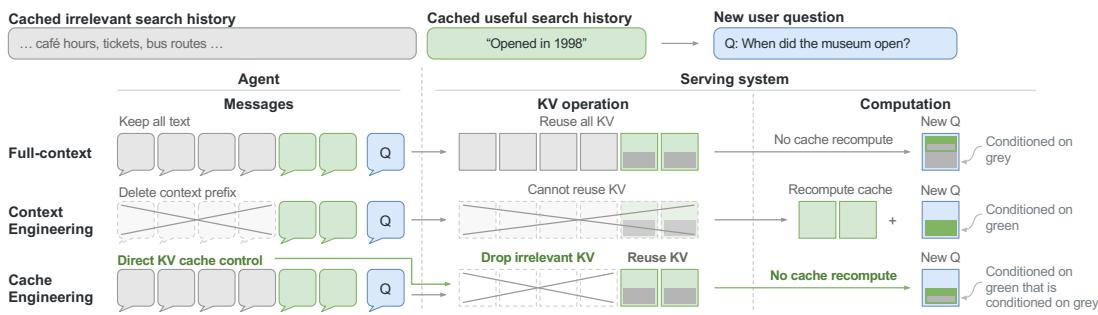
作者提出缓存工程,使 agent 能够直接控制其活跃键值(KV)cache,而无需重写逻辑 token 轨迹或触发昂贵的重新 prefill。在标准自回归 LLM 推理中,下一个 token 预测依赖当前 token 及前序 token 的 KV cache,形式化为 pθ(xt+1∣xt,C1:t−1)。上下文工程通过裁剪或摘要修改逻辑 token 序列,而缓存工程直接修改活跃 cache,同时保持逻辑 token 序列不变。
参见框架图:
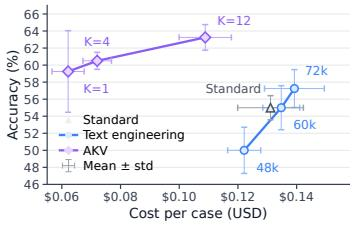
如上所示,全上下文推理会复用所有历史 KV 状态,而上下文工程会删除文本并重新计算保留的历史。相比之下,缓存工程从未来 attention 中丢弃选定的 KV 条目,同时复用所有保留状态且无需重新计算。该方法缓解了重新 prefill 成本与任务准确性之间的两难。经验评估表明,与基于裁剪或基于摘要的上下文工程相比,直接丢弃较旧工具响应缓存可以同时提高准确性并降低成本。
如下图所示:
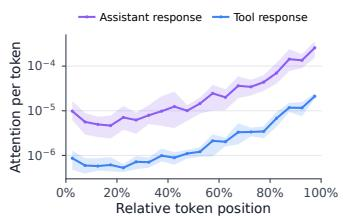
缓存选择的设计反映了消息角色、新近程度和任务需求。对 attention 模式的分析表明,较旧的 token 和工具响应通常比最近的 token 和 assistant 消息获得更少 attention。
参见 attention 分析:
基于此,作者采用工具响应滚动丢弃策略,保留推理和最近工具响应的缓存,同时丢弃较旧缓存。此外,为防止缓存减少时位置编码索引达到模型上限,系统将位置编码索引与逻辑索引解耦,使用单独操作通过旋转位置编码(RoPE)旋转来重新定位缓存 key。
作者定义了三种基本缓存操作:
- Append:标准缓存更新,处理新 token xt+1 并将其 KV 条目追加到活跃缓存:append(xt+1):C←[C;Ct+1]。
- Drop:从后续 attention 中移除选定 KV 状态,同时保持保留状态、它们的位置编码和逻辑 token 序列不变:drop(P):C←C∖{Ci:i∈P}。
- Repos:按逻辑 token 顺序更新缓存 key 的位置编码,并重置后续 append 操作的位置索引。对于 RoPE,该操作通过 K←R(q)R(p)−1K 将 key 从原始位置索引 p 旋转到新索引 q。
为了提供确定性描述,这些操作被组织为缓存操作序列 o1:m=(o1,…,om),其中 oj∈{append(x),drop(P),repos}。缓存状态依赖历史;仅凭 token 和保留位置无法确定下一个 token 概率。
参见轨迹图:
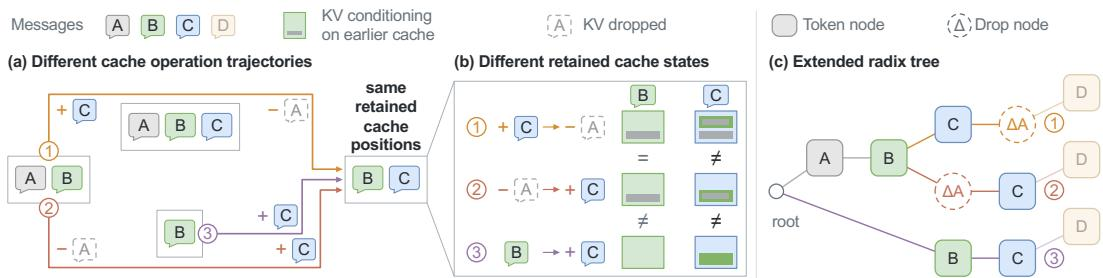
如图所示,保留相同 token(B 和 C)的不同轨迹可能因 drop 发生的时间不同而产生不同的缓存状态。图中的扩展基数树共享前缀,但根据 drop 时机进行分支,以区分缓存状态。
AKV 服务系统遵循无状态接口、有状态服务的原则。Agent 通过扩展 API 指定缓存操作,该 API 同时包含逻辑 token 序列和缓存操作历史。服务器在内部处理物理缓存复用、驱逐和恢复。为支持缓存工程,系统需要应对缓存状态管理中的挑战。仅靠 token 前缀不再能确定缓存状态,因此普通前缀匹配不足。作者在基数树中加入 drop 节点,记录哪些逻辑 token 索引的缓存被丢弃,从而在保持前缀共享的同时区分后续状态。驱逐具有 drop 感知能力;缓存条目只有在没有正在进行的计算或恢复需要它时才可驱逐,并优先驱逐被丢弃的缓存,其次是已完成请求的缓存。缺失缓存状态的恢复通过 segment-batch attention 实现,其中查询在 drop 触发点处被拆分,以在一次 prefill pass 中因果地关注自身 token 以及来自先前段的活跃缓存。
对于位置感知管理,系统在 repos 后通过复制缓存状态并旋转 key 来复用缓存,而无需重新计算隐藏状态。
参见重新定位示意图:
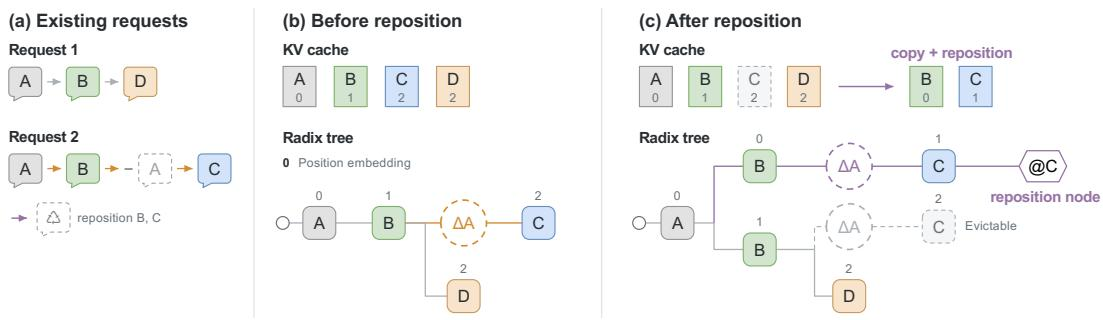
如图所示,当请求需要重新定位的缓存时,系统会创建具有更新后位置索引的副本,并在基数树中创建 reposition 节点。位置版本在不再使用时独立驱逐。恢复使用临时 KV 版本,在每一层旋转 key 并复制 value,以确保各段使用其原始计算中的正确位置编码。
实验
评估在 BrowseComp-Plus、xbench-DeepSearch、GAIA-Text 和 SWE-Verified 等长程 agent benchmark 上,比较了 AKV 与两个上下文摘要基线在三个 LLM 上的表现。AKV 取得了更高的平均成功率,同时降低了推理成本,并且表现出更好的吞吐量和延迟,尤其在高并发下。收益来自逐步丢弃较旧的工具响应 KV cache,而不是突然进行摘要。消融实验表明,工具响应 drop 加 repos 是最强策略,而递归自我改进和 agent 管理的缓存控制可以进一步降低成本或提高准确性。
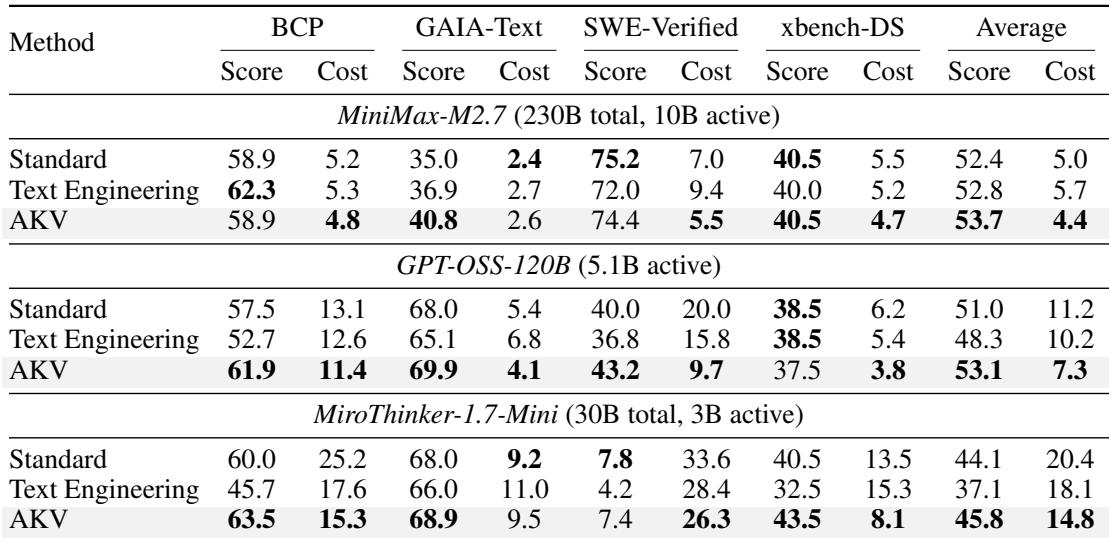
AKV 在所有评估模型上取得了最高的平均通过率,在降低平均推理成本的同时优于两个基线。对于 MiniMax-M2.7,AKV 记录了最高平均得分和最低平均成本,尽管各 benchmark 层级的得分变化不一致;在 GAIA-Text 上提升最大,且在大多数单独 benchmark 上成本更低。AKV 相较于 Standard 和 Text Engineering 提高了平均成功率,同时降低了平均推理成本。对于 MiniMax-M2.7,AKV 在各方法中平均得分最高、平均成本最低,但 Text Engineering 在 BCP 上领先,Standard 在 SWE-Verified 上领先。
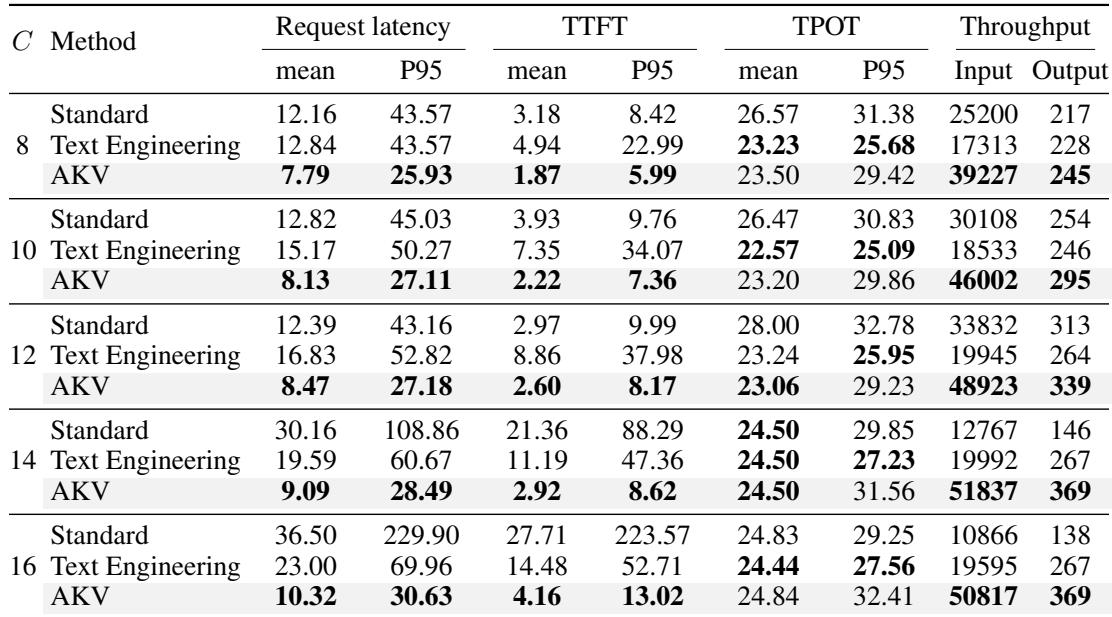
在报告的并发级别下,AKV 的请求延迟和 time to first token 均低于 Standard 和 Text Engineering,同时提供更高的输入和输出吞吐量。效率优势在更高并发下扩大,此时 Standard 承受更多 KV cache 压力和重新 prefill 工作量。在峰值吞吐设置下,AKV 在平均和 P95 请求延迟以及输入和输出吞吐量上优于 Standard。AKV 在报告的并发级别下,三种方法中平均和 P95 请求延迟以及 time to first token 最低。在峰值吞吐设置下,AKV 的平均请求延迟比 Standard 快约 1.4×,P95 请求延迟快约 1.5×。AKV 在报告的并发级别下提供比两个基线更高的输入和输出吞吐量。高并发下,与 Standard 的延迟和吞吐量差距扩大,因为 KV cache 压力增加了 Standard 的重新 prefill 工作量。
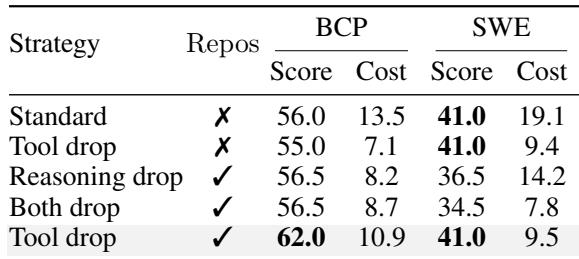
消融结果显示,在启用 repos 的情况下丢弃工具响应缓存提供了最强的准确性表现,在比较策略中取得了最佳 BCP 通过率,并并列最佳 SWE 得分。Repos 操作贡献了 BCP 的很大一部分提升,从 55 提升到 62,而工具响应丢弃使成本低于 Standard。在启用 repos 时,单独丢弃推理缓存或同时丢弃工具响应缓存,相较于仅丢弃工具响应缓存,会降低两个 benchmark 上的通过率。在启用 repos 的情况下丢弃工具响应缓存,在所比较策略中取得了最佳 BCP 通过率,并并列最佳 SWE 得分。在工具响应丢弃中加入 repos 操作将 BCP 通过率从 55 提高到 62,同时成本仍低于 Standard。在启用 repos 时,丢弃推理缓存(无论单独还是与工具响应缓存一起)在两个 benchmark 上都不如仅丢弃工具响应缓存。
与 Standard 和 Text Engineering 方法相比,Cache-As-Tool 在两个模型上的 100 任务 BCP 子集中取得了最高通过率。对于 GPT-OSS-120B,该方法相对 Standard 还降低了每任务成本,而 MiniMax-M2.7 由于执行更多轮次,成本略有增加。Text Engineering 对准确性影响不一,降低 GPT-OSS-120B 的得分,但提高 MiniMax-M2.7 的得分。Cache-As-Tool 在两个模型上的 100 任务 BCP 子集中达到了最高准确性。对于 GPT-OSS-120B,Cache-As-Tool 相对 Standard 降低了每任务成本,而 MiniMax-M2.7 的每任务成本略有上升。Text Engineering 相比 Standard 降低了 GPT-OSS-120B 的通过率,但提高了 MiniMax-M2.7 的通过率。
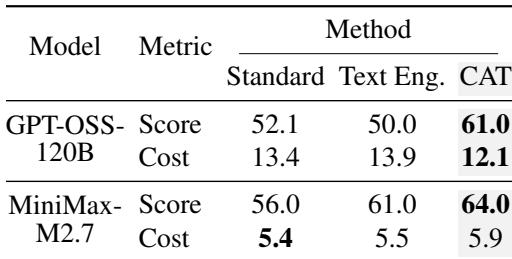
评估在 BCP、SWE-Verified 和 GAIA-Text 等 benchmark 上,比较 AKV 与 Standard、Text Engineering 的准确性、推理成本、延迟、吞吐量和缓存消融结果。AKV 始终取得最高平均通过率和最低推理成本,同时提供更低请求延迟、更低 time to first token 和更高输入输出吞吐量,尤其是在高并发下。消融实验显示,启用 repos 并丢弃工具响应缓存可带来最高准确性,并使成本低于 Standard,而丢弃推理缓存会降低通过率。在 100 任务 BCP 子集上,Cache-As-Tool 在两个模型上达到最高准确性,成本影响因模型而异。