Command Palette
Search for a command to run...
StreamEval:评估交互式流式视频生成模型
StreamEval:评估交互式流式视频生成模型
摘要
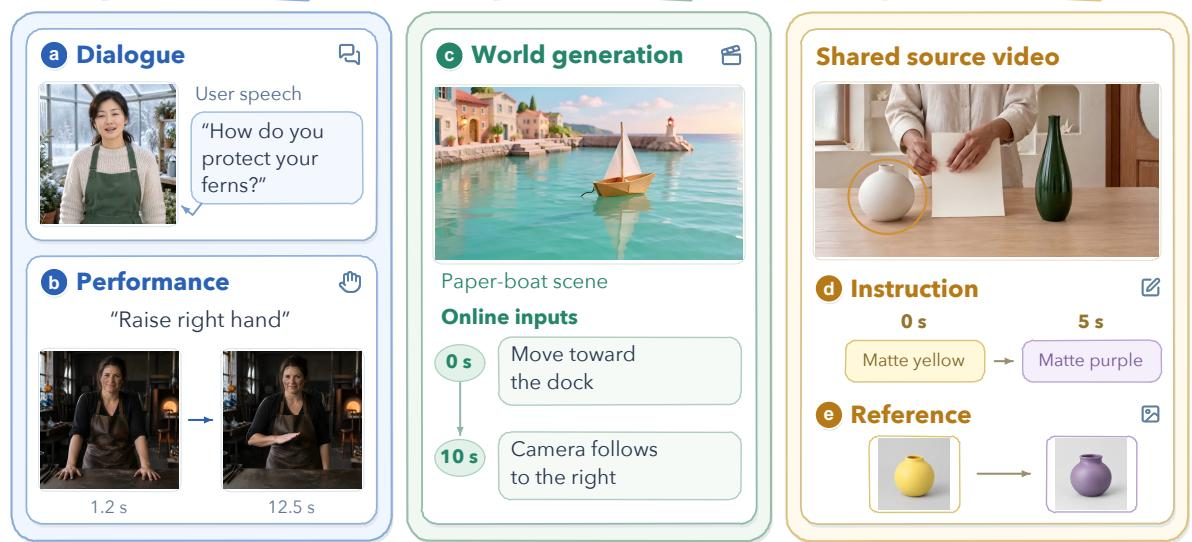
随着流式视频生成的进展,与生成视频进行实时交互变得日益重要。我们提出了 StreamEval,一个用于交互式流式视频生成的统一基准,涵盖五项任务:虚拟形象对话、虚拟形象表演、世界生成、指令编辑和参考编辑。StreamEval 包含 300 个脚本化测试用例,时长为 15–300 秒;每个用例指定初始资产、逐步到达的多模态请求,以及对状态变化和内容保留的明确要求。性能沿四个评估维度进行衡量:任务执行、状态一致性、视觉保真度和视听协调,并通过十个任务特定指标在 0–100 分制上加以具体化。通过评估 300 个测试用例上的 37 个不同模型,我们发现,高视觉质量和身份保持并不一定与可靠的请求执行或持续的状态一致性同时出现。特别是,请求执行仍然具有挑战性:在 7 个虚拟形象表演模型中,Following 的最高任务特定得分为 36.90;在文本条件世界生成中,Following 为 25.93;在 3 个已报告的参考编辑模型中,Edit Success 为 15.00。这些发现表明,在时序和内容保留约束下实现可靠的请求执行,是推进全模态实时交互系统的核心挑战。排行榜可在 https://streameval.ai 获取。
一句话总结
清华大学、NVIDIA、CMU 等机构的研究者提出了 StreamEval,一个面向交互式流式视频生成的统一基准,涵盖五个任务、300 个脚本化测试用例和十个任务专用指标,结果表明在全模态实时交互系统中,高视觉质量和身份保持并不能保证可靠的请求执行或持续的状态一致性。
核心贡献
- StreamEval 是一个统一的交互式流式视频生成基准,涵盖数字人对话、数字人表演、世界生成、指令编辑和参考编辑,通过 300 个 15–300 秒的脚本化测试用例,包含增量多模态请求以及明确的状态变化和内容保持要求。
- 该基准从四个维度评估性能:任务执行、状态一致性、视觉保真度和音画协调,使用十个任务专用指标,评分范围为 0–100。
- 对 37 个模型的评估表明,高视觉质量和身份保持并不能保证可靠的请求执行或持续的状态一致性,所报告的任务专用最高分包括:数字人表演的 Following 为 36.90,文本条件世界生成的 Following 为 25.93,参考编辑的 Edit Success 为 15.00。
引言
随着流式视频生成的发展,实时交互系统必须在执行新用户请求的同时,跨会话保持既有内容和状态,其应用包括对话式数字人、可控虚拟世界和实时视频编辑。现有基准覆盖了互补的评估片段,例如视觉质量、时序行为、构图、多轮控制、流式音视频更新、持续编辑和对话线索,但它们并未在明确的任务专用执行和保持标准下,将数字人交互、世界生成和实时编辑统一起来。
作者提出了 StreamEval,一个覆盖五项交互式流式任务和 300 个 15 至 300 秒脚本化测试用例的基准。每个用例指定了带时间戳的多模态输入、所需更改以及必须保持不变的内容,同时十个任务专用指标评估任务执行、状态一致性、视觉保真度和音画协调。作者评估了 37 个模型,揭示了它们在指令遵循和完整编辑完成方面的不同优势与仍然存在的局限。
数据集
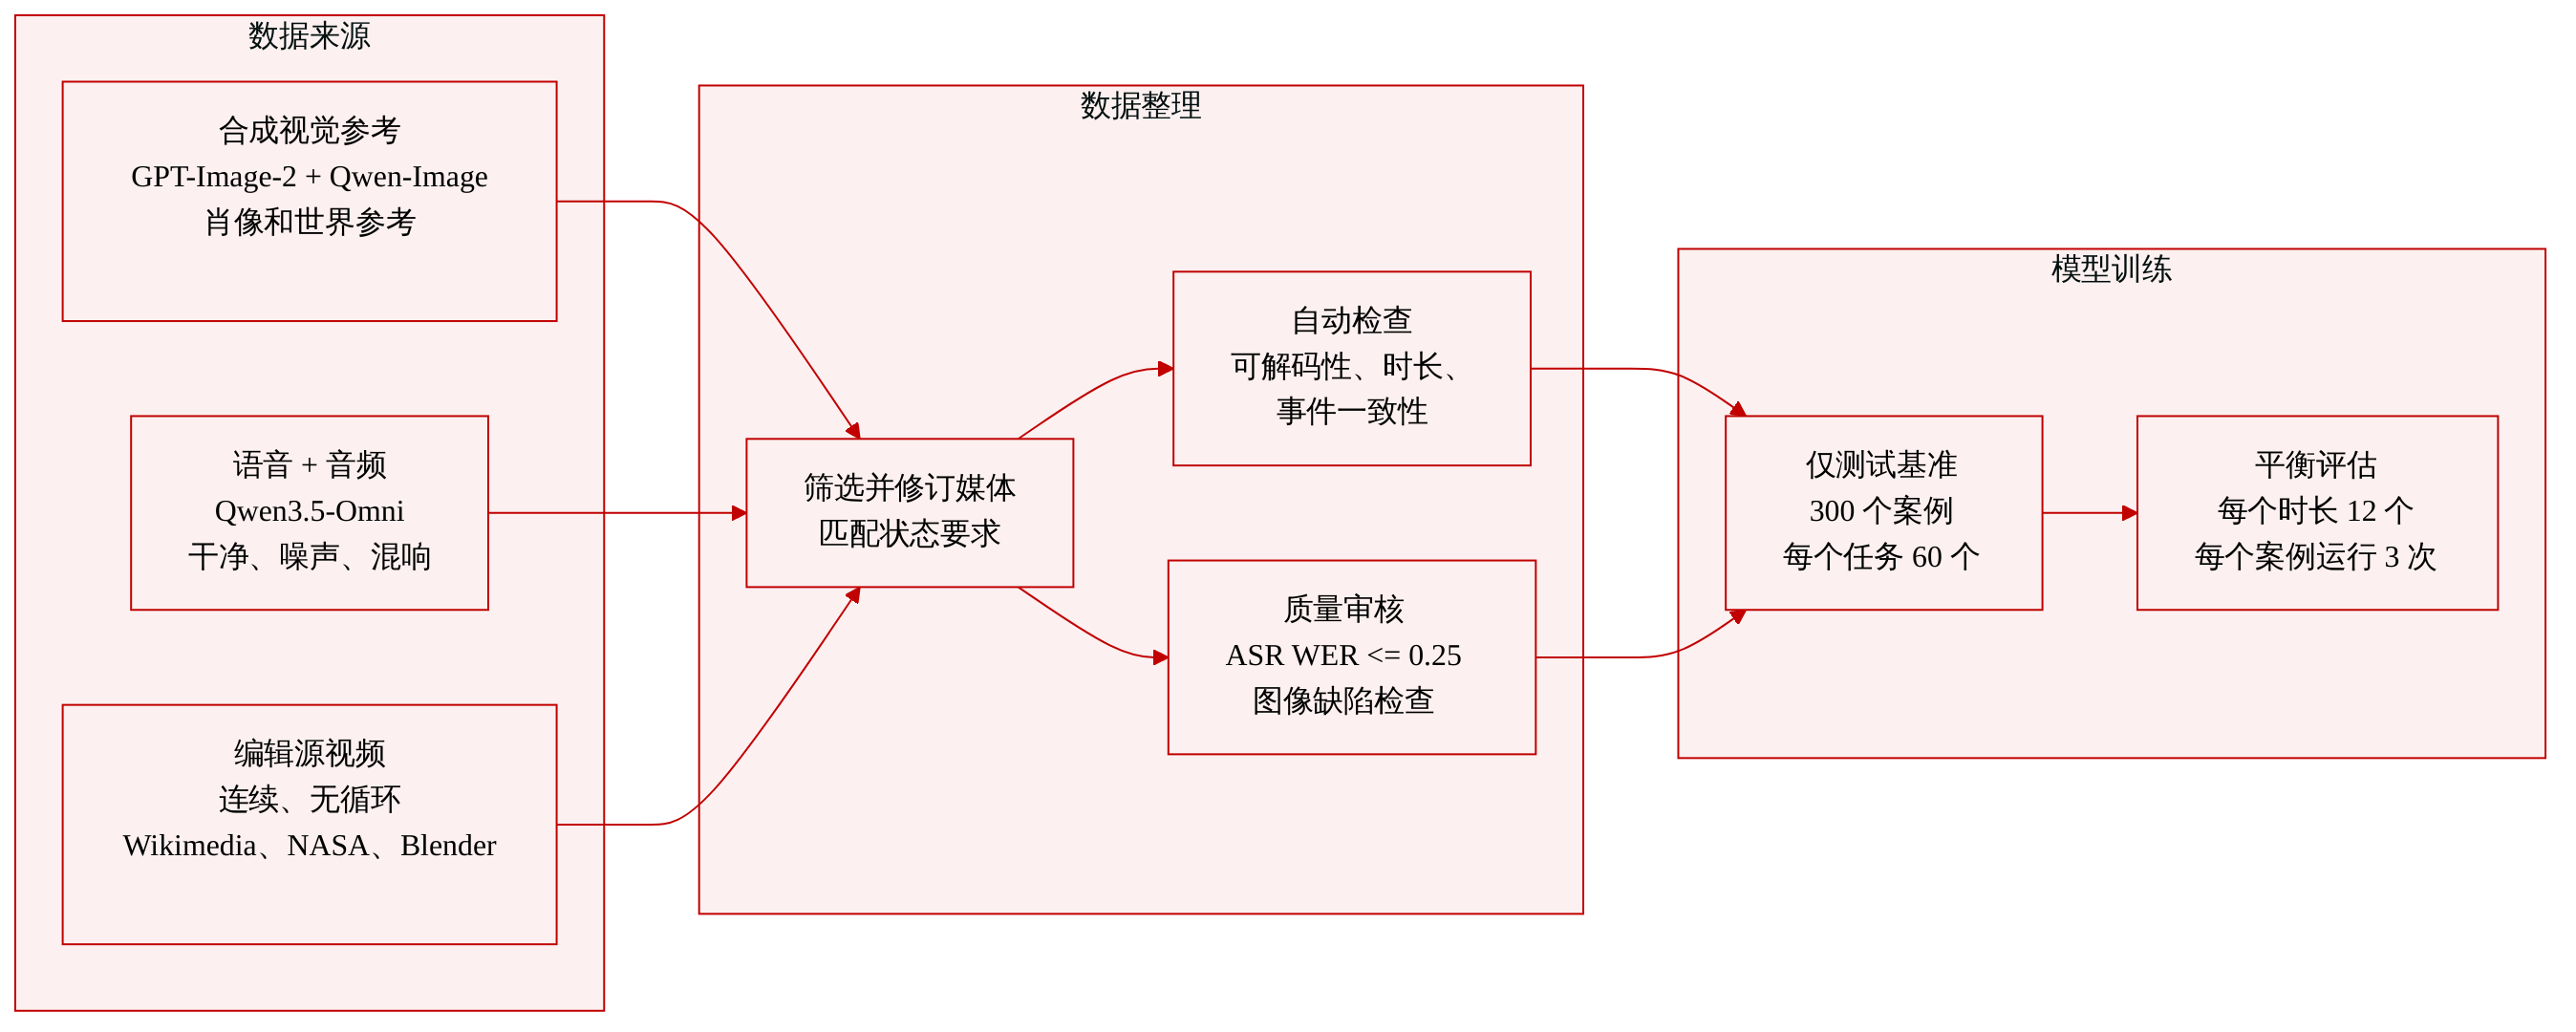
作者将 StreamEval 构建为一个评估基准,而非训练语料库。它包含 300 个测试用例,分布在五个流式任务轨道上,每个任务 60 个用例,并且时长均衡。
-
构成与来源
- 总计:300 个测试用例,每个任务 60 个;在 15、30、60、120 和 300 秒各时长档位各有 12 个用例。
- 视觉/数字人和世界生成输入:GPT-Image-2 和 Qwen-Image 合成肖像和视觉参考。肖像描绘原创合成成年人或风格化虚构角色。
- 对话与音频输入:Qwen3.5-Omni 生成富有表现力的用户语音和规定语音。这些录音与作者编写的角色设定和经过核验的事实配对,包括干净语音、背景噪声和房间混响。
- 文本对话衍生用例:60 个用例将音频轮次替换为编写文本,同时保留相同的源族身份。
- 编辑输入:连续源视频包括授权真实世界素材、动画和基准生成的场景。第三方来源包括 Wikimedia Commons、NASA 和 Blender Studio,并在发布中提供逐资产的许可证和归属信息。
-
元数据与状态构建
- Qwen3.8-Max 起草会话目标、定时控制、受保护属性和预期结果。
- 作者编写的 oracle 指定在每个检查点需要建立、保留、取消或恢复的内容。
- 编辑源中的目标区域由 Qwen3.8-Max 在计划的控制时间戳上进行时间定位。
-
处理与筛选
- 媒体输入根据明确的状态要求进行筛选和修改。
- 编辑源视频是连续的:无循环、无变速、无拼接。
- 未描述显式的裁剪策略;编辑使用连续视频源中的时间定位目标区域。
- 自动化检查验证媒体可解码性、时长边界、文件身份,以及事件、机会与评分要求之间的一致性。
- 合成语音通过 ASR 转录进行检查,与编写文本相比,归一化词错误率必须不超过 0.25。
- Qwen3.8-Max 审核图像的主体清晰度以及解剖结构或渲染缺陷。
- 编辑源会检查场景切换、冻结片段和不合适的目标。修改后的候选素材必须通过相同的检查。
- 评判器校准目标包括每类最多 5% 的假阳性、10% 的假阴性和 10% 的未解决判定。
-
统计信息
- 300 个用例涵盖 240 个独立源族。
- 60 个文本对话衍生用例复用现有源族。
- 完整运行一遍全部 300 个视频会话用例代表 525 分钟的主动流式生成,不包括设置和响应尾部。
- 该基准包含 1,347 个计划的在线事件,不包括初始化和连续源帧。
- 数字人设计涵盖照片级真实风格、风格化 3D、动漫以及黏土或定格动画外观。
- 对话包含干净语音、背景噪声和房间混响。
- 编辑覆盖室内和室外场景,包含单个或多个目标。
-
数据使用方式
- 该数据集用作测试/评估基准。
- 评估使用全部 300 个用例,每个用例和每个模型进行三次独立运行。
- 在每个任务内,五个时长层获得相等的聚合权重。
- 这些章节未报告训练划分或混合比例;论文在该基准上评估了 37 个模型。
方法
作者通过一条结构化流水线构建 StreamEval 基准,将在线输入与明确的状态要求配对。该过程始于场景编写,作者利用 Qwen3.8-Max 根据源帧、任务目标和目标状态起草会话目标、定时控制、受保护属性和预期结果。随后,作者编写的 oracle 指定在每个检查点需要建立、保留、取消或恢复的内容。
在场景编写之后,系统生成多模态输入。图像合成利用 GPT-Image-2 和 Qwen-Image 创建肖像和视觉参考。语音合成采用 Qwen3.5-Omni 生成富有表现力的对话音频。此外,对授权视频进行处理,以提取用于实时编辑任务的源窗口。
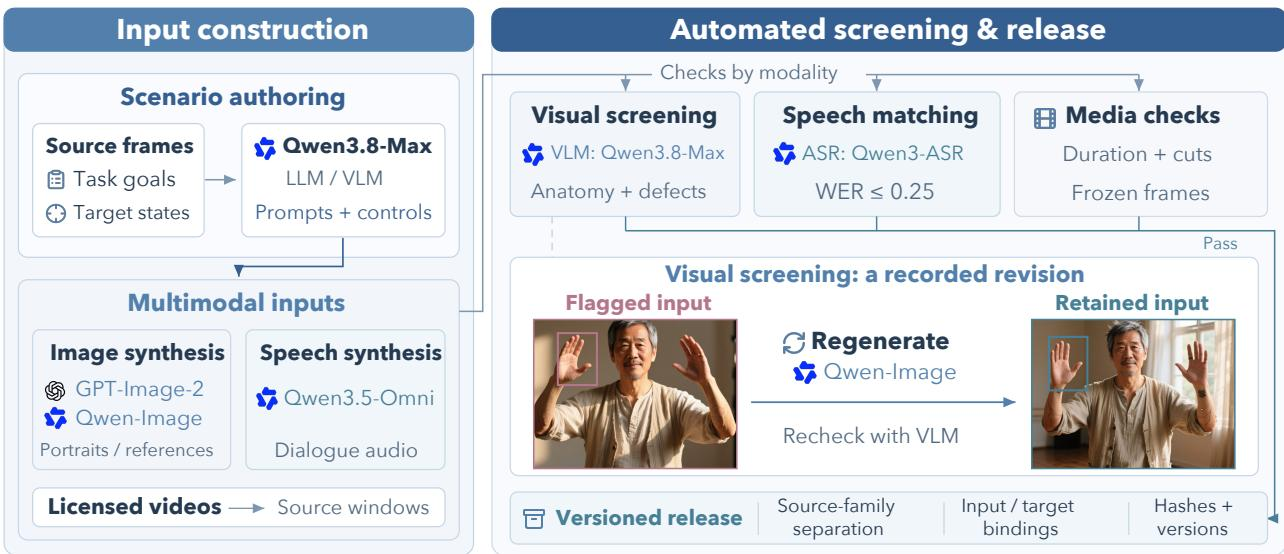
输入构建完成后,会经过自动化筛选和发布,其中包含模态特定的检查。视觉筛选用 VLM Qwen3.8-Max 执行,以检测解剖结构或渲染缺陷。语音匹配利用 Qwen3-ASR 转录合成语音,要求与编写文本相比的归一化词错误率不超过 0.25。媒体检查验证时长边界、场景切换和冻结帧。
如果在视觉筛选期间某个输入被标记,例如手部有缺陷的肖像,系统会启动一个有记录的修改流程。被标记的输入会使用 Qwen-Image 重新生成,然后由 VLM 重新检查。只有通过所有筛选检查的输入才会被保留。最后,包括时间线、oracle 和媒体在内的基准用例会被准备为带版本的发布,以确保源族分离、输入与目标绑定以及通过哈希进行版本跟踪。
实验
论文在 StreamEval 基准上评估了 37 个模型,该基准测试跨五个任务的实时交互视频:数字人对话、数字人表演、世界生成、指令编辑和参考编辑。实验设置使用 300 个调度的多时长会话并进行重复运行,对任务执行、状态一致性、视觉保真度和音画同步进行评分。结果表明,数字人定制和对话质量相对较强,但受时间约束的动作执行、在线控制下的世界连续性以及完整视频编辑遵从仍然困难;模型通常在保留源内容方面比采用所请求的编辑或保持稳定渲染做得更好。
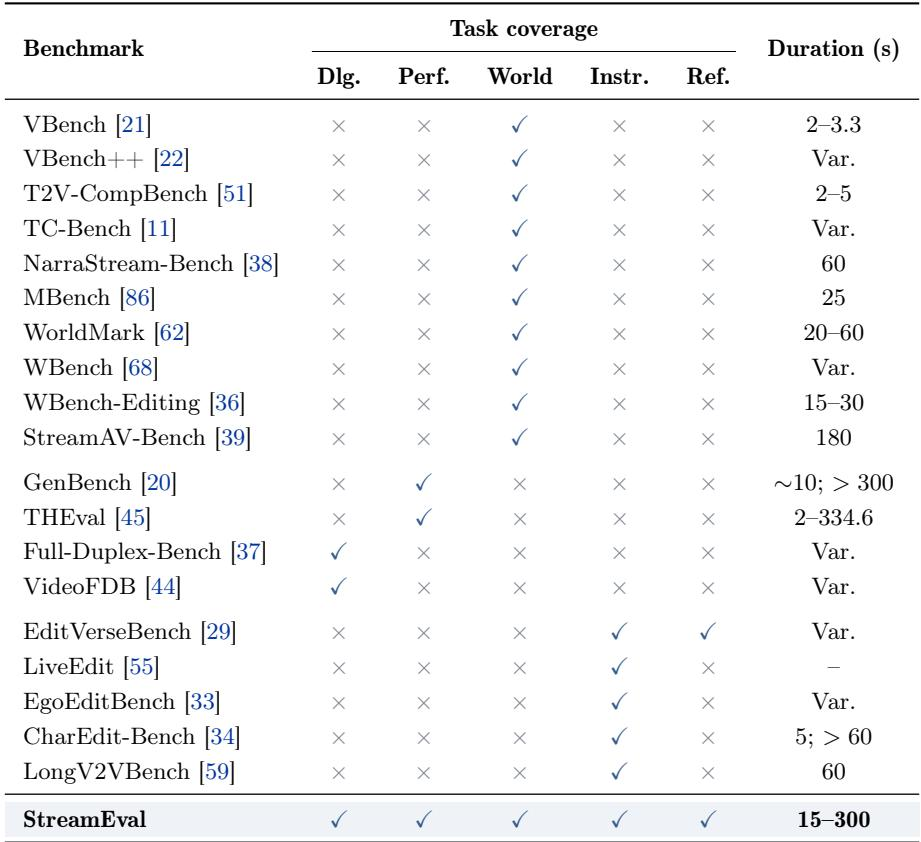
对比表明,提取行中的现有基准大多局限于世界生成,评估时长较短或长短不一,而对话、数字人表演和编辑任务被分开处理或省略。StreamEval 则不同,它在一个框架内涵盖对话、数字人表演、世界生成、指令编辑和参考编辑,并具有最长 300 秒的均衡多时间跨度时长。它更长的编辑和世界生成跨度超出了 LongV2VBench 和 StreamAV-Bench 等先前基准。所列的现有视频生成基准仅覆盖世界生成,并报告较短或可变的时长,在明确说明时通常最长为 60 秒。StreamEval 覆盖全部五个受评估的流式任务,并应用最长 300 秒的均衡时长档位,提供比所引先前基准更长的评估跨度。
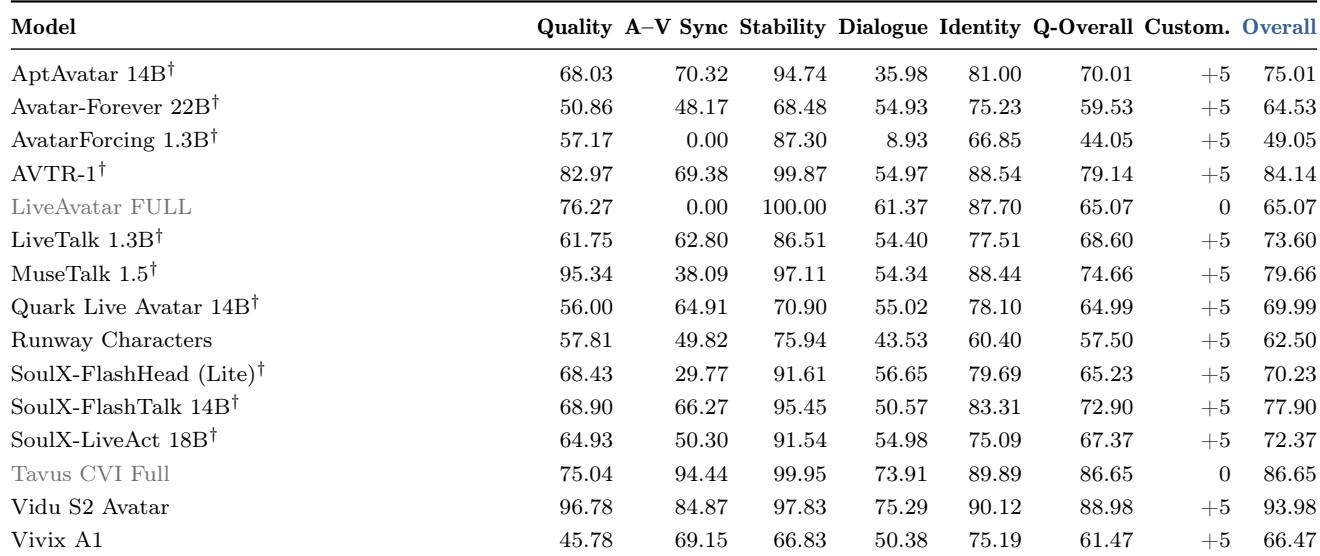
在数字人对话评估中,Vidu S2 Avatar 等自定义数字人模型在整体质量、视觉保真度、对话和身份方面处于领先,AVTR-1 在所报告的自定义数字人系统中紧随其后。固定数字人系统没有定制加分;Tavus CVI Full 在整体质量和身份上优于 LiveAvatar FULL,并在共享模型中取得最高的音画同步分数。高稳定性和视觉质量并不一定转化为强大的对话或同步。Vidu S2 Avatar 在自定义数字人对话模型中取得了最高的 Overall、Quality、Dialogue 和 Identity 分数。Tavus CVI Full 在共享系统中录得最高的 A-V Sync,并在 Q-Overall 和 Identity 上领先固定数字人模型,超过 LiveAvatar FULL。MuseTalk 1.5 兼具高视觉质量、稳定性和身份保持,但 A-V Sync 和 Dialogue 明显更弱,体现了跨评估维度的权衡。LiveAvatar FULL 达到完美 Stability,但无可测量的 A-V Sync,突显了时间一致性可以在没有音画对齐的情况下出现。
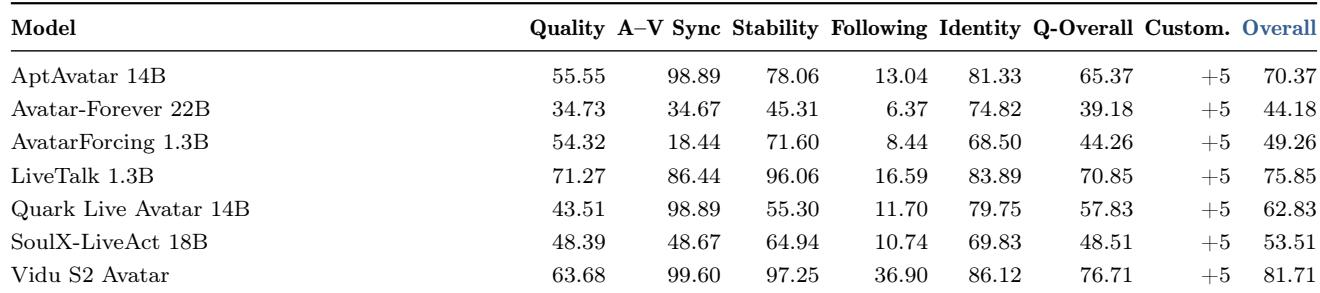
在数字人表演方面,Vidu S2 Avatar 和 LiveTalk 1.3B 整体领先,Vidu S2 Avatar 在音画同步、稳定性、身份保持和指令遵循方面最强,而 LiveTalk 1.3B 在视觉质量上领先。中等排名的系统通常表现出相似的唇形同步和身份保持,但在时间稳定性和视觉质量上存在差异。在时间约束下执行脚本化动作仍然是主要挑战,所有七个系统的 Following 分数差异很大。Vidu S2 Avatar 和 LiveTalk 1.3B 整体领先,但具有不同特点:Vidu S2 Avatar 在同步、稳定性、身份和 Following 上表现出色,而 LiveTalk 1.3B 在 Quality 上领先。全部七个系统都支持自定义数字人并获得自定义数字人加分;在时间约束下遵循脚本化动作仍然是最薄弱的部分,即使在身份和稳定性较强的系统之间也存在很大差异。
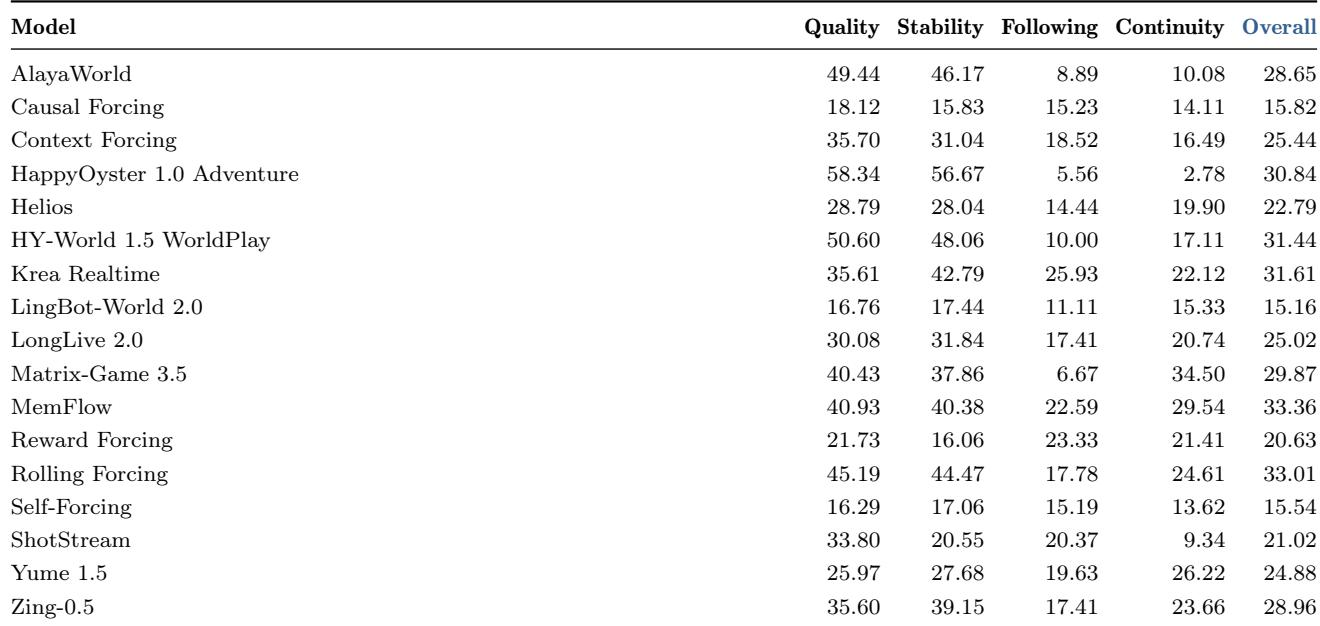
在世界生成方面,文本条件和图像条件配置被一起排名,对同时用两种输入评估的模型采用文本条件结果。MemFlow 整体领先,紧随其后的是 Rolling Forcing、Krea Realtime、HY-World 和 HappyOyster。性能在 Quality、Stability、Following 和 Continuity 上差异明显,单项指标的领先者通常与整体领先者不同。MemFlow 拥有最高的 Overall 分数,紧随其后的是 Rolling Forcing、Krea Realtime、HY-World 1.5 WorldPlay 和 HappyOyster 1.0 Adventure。HappyOyster 1.0 Adventure 在 Quality 和 Stability 上领先,但在 Following 和 Continuity 上得分低得多。Krea Realtime 拥有最高的 Following 分数,而 Matrix-Game 3.5 拥有最高的 Continuity 分数。
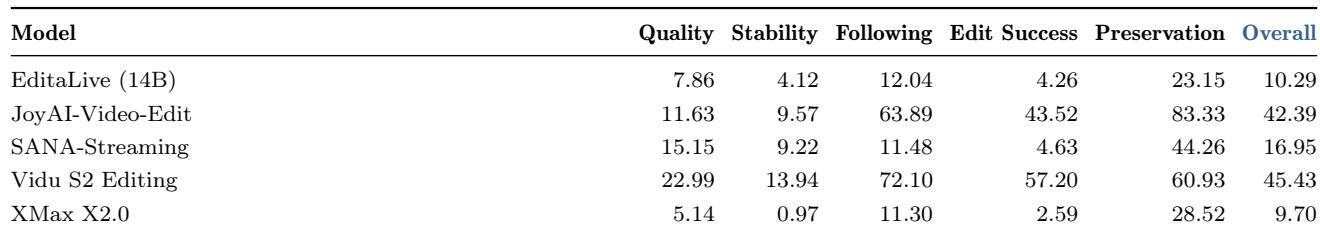
在指令编辑方面,Vidu S2 Editing 和 JoyAI-Video-Edit 大幅领先于其他所报告的模型。Vidu S2 Editing 在 Following、Edit Success、Quality 和 Stability 上表现最强,而 JoyAI-Video-Edit 在 Preservation 上领先。即使是顶级系统也表现出相对较低的质量和稳定性,表明在实时编辑中保持干净的时间渲染仍然困难。Vidu S2 Editing 和 JoyAI-Video-Edit 在指令编辑上大幅领先,而其余所报告的模型整体得分显著更低。Vidu S2 Editing 录得最高的 Following、Edit Success、Quality 和 Stability,JoyAI-Video-Edit 实现最强的 Preservation。在领先系统中,Edit Success 始终低于 Following,这反映出满足完整编辑约束(如范围、时间和持久性)的额外难度。即使对得分最高的模型而言,Quality 和 Stability 仍然较低,突显了在实时编辑中维持干净时间渲染的挑战。
StreamEval 被提出为一个统一基准,涵盖对话、数字人表演、世界生成、指令编辑和参考编辑,并具有最长 300 秒的均衡多时间跨度时长,超越了主要关注世界生成且时长较短或可变的先前基准。在数字人对话和数字人表演中,Vidu S2 Avatar 等自定义数字人模型在整体质量和身份上领先,但高稳定性并不能保证音画同步,并且在时间约束下执行脚本化动作仍然是最薄弱的方面。对于世界生成和指令编辑,MemFlow 和 Vidu S2 Editing 等整体领先者并非在所有子指标上都表现一致,即使顶级系统也在连续性、保持、质量和稳定性方面存在困难,突显了任务特定的权衡以及持续时间渲染的难度。