Command Palette
Search for a command to run...
Omni-Woodpecker:通过证据-先验再平衡实现全模态大语言模型的幻觉校正
Omni-Woodpecker:通过证据-先验再平衡实现全模态大语言模型的幻觉校正
Zijian Liu Chaoyou Fu Yan Yang Caifeng Shan Ran He
摘要
近期,全模态大语言模型(Omni LLM,OLLM)在音视频联合推理方面展现出显著能力,但跨模态幻觉仍是一项重大挑战。现有缓解方法主要作用于输出层面,忽视了融合表示中支撑证据与学习先验之间的纠缠。为解决这一问题,我们提出 Omni-Woodpecker(OWP),一个免训练框架,将幻觉缓解从输出层面的操控转变为以冲突为条件的表示再平衡。具体而言,OWP 首先从互补的模态特定视角识别跨模态冲突;随后采用正交分解,在隐藏状态中将支撑证据与竞争性先验分离开来;最后在解码前通过抑制误导性先验并恢复被忽略的证据,自适应地再平衡融合表示。大量实验证明了 OWP 的有效性和强大的跨架构泛化能力。以 Qwen2.5-Omni-7B 作为骨干模型,OWP 在 CMM 和 AVHBench 上分别将性能提升了 12.9 和 8.6分,同时在四个通用 OLLM 推理基准上持续取得 0.67–2.25分的提升。此外,OWP 可有效泛化至 VideoLLaMA2-AV,在相同基准上分别将性能提升了 4.6 和 3.9分。代码已公开发布于 https://github.com/ZiiJianLiu/Omni-Woodpecker。
一句话总结
作者提出了 Omni-Woodpecker (OWP),一个免训练框架,通过识别冲突并使用正交分解来再平衡融合表示,抑制误导性先验并恢复被忽略的证据,从而纠正 Omni LLM 中的跨模态幻觉;以 Qwen2.5-Omni-7B 为骨干,它在 CMM 和 AVHBench 上分别提升了 12.9 和 8.6 个点,并且可迁移到 VideoLLaMA2-AV,在相同基准上分别提升 4.6 和 3.9 个点。
核心贡献
- Omni-Woodpecker 是一个免训练框架,将 omni LLM 中的幻觉缓解重新定义为以冲突为条件的表示再平衡,而不是输出级修正。
- 该方法从互补的模态特定视图中检测跨模态冲突,应用正交分解在隐藏状态中将支撑证据与竞争性先验分离,并在解码前自适应地抑制误导性先验、恢复被忽略的证据,根据诊断出的冲突将修正分配到注意力路径和残差状态。
- 在 Qwen2.5-Omni-7B 上的实验使 CMM 和 AVHBench 分别提升 12.9 和 8.6 个点,在四个通用 omni 模态推理基准上获得了 0.67 到 2.25 个点的提升;该方法还迁移到 VideoLLaMA2-AV,使 CMM 和 AVHBench 分别提升 4.6 和 3.9 个点。
引言
Omni LLM 将大型语言模型扩展为联合处理文本、视觉和音频,支持跨模态推理,但也带来了可靠性挑战:当模态提供不完整或相互冲突的线索时,模型可能正确编码了证据,却在融合过程中让强学习先验覆盖了证据。现有的缓解方法,如对比解码、模态自适应生成和偏好优化,通过校准解码分布或响应偏好将幻觉视为输出级异常,但在早融合模型中,支撑证据和先验在解码开始前就已在隐藏表示中纠缠,因此这些方法未解决底层冲突。作者提出了 Omni-Woodpecker,一个免训练框架,通过检测以查询为条件的跨模态冲突,将支撑证据与竞争性先验分离,并在解码前恢复被抑制的证据、抑制误导性先验,从而将缓解转移到表示级再平衡,而无需修改模型参数或语言头。这将 omni 模态幻觉重新定义为证据与先验之间的表示失衡,而不是感知失败。
方法
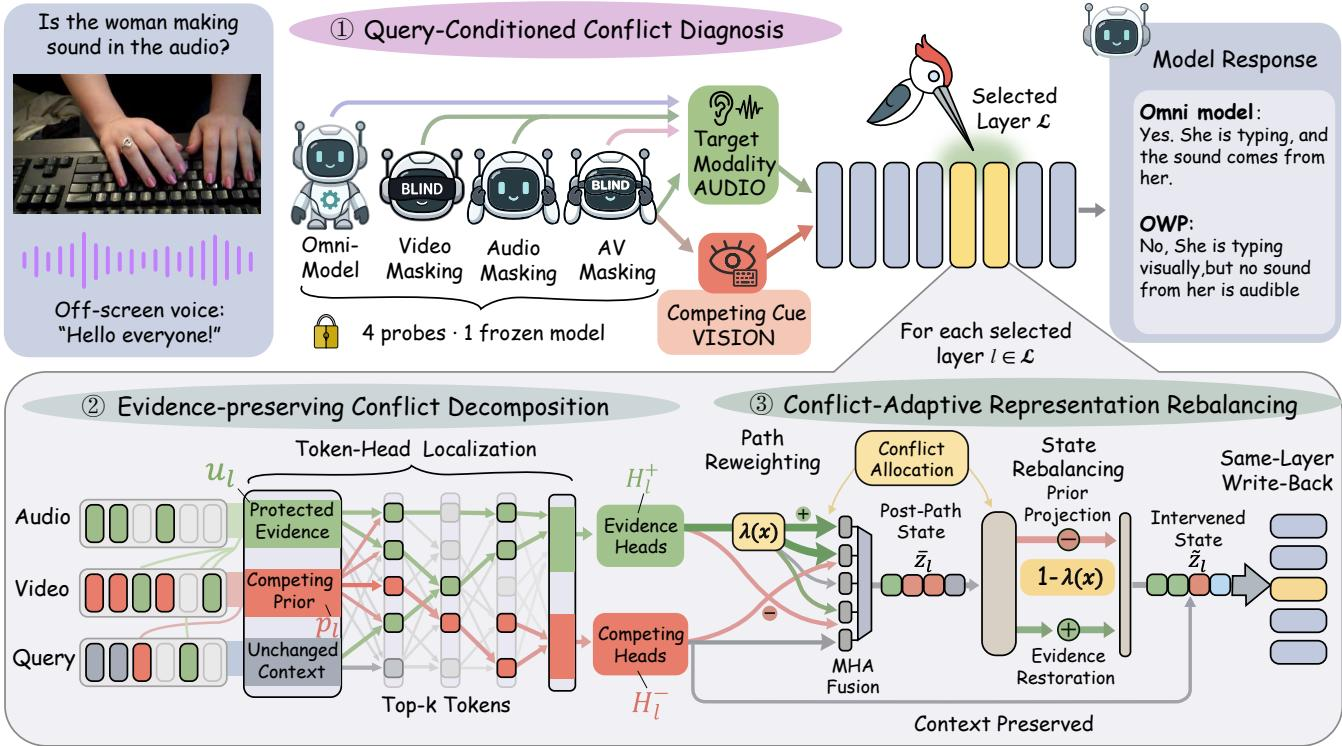
作者提出了 Omni-Woodpecker(OWP),这是一个免训练框架,旨在通过再平衡融合表示中的支撑证据和学习先验,纠正 Omni 大型语言模型(OLLM)中的跨模态幻觉。OWP 不操作最终解码分布,而是直接作用于冻结模型的内部隐藏状态。该流程由三个顺序阶段组成:以查询为条件的冲突诊断、保留证据的冲突分解,以及冲突自适应表示再平衡。
在第一阶段,即查询条件冲突诊断阶段,框架识别查询所需的目标模态,以及导致幻觉的竞争模态。作者在四种不同的输入视图上运行冻结模型:完整多模态输入 xF=(q,v,a)、仅音频 xA=(q,a)、仅视频 xV=(q,v) 和仅文本 xT=q,其中 q、v 和 a 分别表示查询、视频和音频。为了确定目标视图,会追加一个诊断查询,提示模型给出所需模态,并通过 next-token logits 上的 softmax 概率选择目标。然后,通过评估哪个单模态分支与全视图答案一致,同时表现出比目标分支更高的源归一化注意力质量,来识别竞争视图。
第二阶段,即保留证据的冲突分解阶段,将这些视图之间的差异转化为精确的表示编辑。作者首先计算校准后的证据方向 uℓ,它锚定目标证据,同时只保留支持目标答案的跨视图分量。这通过计算偏好分数和信任项来对目标证据、非目标信息以及融合偏移进行加权实现。接下来,通过将融合偏移投影到证据方向的正交补上,推导出正交冲突方向 pℓ 和证据缺口 gℓ。这确保抑制竞争先验时不会触及忠实证据分量。同时,头部级冲突定位会识别需要编辑的具体注意力头。通过分析源注意力和与答案对齐的 value 贡献,框架在每层将头部划分为竞争集合 Hℓ− 和证据集合 Hℓ+。
在最后一个阶段,即冲突自适应表示再平衡阶段,框架通过将一个修正预算拆分为注意力路径修改和残差状态更新来应用计算得到的编辑。该分配由路径份额 λ(x) 控制,该份额由全视图答案偏好决定。弱偏好会将更多控制转移到路径级,而强偏好则将修正导向残差状态。路径级编辑在多头注意力聚合之前重新加权 token-head 路由:从竞争头中减去源对齐的 value,并从证据头中加入证据对齐的 value。然后,残差级编辑抑制正交先验分量,并恢复测得的证据缺口。更新后的状态被写回同一层,确保在解码前抑制导致幻觉的线索,同时保留上下文。
实验
实验使用 Qwen2.5-Omni-7B 和 VideoLLaMA2-AV,在跨模态冲突基准、音视频匹配和通用 omni 模态推理任务上评估 Omni-Woodpecker,并与解码和表示编辑基线进行对照比较。结果验证了该框架能双向纠正冲突、保留联合音视频证据、在不同骨干之间迁移,并在保持更高效的同时改善通用推理。消融和机制分析表明,先验抑制和证据增强互补起作用,残差编辑是主要修正位置,证据恢复和先验移除在不同层之间分离。
在所列外部 omni 骨干中,Qwen3-Omni 取得了最强的整体 CMM 和 AVHBench 性能,而 VITA-1.5 始终落后。OmniVinci 在 CMM 指标上具有竞争力,但在 AVHBench 上落后于 Qwen3-Omni。所提出的 Omni-Woodpecker 框架显著改善了 Qwen2.5-Omni-7B 骨干,提升了抗幻觉能力和感知精度,并在两个基准上都优于 Qwen3-Omni。Qwen3-Omni 在所列外部骨干中整体结果最好,而 VITA-1.5 在大多数指标上最弱。使用 Qwen2.5-Omni-7B 的 Omni-Woodpecker 将 CMM 抗幻觉能力从 57.0% 提高到 85.5%,并在 CMM 和 AVHBench 上分别超过 Qwen3-Omni 4.3 和 6.2 个点。
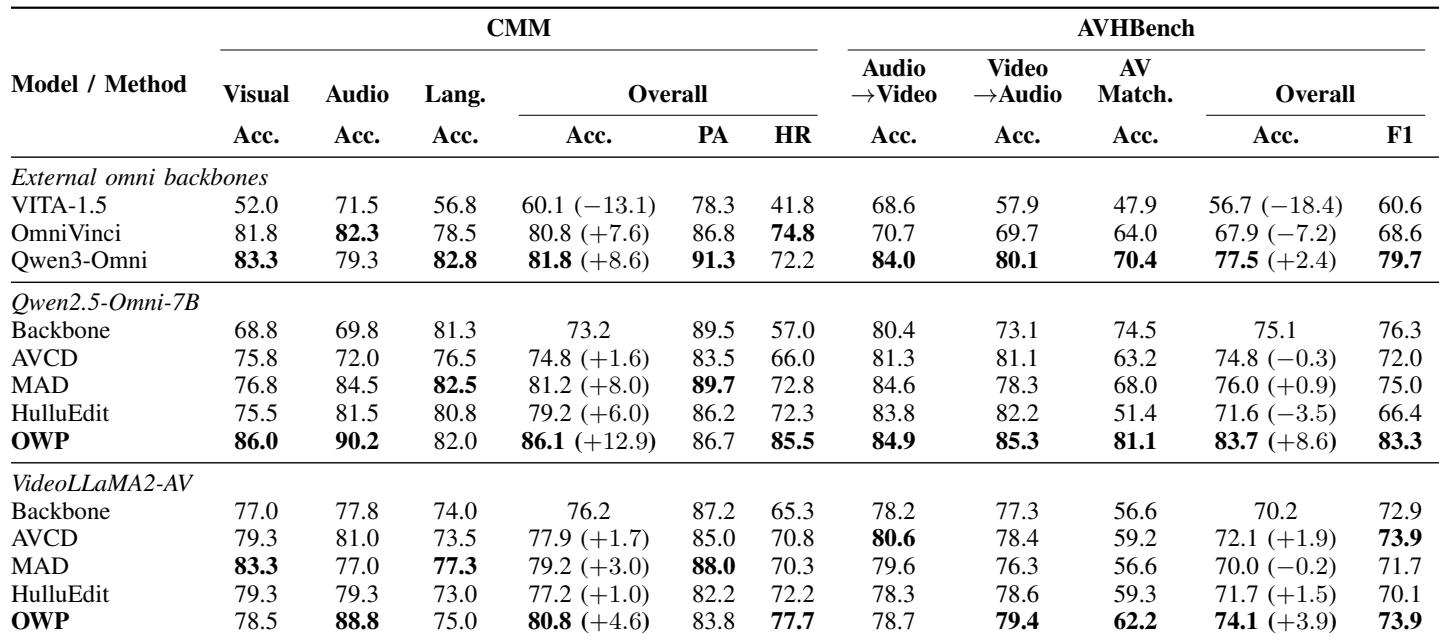
实验在 CMM 和 AVHBench 基准上,使用若干外部 omni 骨干和所提出的 Omni-Woodpecker 框架,评估抗幻觉能力和感知精度。在外部骨干中,Qwen3-Omni 整体表现最好,VITA-1.5 始终落后,OmniVinci 在 CMM 上具有竞争力,但在 AVHBench 上较弱。所提出的带有 Qwen2.5-Omni-7B 骨干的 Omni-Woodpecker 显著改善了两项指标,并在两个基准上都超过了 Qwen3-Omni。