Command Palette
Search for a command to run...
Physical Words:用于结构化机器人操作中潜在推理的词汇表
Physical Words:用于结构化机器人操作中潜在推理的词汇表
摘要
多模态推理为机器人基础模型提供可靠动作生成所需的预测性上下文。然而,基于语言的推理能够捕捉任务语义,却难以表达细粒度物理动力学;潜在推理能够建模未来状态演化,但可用于将这些动力学组织为可复用推理原语的结构有限。为了弥合这一差距,我们提出 PhysWord,一种建立在 Physical Words 之上的先推理后行动基础模型;该词汇使用原子动作动词作为共享语义锚点,以实现物理动力学的连续表示。具体而言,PhysWord 预测即将到来的原子动作词,并将其上下文隐藏状态直接与由相应未来观测导出的潜在目标对齐。基于这些原语,我们构建了一个具有时间结构的 PhysWord 空间,其中为每个动作词提供视觉变体和可选触觉变体。在未来时间步自回归地预测 Physical Words 能够捕捉执行阶段之间的转换,从而为动作生成提供结构化多模态上下文。PhysWord 在视觉触觉 UniVTAC 上取得 90.3% 的当前最优成功率,在基于视觉的 LIBERO-Long 上取得 99.6% 的当前最优成功率,并在采用双臂夹爪和灵巧手的真实世界任务中优于竞争方法。进一步评估表明,我们的结构化潜在推理框架能够泛化到未见场景,并支持长程操作。
一句话总结
NVIDIA、北京大学和加州大学伯克利分校提出 PhysWord,这是一种先推理后行动的基础模型,使用物理词(Physical Words),即原子动作动词,作为共享语义锚点,以表示连续物理动态,并将上下文隐藏状态与源自未来观测的潜在目标对齐,同时跨时间组织视觉以及可选的触觉动作变体。该模型在视觉触觉 UniVTAC 上达到 90.3% 的最先进成功率,在基于视觉的 LIBERO-Long 上达到 99.6%,同时在真实世界的双臂夹爪和灵巧手任务上优于其他方法。
核心贡献
-
PhysWord 是一个先推理后行动的基础模型,使用原子动作动词作为物理词,通过预测即将到来的动作词,并使其上下文隐藏状态与来自未来观测的潜在目标对齐,从而锚定连续物理动态。
-
物理词空间在时间上被结构化组织,包含每个动作词的视觉与触觉变体,并通过对未来时间步的自回归预测捕捉执行阶段之间的转换,用于动作生成。
-
PhysWord 在视觉触觉 UniVTAC 上达到 90.3% 成功率,在基于视觉的 LIBERO-Long 上达到 99.6%;在真实世界中使用双臂夹爪和灵巧手开展实验,展示了接触丰富、精准、长时序的操作能力,并能泛化到未见场景。
引言
作者研究视觉-语言-动作(VLA)机器人领域,其中通用机器人控制不仅要求解释视觉和语言指令,还要求预测操作过程中物理状态如何变化。先前的先推理后行动方法有助于规划动作,但基于语言的推理通常过于粗略,难以描述细粒度动态;而潜在表示或世界模型方法能够捕捉物理演化,却未围绕可复用的动作含义进行组织。作者提出 PhysWord,它使用 pick、rotate、push 等原子动作动词作为潜在未来动态的语义锚点。这为动作生成构建了结构化的物理上下文,支持视觉和触觉建模,并提升了长时序、接触丰富的机器人操作。
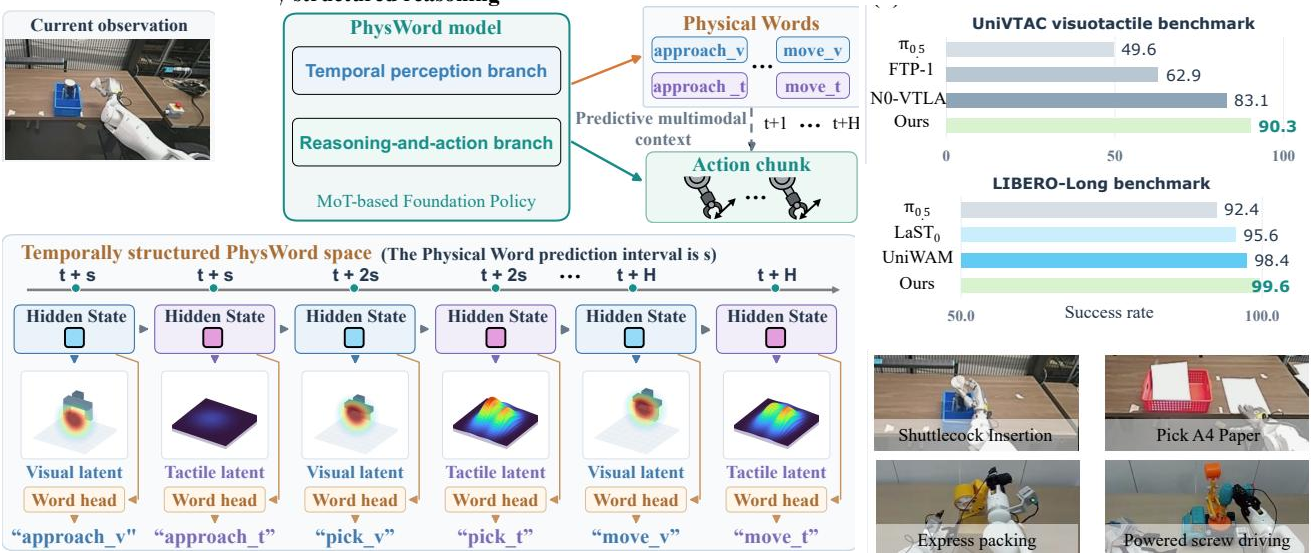
方法
作者提出 PhysWord,这是为语言条件下的机器人操作中的结构化潜在推理设计的框架。该模型采用混合 Transformer 架构,包含两个主要分支:由 Cosmos-Predict2.5-2B 初始化的时序感知分支,以及由 Qwen3-VL-2B 初始化的推理与动作分支。
如图所示:
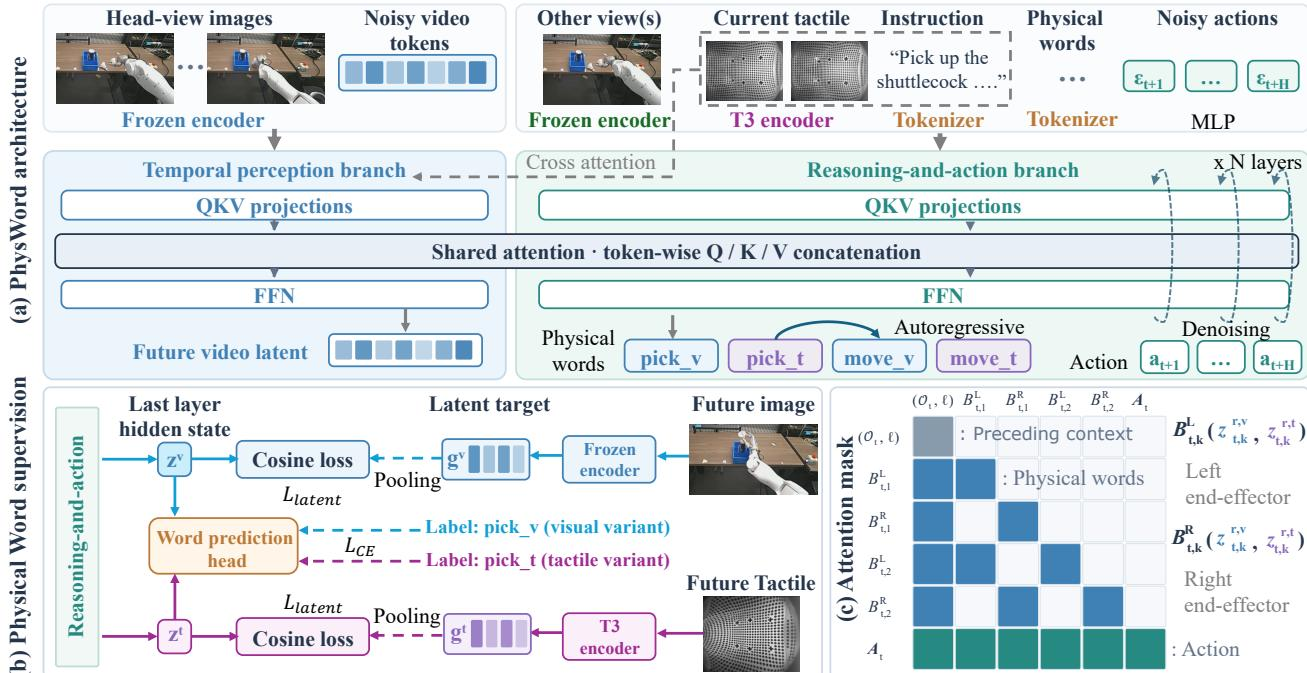
时序感知分支编码视觉历史并预测场景演化,而推理与动作分支生成物理词,随后生成机器人动作。对于多模态输入,时序分支处理头部视角观测序列以预测未来帧。推理与动作分支处理其余相机视角和语言指令。当存在触觉传感时,T3 编码器从 3D 视觉-触觉观测中提取特征。这些特征基于末端执行器配置进行聚合,夹爪情况下拼接传感器特征,灵巧手情况下池化指尖特征,以形成与语言模型嵌入维度相匹配的触觉 tokens。两个视觉编码器在训练期间保持冻结。两个分支保留独立的 QKV 投影和前馈网络,但沿 token 维度拼接其查询、键和值特征以实现共享注意力。在推理时,时序分支执行单步去噪,以缓存用于后续 token 生成的预测特征。
为了衔接高层语义与连续物理动态,作者引入物理词作为推理原语。每个物理词将一个原子动作标签与一个上下文隐藏状态耦合,该隐藏状态表示未来的视觉或触觉动态。该框架定义了 16 个原子动作标签,每个标签分别实例化为视觉和触觉变体,以避免不同潜在空间间产生冲突监督。这些变体从预训练嵌入共享通用语义初始化,但保持独立的可训练条目。每个物理词的隐藏状态接受联合监督:动作标签采用交叉熵损失,并通过余弦距离损失与来自未来感官的潜在目标对齐。未来视觉目标通过对未来头部视角图像进行编码与池化得到,触觉目标则通过对未来观测应用同一 T3 编码器构建。
为了捕捉动作语义和接触条件的连续演化,作者将物理词组织为时间结构化空间。物理词并非逐时间步密集预测,而是在动作时间范围内按间隔预测。这些表示被组织为按未来时间步排序的块,并将左侧与右侧末端执行器预测归入同一组。模型在这些未来时间步块上自回归生成物理词。施加块状因果注意力掩码,允许每个末端执行器时间步块内部采用全注意力,并在其自身各块之间采用因果注意力,同时严格阻断跨末端执行器注意力。
训练过程分为两个阶段:在人类和机器人示范上进行大规模预训练,然后进行任务特定微调。在两个阶段中,作者联合优化四项目标:用于视频预测的流匹配损失、用于物理词标签的交叉熵损失、用于未来潜在预测的余弦对齐损失,以及用于动作生成的流匹配损失。潜在对齐损失定义为:
Llatent=1−∥zt∥2∥gt∥2+εzt⊤gt其中 ε 确保数值稳定性。总目标组合所有四项损失:
L=Lvideo+LCE+Llatent+Lact这种联合优化确保动作语义在共享上下文表示中与未来物理动态紧密耦合。
实验
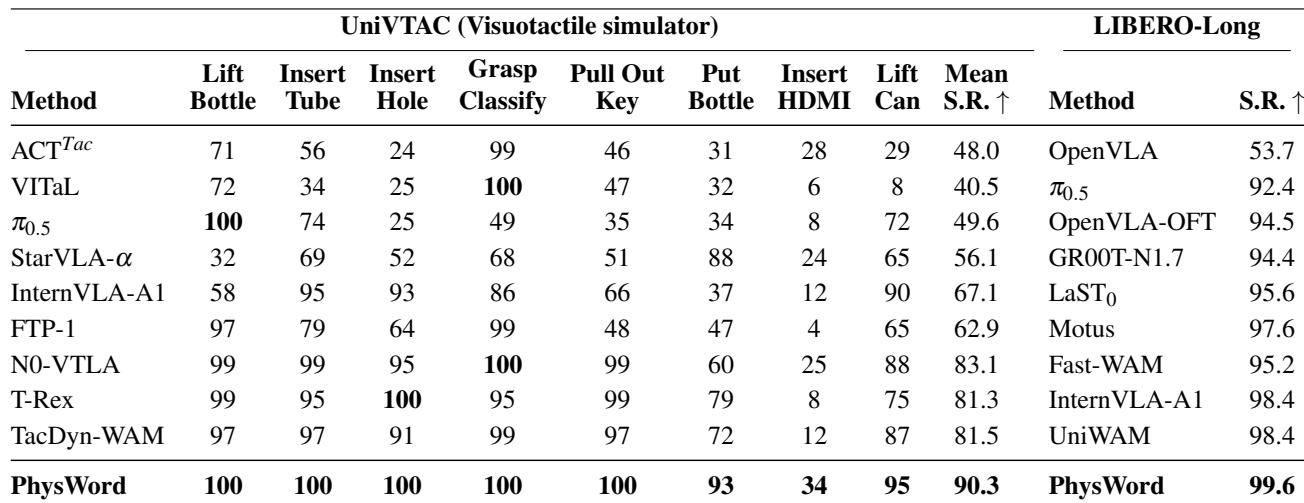
本文在两个仿真基准 UniVTAC 和 LIBERO-Long 上评估 PhysWord,以将其与基于视觉的基线、触觉基线、VLA 基线和世界模型基线进行比较,随后通过消融实验检验物理词监督和时间组织的贡献,最后评估真实机器人平台上的操作能力。实验表明,PhysWord 对接触丰富和长时序任务均有效,预测的触觉潜表示与测量的触觉信息高度一致,原子词监督产生了更一致、更具语义基础的动作表示。消融实验表明,联合语义与潜在监督、直接隐藏状态对齐以及合适的较密预测间隔能够提升性能。真实世界结果进一步证明,在未见过配置和长时序任务上具有更强鲁棒性,表明物理词可在上下文演化过程中复用已学习的动作语义。
PhysWord 在视觉触觉和长时序比较中获得最强平均成功率,并优于支持触觉的基线和基于视觉的基线。其最大优势出现在需要持续运动协调和敏感接触处理的任务上。预测的触觉潜表示几乎与测量的触觉输入相匹配,仅视觉物理词也支持长时序任务成功。PhysWord 在视觉触觉基准上领先支持触觉和基于视觉的基线。当用预测的触觉潜表示替代测量的触觉输入时,预测的触觉潜表示仍保留完整模型的大部分性能。PhysWord 也改进了相比 VLA 和世界模型基线的长时序操作。
PhysWord 在全部四项真实世界操作任务上取得最高成功率,优于 VLA 基线和触觉基础策略。它在接触丰富的灵巧手任务和长时序夹爪任务上尤其强,在更低运行间波动下展现出更高平均成功率。该方法在未见过的背景、物体和位置上测试时也比两个基线更具鲁棒性。PhysWord 在全部四项真实世界任务上均优于两个基线,在 Pick Paper 上优势最明显。该方法在未见配置中表现出广泛鲁棒性,相比两个基线保持较大的成功率优势。
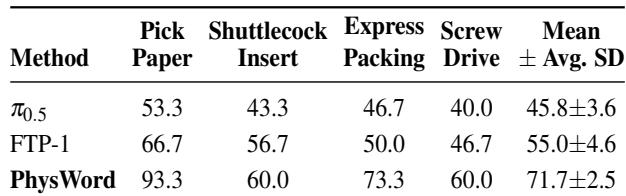
实验评估了 PhysWord 在视觉触觉、长时序和真实世界操作任务上的表现,并与仅视觉、VLA、支持触觉和触觉基础基线对比。PhysWord 实现最强整体成功率,尤其在需要持续运动协调、敏感接触处理、接触丰富的灵巧手操作和长时序夹爪控制的任务上。预测的触觉潜表示保留完整模型的大部分性能,仅视觉物理词仍然有效,表明其对未见背景、物体和位置具有强鲁棒性和泛化能力。