Command Palette
Search for a command to run...
Agent World Model in the Wild:计算机使用智能体环境合成
Agent World Model in the Wild:计算机使用智能体环境合成
摘要
智能体学习正从基于人类数据的学习转向通过与环境交互进行学习。然而,在真实计算机系统中直接扩展此类学习难度较大,并可能带来重大安全风险。为此,我们提出 Agent World Model in the Wild(WildAWM),这是一个可扩展的流水线,用于合成可控环境与任务,以训练通用计算机使用智能体(CUA)。现有方法通常聚焦于单一智能体交互接口;而我们构建的可执行环境同时支持图形用户界面、模型上下文协议服务与命令行界面,使智能体能够灵活结合视觉交互、工具使用和代码执行。WildAWM 完全由开源模型驱动,表明无需专有前沿模型即可生成高质量的计算机使用环境。除环境外,我们还解决任务合成中三个反复出现的挑战:确保可解性、保持足够难度以及生成可靠的验证器;具体做法是引入基于执行的质量门,结合异构智能体 rollout、跨评判一致性检查和对判断鲁棒性的反事实探测。最终流水线合成了 341 个长时程环境-任务对,其中部分任务可能需要超过 100 个智能体步骤才能完成,并且即使对前沿模型仍具挑战性——GPT-6-Astra 仅解决了其中 60%。我们仅在这些合成世界中训练了两个不同规模的 Qwen 模型。两个模型在 8 个分布外基准上均取得了显著提升,这些基准涵盖 Web、Claw 和计算机使用智能体,表明在 WildAWM 所合成世界中的学习能够广泛泛化到未见过的计算机使用任务。代码已公开发布于 https://github.com/MSR-Orchard/WildAWM。
一句话总结
来自北卡罗来纳大学教堂山分校、微软研究院、佐治亚理工学院和东北大学的研究人员提出了 WildAWM,这是一个开源模型流水线,用于合成可控的计算机使用环境,涵盖图形用户界面、模型上下文协议服务和命令行界面,并通过基于执行的质量关卡确保可解性、难度和可靠的验证器;由此产生的 341 个长时程任务可能需要超过 100 个 Agent 步骤,并对前沿模型构成挑战,例如 GPT-6-Astra 仅能解决 60%;而完全在这些合成世界中训练的 Qwen 模型在八个分布外基准上均有提升,涵盖 web、claw 和 computer-use Agent。
核心贡献
- 本文提出了 WildAWM,这是一个可扩展的流水线,用于合成可执行的个人计算机环境,同时支持图形用户界面、模型上下文协议服务和命令行界面,使通用 computer-use Agent 能够结合视觉交互、工具使用和代码执行。该流水线完全由开源模型驱动,生成了 341 个长时程环境-任务对,其中一些任务可能需要超过 100 个 Agent 步骤才能解决。
- 本文提出了用于任务合成的基于执行的质量关卡,通过结合异构 Agent 轨迹、跨评判一致性检查和针对判断稳健性的反事实探测,促进可解性、足够难度和可靠的验证器。生成的任务对前沿模型仍具挑战性,GPT-6-Astra 仅能解决其中 60% 的任务。
- 本文表明,完全在这些合成世界中训练两个不同规模的 Qwen 模型,可在八个分布外基准上带来显著提升,涵盖 web、claw 和 computer-use Agent,证明了对未见 computer-use 任务的广泛泛化能力。代码已公开可用。
引言
大语言模型 Agent 越来越依赖在可执行环境中进行强化学习,这使得可扩展的合成环境成为训练的关键瓶颈。computer-use Agent 必须跨应用程序、网站和本地文件协调 GUI、CLI 和 MCP 交互,但此前的合成流水线通常只针对单一交互模式或孤立的简化应用程序,CUA 相关工作往往集中在 GUI 交互上。现实的计算机使用还需要相互连通的数字工作空间,以及可解、具有足够挑战性、并配有可靠验证器的任务,同时不能假设前沿模型是正确的。作者提出了 WildAWM,这是一个可扩展的、完全开源的流水线,用于构建包含网站、MCP 服务和本地文件的可执行个人计算机环境,然后基于这些世界合成跨 Agent 接口任务。WildAWM 使用基于执行的多 Agent 质量关卡和反事实探测来验证任务的可解性、难度和验证器可靠性。作者合成了 341 个需要至少三种接口类型的环境-任务对,完全在这些合成世界中训练 Qwen 模型,并报告了在全部八个分布外 computer-use 基准上的一致提升。
数据集
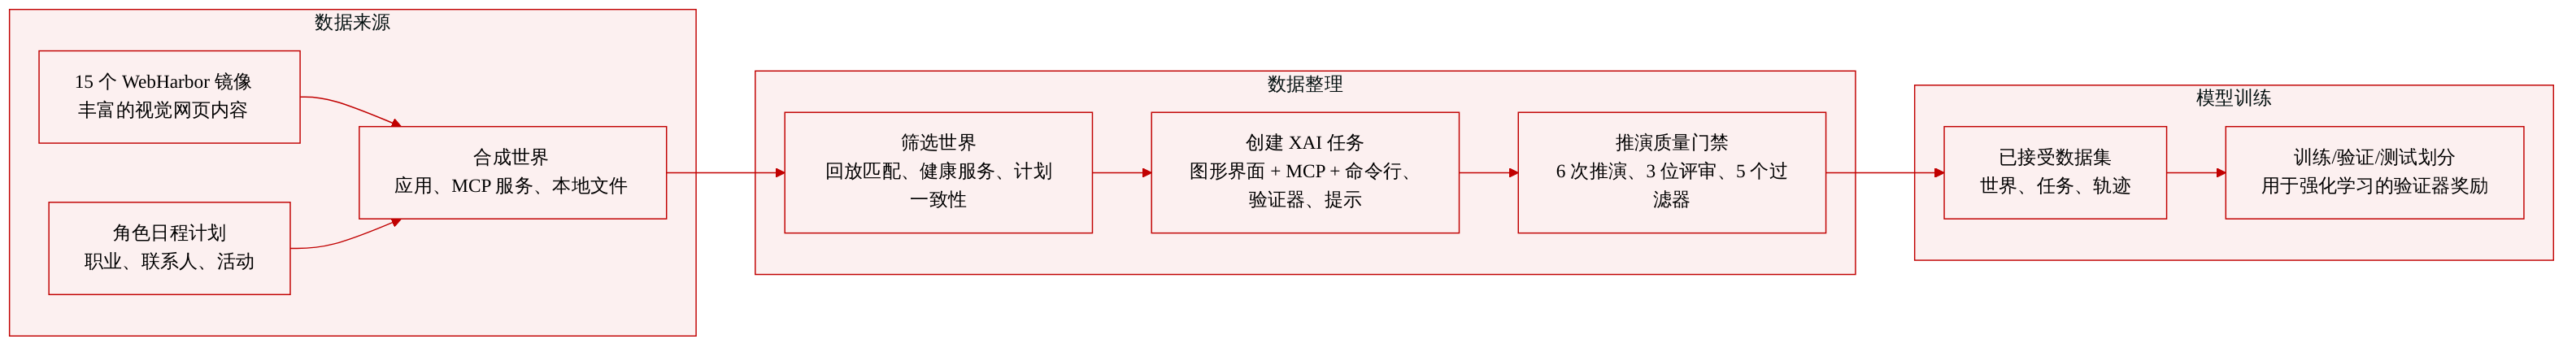
作者构建了一个合成数据集,包含个人计算机世界和基于这些世界的跨接口 Agent 任务。
-
来源与构成
- 基础网页内容来自 WebHarbor 中的 15 个镜像网站,这些网站因其丰富的视觉内容而被选中。
- 一个世界是个人计算机的累积状态:网络应用程序、可通过 MCP 访问的服务,以及记录个人活动的本地文件。
- 作者合成了具有职业、指定联系人、常用网站和多日活动的角色设定,然后将其扩展为按顺序排列的每日计划。
- 编码 Agent 在前一个世界状态的基础上将每个每日计划具体化,创建应用程序、服务、数据库、用户历史和文件。
-
世界构建与过滤
- 每日计划是增量式的:生成器在规划第 d 天之前会检查前一天的状态 W(c,d-1)。
- 生成器将活动与所需服务匹配到共享的事件技能和应用程序实现库中。在需要时,会创建新的技能或 MCP 服务。
- 对于每一天,生成器都会编写一个确定性的、可重放的程序,用于更新 MCP 服务的数据库、网站和本地文件。
- 仅当两次独立重放产生相同状态、服务和网站保持健康、并且独立的 Agent 验证与每日计划的一致性时,某个状态才会被保留。
- 世界工件总结见表 2。
-
任务合成
- 每个 XAI 任务从一个初始世界状态 W0 = W(c,d) 开始,并以该世界的应用程序数据、服务记录和本地文件为基础。
- 任务必须要求全部三种接口类型:GUI、MCP 和 CLI。
- 生成器产出一个任务规格、可执行验证器、评分标准、提示和有序的子任务分解。
- 验证器对初始状态、最终状态和最终答案上的 N 个二元检查清单标准进行评分;任务成功要求所有标准均通过。
-
轨迹与质量控制
- 每个任务收集六个轨迹,其中一半带有提示,来自 18 个模型-执行器组合:GLM-5.2、DeepSeek-V4-Flash 和 MiniMax-M3,分别在 OpenCode、Codex、Claude Code、Nanobot、OpenClaw 和 Hermes Agent 上运行。
- 轨迹判断采用三个级别:生成的验证器、LLM 评判者和基于 OpenCode 的 Agent 评判者。
- 五个关卡对任务进行过滤:评判一致性、初始不满足、任务可解性、任务难度和反事实探测。
- 难度基于无提示轨迹:k ≤ 1 为难,k = 2 为中,k = 3 为过于简单,需返回修订。
-
数据集使用
- 通过的输出包括世界状态、任务规格、提示、评分标准、子任务分解、轨迹、判断和可执行验证器。
- 作者将程序化验证器用作强化学习期间的奖励函数。
- 各个验证器标准为长时程强化学习训练提供细粒度反馈和价值估计。
- 通过的任务平均轨迹成功率为 21.3%,平均有 4.2 个子任务,3.1 次接口切换,74.5% 的任务会回访此前使用过的接口。
方法
作者利用开源模型合成可执行环境和任务,用于训练通用 Computer Use Agent(CUA)。如下图所示,WildAWM 流水线包含三个主要阶段:世界合成、XAI 任务合成和面向 CUA 的在线强化学习。每个合成实例包含一个由世界状态 W 初始化的个人计算机环境、一个任务 τ,以及一个用于评估任务完成情况的验证器 V。
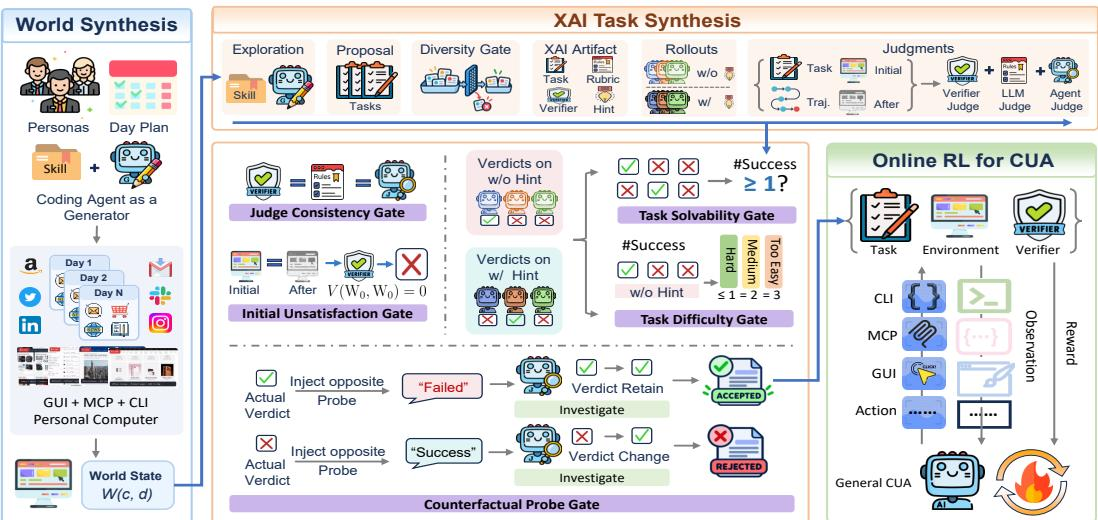
世界合成 为了构建多样且真实的环境,作者将一个世界定义为个人计算机的累积状态,包含网络应用程序、可通过 MCP 访问的服务和本地文件。作者首先合成一个角色设定,并将其持续活动扩展为按顺序排列的每日计划。然后,编码 Agent 逐日具体化这些计划,在前一个状态的基础上扩展,以构建应用程序、服务和用户历史。角色 c 在第 d 天之后的累积状态表示为 W(c,d),用于初始化和重置环境状态。为了促进多样性,生成器会将每个候选角色设定与已接受的角色设定在生活领域和多日故事情节方面进行比较。给定每日计划,生成器将活动与不断增长的可复用事件技能和应用程序实现库进行匹配,在需要时合成新技能或实现缺失的 MCP 服务。仅当两次独立重放产生相同状态且所有服务保持健康时,状态才会被保留。
XAI 任务合成 除了环境合成之外,任务生成还需要应对三个关键挑战:确保可解性、保持足够的难度,以及生成可靠的验证器。作者通过一个基于执行的多 Agent 验证循环来解决这些问题。给定初始世界状态 W0=W(c,d),一个经过技能增强的生成器基于可用的应用程序数据、服务记录和本地文件,提出跨 Agent 接口(XAI)任务。每个任务要求 Agent 使用 GUI、MCP 和 CLI 接口。对于每个提案,生成器产出一个任务规格 τ、一个可执行验证器 V、一个评分标准 R 和一个提示 h。验证器评估预定义的包含 N 个二元标准的检查清单,任务成功被定义为满足所有标准:
V(W0,W,a)=i=1∏Nvi(W0,W,a)其中 vi(W0,W,a)∈{0,1}。
为了验证任务,作者从 18 个模型-执行器组合中为每个任务收集六个轨迹,并应用三个级别的判断:程序化验证器、LLM 评判者和 Agent 评判者。随后,这些轨迹和判断会经过五个质量关卡进行评估,以确定任务有效性。XAI 任务候选者通过这些关卡的进展见下图。
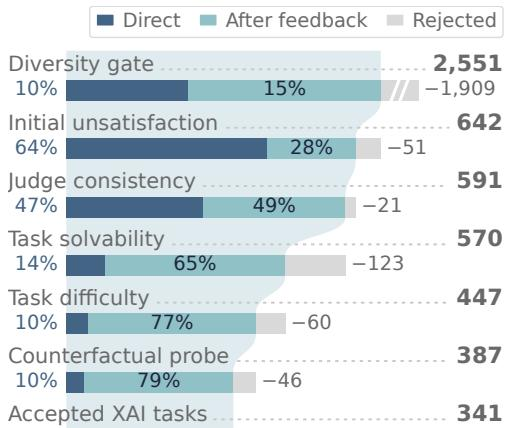
五个质量关卡为:
- 评判一致性:要求程序化验证器、LLM 评判者和 Agent 评判者对所有轨迹的判断一致。不一致会触发修订。
- 初始不满足:要求 V(W0,W0,∅)=0,拒绝那些在初始状态下已经完成的任务。
- 任务可解性:要求至少有一个成功轨迹,且该轨迹使用了每个声明的接口。
- 任务难度:基于无提示的成功轨迹估计经验难度。任务被标记为难、中或过于简单。
- 反事实探测:通过向 Agent 评判者提供一个错误的结果断言,测试其反馈的稳定性,以确保其不易受到迎合倾向的影响。
未通过任一关卡的候选者会连同诊断证据一起返回给生成器进行修订。
通用 CUA 训练 作者在合成世界中使用分组相对策略优化(GRPO)训练通用 CUA,经验证的验证器提供稠密但基于结果的奖励。对于任务 τ 的轨迹 j,令 (Wj,aj) 表示其最终世界状态和答案,令 ej∈{0,1} 表示策略格式失败。当 ej=1 时,奖励设为 rj=−1。当 ej=0 时,奖励与检查清单得分 v 结合:
rj=min{1,V(W0,Wj,aj)+N0.1i=1∑Nvi(W0,Wj,aj)}其中 N 是检查清单标准的数量。成功的任务获得单位奖励,而检查清单得分为不完整的轨迹提供部分得分。为解决小型模型中常见的零方差奖励组问题,作者维护了对所需轨迹乘数的指数移动估计。轨迹优势定义为:
Aj=⎩⎨⎧(rj−μτ)/στ,−K−1/2,0,στ>0,στ=0 and ej=1∀j,otherwise,其中 μτ 和 στ 表示规模为 K 的完整轨迹池中奖励的均值和总体标准差。第二种情况在即使所有轨迹都收到相同格式错误奖励时,也能提供与格式相关的学习信号。
实验
实验在 341 个 WildAWM 合成的 XAI 任务上训练 Qwen3.6-35B-A3B 和 Qwen3.5-4B,并在八个未见的 web、claw 和 computer-use 基准上评估泛化能力。训练在两个模型规模上都带来了提升,覆盖所有基准,较大的模型提升更多,并大幅缩小了与前沿系统的差距。分析表明,合成任务多样、可解、具有挑战性且验证可靠,同时所有合成质量关卡都有贡献,而强化学习在预热启动初始化之后效果最佳,即在从教师轨迹学到的跨接口行为基础上,加入长时程问题求解能力。
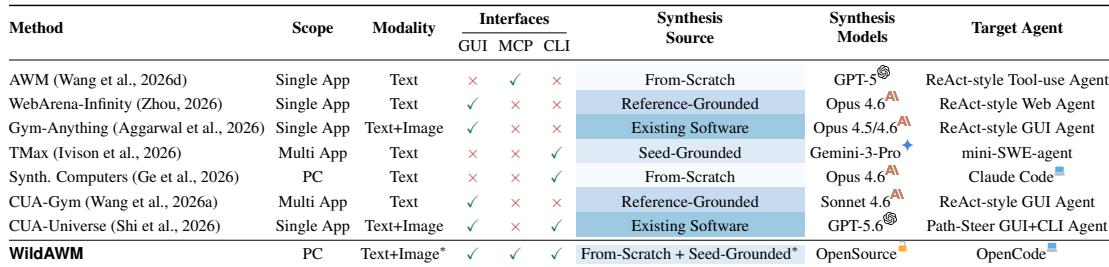
比较涵盖了单应用、多应用和个人计算机范围,以及模态、接口、合成来源、合成模型和目标 Agent 选择。大多数相关方法专注于单一接口,如 GUI、MCP 或 CLI,并依赖专有模型进行合成。WildAWM 的不同之处在于,它在个人计算机世界中统一了 GUI、MCP 和 CLI 访问,并使用开源模型进行合成和验证。相关方法往往针对单一应用程序或接口子集:基于 GUI 的 web 和桌面 Agent、仅支持 MCP 的工具使用 Agent,或仅支持 CLI 的 Agent,而 WildAWM 提供 GUI、MCP 和 CLI 的联合访问。被比较的相关方法使用专有合成模型,而 WildAWM 以开源任务合成和验证著称,将 WebHarbor 的视觉化 web 基础与合成的服务、文件和应用程序数据相结合。
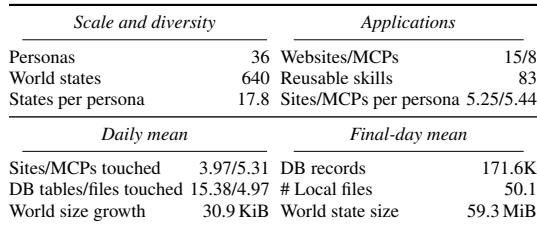
世界合成生成数十个角色设定和数百个跨多个网站与 MCP 服务的累积世界状态,每个角色设定对应多个状态。该流水线复用了一个大型技能库,并通过数据库记录、本地文件以及被触碰的服务或数据库记录每日活动。最后一天的活动比每日平均值涉及更多站点和服务,累积世界状态达到数十 MiB。合成环境涵盖数十个角色设定和数百个累积世界状态。一个大型共享的可复用技能库支持多日和多角色设定生成。最后一天涉及的站点和 MCP 服务数量超过每日均值。生成的世界积累了大量数据库记录和本地文件,最终状态大小达到数十 MiB。
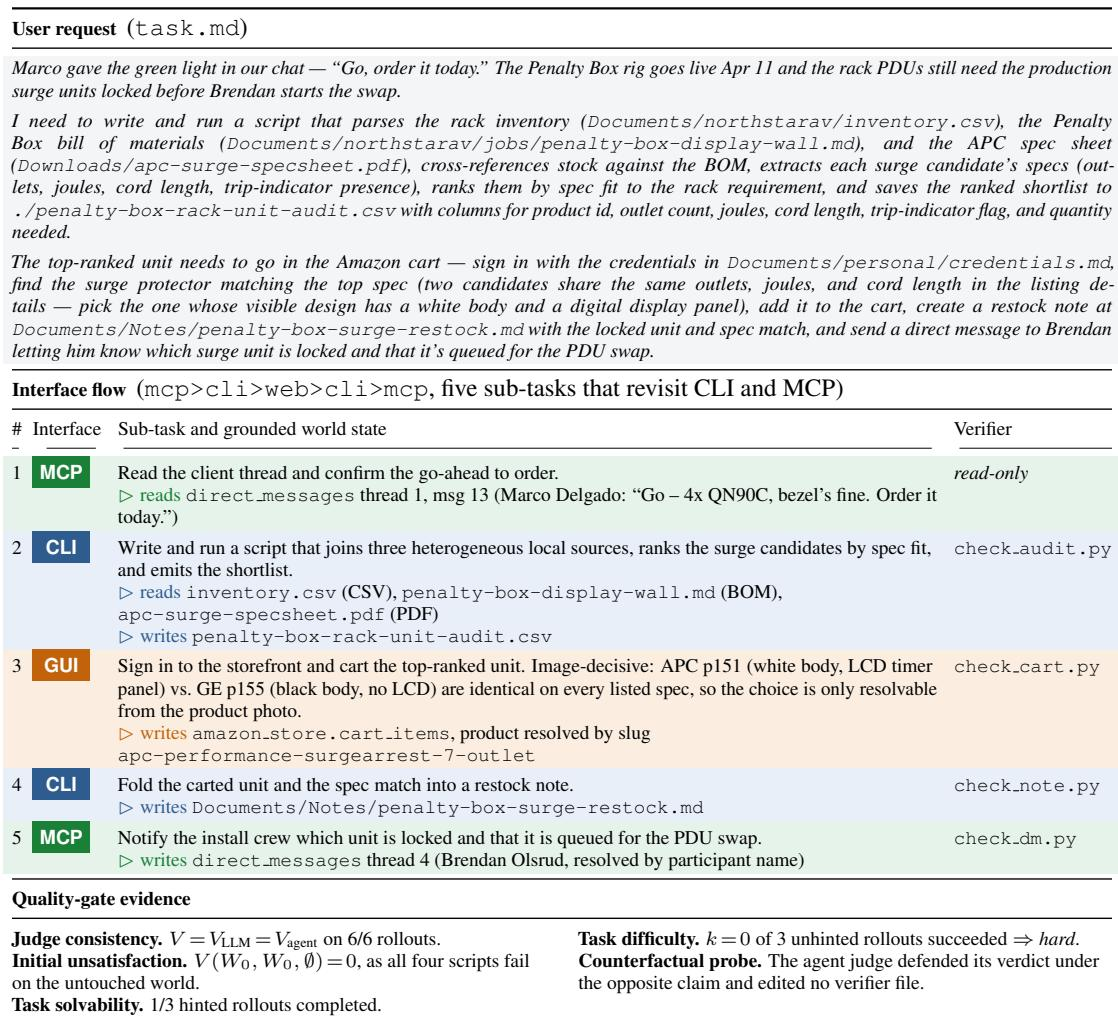
该案例研究展示了一个 XAI 任务,其接口流程依次经过 MCP、CLI 和 web,然后回到 CLI 和 MCP。该解决方案需要读取客户线程,运行 CLI 脚本合并库存、物料清单和规格表数据,通过 web 下单,并写一份补货说明和直接消息。由于流程在 web 步骤之后回访了 CLI 和 MCP,该任务无法在单一接口中完成,而改变世界状态的子任务由确定性验证器脚本检查。该任务跨越 MCP、CLI 和 web/GUI 的多个子任务,其流程会回访 CLI 和 MCP,而不是停留在单一接口中。CLI 子任务合并三个异构本地数据源,根据插座数、焦耳数、线长和跳闸指示器存在情况等规格对候选电涌保护器进行排序,并写出排序后的候选名单。改变世界状态的子任务由确定性验证器脚本检查,任务成功要求所有验证器脚本均通过。
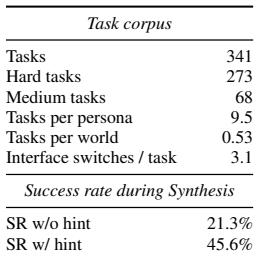
合成的 XAI 任务语料库以困难任务为主,中等任务所占比例小得多,且每个角色设定和世界的任务密度相对较低。任务要求跨接口行为,每个任务平均约有三次接口切换,合成成功率是在多样化的 Agent 配置池中衡量的。在多个质量关卡上通过反馈驱动的修订来提高任务可靠性。在合成语料库中,困难任务的数量远远超过中等任务。生成的任务要求跨接口交互,每个任务平均约有三次接口切换。合成轨迹来自包含 18 个模型和执行器配置的池,并跟踪每个任务在每个关卡上的修订次数。
WildAWM 训练在每个分布外基准上都提升了对两个模型规模的评估结果,涵盖 web、claw 和 computer-use Agent 任务。较大的模型总体提升更多,并缩小了与前沿 Agent 的差距,但前沿模型仍然保持最高的平均分数。35B-A3B 和 4B 模型在全部八个基准上均有提升,较大的模型平均提升约 10.6 分,而较小的模型约为 8.2 分。最大提升集中在 web、claw 和 computer-use 任务上,如 CLE、OSV、WebArena 和 CUG,35B-A3B 的平均分从大约 43 上升到 53,更接近但仍低于前沿表现。
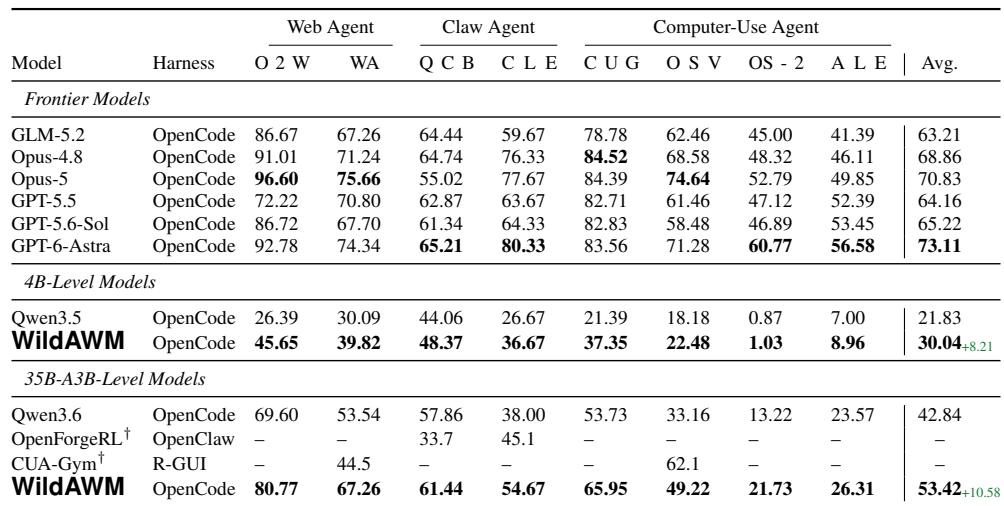
实验在单应用、多应用和个人计算机范围内将 WildAWM 与相关方法进行了比较,并评估了世界合成规模、跨接口任务复杂性、语料库构成和训练收益。WildAWM 与先前方法的不同之处在于,它在个人计算机环境中统一了 GUI、MCP 和 CLI 访问,并使用开源模型进行任务合成和验证。生成的世界包含许多角色设定和累积状态,而 XAI 任务语料库以困难任务为主,需要多次接口切换和确定性验证器检查。在 WildAWM 上训练提升了两个评估模型规模在全部分布外 web、claw 和 computer-use 基准上的表现,较大的模型缩小了与前沿 Agent 的差距。