Command Palette
Search for a command to run...
SpatialScout:VLM 智能体能否主动探索并构建 3D 场景地图?
SpatialScout:VLM 智能体能否主动探索并构建 3D 场景地图?
摘要
空间智能要求智能体主动获取视觉证据,并将观测整合为对三维世界的一致表征。然而,空间问答对于模型能否通过自主探索构建精确的度量地图所提供的证据有限。我们提出 SpatialScout,一个通过主动物体级三维建图来评估视觉语言模型(VLM)智能体的基准。SpatialScout 包含 80 个多样化的室内场景,涵盖 3,140 个目标物体。给定物体清单、RGB 观测以及相机标定与位姿,智能体控制相机探索每个场景,并在统一坐标系中估计物体中心。该任务要求在有限交互预算下持续协调视点选择、跨视图关联、几何估计和地图更新。我们的评估同时衡量定位精度和目标覆盖率,采用对漏检预测进行惩罚的目标级重叠分数。在前沿 VLM 上的实验揭示了显著局限:评估中最强的模型 Claude Opus 5.5 平均重叠度为 41.71%,仅有 47.23% 的目标超过 0.5 的 IoU 阈值,3.25% 超过 0.9。这些结果揭示了恢复粗略物体布局与构建完整、精确的度量地图之间存在巨大差距。SpatialScout 为开发通过主动感知构建可靠三维空间表征的智能体提供了定量测试平台。代码可在 https://github.com/JesseZZZZZ/SpatialScout 获取。
一句话总结
北京大学和天津大学的研究人员提出了 SpatialScout,一个用于评估视觉语言模型(VLM)agent 在 80 个室内场景、3,140 个目标物体上进行主动物体级 3D 建图的基准,其中 agent 控制相机在共享坐标系中估计物体中心,并评估定位精度和目标覆盖率;结果显示,最强评估模型 Claude Opus 5.5 的平均重叠率为 41.71%,其中 47.23% 的目标超过 0.5 的 IoU 阈值,3.25% 超过 0.9,凸显了精确度量建图中的差距。
核心贡献
- SpatialScout 是一个通过主动物体级 3D 建图评估视觉语言模型(VLM)agent 的基准,包含 80 个室内场景、3,140 个目标物体、物体清单、RGB 观测、相机标定和相机位姿。
- 该基准要求 agent 选择视点、跨视图关联观测、在共享坐标系中估计物体中心,并在有限交互预算下修正地图估计;评估使用物体级重叠分数,同时衡量定位精度和目标覆盖率,并惩罚缺失预测。
- 在使用前沿视觉语言模型的实验中,最强评估模型 Claude Opus 5.5 的平均重叠率为 41.71%,其中 47.23% 的目标超过 0.5 的 IoU 阈值,3.25% 超过 0.9;代码见 https://github.com/JesseZZZZZ/SpatialScout。
引言
空间智能对于具身 agent 至关重要,它们必须主动观察三维场景、解决遮挡和视角歧义,并构建一致的度量空间表示。此前的空间基准主要依赖基于图像和视频的问答,有限答案选项可能带来猜测或语言先验捷径,而即使是主动交互基准也仍然停留在问答或离散认知地图,而非对连续三维重建进行评分。作者提出了 SpatialScout,一个通过主动物体级三维建图评估视觉语言 agent 的基准:agent 从初始视图和目标清单出发,选择后续视点,在公共坐标系中更新物体中心估计,并在定位精度、目标覆盖率和最终地图质量上得分。SpatialScout 包含 80 个室内场景和 3,140 个目标,初步评估表明前沿 VLM 能恢复部分场景布局,但在全面覆盖和精确度量定位方面仍存在困难。
数据集
来源与组成 作者表示,SpatialScout 汇集了 80 个通过 ManiSkill3 由 SAPIEN 渲染的室内场景。报告的来源混合为 32 个 iTHOR、12 个 RoboTHOR、10 个 ArchitecTHOR、6 个 Replica-CAD 和 30 个 ProcTHOR 场景。每个源场景出现一次,并保留源布局和目标摆放。
规模与统计 该基准包含 3,410 个目标实例。各场景贡献 30 到 40 个目标:12 个场景有 35 个目标,68 个场景有 40 个目标。目标区域半径范围为 1.95 m 到 9.23 m。在整个目录中,1,489 个目标(43.3%)属于同一场景中具有多个实例的等价组,这增加了关联难度。
清单与标注 每个场景包含一个公开清单 E = {(i, c_i, g_i)},用于 N 个目标,其中 i 是实例标识符,c_i 是类别,g_i 是等价组。在一个 episode 中,agent 为已提交的标识符维护中心估计。评估在每个等价组内比较预测中心。每个目标中心被定义为其渲染几何体的紧凑世界轴对齐包围盒的中点。对于关节物体,包围盒包围已渲染链接几何体的并集。参考中心随后被变换到任务坐标系。
坐标系与输入 任务使用固定的右手坐标系,原点位于初始相机,+x 沿初始光轴向前方向,+y 指向初始左侧,+z 指向初始上方。agent 接收 RGB 图像、清单、相机内参、相机位姿以及目标区域半径 r = max_i ||p_i||_2。参考中心、包围盒和资产几何体保留在评估器中。
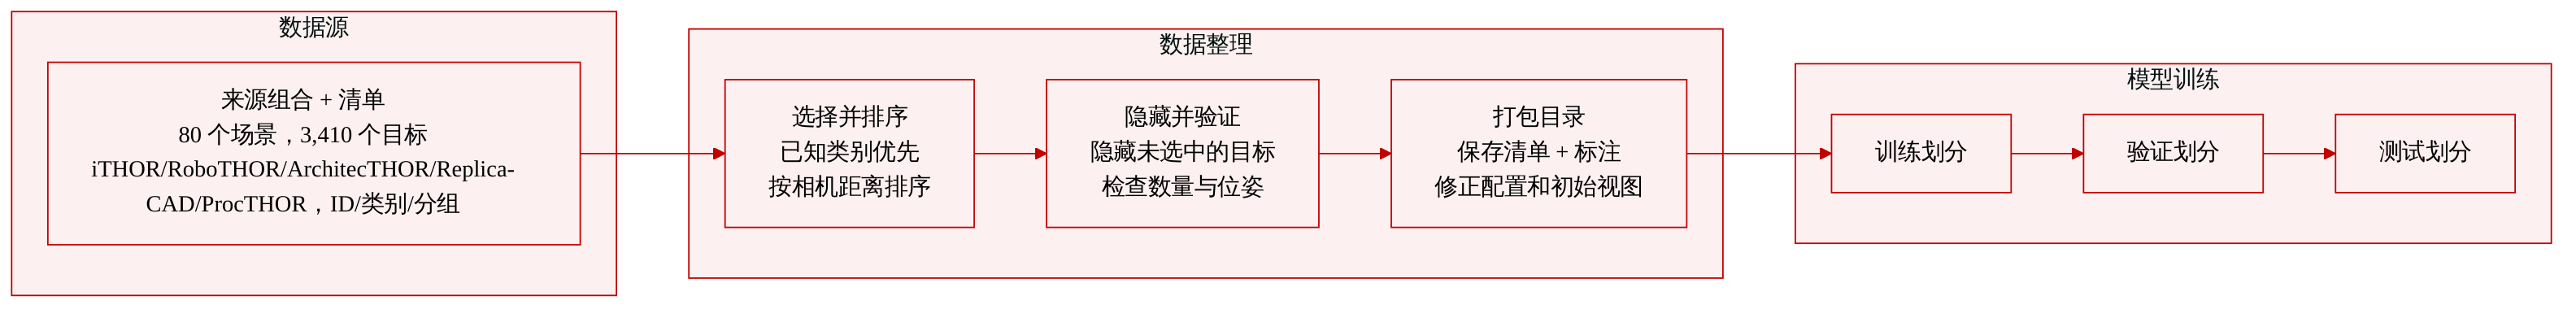
选择与处理 目标选择优先考虑具有已知语义类别的候选对象,然后按它们到初始相机的距离排序,使用标识符顺序打破平局。这样可以把可识别目标集中在探索原点附近。候选对象必须具有渲染几何体,每个场景必须提供所要求的目标数量。未选择的候选对象在渲染观测中被隐藏。每个目录条目固定源配置、初始位姿和目标数量。作者保存清单、几何标注和初始视图,并验证相机位姿轴与投影矩阵之间的一致性。加载的对象数量与源配置数量核对,并计入场景构建器排除项。
使用方式 SpatialScout 评估 VLM agent 的主动物体中心建图能力。给定物体清单和经过标定的相机位姿,agent 选择 RGB 视图,跨观测关联物体,并维护物体中心的三维地图。该基准通过物体级评估衡量地图准确性和完整性。
方法
作者设计了 SpatialScout,用于评估视觉语言模型(VLM)agent 的主动物体中心建图能力。该框架以交互式流水线运行,agent 获得物体清单和经过标定的相机位姿,用于选择 RGB 视图、跨观测关联物体,并维护物体中心的三维地图。
如下图所示:
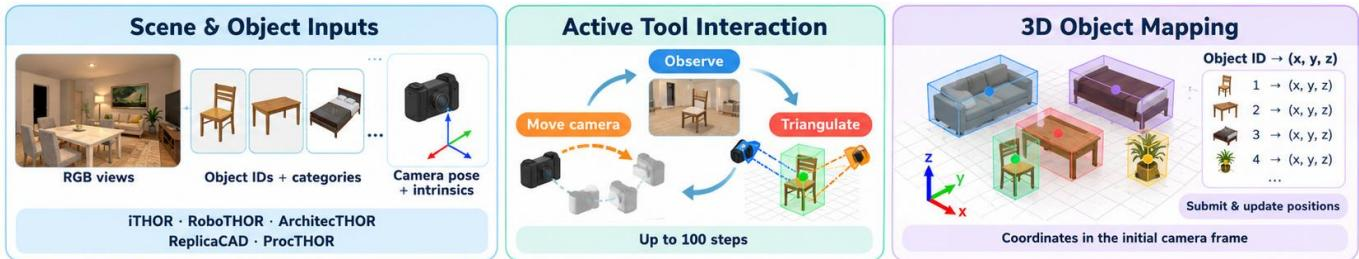
整体架构分为三个主要模块。第一,场景与物体输入模块使用来自 iTHOR、RoboTHOR、ArchitecTHOR、ReplicaCAD 和 ProcTHOR 等平台的固定场景目录初始化环境。agent 接收初始 RGB 视图、带对应类别的物体标识符,以及相机位姿和内参。
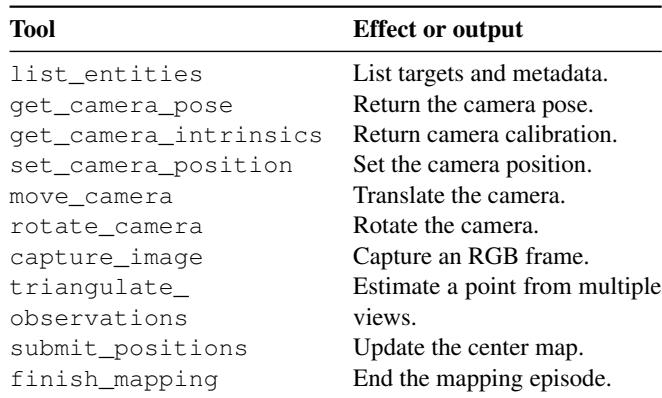
第二,主动工具交互模块使 VLM agent 能够在三维空间中导航。通过共享交互接口,agent 最多可使用一套工具进行 100 步。它通过沿当前水平前向和右向以及世界垂直轴施加相对平移来控制相机移动。agent 通过显式捕获获取新观测,渲染 512x512 RGB 图像,并应用三角测量来估计相机与物体之间的空间关系。
最后,三维物体建图模块处理空间推理和输出生成。agent 跨多个视图关联观测到的物体,并维护其中心地图。它提交或修正已识别物体的位置,将每个物体标识符映射到初始相机坐标系中定义的特定 (x, y, z) 坐标。每次被接受的提交都会替换该标识符之前的位置估计。为确保几何有效性,验证器检查标识符和有限坐标,并施加公开边界约束,表示为 ∥pi∥2≤r+0.5m。
实验
该基准在 80 个室内场景和数千个目标上评估空间建图,七个多模态 agent 在固定交互预算下使用共享的相机移动、清单和三角测量接口。实验验证,成功建图需要多视图几何对齐、增量提交和修正以及一致观测,而失败通常源于覆盖不完整或错误对应,仅靠低三角测量残差无法发现这些问题。总体而言,Claude Opus 5.5 实现了最强的定位和完整性,但推理成本最高,测试的开源模型在精度-成本优势方面表现有限。
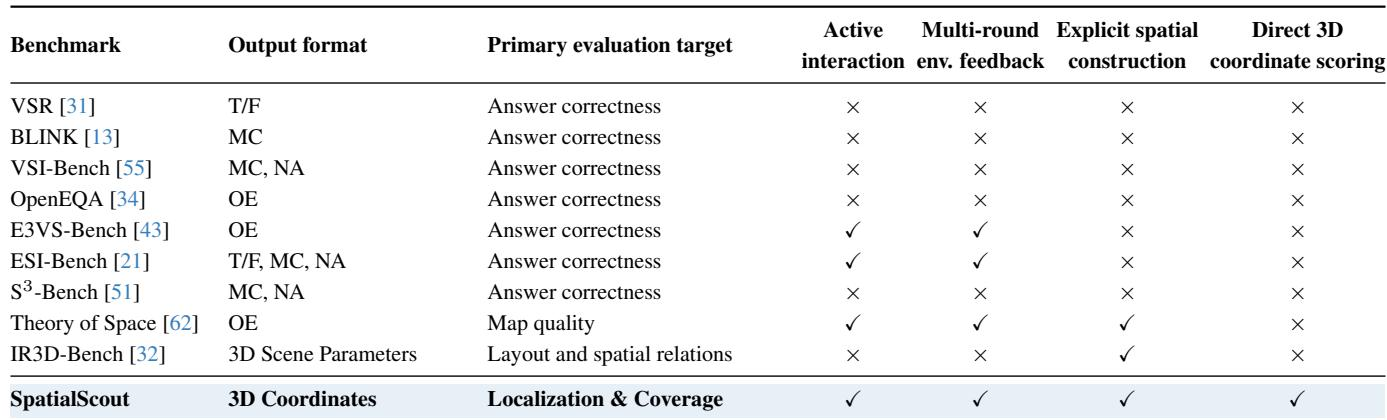
所列举的空间智能和场景理解基准主要评估最终答案的正确性,输出格式涵盖真/假、多项选择、数值和开放式回答。只有少数基准包含主动交互或多轮环境反馈,且没有一个包含显式空间构建或直接三维坐标评分。该比较凸显了在评估模型如何主动感知、探索和表示三维场景方面的空白。所有被调查的基准都针对答案正确性,输出格式在真/假、多项选择、数值和开放式任务中各不相同。只有少数基准包含主动交互和多轮环境反馈。没有任何被调查的基准包含显式空间构建或直接三维坐标评分。
共享评估接口为所有 agent 提供一组通用的相机、捕获和目标列表工具,同时有意隐藏真实目标位置和评估分数。agent 可以提交或修正物体中心并查看当前已接受的地图,但提交只会根据公开约束进行验证,例如有限坐标和距离边界。这种设计将任务转向多视图几何对齐和基于工具的三角测量,有效感知和对应质量比捕获的视图数量更重要。所有 agent 使用相同的工具接口,因此没有任何模型获得特权性的真实位置或评估分数。轨迹分析表明,捕获更多图像并不足够;更强的定位与可靠的多视图三角测量和增量修正有关。
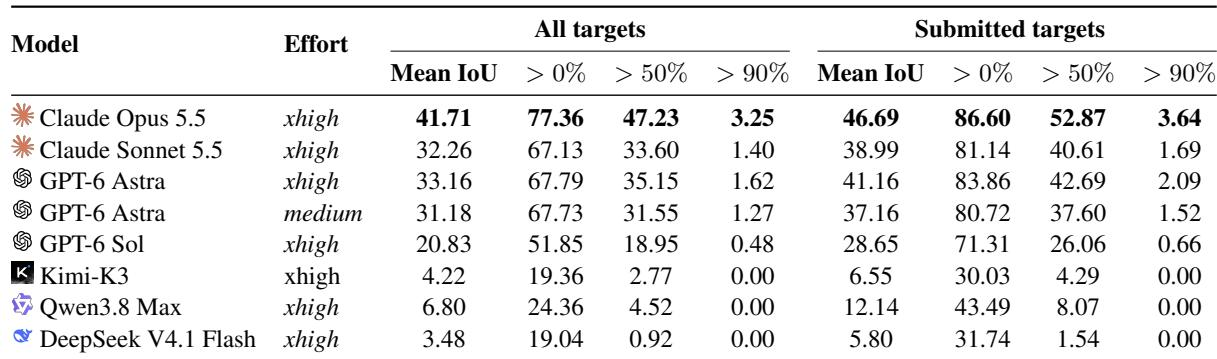
在 80 个场景的定位比较中,Claude Opus 5.5 在所有目标和已提交物体平均 IoU 上均达到最高,其次是 Claude Sonnet 5.5 和 GPT-6 Astra。每个模型的精度仍然有限:超过 90% IoU 的严格重叠很少见,且所有目标得分低于已提交物体得分,表明遗漏物体会降低整体建图性能。Claude Opus 5.5 在所有目标和已提交物体平均 IoU 上均明显领先 GPT-6 Astra。对所有模型来说,超过 90% IoU 的严格高重叠匹配都不常见,说明精确中心对齐仍然困难。已提交物体与所有目标 IoU 之间的差距凸显了物体遗漏如何降低整体建图得分。GPT-6 Sol 和 Kimi-K3 大幅落后,Kimi-K3 几乎没有严格高重叠匹配。
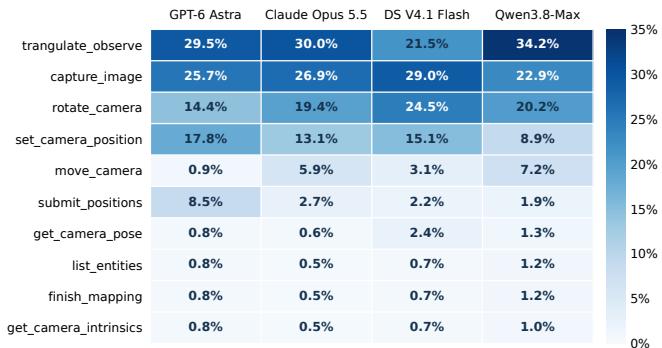
工具使用分布显示四个模型具有不同的探索策略。Claude Opus 5.5 将大部分工具调用用于观测和相机调整,提交占比较低;GPT-6 Astra 更频繁地提交位置,且较少移动相机。DeepSeek 和 Qwen 将更多工具调用用于图像捕获或观测,但提交位置频率较低,表明建图行为效率较低。GPT-6 Astra 的 submit_positions 调用占比最高,move_camera 调用占比最低,这与使用更少工具调用实现竞争性建图一致。Claude Opus 5.5、DeepSeek V4.1 Flash 和 Qwen3.8-Max 将更大比例用于观测、图像捕获或相机旋转,而提交位置的频率低于 GPT-6 Astra。
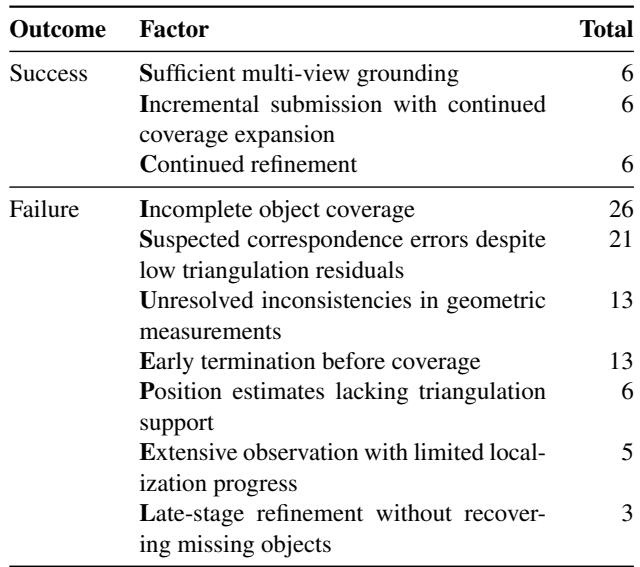
在分析的轨迹中,成功与反复的多视图几何对齐、扩展物体覆盖范围的增量提交以及随后对已提交位置的修正有关。失败模式更加多样,覆盖不完整是最常见的情况,其次是三角测量残差很低但位置不准确以及未解决的几何不一致。所有六条成功轨迹都具备足够的多视图对齐、扩大覆盖范围的增量提交和持续修正。在失败轨迹中,覆盖不完整是最常见的失败模式。许多失败轨迹尽管三角测量残差很低,仍保留了不准确的位置,这表明问题是物体对应或物体中心选择错误,而不是几何约束较弱。
实验首先调查了空间智能基准,发现它们主要评估最终答案正确性,很少包含交互式感知或显式三维构建。随后使用共享评估接口测试模型驱动的定位与建图,结果表明可靠的多视图三角测量和增量修正比捕获更多图像更重要。模型比较表明 Claude Opus 5.5 表现最佳,但精确对齐对所有系统仍然困难;工具使用模式表明,观测和相机调整以及选择性提交能带来更有效的探索。轨迹分析证实,成功依赖于反复的几何对齐和不断扩大物体覆盖范围,而常见失败涉及覆盖不完整或尽管三角测量残差较低但中心选择不准确。