Command Palette
Search for a command to run...
自进化智能体是持续学习者吗?
自进化智能体是持续学习者吗?
Xiaoyin Chen Yizheng Huang Yinglun Xu Ziyun Zhao Emmett McQuinn Julie Liu Hope Yao
摘要
大语言模型智能体常被部署到不断出现新知识、新工具和新工作流程的环境中。这类智能体因而需要持续适应:随着新任务到来学习新任务,同时不遗忘先前任务。这类似于持续学习问题,但其发生速度往往超过传统梯度更新所能承受的限度。非参数化自进化智能体是一种自然的替代方案:它们通过根据任务反馈重写自身运行框架(如提示词、记忆和技能)来适应,同时保持模型权重冻结。我们研究这类智能体在四个漂移任务流上是否是有效的持续学习者,这些任务流会在主题、工作流程或领域上发生变化(基于 BIRD、BFCL 和 ScienceWorld 构建)。我们评估了三种涵盖经验检索与自我修改的代表性方法(ReasoningBank、GEPA 和 Meta-Harness),发现尽管自进化在大多数任务流上提升了总体性能,但更高的可塑性始终以稳定性为代价。具体而言,自我修改方法会对共享提示词或工作区施加全局编辑,在任务流变化时干扰未见任务并覆盖早期知识。相反,基于相似度的记忆检索能够在相距较远的领域间实现更新的局部化,但在未见任务上仍会检索到外来记忆,并且当相似查询需要相互冲突的工作流程时会出现检索冲突。这些发现表明,当前的自进化智能体仍是不完全的持续学习者。
一句话总结
Mila、Université de Montréal 和 Google DeepMind 在基于 BIRD、BFCL 和 ScienceWorld 构建的四个漂移任务流上评估 ReasoningBank、GEPA 和 Meta-Harness,以研究自进化 LLM agent 是否为有效的持续学习者,发现全局自修改提高了可塑性但损害稳定性,而基于相似度的记忆检索在主题、工作流和领域不断切换时会出现检索冲突。
核心贡献
-
该论文将非参数化自进化 LLM agent 视为持续学习者,即保持模型权重冻结,仅根据任务反馈更新 harness 组件,例如提示词、记忆和技能。
-
该工作形式化了顺序任务流上的 harness 适配,并使用策略序列目标以及调整后的可塑性与稳定性指标,比较 ReasoningBank、GEPA 和 Meta-Harness 等经验检索与自修改方法。
-
在基于 BIRD、BFCL 和 ScienceWorld 构建的四个漂移任务流上的实验表明,这些方法在大多数设置下相比种子 harness 提升了总体表现,同时也暴露出可塑性与稳定性之间的权衡,具体表现为全局提示词编辑带来的干扰、早期知识被覆盖、外部记忆注入以及检索冲突。
引言
大型语言模型 agent 越来越多地用于操作软件工具、编写代码、查询数据库以及在仿真环境中行动。这一点很重要,因为现实世界部署通常会在模型权重冻结之后出现新任务、新工具和新工作流,因此 agent 需要在部署期间持续学习,同时不遗忘早期技能。作者采用非参数化自进化 agent,这类 agent 保持模型权重冻结,转而更新 agent harness,包括提示词、记忆、技能和控制代码。
已有工作表明,自进化可以在单任务或单领域基准上提升 agent 性能。然而,这种方法是否能支持跨异构任务流的持续学习仍不清楚。共享 harness 可能偏向近期出现的情况或任务特定捷径,针对某一任务的更新也可能干扰后续任务。现有评估也未直接测试主题漂移、工作流漂移、领域漂移以及组合漂移下的持续学习。
主要贡献是一个评估框架,用于将自进化 LLM agent 作为持续学习者进行评估。作者形式化了基于经验更新 harness 的 evolver,基于 BIRD、BFCL 和 ScienceWorld 构建了四个漂移任务流,并测试了 ReasoningBank、GEPA 和 Meta-Harness。研究发现,现有方法面临可塑性与稳定性之间的权衡:共享自修改可能引发跨任务干扰,而基于相似度的检索并不能完全阻止外部记忆注入或检索冲突。
数据集
-
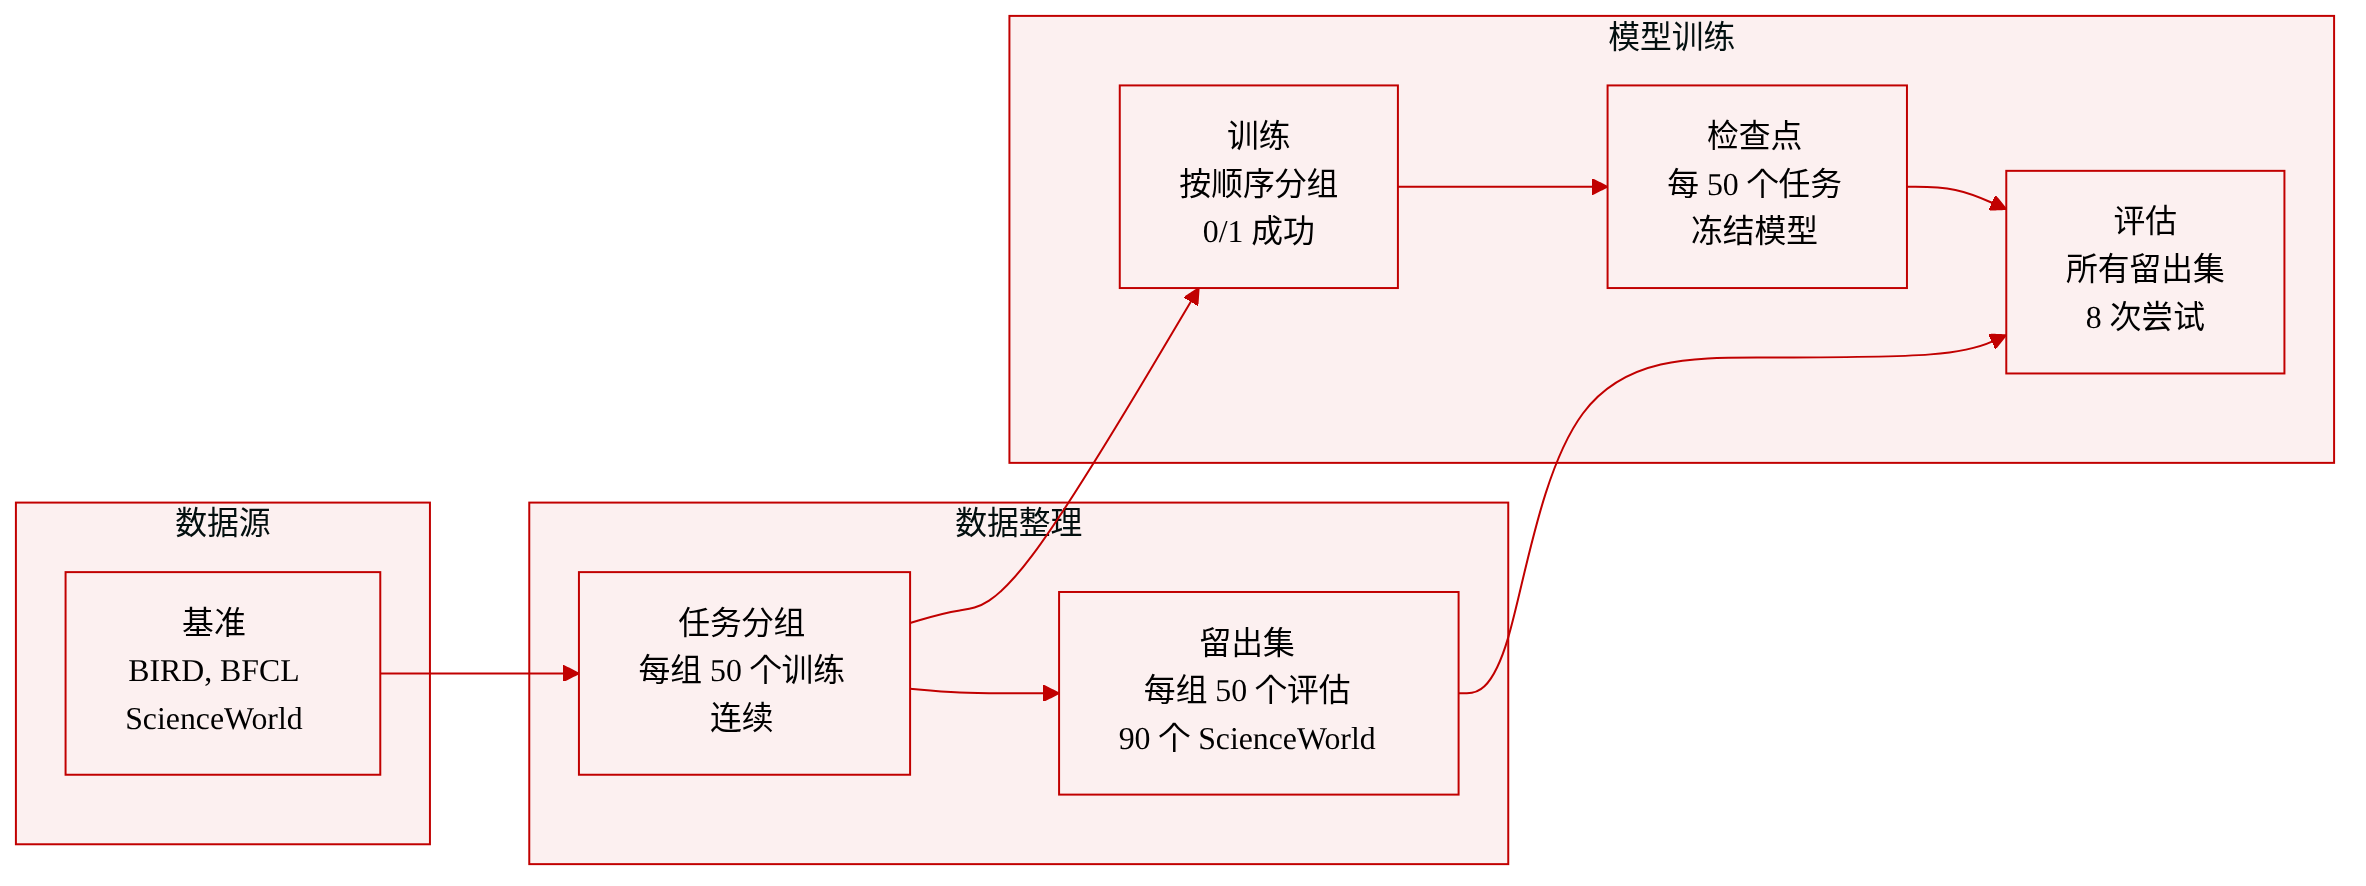
作者基于三个 agent 基准构建任务流:BIRD 用于关系数据库上的 text-to-SQL 查询,BFCL 用于通过调用有状态 API 服务多轮用户请求,ScienceWorld 用于文本环境中的交互式科学实验。
-
每个任务流按组组织为连续区块,每组包含 50 个训练任务。训练后,每组在一个与之不相交、包含 50 个任务的留出集上评估;ScienceWorld 除外,它使用包含 90 个任务的留出集。
-
对于主题漂移,作者依次使用三个 BIRD 数据库组:基于 formula_1 数据库的 BIRD-F1、基于 codebase_community 的 BIRD-Code,以及基于 thrombosis_prediction 的 BIRD-TP。text-to-SQL 任务保持不变,但每个数据库都引入不同的 schema 和本地约定。
-
对于工作流漂移,作者使用 BFCL-Miss,随后使用 BFCL-Base。两组共享相同 API 环境,但 BFCL-Miss 要求 agent 对缺失参数进行澄清,而 BFCL-Base 提供完整参数,并会对不必要的澄清进行惩罚。
-
对于领域漂移,作者依次使用 ScienceWorld、BFCL-Base 和 BIRD-F1。该任务流在交互式科学实验、多轮工具调用和数据库查询之间切换,环境、观察空间和动作空间随之改变。
-
对于复合漂移,作者在更长的序列中组合多种变化类型:BIRD-Code、BIRD-F1、BFCL-Miss 和 BFCL-Base。这会同时测试跨领域转换和领域内变化,包括主题、领域和工作流变化。
-
该论文将数据用作在线任务流,而不是标准训练-验证-测试划分。agent 按顺序在每组上训练,每个训练任务后接收二元任务成功反馈,并在该任务流中每一组对应的不相交留出集上进行评估。
-
评估检查点每 50 个任务流位置出现一次。在每个检查点,冻结系统会在全部 K 个组的留出集上评估,并且每个实例每次评估平均 8 次 rollout。
-
数据集构建主要依赖分组、顺序排列和不相交留出集构造。除基准选择、任务区块形成、组专属留出集分配和任务流顺序排列外,论文未描述额外的过滤、裁剪或元数据处理步骤。
方法
作者围绕两个相互作用的组件组织方法论:evolver f 和任务流权重调度 w。evolver 代表所研究的自适应机制,而权重调度决定在衡量表现时如何对任务流加权。这些组件共同定义了系统的评估目标。
关键评估准则是 evolver 相对于种子 harness 的提升。作者并非孤立地评估 evolver,而是衡量其相对于 baseline harness 能在多大程度上提升加权任务流目标 Jˉw(f)。这一设计强调 evolver 与任务分布加权之间的交互,从而通过其对加权性能目标的实际效果来评判方法。
实验
实验从 text-to-SQL、API 调用和科学环境基准实例化 task-free 漂移流,并在主题、工作流、领域和复合漂移的检查点间隔评估处于冻结状态的自进化 harness,以衡量自进化方法是否在平衡可塑性与稳定性的同时提升性能。各方法中,自进化通常带来净收益,但在活跃任务上更高的可塑性始终伴随更大的跨任务干扰和遗忘,尤其当更新覆盖共享提示词或工作空间时。当领域分隔清晰时,基于检索的记忆提升稳定性,但仅凭相似度无法区分冲突工作流或高度相关任务,导致任务块前干扰和任务块后位移。整体上,在持续漂移下,当前自进化 agent 难以在不擦除或错误应用既有能力的情况下整合新能力。
在各漂移流中,自进化方法通常提升最终性能和平均性能,在工作流、领域和复合漂移上提升最明显。主题漂移是例外,所测试方法产生接近零或略负的净变化。结果显示,在活跃任务块上更强的学习通常伴随对早期任务的更弱保持。GEPA 在活跃任务块上取得最强提升,但也造成最大的跨任务块损失,因为其更新会重写共享提示词。在领域可分离时,ReasoningBank 通过局部化检索避免任务块后遗忘,但仍会因注入外部记忆而导致任务块前干扰。在四种漂移场景中,更高的任务块内可塑性始终对应更低的跨任务块稳定性。
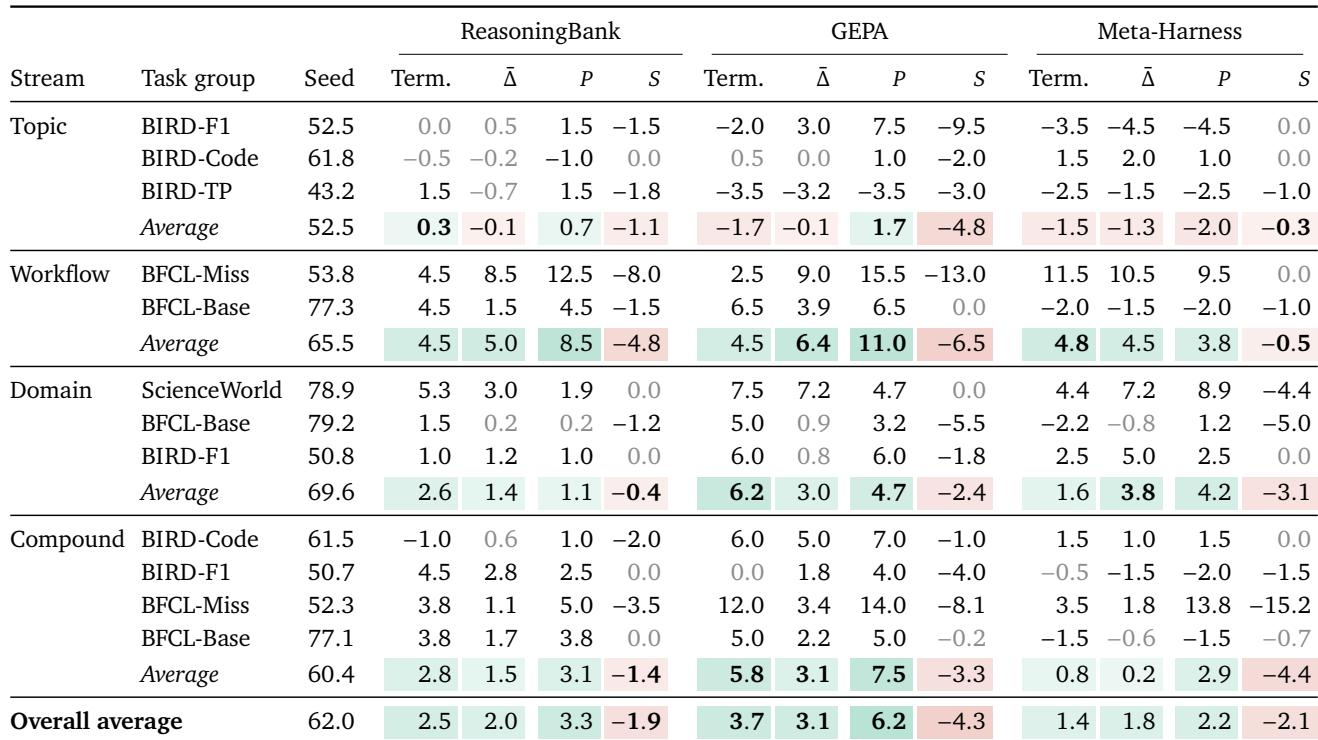
实验比较了多个漂移流下的自进化方法,结果表明它们通常提升最终和平均性能,在工作流、领域和复合漂移下尤为明显,而主题漂移带来很少收益或负收益。实验还揭示了可塑性与稳定性之间的权衡:任务块内可塑性更高的方法(如 GEPA)能更好地学习活跃任务,但因共享提示词重写而承受更大的跨任务块损失;ReasoningBank 通过局部化检索减少任务块后遗忘,却会引入任务块前干扰。总体而言,结果说明,对当前任务的更强适应往往以保留早期任务能力为代价。