Command Palette
Search for a command to run...
Épi: Towards a Persistent, Self-Improving Agent for Autonomous Research
Épi: Towards a Persistent, Self-Improving Agent for Autonomous Research
摘要
We present Épi, an autonomous research agent that sustains investigations across model sessions and evolves its methods through accumulated experience. Épi combines persistent research history, hierarchical memory, branching and independent review to maintain research continuity, learn from experiments, and explore and revisit alternative approaches. Its experiments run across session boundaries, and a fixed verifier evaluates their outputs. Épi produced 120 record-setting results, comprising 20 numerical bound records across 12 families and 100 construction records across eight families. These include an approximately 84-fold narrower interval for the n-queens constant and a more than 3.6-million-fold narrower rigorous interval for the quartic Feigenbaum attractor dimension. Exact dual certificates establish that the Cohn–Elkies linear-programming bound cannot be sharp in dimensions 10 and 11. Beyond numerical improvements, Épi gives a computer-assisted proof of Tuza’s conjecture for split graphs with an eight-vertex clique part and at most three triangle-active neighborhood types, with arbitrary multiplicities. We extend this research process to algorithmic coding with Épi-turbo, a lightweight configuration that develops executable solvers for tasks including vehicle routing, scheduling and production planning. On 30 FrontierOR tasks, Épi-turbo achieves a 5.4% higher total benchmark score than Codex at 64% of its model cost, using the same underlying model and reasoning efort. Épi is designed to support human understanding by connecting computational results to explicit methods and mathematical arguments that researchers can examine and build upon.
一句话总结
作者提出 Épi,一种持久化、可自我改进的自主研究 agent,它通过研究历史、分层记忆、分支、独立审阅、跨会话实验和固定验证器,使研究能够跨模型会话持续推进,产生了 120 项创纪录结果,其中包括 20 项数值界限记录和 100 项构造记录,此外还给出了分割图情形下 Tuza 猜想的计算机辅助证明;同时,其 Épi-turbo 配置开发了可执行求解器,在相同的底层模型和推理强度下,30 个 FrontierOR 任务上的总基准得分比 Codex 高 5.4%,模型成本仅为 Codex 的 64%。
核心贡献
- Épi 被提出为一种自主研究 agent,它通过结合持久化研究历史、分层记忆、分支、独立审阅和固定验证器,使研究能够跨模型会话持续推进,并从实验中学习、重新尝试替代方法。
- Épi 产生了 120 项创纪录结果,包括将 n 皇后常数的区间宽度缩小到约 84 倍更窄,以及将四次方 Feigenbaum 吸引子维数的严格区间缩小到超过 360 万倍更窄。Épi 还提供了精确对偶证书,表明 Cohn-Elkies 线性规划界限在第 10 维和第 11 维中无法达到锐界,并给出了分割图情形下 Tuza 猜想的计算机辅助证明,其中团部分具有 8 个顶点,且三角形活跃邻域类型最多为 3 种。
- Épi-turbo 将这一研究流程扩展到算法编码,为车辆路径、调度和生产规划开发可执行求解器。在 30 个 FrontierOR 任务上,在相同底层模型和推理强度下,Épi-turbo 的总基准得分比 Codex 高 5.4%,模型成本为 Codex 的 64%。
引言
自主研究 agent 在那些进展依赖大量实验、程序生成和可执行检查的工作流中具有重要意义,尤其是在数学发现和算法优化领域。早期系统表明,LLMs 可以提出代码并进行评估,但当研究必须跨会话继续、把结果转化为可复用经验,并在不丢失证明某选择成功或失败证据的情况下探索替代方法时,它们可能会遇到困难。作者提出 Épi,一种持久化自主研究 agent,它使用分层记忆、版本化分支、独立审阅和固定验证协议,来维持并完善长时间运行的研究。
方法
作者提出 Épi,一个旨在开展可验证研究并通过累积经验改进其方法的自主研究系统。整体架构协调一个连续研究循环,其中 agent 探索替代表述、执行持久化实验,并向冻结评估环境提交候选解。
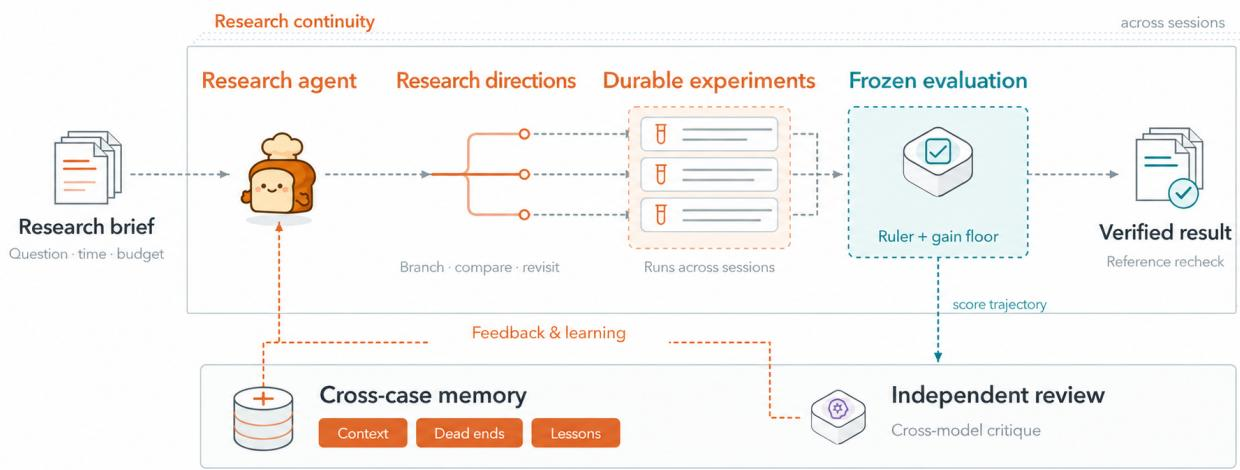
如框架图所示,流程从一个包含问题、时间预算和约束的研究简报开始。研究 agent 在版本化分支上开发方法,使其能够分支、比较并重新尝试不同方法。这些持久化实验跨会话运行,并馈入一个冻结评估模块。该模块应用严格标尺和增益下限来产生经过验证的结果,随后对结果进行参考重检。系统包含由跨案例记忆和独立审阅模型驱动的反馈学习循环。
为确保有效性检查一致,作者建立了一个固定评估规则,称为标尺。对于最小化问题,验证器的可行性判定记为 V(x)∈{0,1},目标函数记为 f(x),参考值记为 b。改进量定义为 Δ(x)=b−f(x)。系统指定一个正增益下限 δ>0,表示最小的有意义改进。候选解在同时满足可行性和增益阈值时被接受:
V(x)=1,Δ(x)≥δ.对于最大化任务,改进量定义为 Δ(x)=f(x)−b。这一严格评估框架确保每个分支都在共同规则下比较,从而为整个研究过程中的方法比较提供一致基础。
研究 agent 通过三个核心机制改进其方法:分支、分层记忆和独立审阅。首先,系统维护版本化分支,在保留每种方法代码和证据的同时开发替代方案。agent 可以通过返回已保存的实现并尝试不同后续来回溯,也可以在记录放弃原因后放弃某个分支,以便后续检查。
其次,Épi 利用分层记忆结构来积累并复用研究经验。短期记忆支持当前研究,长期记忆保留用于后续研究的经验。跨案例记忆存储保留研究上下文、记录可复用发现的教训,以及记录无效方法的死路。在会话边界,agent 记录其发现并生成交接说明。后续会话检索这些相关记忆记录,以指导下一次实验,而无需重放早期会话的全部历史。
第三,为缓解开发 agent 的视角局限,系统采用独立审阅模型。该独立模型评估得分轨迹、尝试的方法、检索到的发现和资源使用。审阅者评估 agent 对进展的解读是否合理,以及得分提升是否反映目标任务,而不是奖励黑客行为。隔离验证器在固定标尺下检查候选解的有效性和增益,而审阅者评估总体研究方向。
执行基础设施 Breadboard 通过提供隔离实验环境并支持跨模型会话的长时运行任务来支撑这些流程。它存储研究历史,包括代码、分支状态和实验输出,并运行固定验证器。对于快速、低成本的算法设计任务,作者提出 Épi-turbo,一种轻量配置,该配置以连续会话运行活动,严格控制模型调用预算,并在额外会话无法改进最佳已验证得分时停止活动。
实验
实验使用前沿语言模型并在有界预算下进行,将最终产物与文献或注册表基线进行比较,覆盖数学和优化任务。结果显示,在几何包装、数值界限和专门构造方面存在广泛的创纪录活动,案例研究则验证了改进的包装、Cohn-Elkies 方法的结构性限制、收紧的常数以及经过认证的优化界限。在 FrontierOR 协议上,Épi-turbo 通常产生了在解质量和运行时间之间取得平衡的算法,同时使用比 coding-agent 基线更少的算力。总体评估支持将 Épi 视为实用研究工具,用于构造经过验证的数学产物并设计高效独立求解器。
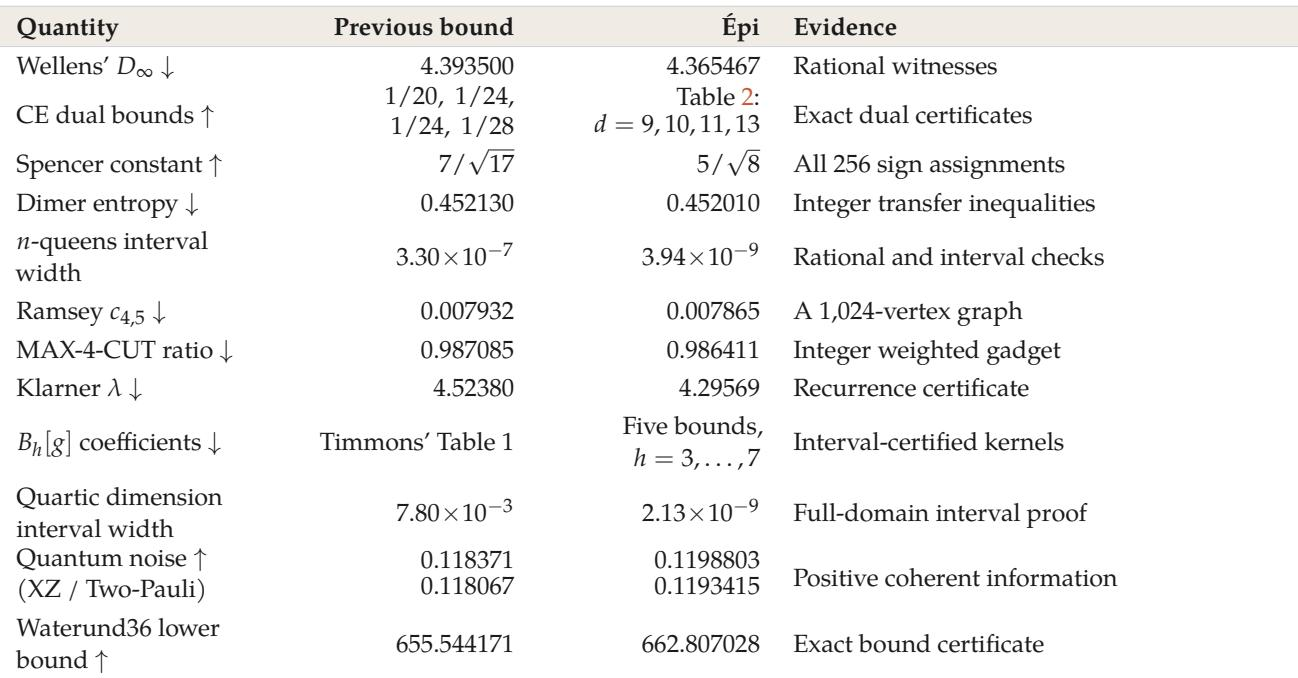
报告的数值记录显示多个族的界限更紧,每个条目都指向其改进方向。若干区间宽度也缩小,表明数值估计更加集中。这些改进得到多种形式的证据支持,包括有理见证、精确证书、穷举检查、不等式和显式构造。若干界限族沿其所述改进方向被收紧。支持证据各不相同,包括有理见证、对偶证书、穷举赋值、整数不等式,以及图或组件构造。
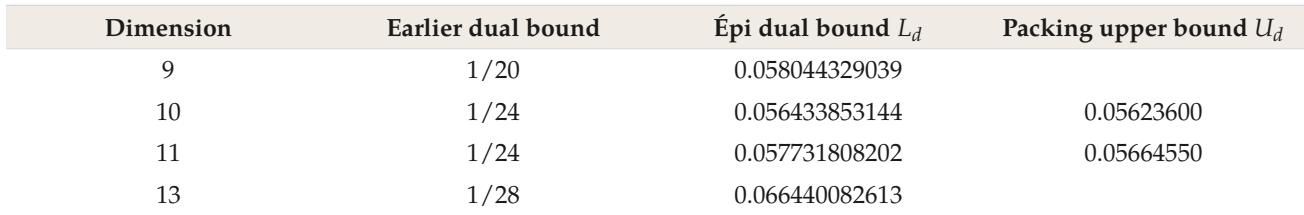
报告的来自 Épi 对偶方法的中心密度下界在维度 9、10、11 和 13 上改进了早期对偶界限。在维度 10 和 11 中,即使采用保守舍入,新下界也超过相应的包装上界,从而给出包装密度上限与最佳 Cohn-Elkies 界限之间的严格分离。维度 9 和 13 被作为改进下界案例纳入,但所示数值并未建立相同程度的分离。在所有列出的维度中,新的 Épi 对偶界限都强于早期对偶界限。在维度 10 和 11 中,下界超过包装上界,表明 Cohn-Elkies 方法在那里不紧。
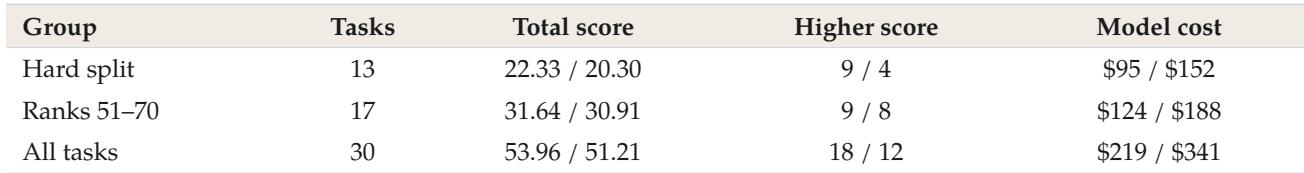
在 FrontierOR 任务上,Épi-turbo 使用更少的模型预算,却取得了比 Codex 更高的总体基准得分。其优势主要来自更快的留出程序和更频繁的任务级胜出,且收益超过损失。速度优势也有助于弥补解质量相近或略低的情况。Épi-turbo 在更多任务上得分更高,并且总体收益大于损失。其生成的程序在留出评估中运行更快,因此速度成为得分差异的关键来源。
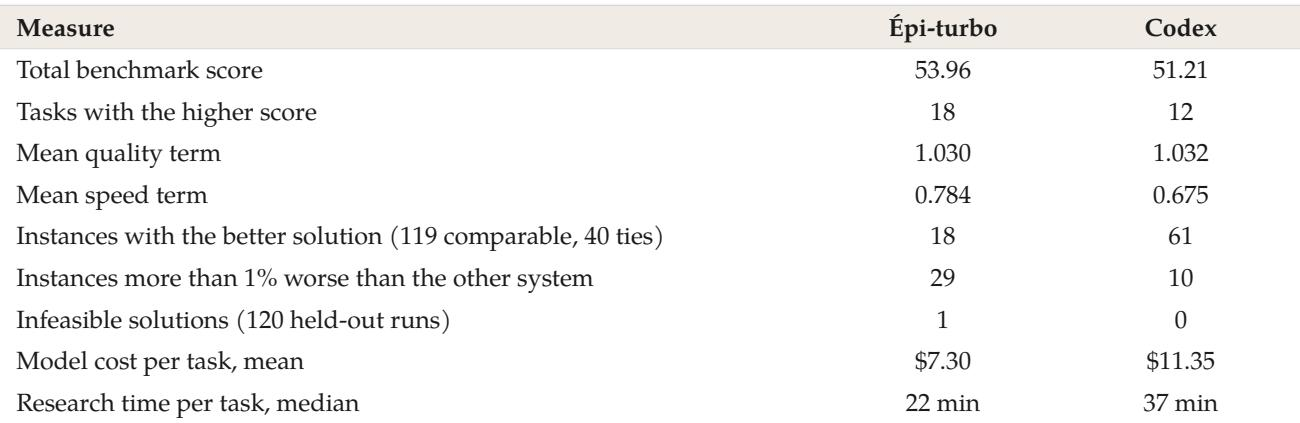
结果显示,在整个任务集上,Épi-turbo 的总体得分略高于 Codex,同时使用的模型成本显著更低。其优势在最难任务组中更明显:其总得分高约 10%,且赢的任务多于输的任务,而中等排名任务则非常接近。该模式表明,得分增益的很大部分来自更快的生成程序,而不仅仅是更好的解。在所有任务上,Épi-turbo 的总分更高,同时花费远低于 Codex。在最难任务组中,Épi-turbo 赢得大多数任务,总得分明显更高。在中等排名任务上,得分差距缩小,两个系统接近。若干任务显示,Épi-turbo 同时具备更高分和更低模型成本。更快执行有助于提升 Épi-turbo 的得分,而长时间运行会削弱 Codex 的速度优势。
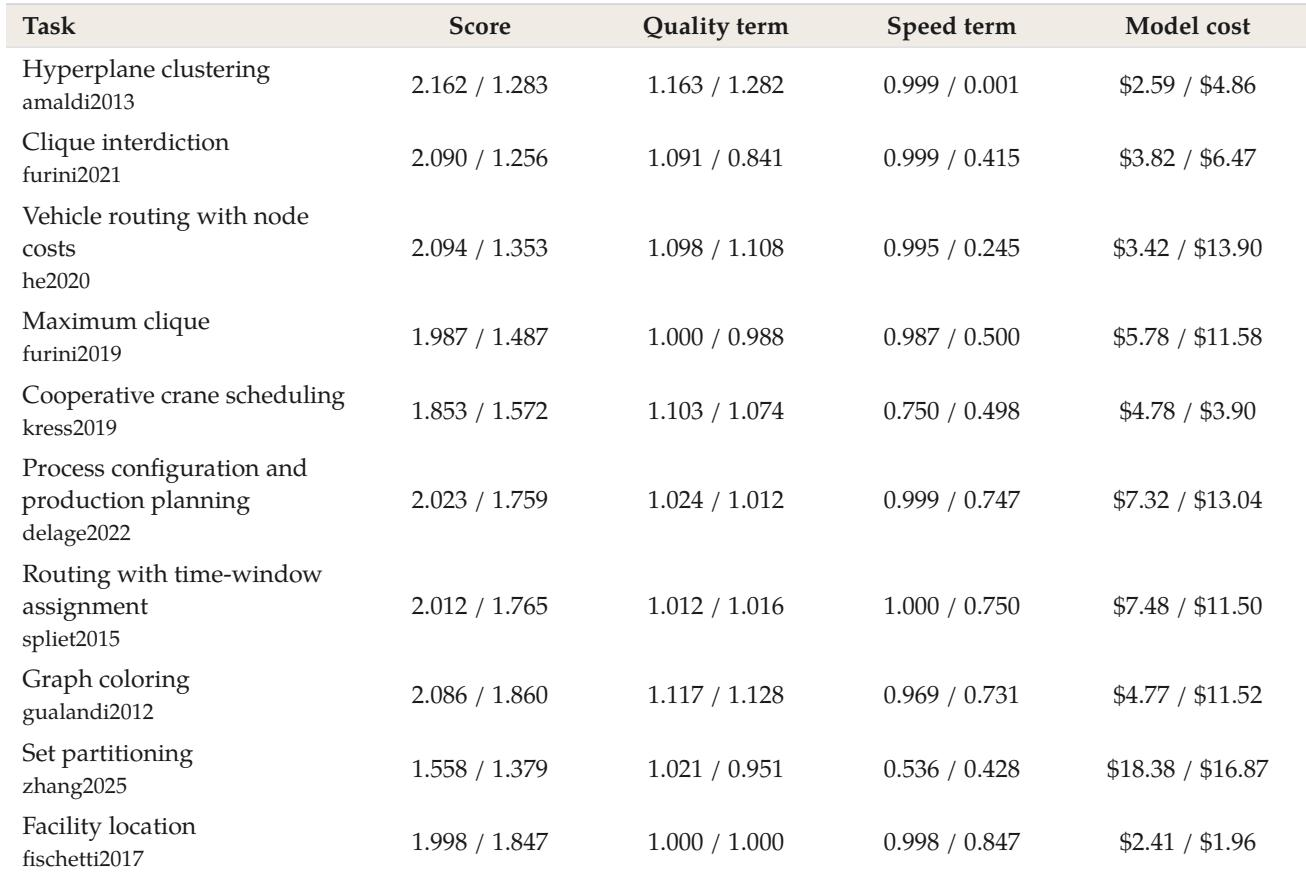
在有利于 Épi-turbo 且得分差异最大的任务中,生成的程序覆盖路由、调度、规划和聚类等多种优化领域。这种优势通常由更快执行驱动,而在若干突出案例中,解质量仍保持相当或更好。这些选择示例也与更广泛结果一致,即 Épi-turbo 经常比 Codex 使用更少的模型成本。速度是主要优势来源,因为 Épi-turbo 程序通常远低于 Codex 使用的运行时间。若干案例中解质量很强,Épi-turbo 与参考结果持平或产出更好的解。所选胜例涵盖许多问题类型,显示出广泛的实际相关性。在这些比较中,Épi-turbo 的模型成本通常更低。
实验通过更紧的数值界限、更集中的区间估计,以及从 Épi 对偶框架获得的更强中心密度下界验证了该方法,并在若干选定维度中改进了分离性。实验还评估了 FrontierOR 任务,其中 Épi-turbo 以更低的模型成本取得了比 Codex 更高的总体得分,尤其是在更难任务和更广泛的优化设置中。定性结果表明,更快的生成程序是主要优势来源,而在多样案例中,解质量保持相当或更好。