Command Palette
Search for a command to run...
通过组合式编辑先验蒸馏将图像编辑为可复用图层
通过组合式编辑先验蒸馏将图像编辑为可复用图层
Wen Xue Yong Liu Xueheng Li Si Wu Yong Xu Yipeng Sun Yan Li Simiu Gu
摘要
高质量图像编辑要求精确修改目标区域,同时保持无关区域的内容不变。现有编辑模型生成扁平化输出,限制了精确的局部操作和图层复用;而分解方法通常将图层恢复与指令驱动编辑分离优化。为此,我们提出 LayerEditor,一个将指令引导的图像编辑与可复用 RGBA 图层的可控生成相耦合的统一框架。其核心是上下文 RGB–Alpha 令牌建模(In-Context RGB–Alpha Token Modeling),在单个令牌序列中联合表示编辑后的画布和有序的 RGB–Alpha 图层序列,从而实现语义编辑以及对单个图层内容的显式控制。为了在适配分层输出时保留预训练模型的编辑能力,我们提出组合式编辑先验蒸馏(Compositional Edit-Prior Distillation),将编辑先验同时迁移到编辑后的画布和由预测图层合成的图像上。为支持训练与评估,我们构建了 LayerEditor-100K,一个带有有序 RGBA 图层标注的大规模成对图像编辑数据集,并引入了用于分层编辑的专用基准。大量实验表明,LayerEditor 在保持较高编辑保真度的同时能够生成准确的 RGBA 图层,支持灵活的图层级操作和多图层分解。
一句话总结
华南理工大学、清华大学的研究者及合作者提出 LayerEditor,一个统一框架,通过上下文 RGB-Alpha Token 建模和组合编辑先验蒸馏(Compositional Edit-Prior Distillation),将指令引导的图像编辑与可复用 RGBA 图层的可控生成相结合;在 LayerEditor-100K 数据集支持下,实现了较强的编辑保真度和灵活的层级别操控。
核心贡献
- 论文提出 LayerEditor,一个统一框架,通过编辑画布和有序图层序列的上下文 RGB-alpha token 建模,将指令引导的图像编辑与可复用 RGBA 图层的可控生成结合起来。
- 论文提出组合编辑先验蒸馏(C-EPD),一种 on-policy 蒸馏策略,将预训练编辑器的先验同时传递到编辑画布和由预测图层合成的图像,从而在分层适配过程中保持编辑保真度。
- 论文构建了 LayerEditor-100K,一个带有序 RGBA 图层标注的大规模成对图像编辑数据集,并引入了专门的分层编辑基准;实验报告了较强的编辑保真度、准确的 RGBA 图层生成和灵活的层级别操控。
引言
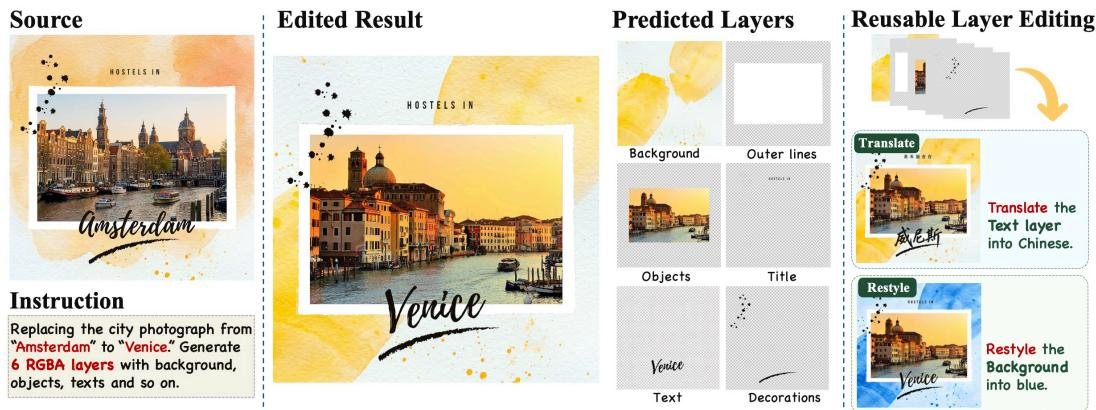
指令驱动的图像编辑对于电商内容生产和广告设计等任务很重要,用户需要只修改指定内容,同时保持无关区域不变。近期的多模态扩散 Transformer 通常合成单一扁平画布,将文字、物体和背景合并在一起,导致细粒度编辑、复用和后续修改变得困难。此前的分层工作流(如 Agent Banana)将编辑和分解视为目标不同的独立阶段,因此即使视觉上合理的编辑也可能产生不完整或组织较差的图层,并需要昂贵的人工修正。作者提出 LayerEditor,这是一个统一模型,将指令驱动的编辑与可复用 RGBA 图层的生成结合起来。它使用上下文 RGB-Alpha Token 建模和专用 alpha 解码器来表示有序图层和精细透明度,同时组合编辑先验蒸馏(Compositional Edit-Prior Distillation)帮助在分层适配期间保持预训练编辑器的生成质量。作者还构建了 LayerEditor-100K 数据集和两个基准,用于系统评估。
数据集
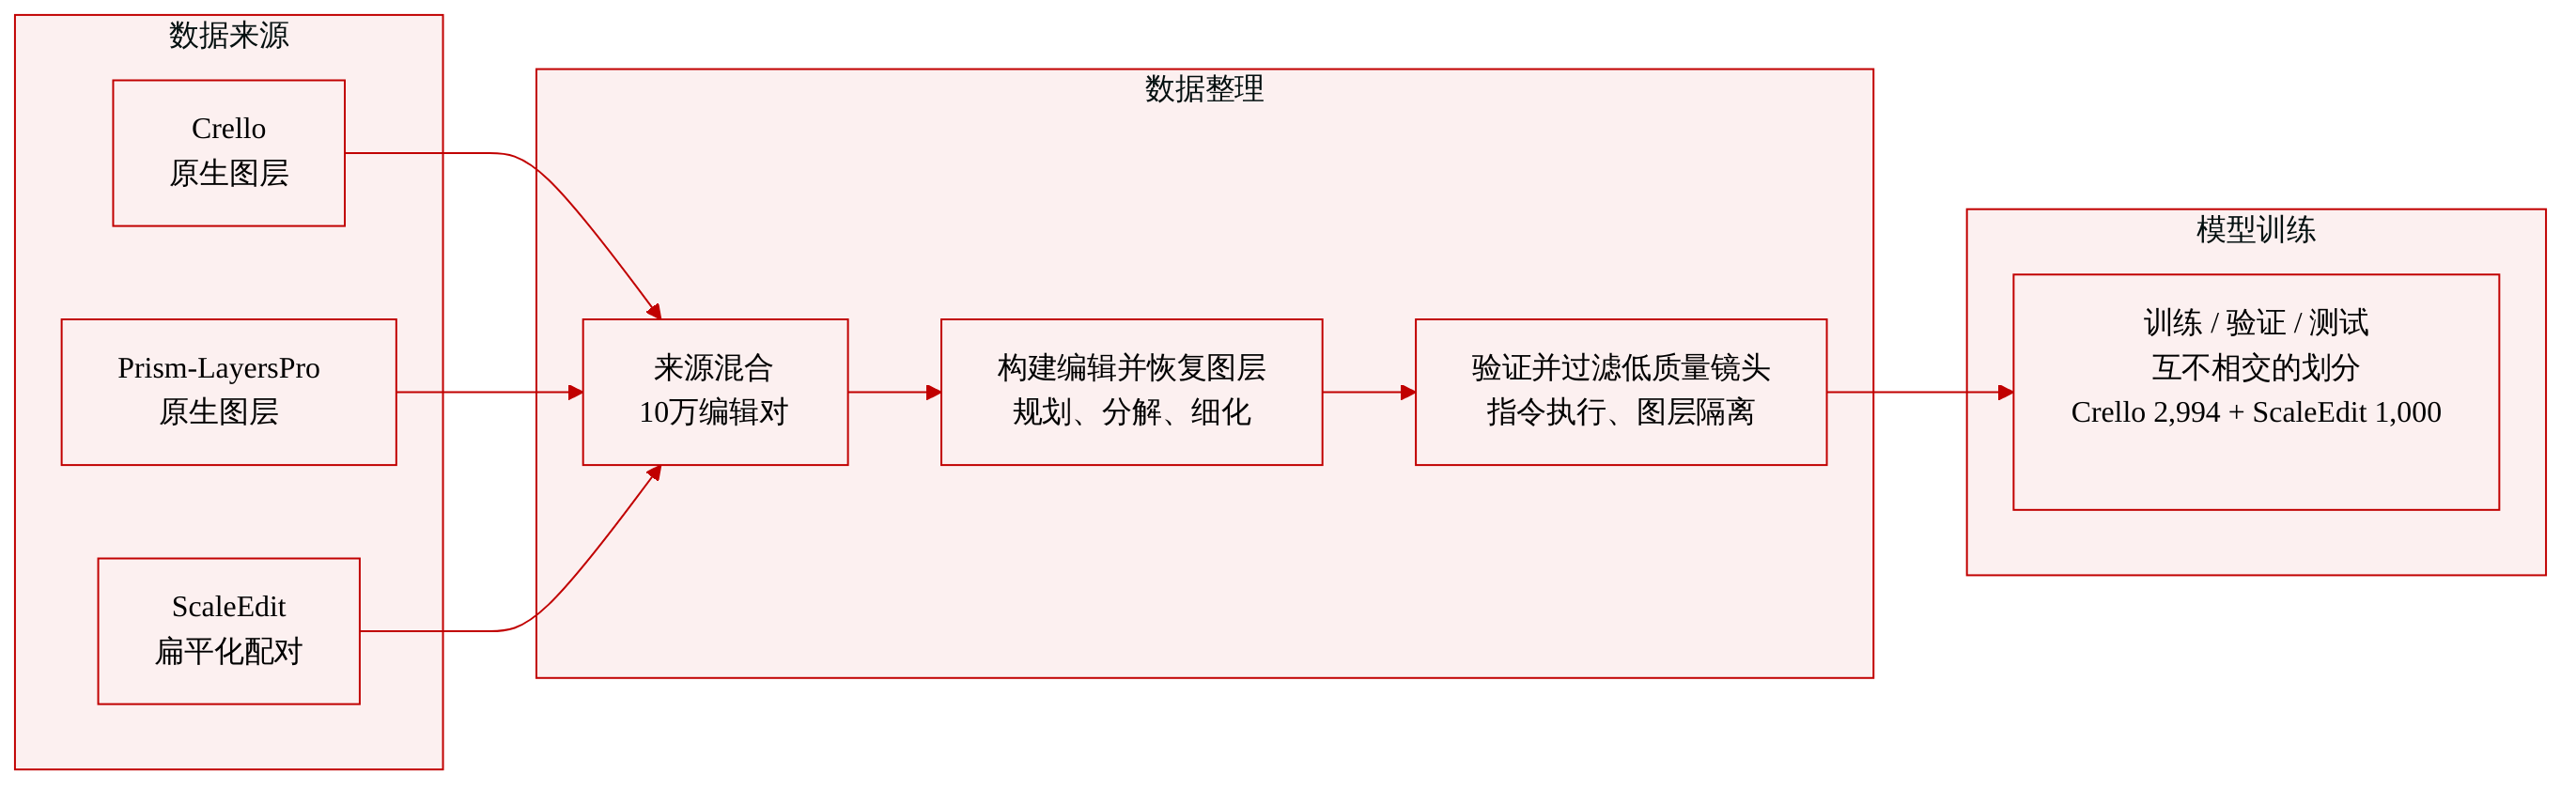
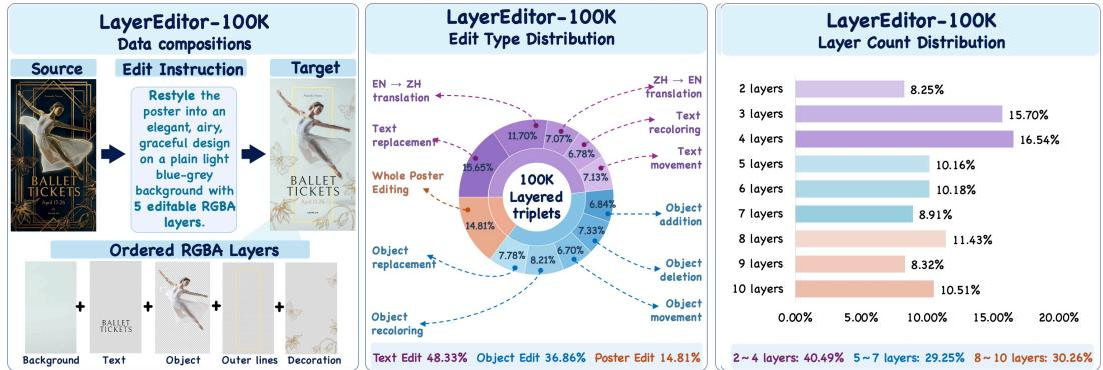
作者提出 LayerEditor-100K,一个包含 100K 个编辑对的数据集,来源于三个渠道:Crello、Prism-LayersPro 和 ScaleEdit。每个示例提供一个源图像、一条编辑指令、一个编辑后的目标图像,以及可重建该目标的有序全画布 RGBA 图层堆栈。
数据集组成与处理:
- 原生 Crello 和 PrismLayersPro 设计在编辑构建过程中保留其原始分层结构。
- 扁平化的 ScaleEdit 编辑对通过规划、分解、细化和质量过滤转换为目标图层。
- 所有编辑对都经过指令执行、图层隔离和重新合成验证。
- 数据集包含 48,329 个文本编辑、36,858 个对象编辑和 14,813 个海报级外观编辑。
- 文本编辑包括移动、重新着色、替换和翻译。
- 对象编辑包括添加、移除、移动、重新着色和替换。
- 每个目标有 2 到 10 个图层,范围从紧凑布局到文本、物体和装饰的细粒度组织。
评估基准与用途:
- Crello-Testset 包含 2,994 个案例,来源于原生 Crello 和 PrismLayersPro 设计。
- ScaleEdit-Testset 包含 1,000 个案例,来源于带有恢复目标图层的扁平编辑对。
- 两个基准都严格与训练数据隔离,包括源文档及所有派生的编辑或图层变体。
- 作者汇总 3,994 个评估案例,创建用于分层可控性的受控设置,包括图层数量控制和图像到图层分解。
- 图像到图层分解在留出的原始 Crello 示例上评估,这些示例最多有十个图层。
方法
作者提出 LayerEditor,一个生成式框架,扩展预训练图像编辑模型,以联合生成编辑画布和可复用 RGBA 图层堆栈。给定源图像 Isrc、编辑指令 u 和请求的图层数量 N,模型生成编辑画布 D 和有序图层堆栈 S:
(D,S)=G(Isrc,u,N),S={Li=(Ri,Ai)}i=0N−1.这里,Ri 和 Ai 分别表示第 i 层的 RGB 外观和 Alpha 不透明度。图层堆栈按从后到前的顺序排列,其精确 alpha-over 渲染产生合成图像 C=Comp(S)。
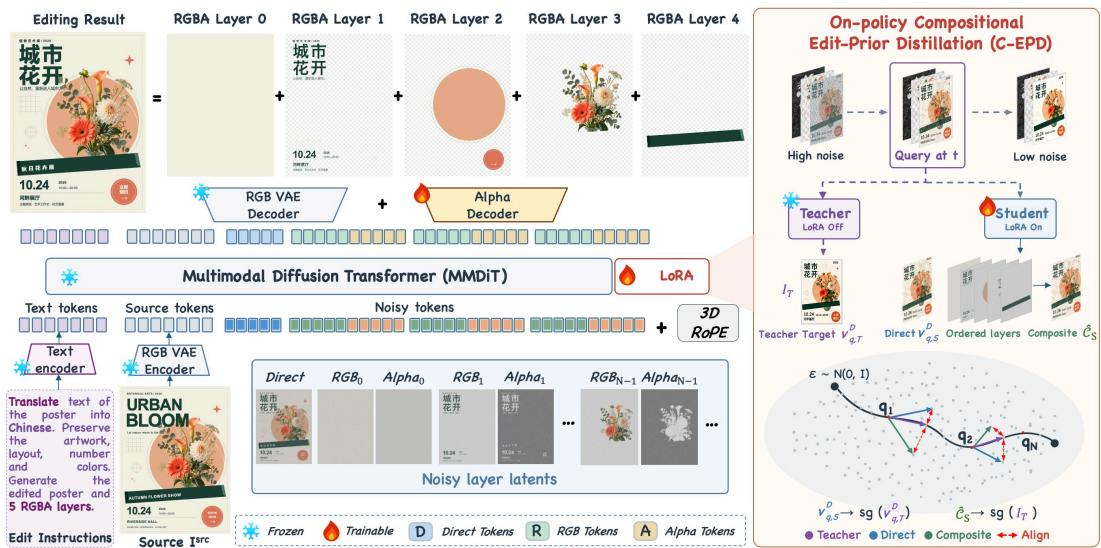
为了实现这种联合生成,作者提出上下文 RGB-Alpha Token 建模。冻结编码器提供源图像和指令条件,而请求的图层数量 N 决定输出对的数量。在噪声水平 σt 下,联合潜状态构造为:
Zt=[ztD,ztR0,ztA0,…,ztRN−1,ztAN−1].所有输出字段都从高斯噪声初始化,并在统一序列中联合去噪。模型将外观和不透明度表示为不同的交互字段,利用共享注意力捕获编辑画布与图层堆栈之间的依赖关系。为了区分共享相同画布坐标的字段,作者采用层感知旋转坐标 (s,x,y)。源图像 tokens 使用 s=−1,编辑画布使用 s=0,第 i 层的 RGB 和 Alpha 字段分别使用 s=2i+1 和 s=2i+2。这种形式化支持在共享架构中处理可变图层数量。此外,引入专用 Alpha 解码器来恢复连续不透明度 Ai。该解码器从预训练 RGB 解码器初始化,并用不透明度和合成重建目标单独训练,在保留预训练 RGB 通路的同时,专门针对细结构和半透明边界进行透明度重建。
将预训练图像编辑模型适配到分层输出可能会削弱其原始编辑能力,可能引入文字损坏、结构失真以及对周围内容的非预期更改。
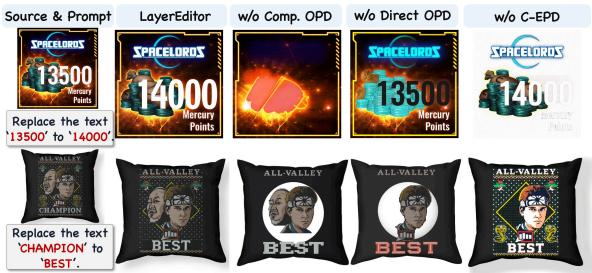
为缓解这种退化,作者提出组合编辑先验蒸馏(C-EPD),使用冻结的预训练编辑模型作为 on-policy 教师来保留原始编辑先验。教师同时引导 Direct 输出和合成的分层表示。遵循 DiffusionOPD,C-EPD 在来自分离学生去噪轨迹的中间状态上查询冻结教师。在噪声水平为 σq 的查询状态 Zˉq 下,学生用梯度重新计算 Direct、RGB 和 Alpha 速度。教师接收相同的 Direct 潜变量 zˉqD、源图像和编辑指令,以预测 vq,TD。对于每个学生输出字段 X∈{Ri,Ai},局部干净潜变量估计为 z^0∣qX=zˉqX−σqvq,SX。冻结解码器恢复 R^i=DR(z^0∣qRi) 和 A^i=DA(z^0∣qAi)。从白色背景 C−1=B 开始,预测按从后到前的顺序合成:
Ci=A^i⊙R^i+(1−A^i)⊙Ci−1,CS=CN−1.学生预测的 Alpha 通过标准 source-over 合成控制每个图层的可见贡献。作者保留 Direct 速度匹配,并使用该损失监督解码后的合成结果:
LC−EPD=Eq∼Q[dD1vq,SD−sg(vq,TD)22+dCλSCS−IT22].这里,dD 和 dC 分别统计 Direct 速度场和解码合成结果的元素数量,sg 阻止梯度通过教师目标。第一项将学生的 Direct 速度与冻结教师对齐,第二项通过其解码合成将相同的编辑先验传递到分层输出。
在训练过程中,LayerEditor 使用 LoRA 适配冻结的预训练多模态扩散 Transformer(MMDiT)。给定干净目标序列 Z∗=[zD,∗,zR0,∗,zA0,∗,…,zRN−1,∗,zAN−1,∗],联合噪声状态构造为 Zt=(1−σt)Z∗+σtϵ,目标速度为 vt∗=ϵ−Z∗。模型根据源图像、编辑指令、请求的图层数量和噪声水平预测联合速度 vθ。作者使用 flow-matching 损失监督完整速度序列:
Lflow=Et,ϵ[dZ1∥vθ(Zt)−vt∗∥22].在初始 flow-matching 预热之后,C-EPD 在 flow matching 仍然生效的同时,对 Direct 速度和解码图层合成引入教师引导。组合目标为:
Lθ=Lflow+λCLC−EPD.该训练由 LayerEditor-100K 数据集支持,该数据集提供 100K 个编辑对,包含源图像、编辑指令、编辑目标以及可重建目标的有序全画布 RGBA 图层堆栈,覆盖文本、对象和海报级外观编辑。
实验
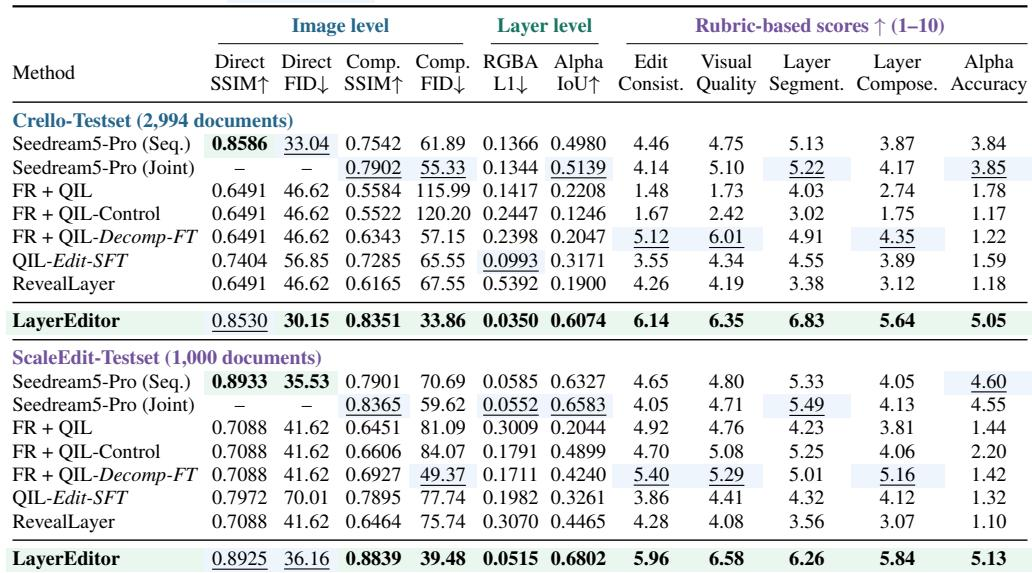
实验在留出的 Crello 和 ScaleEdit 基准上评估 LayerEditor,用于分层图像编辑、受控图层数量设置、纯图像到图层分解基准以及 Crello-Testset 上的消融。这些设置验证重新合成后的编辑保真度、图层可复用性和不透明度准确性、对图层粒度和分配内容的可控性,以及在无需分解专用微调的情况下向分解任务的迁移。LayerEditor 在级联、顺序和联合基线上持续提升,从直接输出到重新合成输出的下降更小,并生成分离更好、可复用的 RGBA 图层。消融证实,Alpha 解码器和 C-EPD 的两个组成部分共同改善编辑一致性、图层分割和图层重建质量。
分解微调改善了基于 FR 的级联中的合成重建保真度,在两个基准上提高了合成 SSIM,同时保持直接编辑指标不变。LayerEditor 在比较方法中取得最佳合成相似度、合成 FID 和 alpha 重叠,其 Crello 合成 SSIM 比 Seedream5-Pro Joint 高 5.7%,合成 FID 低 38.8%。Rubric 评分也指向相同方向,LayerEditor 的平均 Crello 分数高于最强基线。LayerEditor 在两个基准上的合成 SSIM、合成 FID 和 alpha IoU 上均优于 Seedream5-Pro 和基于 FR 的级联。对分解阶段进行微调使 Crello 上的合成 SSIM 从 0.5584 提高到 0.6343,ScaleEdit 上从 0.6451 提高到 0.6927,且不改变直接指标。
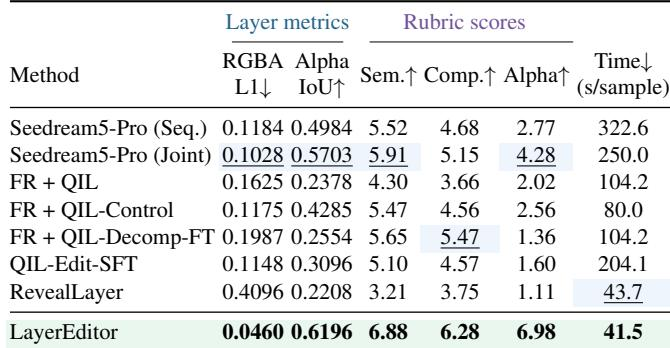
在受控图层数量设置中,LayerEditor 取得最佳 alpha 重叠和基于 Rubric 的图层质量,在 Alpha IoU 和语义分组上优于最强基线。在所列基线中,Seedream5-Pro (Joint) 提供最强的整体质量,但观测延迟相对较高,而基于 QIL 的变体在图层保真度、语义质量和速度之间表现出明显权衡。LayerEditor 在 Alpha IoU 和语义分组上以明显优势超过 Seedream5-Pro (Joint),成为最匹配请求图层结构的方法。Seedream5-Pro (Joint) 是 alpha 和 Rubric 质量方面最强的基线,但比多种基于 QIL 的方法更慢。FR+QIL-Control 在 alpha 重叠、语义分组和合成上相比 FR+QIL 有显著改善,同时降低了观测延迟。FR+QIL-Decomp-FT 取得相对较高的语义和合成分数,但 RGBAL1 最差,Alpha 分数很低,突出图层保真度权衡。
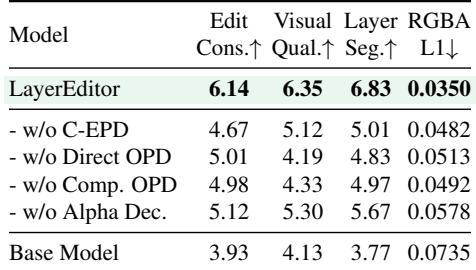
完整 LayerEditor 配置在所有消融变体中取得最佳的编辑一致性、视觉质量、图层分割和 RGBA 重建误差。移除组合编辑引导会显著削弱编辑一致性和图层分割,基础模型在所有指标上都落后于所有 LayerEditor 变体。专用 alpha 解码器与组合引导项共同改善图层准确性和编辑保真度。与完整模型相比,移除 C-EPD 导致编辑一致性和图层分割明显下降。单独使用任一引导项相比无 C-EPD 设置能改善编辑一致性,但会降低视觉质量、图层分割和 RGBA L1。组合两个引导项可改善全部四项指标,专用 alpha 解码器进一步降低 RGBA L1,同时改善图层分割。
实验在合成重建、图层结构对齐和消融设置上,将 LayerEditor 与基于 FR 的级联和 Seedream 风格基线进行比较。分解微调在不改变直接编辑质量的情况下改善合成保真度,LayerEditor 持续取得比对比方法更好的合成相似度、alpha 重叠和语义分组。受控图层数量结果表明,LayerEditor 最匹配请求的图层结构,而 Seedream5-Pro Joint 表现强但更慢,QIL 变体在保真度、语义和速度之间呈现明显权衡。消融证实,组合编辑引导、组合引导项和专用 alpha 解码器对编辑一致性、视觉质量、图层分割和 RGBA 重建很重要。