Command Palette
Search for a command to run...
HexaShell:一个用于探索 VLM 智能体作为机器人编码智能体极限的轻量级框架
HexaShell:一个用于探索 VLM 智能体作为机器人编码智能体极限的轻量级框架
摘要
基于视觉语言模型(VLM)的智能体如今在机器人操作排行榜上已能与学习型策略竞争。我们探究编码智能体在控制机器人而非计算机时能走多远,以及它会在何处遇到边界。我们的系统 HexaShell 保持框架轻薄:它仅将智能体的命令转换为机器人运动。该智能体通过一个命令行驱动一台双臂机器人。它能看到三个 RGB 相机,并知道它们的标定信息。每次尝试失败后,智能体会读取日志、找出原因,并编写或修复被称为工具的小程序。这样,它把学到的东西以代码形式保留下来,就像编码智能体修复失败测试时所做的那样。这些工具只能使用机器人观测到的信息。它们利用三角测量来确定物体相对于彼此以及相对于夹爪的位置。如果两个相机看到同一点,该点就位于两条相机射线的交点处。如果某个点位于已知平面上,例如桌面或积木顶部,它就位于其射线与该平面的交点处。当头部相机不够用时,机器人会移动腕部相机以获取第二个视角。我们仅在每个任务使用一个种子的十种布局来构建工具,然后冻结这些工具,并在同一种子的十种新布局上进行测试。我们使用 Codex 与 GPT-6-Astra,并设置为中等推理努力程度。在所有 42 个 RoboDojo 任务上,HexaShell 达到 39.7% 的成功率和 48.0 的进度得分,平均方式与排行榜相同。这是 RoboDojo 上的新最优结果。瓶颈在于接触而非推理:推动任务达到 92.5%,记忆任务达到 65.0%,但紧密插入任务仅为 8.3%。当智能体失败时,它通常能看到失败,但无法让运动成功执行。我们在 https://github.com/HexaFuture/HexaShell 开源了目前演化出的工具。
一句话总结
HexaFuture.ai 的 HexaShell 是一个轻量级机器人编程框架,允许 VLM agent 通过一个命令行控制双臂机器人,通过编写代码工具修复失败尝试,并利用 RGB 视图进行相机射线三角测量来定位物体,在全部 42 个 RoboDojo 任务上达到 39.7% 成功率和 48.0 进度分,创造了新的最优水平。
核心贡献
- HexaShell 是一个轻量级机器人控制框架,它让一个未修改的 coding agent 通过一个命令行驱动双臂机器人,并将失败尝试日志转化为可复用、可修复的工具程序。
- 这些工具仅使用 RGB 观测和标定多视图几何,包括双相机射线相交、射线与平面相交以及腕部相机主动移动,来确定 3D 物体之间的相对位置以及物体相对于夹爪的位置。
- 工具在每个任务的一种种子上构建十个布局,冻结后在同一种子的十个新布局上测试;在全部 42 个 RoboDojo 任务上,HexaShell 达到 39.7% 成功率和 48.0 进度分,成为新的最优水平。分析表明主要限制是接触而非推理,推动任务成功率为 92.5%,紧密插入任务成功率为 8.3%,并且进化得到的工具已开源。
引言
机器人操作排行榜目前由学习策略主导,包括视觉-语言-动作模型和世界-动作模型,它们将大规模演示数据集直接映射为机器人动作,而基于 VLM 的 agent 也开始通过固定框架参与竞争。Coding agent 提供了另一种选择,因为它们可以读取、运行和修复代码并保留修复结果,但此前的机器人编程工作大多在人工编写的原语之上生成逐指令程序;在 RoboDojo 上,没有自己工具的 VLM 通过固定框架只能达到 22.5% 的成功率。一个核心限制是像素到位置的差距:VLM agent 对度量距离的判断较差,而单目深度网络可能偏差数十毫米,这对可靠抓取来说过于粗糙。作者提出 HexaShell,这是一个面向未修改 coding agent 的轻量级框架,它学习带单元测试的持久机器人工具,并在失败后修复这些工具,利用标定多视图三角测量和主动感知将选定像素转换为世界位置。在全部 42 个 RoboDojo 任务的新布局上,HexaShell 达到 39.7% 成功率和 48.0 进度分,成为新的最优水平。
方法
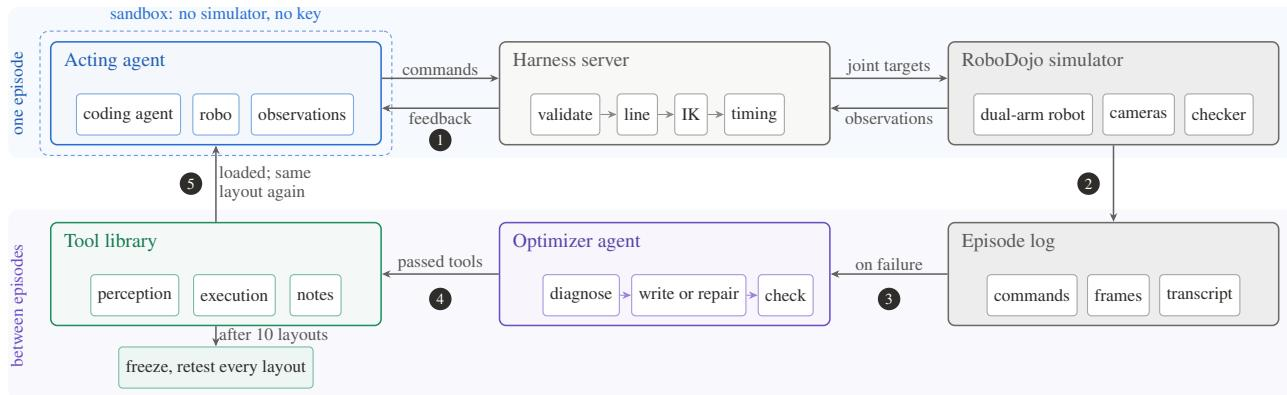
作者设计 HexaShell 是为了让 coding agent 仅使用 RGB 观测来解决机器人操作任务。该架构由三个核心部分组成:将命令转换为运动的框架、从 RGB 图像测量 3D 位置的一组工具,以及根据任务失败迭代改进这些工具的进化循环。
如下图所示:
该框架将执行 agent 隔离在一个沙箱容器中,该容器没有直接网络访问、API 密钥或主机目录。agent 通过一个可执行文件和一个按请求刷新的观测目录与环境交互。这些观测包括来自头部和腕部相机的三张 RGB 图像,以及相机内参、位姿、工具中心点位姿和关节角度。agent 发出基础命令,例如 move、rotate、point、gripper 和 obs。在命令行之后,一个出口代理将流量路由到框架服务器。该服务器验证每条命令,插值一条直线笛卡尔路径,使用 cuRobo 求解每个路径点的逆运动学,并在官方机器人限制下用梯形速度曲线对关节路径进行时间规划。规划后的路径以 25 Hz 采样并发送到模拟器。关键的是,该框架除机器人和桌面外不包含运动规划器或碰撞模型,成功完全由未修改的基准检查器判定。
为了在没有深度传感器的情况下弥合 2D 像素与 3D 世界坐标之间的差距,系统依赖来自标定相机的几何约束。一个像素及其标定定义了世界坐标系中的一条射线,但仅凭射线不足以完成定位。这些工具利用标准 OpenCV 几何中的三类约束。第一类是桌面平面,每个回合由一个共享工具测量一次,该工具扫描候选高度并扭曲图像,以找到相机视图最一致的高度。第二类约束是任何已知高度的其他水平面,例如方块的顶面。第三类约束利用第二个相机视图进行三角测量。如果两个相机观察到同一点,它们的射线相交即可得到 3D 位置。
如下图所示:
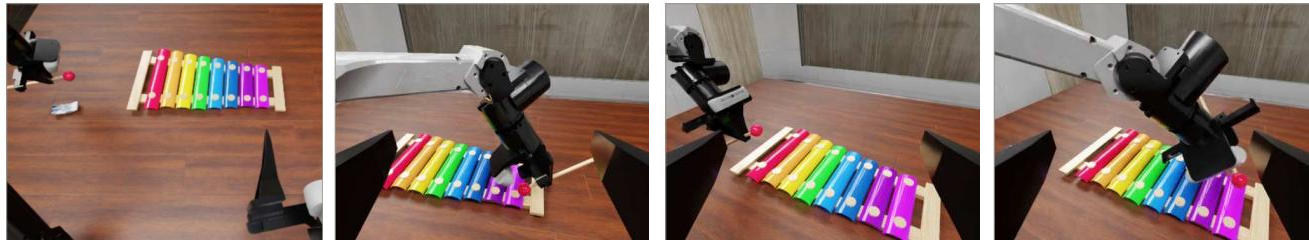
当单一视图不够时,例如物体被部分遮挡或观察角度不佳,机器人必须移动腕部相机以获得第二视角。这种移动会消耗动作步数,代表没有深度时进行测量的成本。例如,在需要精确定位所持物体的任务中,系统在当前两个相机视图之间匹配特征来三角测量中心,按半径过滤候选点,并在找不到清晰匹配时安全失败。
工具实现为包含一个 Python 文件和一个接口描述的目录。Python 文件在 EpisodeAPI 上声明子命令和 run 函数,EpisodeAPI 提供关节角度、TCP 位姿、RGB 图像和运动原语。不移动机器人的测量命令不消耗步数,而移动手臂的命令会从任务限制中消耗步数。共享工具池在优化过程中保持不变,而所有其他工具都针对具体任务。
进化循环驱动这些工具的持续改进。一次运行在特定任务和布局上开始。执行 agent 使用当前工具集尝试该布局。成功后,优化 agent 读取轨迹并记录哪些工具有效。失败时,优化器分析命令日志、相机帧和当前工具代码以诊断问题。然后它写出诊断,并修改或创建工具来解决该失败。交付检查确保修改后的文件完整、可加载,并且接口文本中不引用任务特定对象。如果检查失败,则回滚编辑。模拟器重启,再次尝试同一布局,每个布局最多允许五次编辑。
如下图所示:
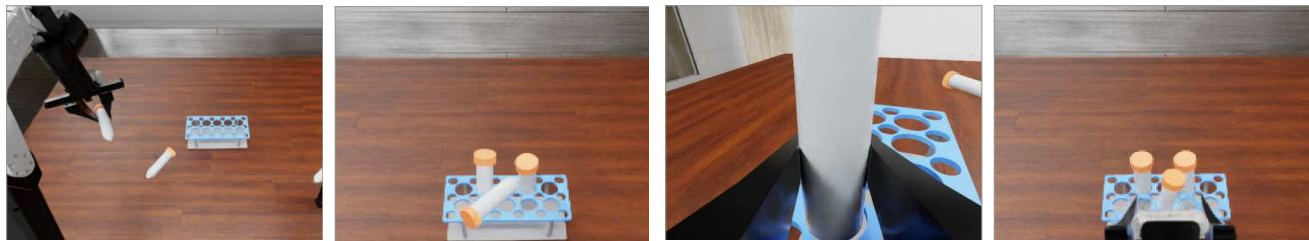
处理完十个布局后,优化器汇总其记录,工具集被冻结,并在开发布局和新布局上重新测试。这一迭代过程使系统能够改进复杂行为,例如调整移动物体的运动时序,或放宽基于未验证单目射线的过于严格的间隙约束,最终使 agent 能够从失败中恢复并完成具有挑战性的操作序列。
实验
这项工作评估了一个仅使用 RGB 的双臂 agent,它在 RoboDojo 的 42 个模拟任务上构建几何测量工具,并将其与排行榜策略、深度网络变体以及干净与杂乱场景进行比较。结果表明,这些工具使 agent 在记忆类和开放类任务上表现强劲,在加入干扰物时仍保持成功率,并受益于主动第二视角;而精确插入、可变形材料和关节式接触仍然是主要弱点。案例研究和失败分析表明,优化器可以修复局部测量、时序、抓取和提前停止错误,但无法克服需要紧密插入或在没有深度的情况下准确倾倒等任务在接触层面的根本限制。
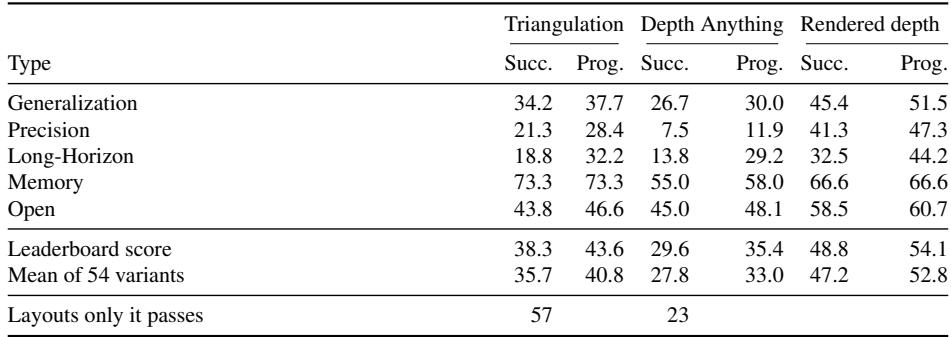
三角测量在总排行榜得分和大多数任务类别上优于深度网络,尤其在精度、记忆和泛化类别;开放类别接近,深度网络略占优势。深度网络在头部和腕部相机上的中位误差相对于抓取和放置所需的厘米级精度来说较大,而三角测量在几何假设成立时不存在同样的固定深度估计下限。渲染深度仍然更高,但仅作参考。在成对布局上,三角测量将更多深度网络失败转化为成功,而不是相反,最大收益出现在 push T、imitate sorting sequence 和 play Xylophone。相对于深度网络的损失较小,集中在圆形容器任务,例如倾倒和堆叠。
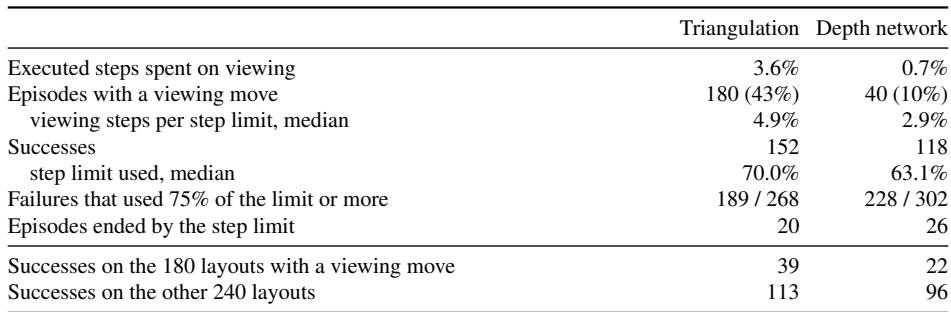
基于三角测量的 agent 在观察移动上花费的执行步数比深度网络 agent 更多,并且包含至少一次观察移动的回合比例大得多。额外的观察并不对应整体步数预算更紧张:该 agent 更常成功,同时接近步数限制的失败略少,在限制处结束的回合也更少。观察成本集中在机器人必须测量早期工具视为固定特征的任务中。观察移动在三角测量中更常见,出现在 43% 的回合中,而深度网络为 10%。三角测量 agent 尽管消耗的步数限制中位数比例更高,但总体上取得更多成功,并且消耗至少四分之三限制的失败略少。
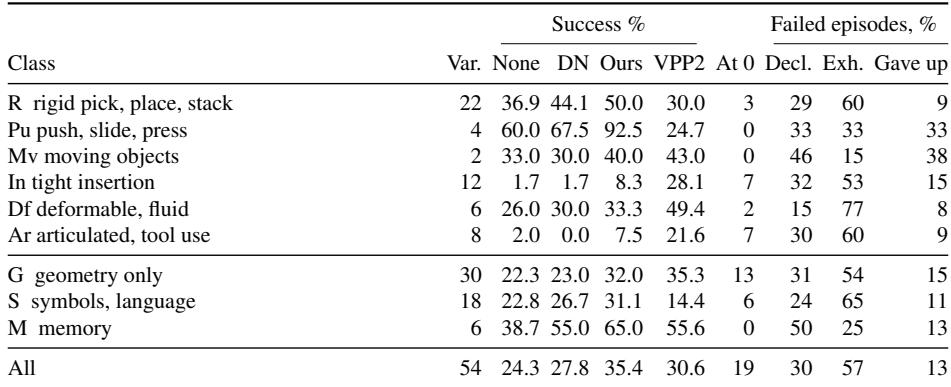
能力图显示,基于工具的成功率随物理交互类别差异很大。深度工具对推动和刚性操作改善最大,而紧密插入和关节式物体仍然困难。失败模式也不同:可变形、关节式和刚性失败大多耗尽预算,而记忆类任务常以虚假完成结束,移动物体常导致放弃。三角测量工具在推动任务上达到 92.5% 成功率,在刚性操作上达到 50.0%,而紧密插入和关节式工具使用保持在 10% 以下。学习策略则呈现相反的特征,在插入和可变形材料上表现更好,但在推动上较弱。预算耗尽在可变形、关节式和刚性类别中主导失败,而声明完成在记忆类任务中最常见。
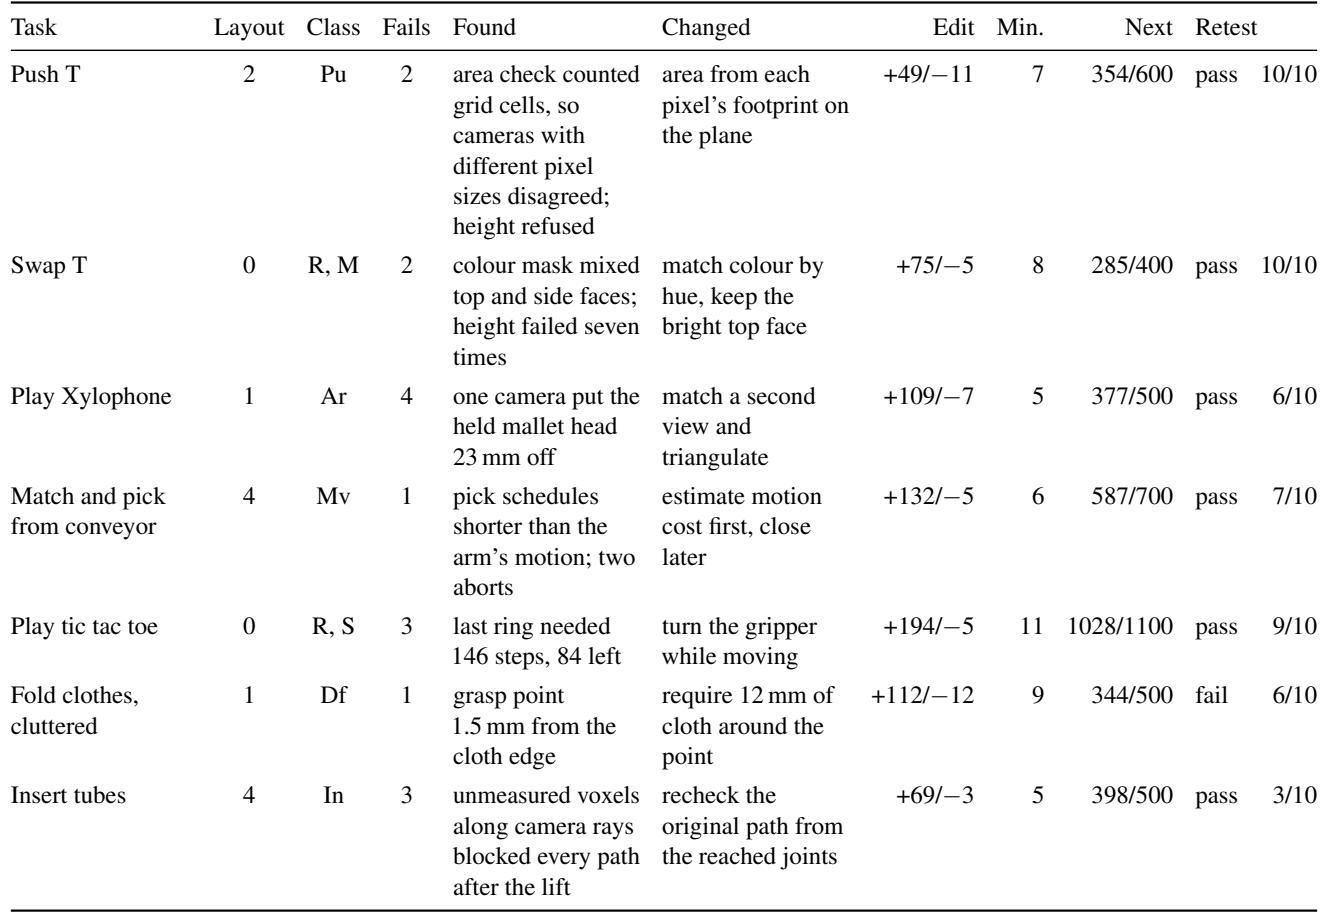
在七个被修复的失败中,优化器对其中一个工具进行了小而局部的编辑,修复了测量、时序、抓取选择或过早回退行为。大多数修复依赖命令日志、工具反馈和代码,而不是视觉检查,并且下一次尝试在全部七个案例中成功。冻结后的重测显示,某些任务具有较强泛化性,但在较难类别(如叠布和管插入)中任务级鲁棒性较弱。优化器主要依据文本和数值证据(如命令日志和拒绝原因)工作,只有少数情况需要图像分析。重测泛化不均衡:部分修复在开发布局上完全泛化,而叠布和管插入仍然脆弱,任务级成功率较低。
这些实验在操作基准上将基于三角测量的工具 agent 与深度网络基线进行比较,考察其步数和观察成本,按物理交互类别分解性能,并测试用于从失败中恢复的自动优化器。三角测量提高了总排行榜得分,并在精度、记忆和泛化任务中更常成功,尽管它使用更多观察移动,且不能解决困难的插入或关节式工具场景。能力分析显示,深度工具主要帮助推动和刚性操作,而紧密插入和可变形任务仍然具有挑战性,预算耗尽是最主要的失败模式。优化器进行小而局部的修复,通常能立即成功,但重测泛化不均衡,尤其是对于叠布和管插入等脆弱任务。