Command Palette
Search for a command to run...
R2Orch:通过技能内化循环中的自博弈实现智能体编排的递归自我改进
R2Orch:通过技能内化循环中的自博弈实现智能体编排的递归自我改进
Mingda Zhang Yun Huang Qiang Huang Yanjin Li Rui Qian Qichao Zhao Tiesunlong Shen Na Zhao Jian Wang Xiaoying Tang
摘要
近年来,智能体编排已被广泛应用于解决复杂的人类任务。然而,现有的编排学习仍面临关键挑战,包括手工设计的课程体系、当某一任务的所有 rollout 都达到相同结果时出现的优势塌缩,以及仅用单一含噪分数评判每项技能的不可靠评估信号。为解决这些挑战,我们提出了 R2Orch,一种递归自博弈编排的新范式:内层自博弈循环在自选任务上改进编排器,外层循环则改进内层循环的改进方式。为支持这一范式,我们引入了递归可学习性(Recursive Learnability),该训练目标奖励提议者(Proposer)选择那些在技能被撤除时其 rollout 仍不断得到不同结果的任务。在此目标基础上,我们进一步提出技能撤除(Skill Withdrawal):当自博弈中的受控评估表明编排器在没有某项技能时表现同样好,外层循环即撤除该技能。此外,两个循环形成一个完整周期:失败被蒸馏为技能,技能被蒸馏为参数,而技能撤除又促使提议者寻找新的失败,从而使编排器逐步走向零技能部署。在 12 个数据集上的实验结果表明,R2Orch 在问答、数学、代码和交互式任务上一致优于基线方法。我们的代码可在 github.com/beita6969/R2Orch 获取。
一句话总结
香港中文大学(深圳)、复旦大学、伊利诺伊大学厄巴纳-尚佩恩分校、清华大学和新加坡国立大学的研究人员提出 R2Orch,一种递归自博弈编排范式,其内层循环在自选任务上改进编排器,外层循环通过递归可学习性与技能撤回改进内层循环的改进方式,推动零技能部署,并在十二个问答、数学、代码和交互式数据集上优于基线。
核心贡献
- R2Orch 是一种递归自博弈编排范式,结合了内层循环和外层循环:内层循环在自选任务上改进编排器,外层循环改进内层循环的运作方式,推动系统走向零技能部署。
- 递归可学习性奖励任务 Proposer 选择那些在候选技能未被提供时 rollout 仍持续产生不同结果的问题;技能撤回则在受控自博弈评估显示编排器在没有某技能时表现同样好后移除该技能。
- 在涵盖问答、数学、代码和交互式任务的十二个基准上的实验表明,R2Orch 在每一个基准上都优于所有基线,无需重新训练即可改善其他六种 Worker 主干,并在零技能测试下保持准确率。
引言
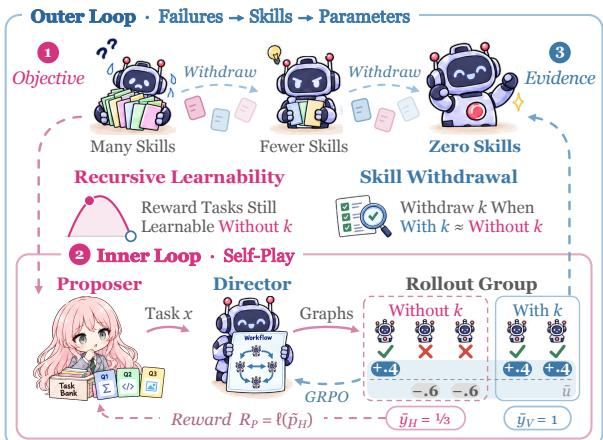
Agentic 系统越来越依赖 agent 图谱,其中节点是角色,边是交接关系,这为编排器提供了可控、可组合和可复用的任务解决方式。然而,现有编排器通常从人工收集的任务中学习,并依赖提示中的技能,因此扩展成本高且难以自主改进。先前关于学习式编排、自改进 agent 和技能脚手架的工作仍面临人工设计的课程、基于群体的强化学习中的优势坍塌以及不可靠的评估信号。作者提出 R2Orch,一种递归自博弈编排范式,其内层循环在 Proposer 选择的任务上改进 Director,外层循环改进内层循环。该方法引入递归可学习性,用于奖励在候选技能不予提供时 rollout 依然保持多样的任务;引入技能撤回,用于在随机 rollout 组内通过受控评估淘汰技能。该方法在十二个基准上优于基线,并在零技能部署下保持准确率。
方法
作者引入 R2Orch 框架,通过构建在单一随机 rollout 组之上的两个嵌套自博弈循环来编排模型改进。该架构整合了递归自博弈编排、递归可学习性和技能撤回,以持续优化任务选择以及模型的底层能力。
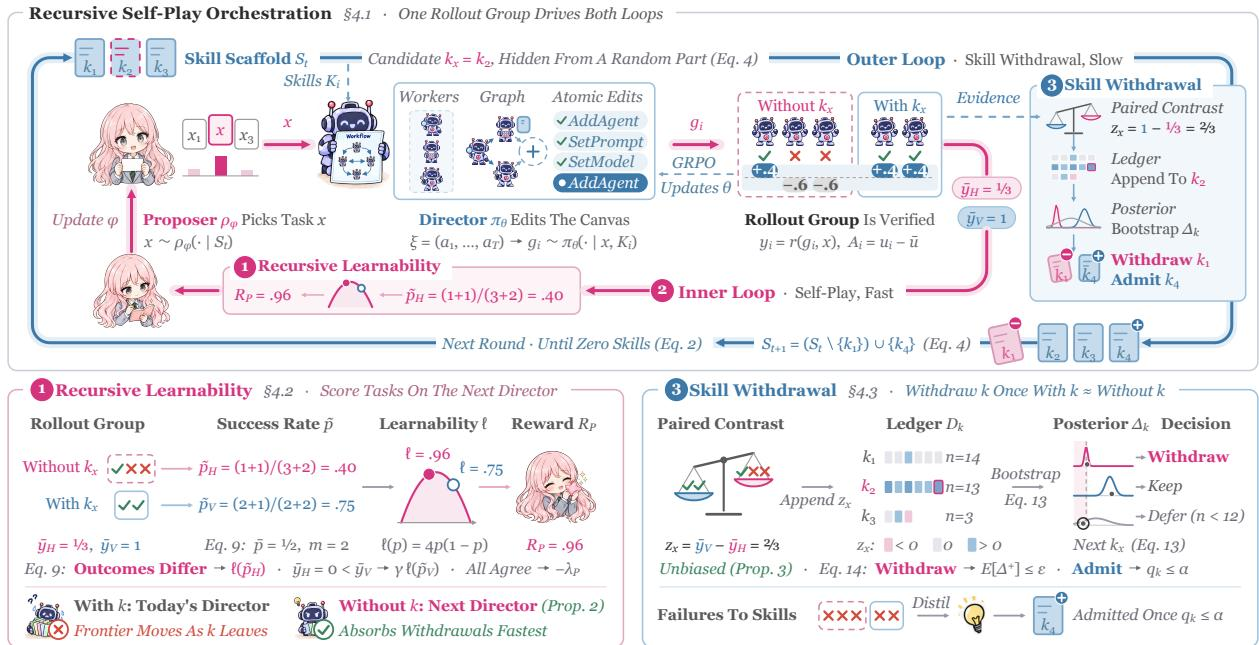
核心机制递归自博弈编排在两个不同时间尺度上运作。在快速时间尺度上,内层循环利用自博弈在 Proposer 选择的任务上改进 Director。两个策略通过裁剪步骤执行近端最优响应,其公式为:
θt+1≈argθmaxEvK(x;θ)−β1KL(πθ∥πθt) ϕt+1≈argϕmaxERP(x)−τKL(ρϕ∥ρ0)Director 在 Proposer 的选择上进行训练,并根据其读取的上下文价值进行评估;Proposer 则使用特定的奖励信号进行优化。在慢速时间尺度上,外层循环利用相同 rollout 组,通过规则 St+1=Φ(St;{Πk}k∈St,Ft) 更新技能脚手架。该脚手架决定每个组的随机上下文,实际上在每个外层步骤重写内层循环的目标。通过共享单个随机 rollout 组,该框架确保内层循环为每次技能撤回做好准备:在多数更新中,Director 在不使用候选技能的情况下进行训练。
为了引导 Proposer 选择最有益的任务,作者设计了递归可学习性模块。该组件充当向下通道,外层循环在此设定内层循环的目标。它奖励 Proposer 选择这样一类任务:即使候选技能不予提供,rollout 仍持续产生多样的结果。任务的可学习性由近端步骤的对数配分函数的曲率来量化,该曲率对应结果方差。具体而言,递归目标定义为:
ℓrec(x):=4∂β2logZKx∖kxβ=0=4p−(1−p−)其中 p− 是移除候选技能时的成功概率。Proposer 奖励计算为 rollout 组隐藏部分上该递归可学习性的经验贝叶斯插件估计;当进展仅限于可见部分时进行折扣,并在坍缩时施加惩罚。该奖励机制塑造了一种课程,使基础模型倾向于具有高递归可学习性的任务。
与此互补,技能撤回模块充当向上通道,将内层循环的证据提供给外层循环。其目的是最小化脚手架更改成本:一旦受控评估表明 Director 在没有某项技能时表现得同样好,就撤回该技能。由于 rollout 组的隐藏部分是随机抽取的,每个组都起到随机区组的作用。两部分均值之差提供了技能效应的无偏估计:
zx=nv1i∈Vx∑yi−nh1i∈Hx∑yi这些对比被累积为每个技能的贝叶斯自举后验。基于该后验,系统做出贝叶斯最优决策,以撤回或接纳技能,从而确保每次撤回产生的期望成本最小。此外,同样的后验机制会识别最没有帮助的技能进行修订,并从两部分均失败的组中蒸馏出新技能,从而无缝闭合外层循环。
实验
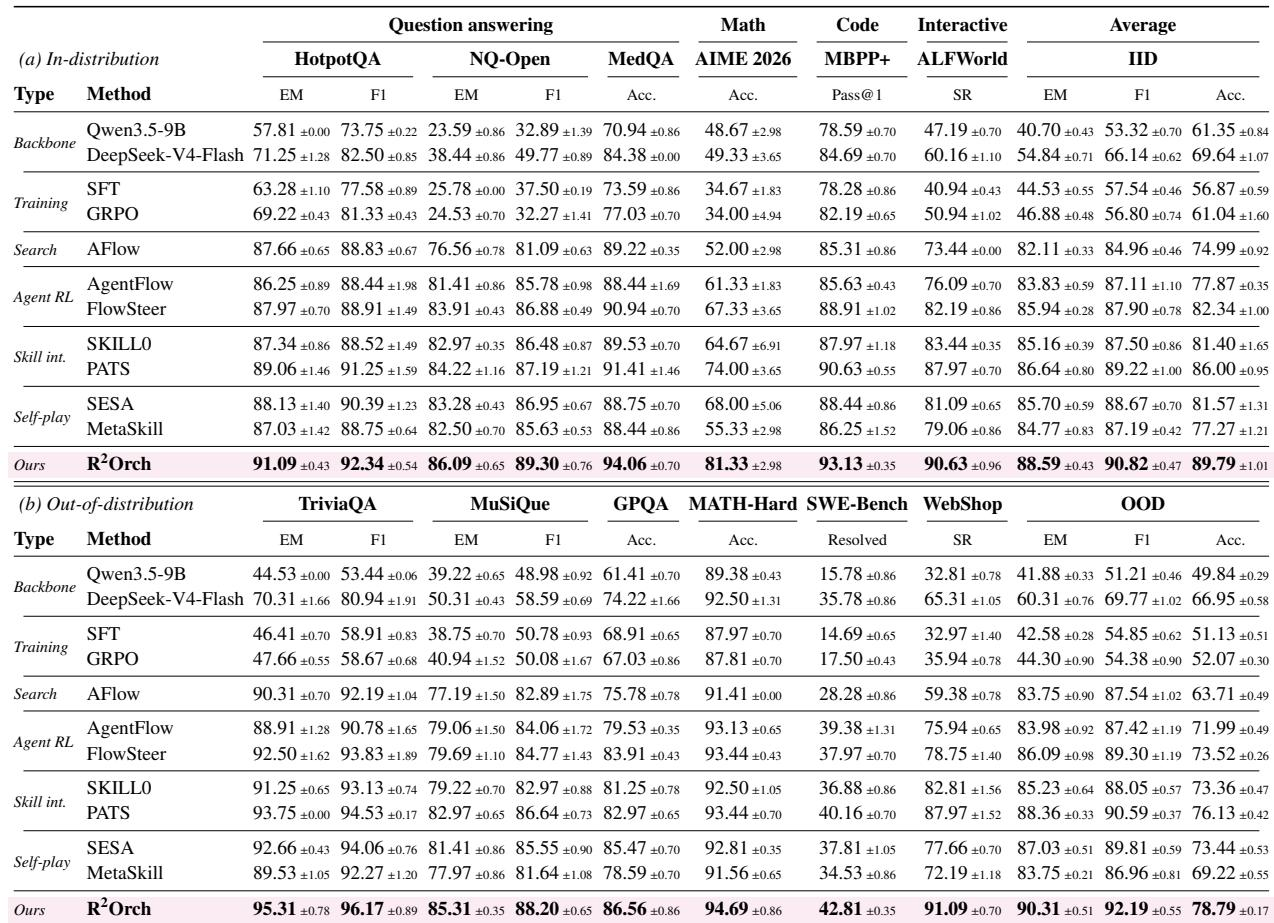
实验在六个分布内和六个留出基准上,针对六个基线族评估 R2 Orch,测试整体性能、主干迁移、递归自博弈编排、递归可学习性和技能撤回。R2 Orch 在每个基准上都优于所有基线,收益来自编排而非主干训练;其训练后的 Director 无需重新训练即可迁移到其他 Worker 主干,尤其能改善较弱的主干。消融实验确认,两个递归自博弈循环都是必要的,递归可学习性会选择在技能被撤回时仍持续产生学习信号的任务,技能撤回仅在技能不再对 Director 有帮助时才移除该技能。
在冻结 worker 和匹配计算量的共享协议下,R2 Orch 在每一个分布内和留出基准上都优于所有基线。收益主要来自编排而非主干训练,在 AIME 2026、WebShop 和 ALF-World 等任务上优势最大。训练后的 Director 还能在不重新训练的情况下迁移到其他 worker 主干,缩小了不同主干之间的性能差距。R2 Orch 是唯一在全部十二个基准上都领先的方法,在替代目标和消融设置退化最严重的任务上优势最强。对冻结 worker 的编排比仅进行主干训练贡献更大,学习到的 Director 无需重新训练即可跨 worker 主干迁移。
消融实验在零技能评估下隔离每个编排组件。移除递归自博弈或将部分组件替换为更简单替代方案,会降低分布内和分布外基准上的准确率;而直接提示主干模型的得分远低于任何编排变体。最大的损失出现在 WebShop 和 ALF-World 等交互式任务上,这些任务中技能撤回和递归可学习性最为重要。对 Qwen3.5-9B 主干的直接提示远弱于任何编排变体,这确认了编排是收益来源。移除或简化递归自博弈、递归可学习性或技能撤回的消融会降低零技能准确率,其中 WebShop 和 ALF-World 等交互式任务的下降最大。
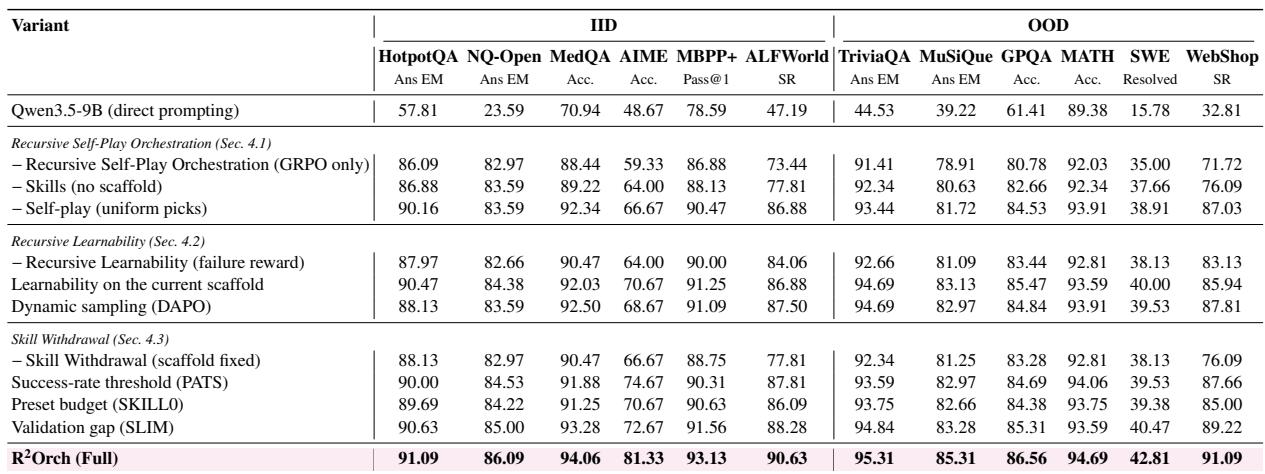
实验在冻结 worker 和匹配计算量的共享协议下评估 R2 Orch 与基线,并单独在零技能设置下对其编排组件进行消融。比较表明,对冻结 worker 的编排而非主干训练带来了持续收益,R2 Orch 在全部十二个基准上领先,其训练后的 Director 无需重新训练即可迁移到其他 worker 主干。消融确认递归自博弈、递归可学习性和技能撤回都很重要,因为移除或简化它们会降低分布内和分布外基准上的准确率,尤其是在 WebShop 和 ALF-World 等交互式任务上。总体而言,结果将 R2 Orch 的广泛优势主要归因于其编排机制。