Command Palette
Search for a command to run...
TokenEconomizer:面向编码智能体的经验驱动黑盒成本控制
TokenEconomizer:面向编码智能体的经验驱动黑盒成本控制
摘要
前沿编码智能体的进步显著提高了人工智能辅助软件工程的令牌成本。现有方法通常在孤立任务上评估其令牌效率,而现实世界中的开发者使用这些智能体持续构建、更新和维护大规模项目。这种不匹配促使我们在真实编码任务序列上评估智能体,发现智能体表现出反复出现的、依赖于环境的令牌成本,而现有方法难以降低这些成本。为最小化此类成本,我们提出了 TokenEconomizer,一种外部控制器,能够在任务序列中削减特定于环境的令牌成本。这些削减来自三个方面:(i)确定注入哪些操作性微技能,(ii)剪除哪些持续无关的工具,以及(iii)何时介入无效的失败循环。在 Claude Code、Codex 和 GitHub Copilot CLI 与前沿模型配对的环境中,TokenEconomizer 将平均令牌成本降低了 18.4%–30.9%,同时保持了相当的任务成功率。在每种智能体-模型设置下的每个代码仓库中,节省效果均得以保持,并泛化到序列化 Web 开发和安全审计等多种领域,成本根据任务结构下降 6.4%–21.2%。我们的工作确立了自适应黑盒成本控制作为在现实环境中降低编码智能体令牌成本的一个有前景的方向。
一句话总结
来自 UC Berkeley、Microsoft Research 和 Microsoft Security 的研究人员提出了 TokenEconomizer,一个外部黑盒控制器,通过注入操作性微技能、剪除持续不相关的工具,并干预无产出的失败循环,在现实编码任务序列中降低编程 agent 的环境特定 token 成本;在 Claude Code、Codex 和 GitHub Copilot CLI 与前沿模型配对使用时,平均 token 成本节省 18.4%–30.9%,并且任务成功率相近;在连续的 Web 开发和安全审计中还实现了 6.4%–21.2% 的节省。
核心贡献
- 该论文提出了 TokenEconomizer,一个外部黑盒控制器,它从已完成任务轨迹中学习,通过选择要注入的操作性微技能、剪除持续不相关的工具,并干预无产出的失败循环,降低编程 agent 的环境特定 token 成本。
- 该方法将这些选择形式化为环境特定的元策略,通过 agent 的提示词、工具配置和事件流加以应用,并包含恢复路径:退役过时技能、恢复被剪枝的工具,以及对不确定情况进行重定向,而不是直接停止。
- 结果表明,在 Claude Code、Codex 和 GitHub Copilot CLI 与前沿模型配对使用时,TokenEconomizer 将平均 token 成本降低 18.4% 至 30.9%,任务成功率相近;在每一个测试仓库中都有降低,并泛化到连续的 Web 开发和安全审计,成本降低 6.4% 至 21.2%。
引言
Claude Code、Codex 和 GitHub Copilot CLI 等前沿编程 agent 可以完成长周期软件工程任务,但由于持久指令和不断增长的工具历史会在每一轮中被重复计费,它们会产生大量且不断累积的 token 成本。此前的大多数成本降低方法通过固定提示词压缩、工具限制、仓库地图或路由来优化单个任务,但这些方法通常需要修改 agent、牺牲任务成功率、在不同仓库上产生不一致的节省,并且忽略了在共享代码库中跨任务积累的可复用经验。作者分析了默认 agent 轨迹,识别出三类反复出现的可移除成本:反复重新发现的操作性知识、已加载但未使用的工具,以及消耗不成比例开销的失败轨迹。为解决这些问题,他们提出了 TokenEconomizer,一个外部黑盒控制器,使用已完成的执行轨迹学习环境特定策略,以激活微技能、剪除无关工具,并干预无产出的失败循环,从而在多个 agent 和基准上保持一致的成本降低,同时维持可比的任务质量。
方法
作者首先对 agent 轨迹进行剖析,以识别三类主要的可移除成本来源:仓库内重复的操作性工作、大量已加载但未使用的工具,以及消耗总开销中不成比例份额的失败轨迹。
如下图所示:
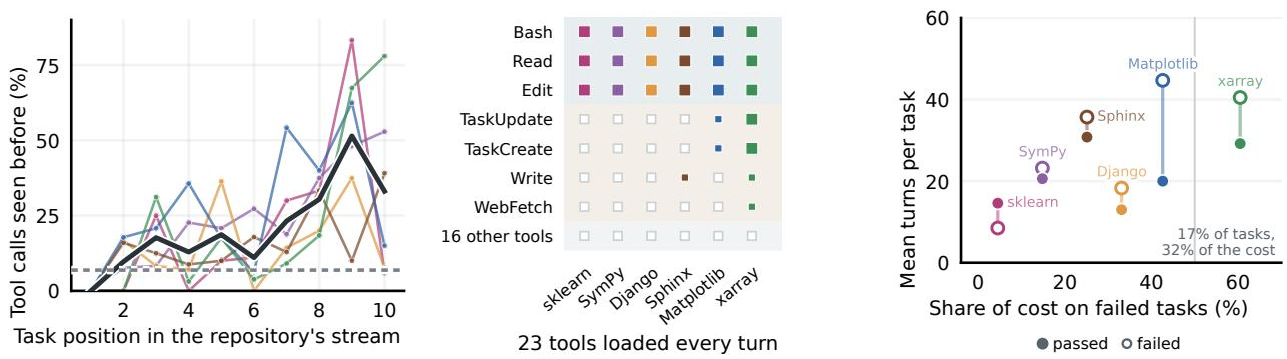
为解决这些低效问题,作者提出了 TokenEconomizer,一个外部控制器,它应用三种与仓库无关的元策略,从已完成轨迹中学习仓库特定策略。该控制器无需修改底层 agent,而是通过指令前缀、已加载工具和实时事件流发挥作用。
参考框架图:
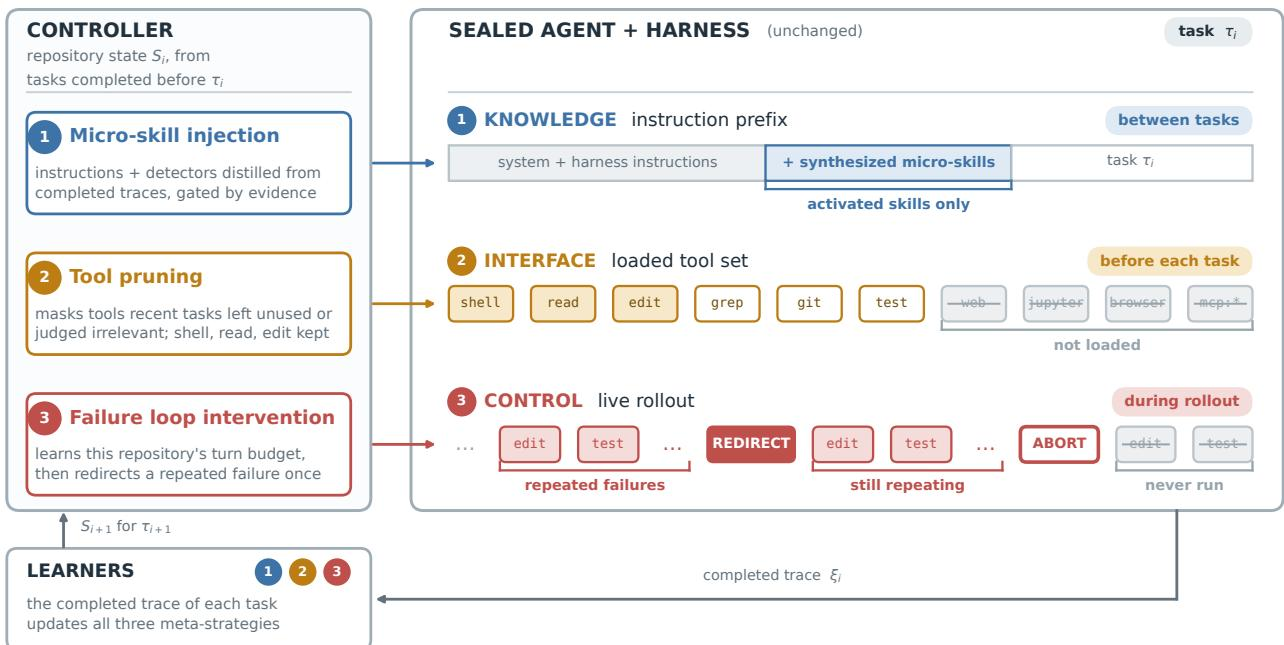
系统对环境中按时间顺序排列的任务流 τ1,…,τn 进行优化。在任务 τi 开始前,控制器 C 根据任务描述和累积的仓库状态 Si−1 确定当前激活的策略:
(ΔPi,Ui,Bi)=C(τi,Si−1).这里,ΔPi 表示该任务激活的微技能集合,Ui 是受限的已加载工具集合,Bi 是失败循环干预的轮次预算。agent 执行任务并产生轨迹 ξi 后,控制器将仓库状态更新为 Si。
元策略 I:基于经验的微技能
该模块从过去的轨迹中综合操作性知识。控制器将已完成轨迹压缩为操作性证据摘要,例如命令模板和错误模式。LLM 提议器起草候选微技能,每个微技能将一条操作指令与可执行检测器配对。作用域检测器检查该技能的情形是否在轨迹中出现,而需求检测器记录任务是否确实需要该技能。
技能 f 在任务 i 上的支持度计算如下:
qi(f)=j<i∑γi−j(1[ξj confirms f]−λ1[ξj contradicts f]),其中 γ<1 对较旧证据进行折扣,λ>1 对矛盾给予更重惩罚。仅当一项技能在已编辑文件不重叠的多个任务中得到确认,且其需求率达到阈值时,该技能才会被激活。如果 qi(f)<0,则该技能被退役。
元策略 II:工具剪枝
为降低工具接口的重复成本,该模块省略不太可能有帮助的 schema。用于 shell 执行和文件操作的核心工具始终保留。其他工具如果在连续固定数量的任务中一直未被调用,或 LLM 判定器认为其与当前任务描述无关,则会被移除。为了从错误排除中恢复,控制器定期恢复完整工具目录以进行重新审计;在该审计期间被调用的任何工具将被永久取消屏蔽。
元策略 III:失败循环干预
该模块推导出仓库特定的轮次预算,以识别无产出的循环。任务 τi 的预算定义如下:
Bi=β⋅Qp({∣ξj∣:j<i,yj=1}),其中 Qp 是来自先前成功任务的轮次计数的经验 p 分位数,β>1 是余量。在执行期间,基于规则的检查会监测重复的失败特征,或轨迹是否超过 Bi。如果触发,LLM 判定器会审查近期操作摘要,以区分卡住的循环与困难但仍在推进的任务。若给出有把握的“卡住”结论,则通过近期操作摘要进行重定向。如果该模式再次出现,则终止该次执行。若严格停滞条件满足,强制停止会在 κBi 轮次作为兜底生效。
实验
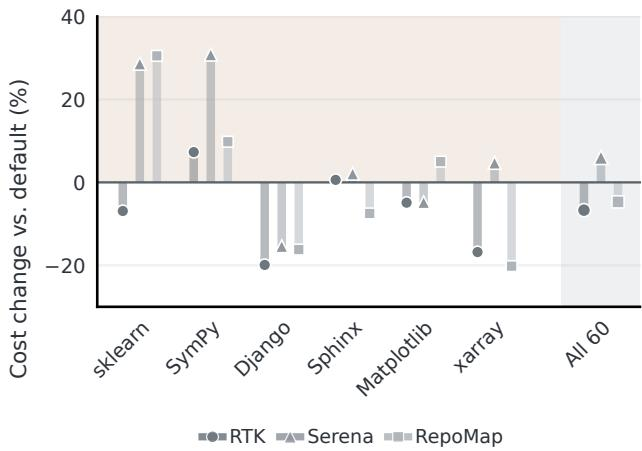
作者首先对六个仓库中的 60 个 SWE-Bench 任务进行剖析,发现 RTK、Serena 和 RepoMap 等固定策略在仓库层面带来的成本变化好坏参半,这促使采用自适应学习式控制。随后,他们在五个 agent 模型设置、277 个 SWE-Bench 任务,以及 Web-Bench 和两个安全基准上评估 TokenEconomizer,并与默认执行、降低推理力度和固定策略进行比较。TokenEconomizer 一致地降低了缓存感知成本,同时大体上保持或提高 Pass@1;节省在若干任务后逐步累积,消融分析表明大部分收益来自工具剪枝和微技能注入。泛化结果在 Web-Bench 和 CredData 上显示显著节省,在 ReposVul 上节省较小但一致,表明收益随可复用结构和成本降低空间而有所不同。
RTK 和 RepoMap 等固定成本控制策略表现出不一致的成本影响,有时会提高成本,同时使得通过率接近默认水平。降低推理力度可以节省成本,但会一致地降低 Pass@1。TokenEconomizer 在各类设置和仓库单元中提供一致的成本降低,同时通常保持或提高通过率,其变体定义了保持通过率的 Pareto 前沿。降低推理力度可带来较大成本节省,但在每种设置中都降低了 Pass@1。RTK 和 RepoMap 产生好坏参半的成本变化,各自在许多仓库设置单元中增加了成本。仅 TokenEconomizer 就能在每个仓库设置单元中降低成本,同时在大多数设置中保持或提高通过率。无论是否与 RTK 或 RepoMap 结合,TokenEconomizer 变体覆盖了所有保持通过率的 Pareto 前沿点。
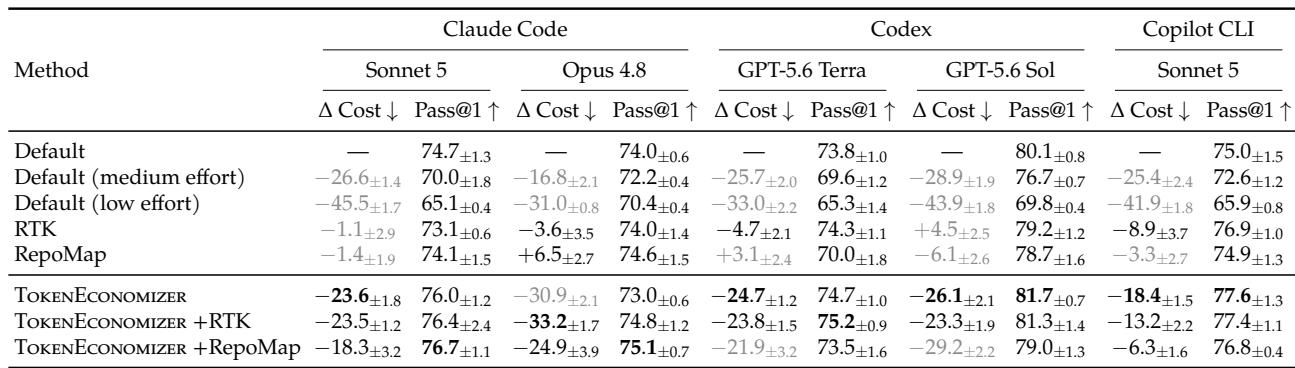
在所报告的 SWE-Bench 运行中,组合的元策略栈相对于默认执行实现了显著的成本节省,同时使 Pass@1 接近或略高于基线。工具剪枝和微技能注入提供了最大的单项节省,所有单策略变体都将通过率保持在默认水平的几个百分点以内。节省可以泛化到其他任务结构,但其规模取决于可复用的流程和可用的成本降低空间。将微技能注入、工具剪枝和失败循环防护结合,可实现最大的 SWE-Bench 成本降低,同时使 Pass@1 等于或略高于默认水平。工具剪枝和微技能注入是最大的单一贡献者,两者都带来两位数的节省,而失败循环防护则带来较小的个位数节省。每个单独的元策略都将 SWE-Bench Pass@1 保持在默认水平的 3 个百分点以内,因此成本降低并非来自大幅牺牲质量。自适应控制变体占据维持或提高默认通过率的 Pareto 前沿点,而降低推理力度则以较大的节省换取明显的通过率损失。节省在 Web-Bench 和 CredData 上具有泛化性,但在 ReposVul 上要小得多,因为较短的轨迹留下较少的可移除成本。
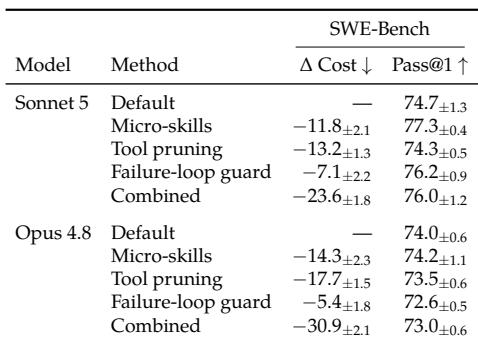
第一组实验评估了固定成本控制方法、降低推理力度和 TokenEconomizer,发现只有 TokenEconomizer 能在不同设置中一致地降低成本,同时保持或提高通过率;RTK 和 RepoMap 的成本影响不一致,降低推理力度通常会降低 Pass@1。第二组实验在 SWE-Bench 和泛化任务上评估组合的元策略栈,表明微技能注入、工具剪枝和失败循环防护共同带来显著成本节省,同时使 Pass@1 接近或略高于默认水平,其中工具剪枝和微技能注入是最大贡献者。自适应控制变体占据保持通过率的 Pareto 前沿,而降低推理力度以明显通过率损失换取更大节省;节省在 Web-Bench 和 CredData 上具有泛化性,但在 ReposVul 上较小,原因是轨迹较短。