Command Palette
Search for a command to run...
GPT-6-Astra 是否已实现具身智能?
GPT-6-Astra 是否已实现具身智能?
摘要
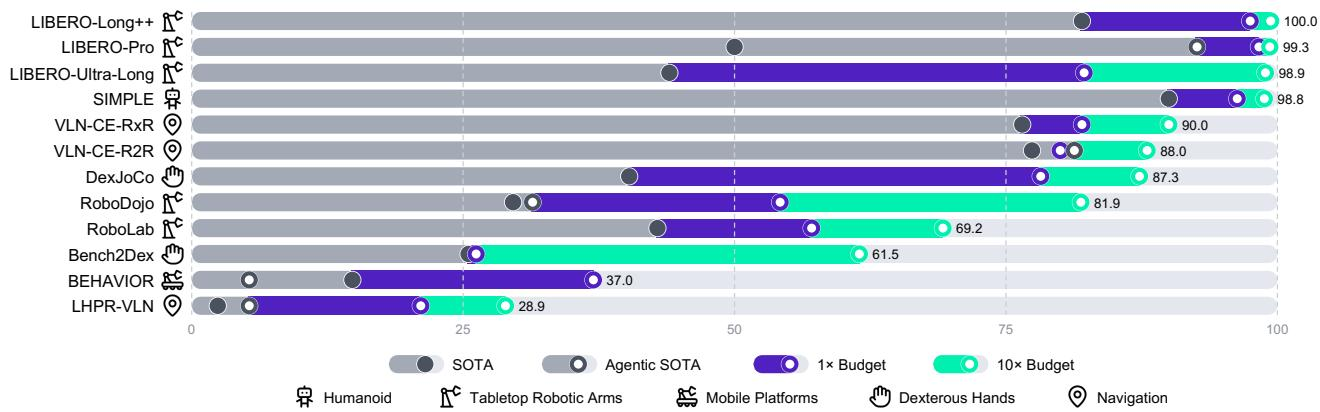
GPT-6-Astra 在机器人操作与导航中展现出的能力水平,对为具体任务和具身形态构建专用模型的传统范式提出了挑战。在本报告中,我们不仅探讨 GPT-6-Astra 本身的能力有多强,而且探讨这些能力对该领域意味着什么。首先,我们探究独立运行的 GPT-6-Astra 的能力边界。我们在 12 个代表性基准上开展了大规模评估,涵盖桌面操作、人形机器人、移动平台和灵巧手。在允许利用训练集演示进行上下文学习(ICL)并大幅增加执行步数的统一协议下,GPT-6-Astra 取得了前所未有的性能(图 1)。我们的分析表明,未来研究应更加关注以下方面的改进:1)上下文学习的通用性;2)成本与执行时间;3)物理状态验证;4)从不可逆失败中恢复;5)长时程进展保持。其次,我们研究了用于具身控制的智能体控制框架。除探索理想的动作表示和分块参数之外,我们发现,高层“System 2”推理器(即 GPT-6-Astra)与低层“System 1”控制器(例如,π0.5)之间的闭环协调虽然成本高昂但行之有效。第三,我们考察了 GPT-6-Astra 在真实世界部署中的表现。我们在 8 种机器人配置上的实验揭示了显著差距:1)上下文学习所需的机器人演示采集成本高昂;2)在物理约束下,以更长执行时间换取更高成功率并不可行。第四,我们展望了下一代具身智能基准。我们开发了一个原型,其 1)从现实世界需求而非当前机器人能力出发推导任务;2)不提供领域内演示;3)以一个在智能体思考期间持续运行的世界时钟来评判智能体。综合而言,我们的结果表明,GPT-6-Astra 已在很大程度上跨越了具身能力的门槛,但尚未跨越实用具身智能的门槛。剩余的关键挑战在于将基准测试中的成功转化为可靠、高效且可扩展的真实世界部署。
一句话总结
联合研究团队报告称,GPT-6-Astra 采用统一的上下文学习协议,在 12 个代表性基准和 8 种机器人配置上以更长执行时间运行,取得了前所未有的具身能力;而协调 GPT-6-Astra 与低层控制器 (e.g.,π0.5) 的闭环 System 2/System 1 框架虽然有效但成本高昂,实用的具身智能仍未解决。
核心贡献
-
论文对 GPT-6-Astra 在 12 个具身基准上进行了大规模评估,覆盖桌面操作、人形机器人、移动平台和灵巧手,采用统一协议,从训练演示中进行上下文学习,并提供显著更大的执行步数预算。结果显示前所未有的基准性能,并指出五个研究优先事项:上下文学习通用性、执行成本、物理状态验证、从不可逆失败中恢复以及长时程进度保持。
-
论文提出并分析了一种用于具身控制的 agentic 框架,其中高层 System 2 推理器与低层 System 1 控制器(例如 π0.5)协调,并考察动作表示和分块参数。实验表明,这种闭环协调虽然成本高昂,但能有效将通用模型适配到机器人动作接口。
-
在 8 种机器人配置上的真实部署研究发现两个差距:用于上下文学习的轨迹演示采集成本高昂,而在物理约束下用更长执行时间换取更高成功率并不现实。论文还提出了一个下一代基准原型,基于三个原则:任务源于现实需求;不提供领域内演示;agent 在持续运行的世界时钟下接受评判,包括思考时间及其物理后果。
引言
具身智能传统上依赖专用模型,例如用于机器人操作和导航的视觉-语言-动作策略和世界-动作模型。GPT-6-Astra 这一具备零样本泛化、上下文学习和失败恢复能力的通用模型的出现改变了这一格局,并促使领域重新评估通用具身能力的含义。现有具身基准大多为模仿训练策略设计,通常提供领域内演示和步数预算,可能扭曲性能比较;而真实世界部署额外带来安全性、成本和时间约束。作者在 12 个基准上评估 GPT-6-Astra,分析框架设计的性能-成本权衡,在真实机器人上验证其发现,并提出下一代具身基准的原则。
数据集
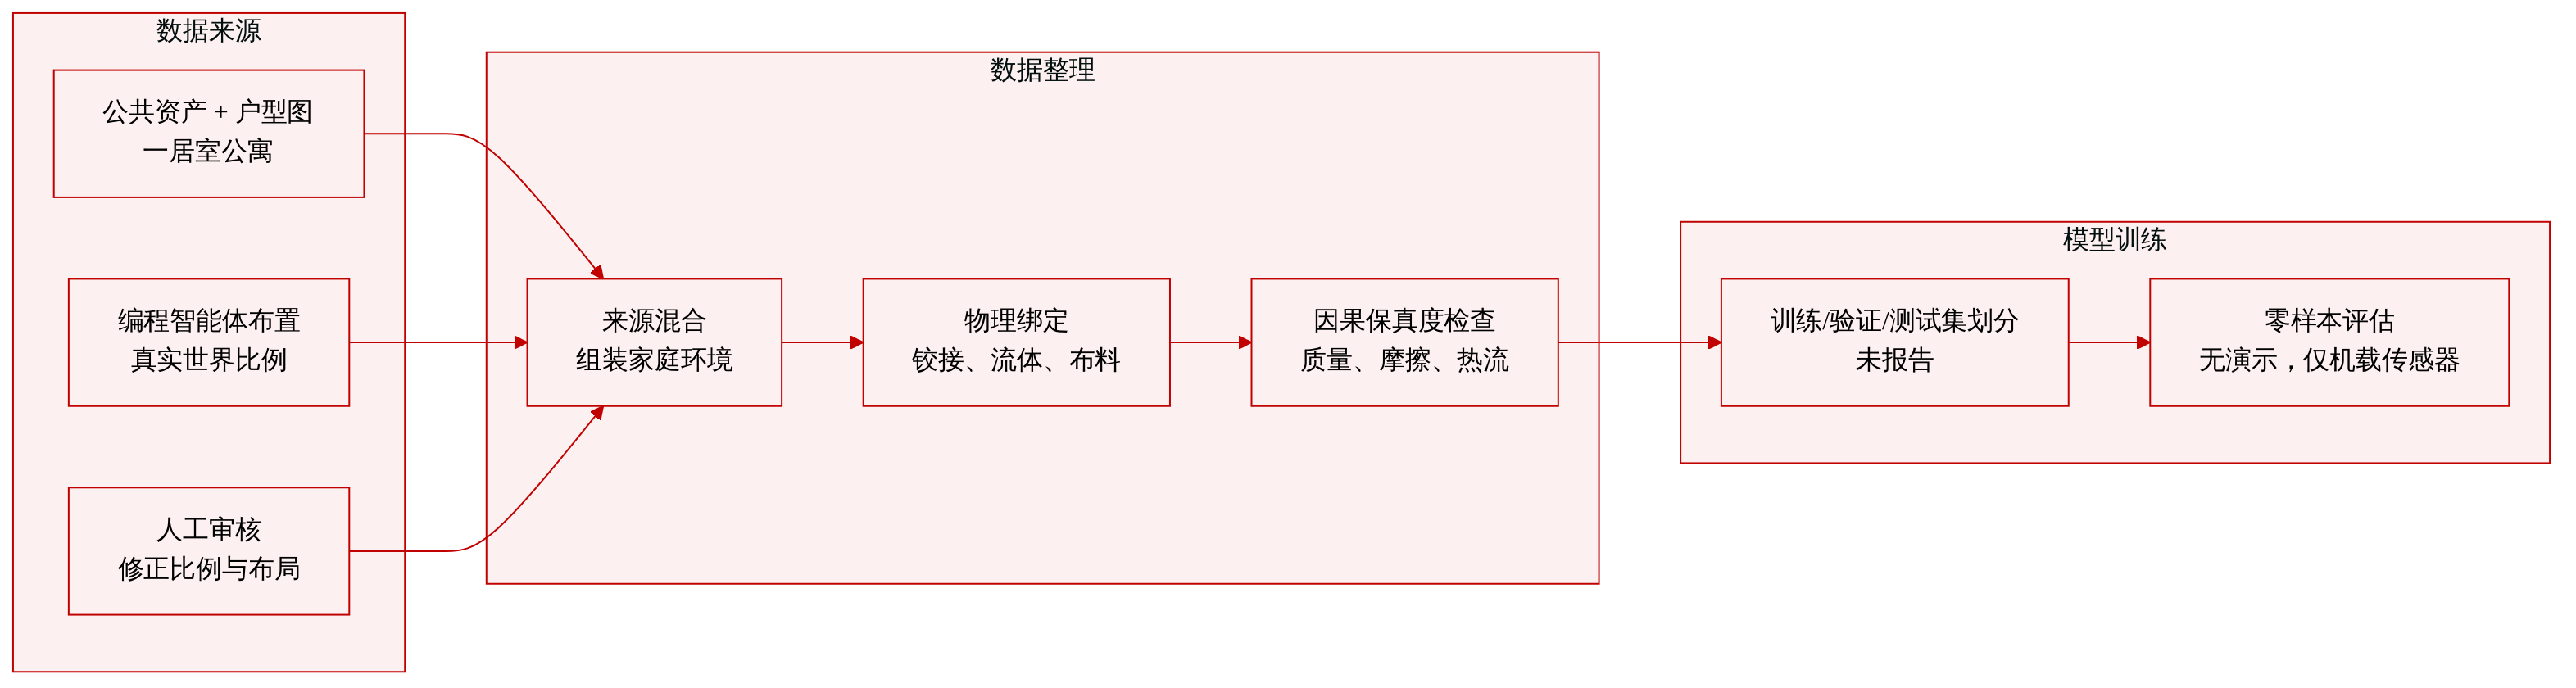
文本描述的是一个定性具身基准概念验证,而非包含训练划分或各子集规模的常规数据集。
数据集构成与来源
- 环境是 NVIDIA Isaac Sim 中构建的一个全交互式一居室公寓。
- 它由公开可用的资产和平面图组装而成。
- coding agents 以真实世界尺度布置公寓,并经过人工审核。
- 每个部分都与物理绑定,包括关节、接触、基于位置的流体、布料以及日常加热/烹饪过程。
各子集的关键细节
- 没有报告明确的子集规模、类别分布或数据集统计信息。
- 该基准提供两类信息:家庭环境和以人类需求表述的任务。
- 任务不是 PDDL/BDDL 目标公式;例如包括在住户离开前做好早餐。
- 该基准不提供领域内训练片段或场景特定演示。
筛选与评测规则
- 成功是在世界时钟上根据整个轨迹判断,而不仅看最终状态。
- 判定谓词定义在物理量上,并对 agent 保密。
- 义务可能未被明确说明,并可能有截止时间。
- 在 agent 推理时世界持续运行;从观测到下一命令之间的时间按上一命令计费,而宿主仿真和渲染时间不计费。
论文如何使用这些数据
- 该环境用于 GPT-6-Astra 通过 AgiBot G2 自身接口控制该机器人的零样本评估。
- 策略只能看到机载摄像头和本体感觉。
- 模型不接收演示,仅接收对具身形态的描述。
- 训练划分和混合比例不适用,因为这是评测设置而非训练语料。
处理与元数据构建
- 构建流程可复现:资产和平面图构成住宅,coding agents 进行布置,人工审核确保真实世界尺度。
- 仿真为因果保真而构建:质量、摩擦和热流等物理量以因果方式仿真,并以真实世界参考为依据。
- 文本未说明此概念验证的裁剪策略或元数据模式细节。
方法
作者利用上下文学习(ICL)使 GPT-6-Astra 在多样化具身基准上取得强性能,而无需更新模型权重。通过让模型研究可用训练数据并构建一个冻结知识包,系统可以在测试时将资源检索并适配到当前场景。该方法带来显著提升,在标准预算下大多数设置中匹配或超过已发表的最强结果。12 个基准的性能对比如下所示:
该方法的核心是结构化知识包的构建与使用。在 ICL 准备阶段,GPT-6-Astra 独立检查并保留每个基准允许的训练数据和工具接口中的信息。尽管具体内容因基准而异,作者观察到每个知识包都一致围绕六个反复出现的组件组织。知识包的结构及其在测试片段中的使用如下图所示:
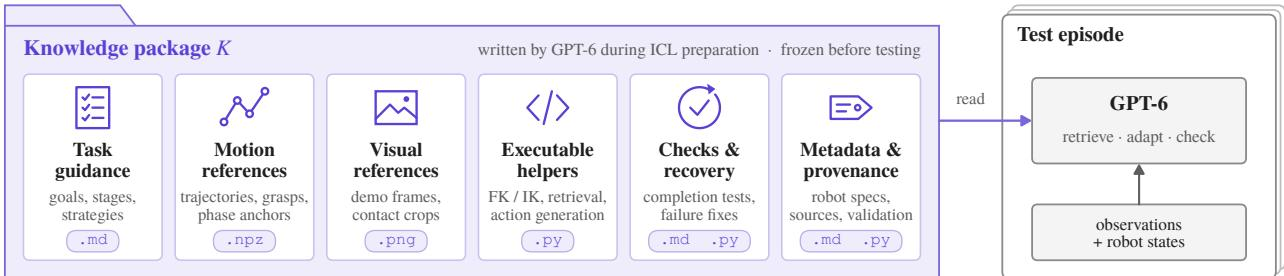
这六个组件构成了任务执行的完整框架。任务指导提供书面说明,详述任务目标、执行阶段和策略,规定子任务顺序和约束。运动参考包括从演示派生的轨迹、抓取配置和阶段锚点,提供动作执行的数值示例。视觉参考包括选定的演示帧和接触裁剪,用来说明物体外观和中间任务状态。可执行 helper 是可复用的 Python 程序,支持正运动学、逆运动学、参考检索和动作生成。检查与恢复流程定义完成测试,并将失败症状与纠正动作关联。最后,元数据和来源记录机器人规格、接口约定以及保留材料的来源。
在测试片段中,模型读取该知识包以及当前观测和机器人状态。GPT-6-Astra 不是简单回放演示,而是通过准备好的 helper 检索相关候选动作,将其适配到当前场景,并根据视觉参考检查执行情况。该工作流使系统能够在反馈下提出、调整和修订动作,有效利用存储资源实现鲁棒控制。
实验
实验在 12 个具身设置上评估 GPT-6-Astra,采用统一的固定权重协议,从训练演示提供上下文学习,并为恢复提供扩展的交互预算。当演示覆盖被测试任务时,上下文学习带来广泛收益,额外交互对操作类基准的帮助大于长程导航;局限性包括任务特定知识包、高推理成本,以及验证和恢复中的失败。框架消融实验确认,闭环 System 2 监督和自适应动作分块能以提高 token 成本为代价改善任务性能;真实世界和家庭环境验证显示可靠的刚性操作,但在精确接触、可变形物体、长程任务、全局场景感知以及时间压力下行动方面仍存在持续弱点。
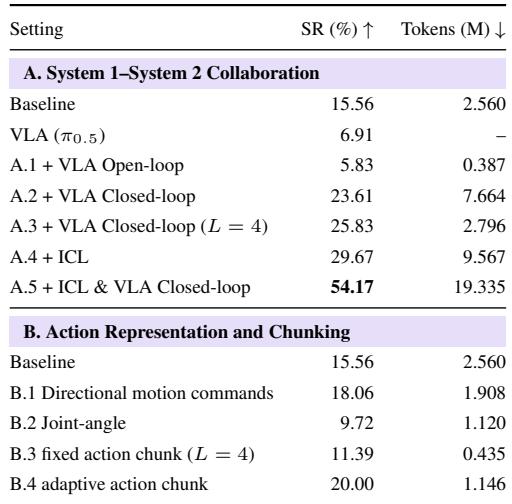
在 RoboDojo 上,System 1-System 2 协作基线优于单独使用 VLA,增加闭环 VLA 接口可进一步提高成功率,而开环 VLA 接口则使其低于前两者。L=4 闭环变体在保持更高成功率的同时,token 成本接近基线;上下文学习获得最高成功率,但使用的 token 最多。闭环 VLA 协作将成功率提高到基线以上,而开环 VLA 则将其降低到基线以下且低于单独使用 VLA。与标准闭环设置相比,L=4 闭环配置降低了 token 成本,同时保持高于基线的成功率。在所报告的策略中,上下文学习实现了最高成功率,但产生的 token 成本也最高。
真实世界验证覆盖八个平台,按从简单到复杂的具身形态排序,涵盖五类,每类考察不同能力:单臂夹爪、双臂夹爪、灵巧手、轮式移动操作臂和人形机器人。在此零样本设置中,模型接收结构化人类先验作为上下文,而不是演示或蒸馏知识包。报告的真实世界片段显示,GPT-6-Astra 通常能正确决定要做什么,但在持续变化的世界中难以行动,倾向于重复无效动作,并依赖在思考期间已过时的观测。具身形态类别从简单到复杂排序,每类探究不同的研究问题。单臂夹爪平台测试仿真结果是否迁移到刚性、可变形和精确任务,如堆叠、折叠和插拔。双臂夹爪平台在更难的零样本任务上考察双臂协调,例如有序折叠和双臂保持。灵巧手通过抓取玩具和瓶子测试高自由度控制。轮式移动操作臂和人形机器人将评估扩展到房间尺度、长程任务以及行走与臂部控制的组合。定性真实世界证据表明,在持续变化的世界中,“决定做什么”与“执行该决定”之间存在差距。
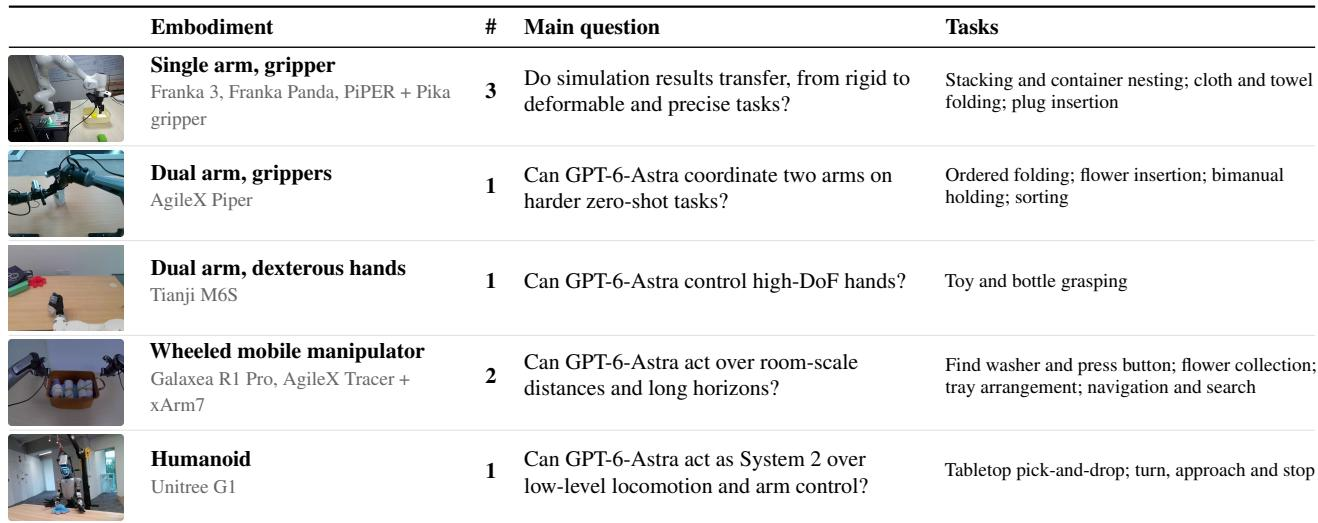
在 RoboDojo 上,System 1-System 2 协作基线优于单独使用 VLA,增加闭环 VLA 接口可进一步提高成功率,而开环接口会降低成功率;L=4 闭环配置在保持更高成功率的同时,token 成本接近基线;上下文学习实现最高成功率,但 token 消耗最高。真实世界零样本验证覆盖八个平台、五类具身形态,从单臂夹爪和双臂夹爪到灵巧手、轮式移动操作臂和人形机器人,使用结构化人类先验作为上下文而非演示。真实世界证据表明,在持续变化的世界中,“决定做什么”与“执行”之间存在差距,模型通常能选择正确动作,但难以有效执行。