Command Palette
Search for a command to run...
视觉生成能否扩展统一多模态模型的知识?
视觉生成能否扩展统一多模态模型的知识?
Wenkai Li Wenyi Hong Zhuoyi Yang Jie Tang
摘要
统一多模态模型(UMM)接收图像生成监督,使其接触到文本中未充分记录的视觉信息。学习生成图像能否扩展预训练模型所掌握的知识?我们提出 Knowledge Transfer Probing(KTP),这是一种受控协议,通过图像生成训练提供新知识,并通过纯文本问答测试其可访问性。在七个知识类别和三个 UMM 中,我们观察到从视觉监督到语言的直接但不均衡迁移。受这些观察结果启发,我们依次引入 Textual Alignment 和 Interleaved Image–Text Alignment,其中 Textual Alignment 通过共享知识、Interleaved Image–Text Alignment 通过交错响应,分别将图像生成与文本问答连接起来。对选定实体的引导无需 QA 监督即可改善对其他实体的知识访问,并且交错对齐可带来额外收益。进一步分析表明,在图像中正确复现的知识往往更容易通过文本获取,尽管两种访问方式之间仍存在显著差距。这些发现支持将视觉生成视为超越文本监督的知识来源,并促使人们联合研究训练数据设计与模型架构,以使这类知识更广泛地被获取。数据集与评测协议可在以下地址获取:https://github.com/kevinlllee/Knowledge-Transfer-Probing。
一句话总结
PhAI Labs、CUHK、密歇根大学和新加坡国立大学推出 DiscoveryRSI 和 DiscoveryRSI-27B,这些系统通过演化假设树、将选定的调查编译为可执行的 Harbor 任务,并借助假设信用优化、harness 重放和重新发现来改进工作流,从而递归地学习有价值且可测试的假设。DFM-Bench 在四个生命科学领域评估假设质量,结果显示自动评分从基座模型的 4.86 上升到两轮自我改进后的 5.39,并在可证伪性和数据可解决性方面有所提升。专家审查还显示,相对于 GPT-6 Luna,其重要性更高,且合理性更受证据约束。
核心贡献
-
该论文将有价值且可测试的研究假设定义为关于重要不确定性的证据支撑主张,每个假设都配有一个可行调查、明确决策标准和替代解释。该定义将假设生成与可观察量、证据约束以及科学评估所需的解释联系起来。
-
该论文提出 DiscoveryRSI,这是一个通过多 agent 演化搜索发展假设树、将选定调查编译为可执行 Harbor 任务,并通过假设信用优化、harness 重放和重新发现改进研究 agent 的框架。它将科学评估与已记录的研究贡献联系起来,并使用接受的改进来优化后续调查工作流。
-
该论文提出 DFM-Bench,用于评估跨假设、修订、发展路径和研究运行的假设质量和累积进展。结果显示,质量从基座模型的 4.86 上升到两轮自我改进后的 5.39,尤其在可证伪性和数据可解决性方面。在四个生命科学领域中,DiscoveryRSI-27B 在重要性、合理性和证据约束性方面获得高于 GPT-6 Luna 的专家评分,并且相对于模型截止日期后发表的研究达到 6.3% 的对应率,而 GPT-6 为 2.5%,Claude Opus 5 为 2.3%。
引言
科研发现 agent 可以帮助研究人员提出、测试和优化假设,但其有用性取决于能否将建议转化为可执行调查,并从这些调查的结果中学习。先前系统,例如 Co-Scientist、AI Scientist-v2、ScienceIDE 和 ScienceBuddy,支持假设生成、实验规划或工作流改进,但它们没有完全将研究评估连接到促成这些评估的具体行动。这具有挑战性,因为对假设的最终判断可能无法揭示哪一个建议、控制、修订或证据决策应当被强化。作者提出 DiscoveryRSI,这是一个将假设视为包含主张、调查计划、决策标准和替代解释的联合对象,然后通过多 agent 搜索演化这些假设,并将选定调查编译为可执行 Harbor 任务的框架。作者还提出 DFM-Bench 来评估假设质量和累积研究进展,并使用假设信用优化、harness 重放和重新发现从已记录的研究历史中学习,改进后续调查。
数据集
-
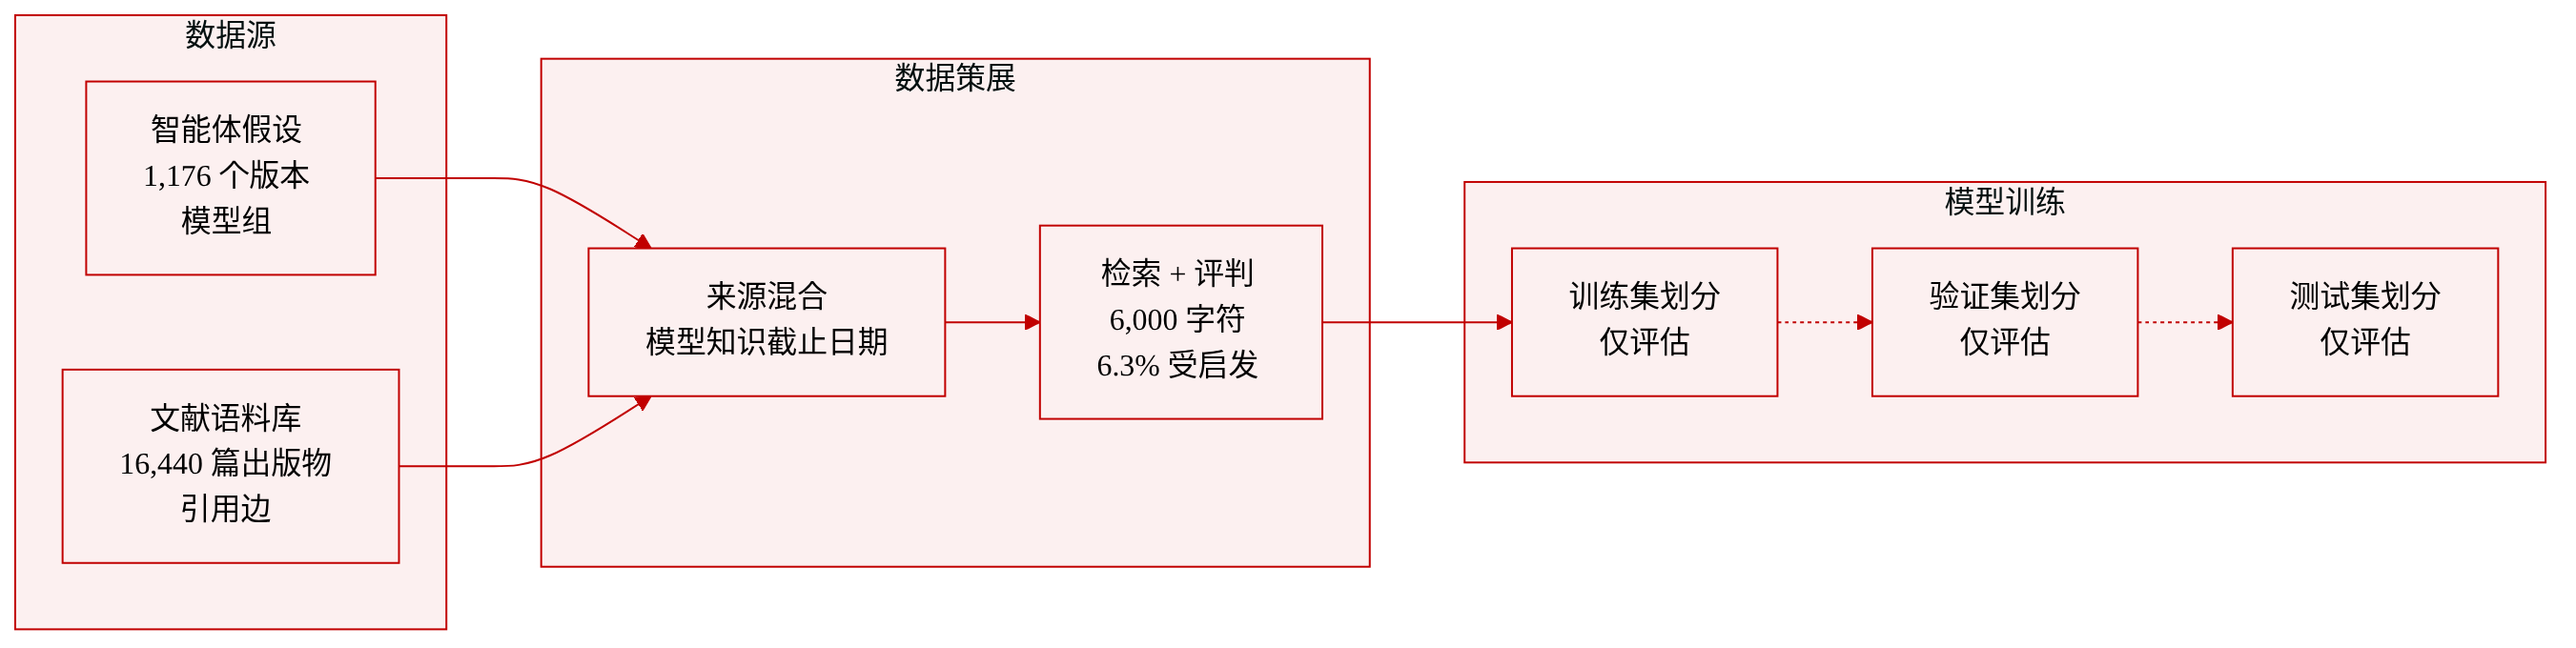
整体数据集作用:作者使用所描述的数据作为评估和分析语料库,而不是模型训练数据集。它用于判断科学质量、修订价值、发展路径进展、研究运行质量和后续科学贡献。
-
主要来源组件:数据集包含研究 agent 生成的假设记录、修订与发展路径记录、agent 行为历史、研究运行图、资源和机会记录,以及通过引文关联的外部文献语料库。
-
科学评估数据:
- 假设记录按重要性、新颖性、证据支撑、可证伪性、数据可解决性、可行性、替代解释和可操作性评分。
- 修订记录将每个假设与前序版本比较,并将变化标记为实质进展、必要修复、重复或证据不足。
- 发展路径记录遵循有序祖先关系,并跟踪证据获取、一致修订、科学连续性以及继续或停止决策。
- 研究运行记录覆盖完整研究图、选择决策、停止决策、探索广度和深度、跨分支综合以及预算分配。
- 贡献记录按科学问题分组建议,并标记证据是否增加了新区分、阴性结果、受支持的发现或不确定性降低。
-
模型生成的假设子集:
- 论文报告汇总的 DiscoveryRSI 生产运行包含 1,176 个假设版本。
- 其他模型组包括 DeepSeek 257 个假设版本,GLM 36 个,GPT 2,341 个,Claude 131 个。
- 这些子集用于比较对后续文献的启发,而不是模型拟合或基于混合的训练。
-
领域组成:
- 所评估的 DiscoveryRSI 输出涵盖治疗靶点、群体多组学、疾病机制、临床与人群健康。
- 论文报告领域层面的启发率,包括治疗靶点 16.9%,群体多组学 7.4%,疾病机制 6.8%,临床与人群健康 2.3%。
-
文献参考语料库:
- 作者使用 420 次向后和向前引文遍历构建共享参考语料库。
- 语料库产生 17,790 条引文边和 16,440 篇已解析出版物。
- 参考文献根据每个模型组记录的截止日期过滤。
- 只有当较晚出版物提供与开发或测试假设相关的实验设计、比较器、测量或可测试证据缺口时,才被判定为具有启发性。
-
启发评估数据:
- 启发集通过将生成的假设版本与检索到的出版物匹配构建。
- 启发率是生成假设版本中获得自动正面判断的比例。
- 在汇总的 DiscoveryRSI 集合中,1,176 个假设版本有 74 个被标记为具有启发性,即 6.3%。
- 报告的模型层面启发率为 DeepSeek 5.4%,GLM 2.8%,GPT 2.5%,Claude 2.3%。
-
检索和过滤规则:
- 评估按模型组应用截止过滤,因此只考虑相关截止日期之后的文献。
- 检索门控决定哪些建议进入后续自动判断。
- 对 Claude,131 个建议中有 15 个通过检索门控,即 11.5%。
- 对 DiscoveryRSI,1,176 个建议中有 355 个通过,即 30.2%。
- 在检索到的建议中,正面判断比例相似,Claude 为 20.0%,DiscoveryRSI 为 20.8%。
-
截断和文本处理策略:
- 检索作用于建议前 6,000 个字符。
- 语义审计作用于前 2,500 个字符。
- 论文指出 Claude 建议的中位长度为 41,134 个字符,因此出处和修订说明可能使科学内容处于所评估摘录之外。
- 一项使用建议标题作为查询的诊断将 Claude 的检索建议数从 15 提高到 95,同时保持语料库、评分方法、日期规则和重叠阈值固定。
-
元数据构建:
- 每个假设都与模型组、领域、截止日期、前序版本、祖先位置和支撑行为历史关联。
- 发展路径记录假设如何随时间变化。
- 研究运行记录选择、停止、探索、综合、预算分配和资源使用。
- 贡献按科学问题分组,并按成熟度注释,区分提出想法、由已完成调查和独立检查支持的发现。
-
在论文中的用途:
- 数据用于计算描述性和基准式质量分数。
- 提供的文本没有描述训练划分、混合比例或模型训练数据管线。
- 数据集支持五个层面的评估、假设到文献的启发匹配,以及检索敏感性的诊断分析。
方法
作者提出 DiscoveryRSI,这是一个将假设驱动研究转化为递归学习过程的通用框架。该方法的核心是有价值且可测试研究假设的联合操作定义,表示为 H=(c,π,d,a),其中 c 是证据支撑主张,π 是调查计划,d 规定决策标准,a 标识替代解释。如果解决其不确定性能够有意义地推进当前理解,假设即被视为有价值;如果调查计划在声明约束下可行,并产生能够支持、削弱或约束该主张的可观察结果,则被视为可测试。
如下图所示:
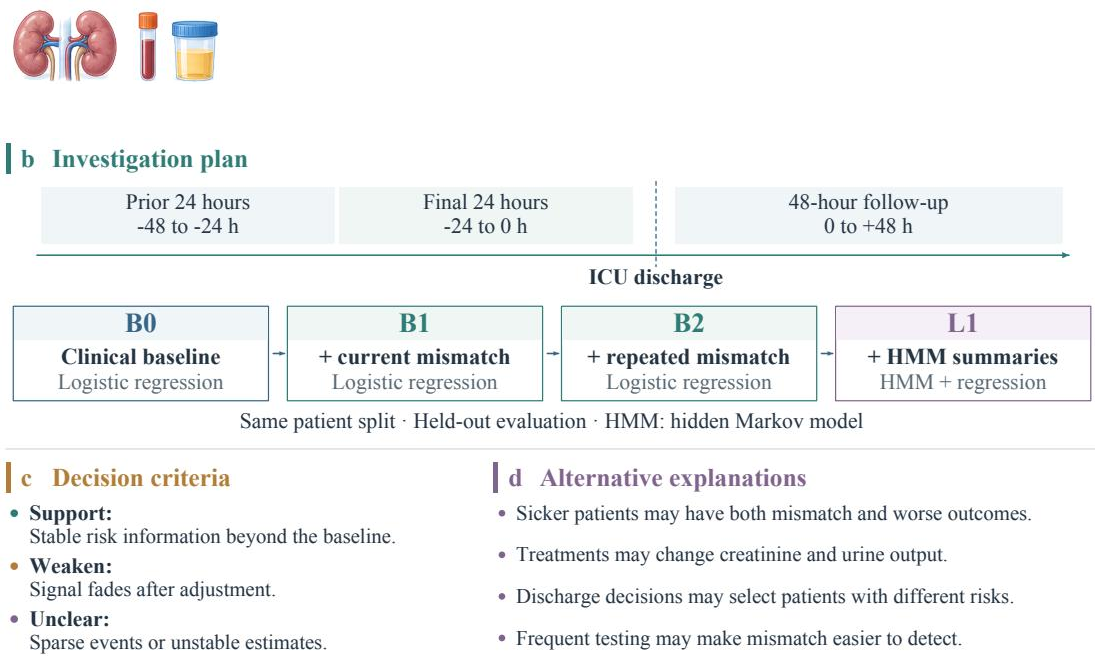
该操作定义通过结构化调查计划具体化,该计划界定时间范围、基线模型和评估协议。决策标准在结果解释之前明确规定哪些结果会支持或削弱该主张,而替代解释则标识必须区分的竞争性解释和混杂因素。
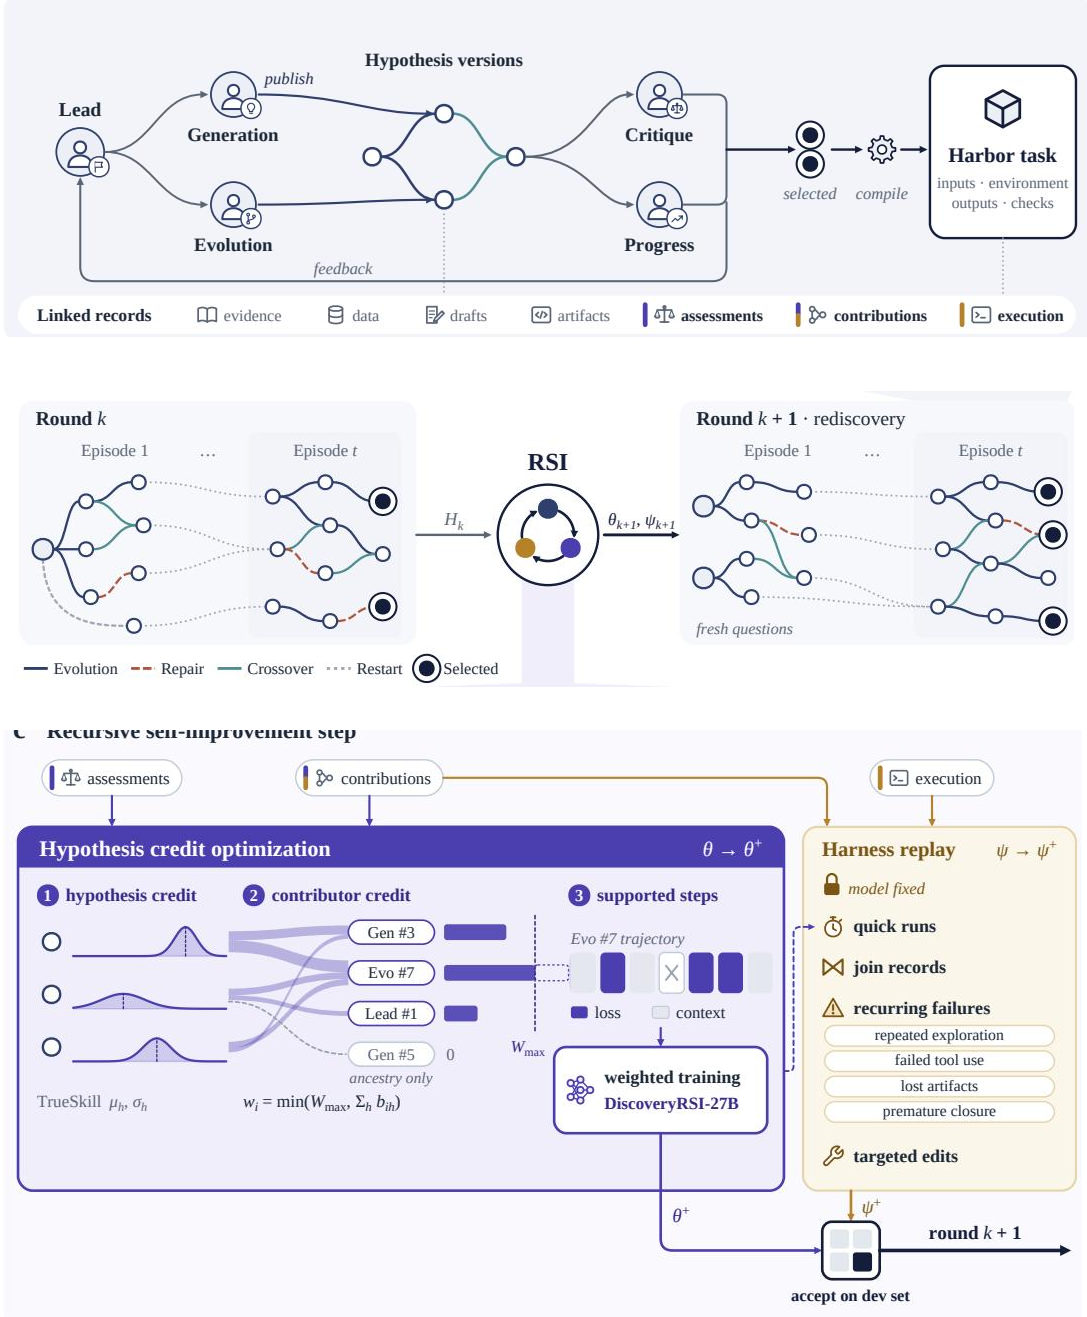
DiscoveryRSI 在多个 episode 中发展这些假设,并保留每个版本背后的工作,形成关联研究记录。该框架采用包含 Lead、Generation、Evolution、Critique 和 Progress 等角色的多 agent 演化搜索来生长研究树。随后,选定计算计划被编译为可执行 Harbor 任务,并保留原始假设的科学承诺。
框架核心是递归自我改进机制,它利用累积研究经验更新底层模型和研究工作流。
如下图所示:
递归自我改进步骤包含两个耦合机制:假设信用优化和 harness 重放。
假设信用优化将科学评估与已记录贡献关联,为模型训练提供监督。首先,使用 TrueSkill 模型评估假设,以估计其相对偏好强度和不确定性。得到的后验参数 (μh,σh) 描述比较性评估。然后,贡献者信用被分配给产生建议、提供支撑调查或作出协调决策的特定研究历史。历史 i 的累积信用计算如下:
wi=min(Wmax,h∑bih)其中 bih 是经过贡献者共享和重复抑制后来自假设 h 的分配。最后,通过强化这些获信历史中受支持的行动来训练模型。DiscoveryRSI-27B 的训练目标定义为:
L(θ)=−i∑∣Ui∣ωiu∈Ui∑logπθ(aiu∣xiu)其中 Ui 包含合格 assistant-token 位置,xiu 是记录的上下文,ωi 将贡献者信用与领域平衡结合。这确保历史权重分配给其支持目标,而不是每条消息。
harness 重放保持模型权重固定并改进研究工作流。通过分析 agent 贡献和决策记录并结合执行日志,系统诊断反复出现的失败,例如重复探索、工具调用失败或过早闭合。这些诊断推动有针对性的 harness 编辑。候选 harness 通过快速运行和匹配开发评估提出并评估,考虑科学质量、探索广度和可靠性。
最后阶段是重新发现,它将已接受模型和 harness 更新应用于新调查。令 θk+ 为假设信用优化得到的模型候选,ψk+ 为通过重放选择的 harness 候选。下一个周期的系统由以下决定:
(θk+1,ψk+1)=Acceptdev({θk,θk+}×{ψk,ψk+})随后,已接受系统回到新问题,收集新假设和证据,从而闭合递归学习循环。
实验
实验使用 DFM-Bench 和专家监督审查协议,在生物医学、临床和电池研究场景中评估 DiscoveryRSI,并结合自动判断、行为分析和基于文献的后续分析,以检查假设质量、研究行为、人类感知进展和下游启发。从研究历史中学习主要增强了可测试调查设计和证据规范,同时促使 agent 转向持续改进,而不是反复重启。人类审查者认可更有利的修订轨迹,尽管单个建议仍显示出混合设计质量和偶发重大缺陷。文献比较表明,一些生成的假设与具体未来研究方向对应,支持潜在科学效用,尽管前瞻性验证有限。
表格显示,DFM-Bench 明确覆盖假设优点、贡献成熟度、证据使用、修订、发展路径和整体运行分配,而现有基准只评估重叠子集。AgentIdeaBench 和 DiscoveryBench 提供最清晰科学评估信号,BLADE 和 ScienceAgentBench 主要处理证据使用,OEB 是研究过程维度中最接近的比较,但发展路径和整体运行分配仍属部分覆盖。DFM-Bench 是所列基准中唯一一个在全部六个比较维度上都具有明确评估的基准。现有基准更常评估证据使用,而不是修订、发展路径或整体运行分配。
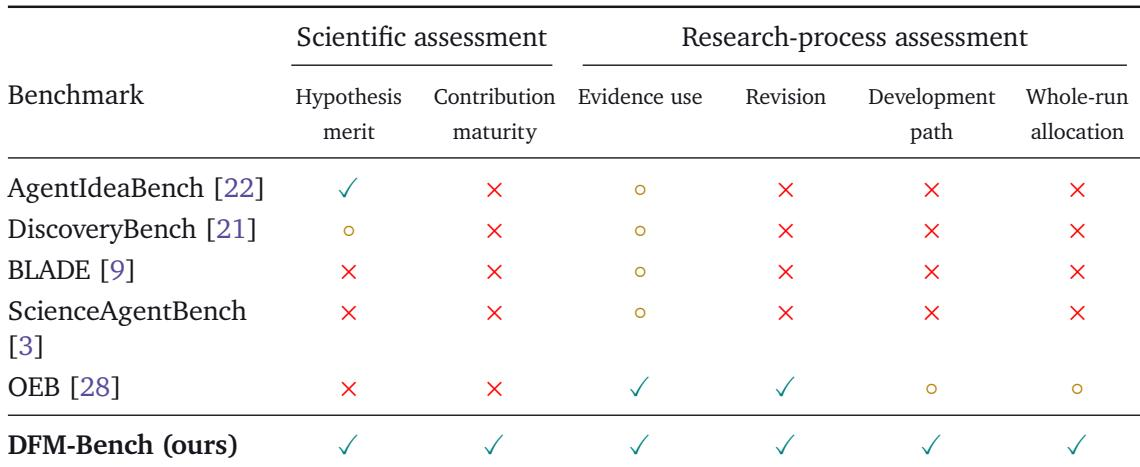
该比较在假设优点、贡献成熟度、证据使用、修订、发展路径和整体运行分配方面,将 DFM-Bench 与现有研究评估基准进行比较。结果表明,现有基准通常只覆盖部分子集,尤其侧重证据使用,而对修订、发展路径或整体运行分配关注有限。DFM-Bench 因在全部六个维度上都具有明确覆盖而被突出,表明科学研究过程评估得到更广泛验证。