Command Palette
Search for a command to run...
Fish Audio Drama 3 技术报告
Fish Audio Drama 3 技术报告
摘要
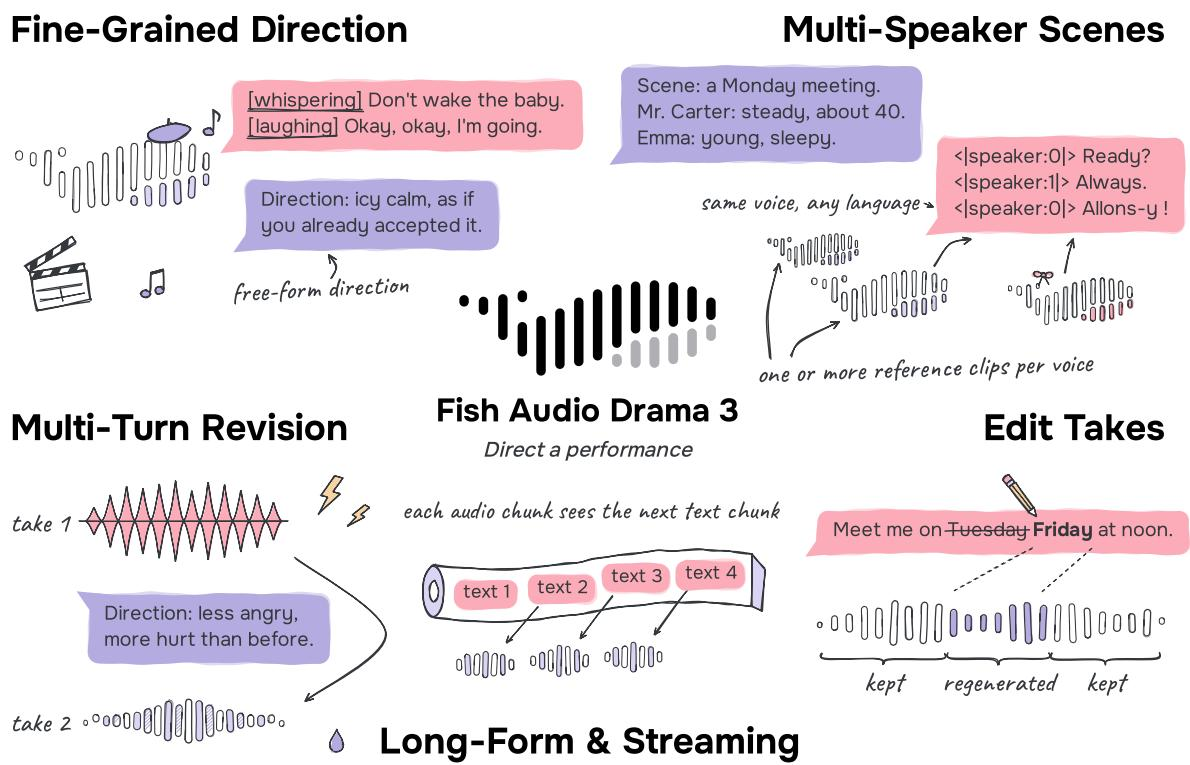
我们推出 Fish Audio Drama 3,一款开源语音生成模型,可将文本转化为受控语音表演,基于 35B 参数混合专家(MoE)骨干网络,每个 token 激活 3B 参数。它可从多个参考音频中克隆声音,遵循自然语言导演指令,在下一轮给出备注时修改某个 take,为多角色场景配音,通过填充式编辑已有语音,并合成长音频和流式音频。多轮修改、场景配音、填充式编辑和流式文本输入均为 Drama 3 的新增能力,并且全部集成在同一个模型中。Drama 3 将混合线性注意力骨干网络与一种新的码本多 token 预测音频解码器相结合,该解码器在专用层中预测每一帧的声学码本,这些层可对整个序列进行注意力计算。该模型使用三阶段预训练流程、指令微调和大批量强化学习进行训练,其中唯一的奖励信号来自一个学习得到的人类偏好模型。其推理引擎在单张 H200 上以每秒 271 帧的速度解码单条语音流,而 Fish Audio S2 为每秒 177 帧,尽管 Drama 3 的参数量超过 7 倍。模型权重已在 GitHub 和 Hugging Face 上发布,推理功能可通过 SGLang-Omni 提供。我们强烈建议读者访问 https://fish.audio 以指导自己的表演。
一句话总结
Fish Audio Team 的 Fish Audio Drama 3 是一款开源的 350 亿参数混合专家语音生成模型,面向可导演的文本到语音合成。它通过混合线性注意力主干、码本多 token 预测音频解码器和偏好强化训练,统一语音克隆、自然语言指令、修改、多角色配音、填充编辑和流式生成,实现高效、实时、可控的语音生成。
核心贡献
-
Fish Audio Drama 3 是基于 350 亿参数混合专家主干的开源语音生成模型,每个 token 激活 30 亿参数。它将混合线性注意力主干与码本多 token 预测音频解码器配对,解码器中的各层会对整个序列进行注意力计算,并采用三阶段预训练、指令微调和基于单一学习人类偏好奖励的强化学习。
-
该模型可在同一共享对话格式下处理多参考语音克隆、自然语言指令、多轮修改、多角色场景、填充编辑、长音频合成和流式合成。其服务引擎每帧只运行一次码本多 token 预测解码器,使用分块缩放 FP8 专家,移除 CUDA graphs 遗留的 kernel 启动,针对实时服务形状优化 kernel,将 prefill 与 decode 分离,并在单张 H200 上实现单流 271 帧/秒,而 Fish Audio S2 为 177 帧/秒。
-
评测表明,修改轮次在 Step-Audio-Edit 基准上提升了情感和风格准确率,在 MiniMax Multilingual Testset 的中文、荷兰语、英语、德语和土耳其语任务中,语音克隆错误率低于所比较的系统,并在 Ming-Freeform-Audio-Edit 基准的英语和中文任务中,错误率低于 Cartesia Sonic-3 的 infill API。模型权重已在 GitHub 和 Hugging Face 发布,并支持 SGLang-Omni 推理;Drama 3 被描述为按总参数量计算的最大开源权重专用语音生成模型。
引言
大规模文本转语音模型已在接近人类水平的清晰度和说话人相似度方面取得进展,但有声书、配音和交互式角色等真实应用需要可导演的表演,而不是简单朗读。作者基于 Fish Audio S2,即其先前具备内联自然语言指令和多说话人生成能力的模型,但指出该模型的全注意力主干在处理长会话时表现吃力,Fast AR 模块对参考音频的访问有限,控制方式为单次执行,局部编辑需要重新生成整段 take,而强化学习依赖词错误奖励和说话人相似度奖励,这可能会惩罚笑声、停顿和耳语。作者利用混合线性注意力混合专家主干和码本多 token 预测解码器,围绕可导演表演重新设计模型、任务形式和训练后目标。其主要贡献是 Fish Audio Drama 3,这是一款单一开源权重语音生成模型,支持多轮修改、场景配音、基于填充的编辑和流式文本合成,并使用学习的人类偏好奖励替代基于规则的奖励。
数据集
-
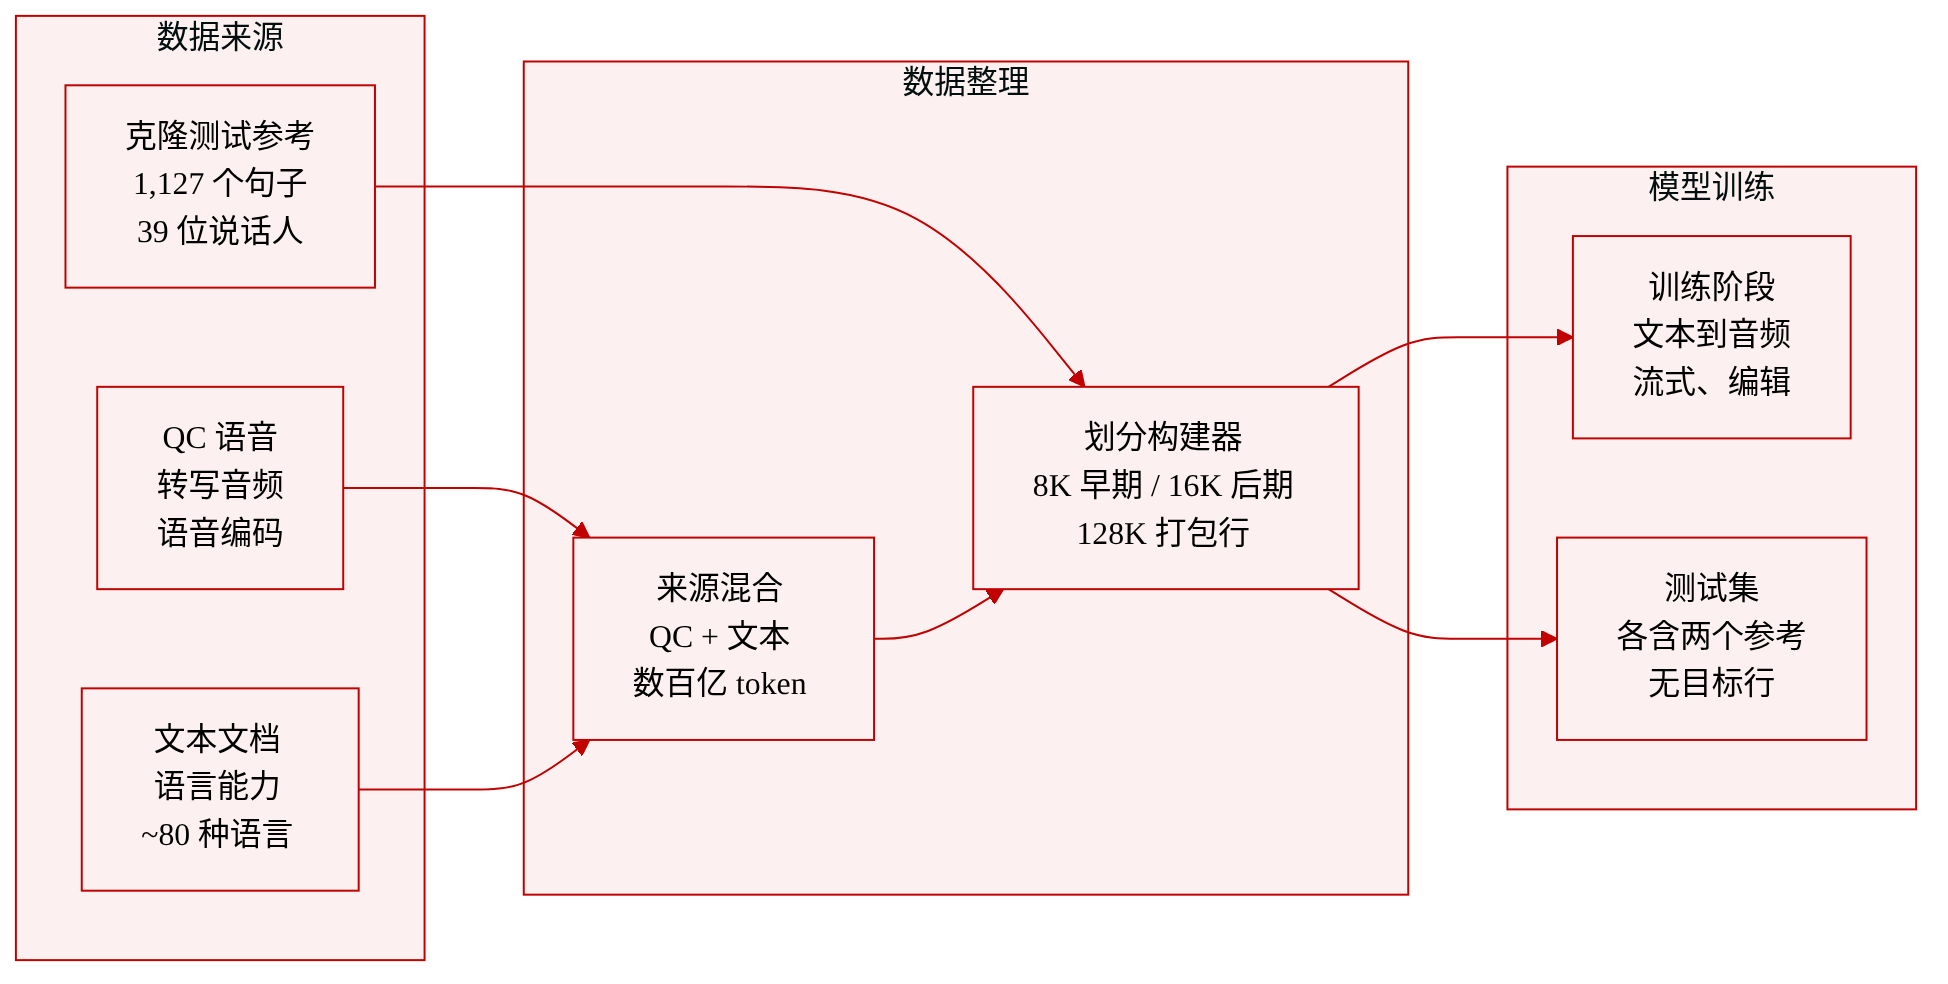
预训练数据来自两个主要来源:经过质量控制的转录语音和文本文档。
-
语音数据在使用前经过转录和质量控制,而文本文档用于保留模型的基础语言能力。
-
完整预训练语料库包含数千亿 tokens,并覆盖约 80 种语言和方言,沿用 S2 的语言覆盖范围。
-
早期阶段以文本文档和多轮 TTS 对话作为主要数据类型。这些序列被限制在最多 8K tokens,用于教导模型将文本映射为音频码。
-
后期阶段将数据扩展到完整录音、流式输入和语音编辑任务。序列长度限制增加到 16K tokens,数据组织方式支持从转录文本进行整段录音合成、逐行合成、流式交错和语音填充。
-
作者将带有文档掩码的样本打包为 128K tokens 的行,使文本样本和语音样本能够在同一训练批次中混合。
-
监督结构以 text tokens、行分隔符、segment 闭合 tokens 和语义音频码为目标。为解码器侧建模还包含较低层码本目标,因此数据模式同时体现文本和多码本语音表示。
-
在多参考零样本语音克隆评测中,作者扩展了来自 F5-TTS 的 LibriSpeech-PC test-clean 列表。基础集合包含来自 39 位说话人的 1,127 个句子。
-
每个目标说话人都补充两个额外参考片段,并筛选这些片段,使其绝不包含目标句子。
-
参考片段被格式化为独立的参考块,最终输出使用与 OmniVoice 相同的评测协议进行评分。
方法
Drama 3 架构面向高保真、富有表现力的语音合成而设计,采用自回归语言模型主干,并搭配一个处理声学细节的专用解码器。该系统处理交错排列的文本和音频 tokens,逐帧生成语音。
架构与模块设计
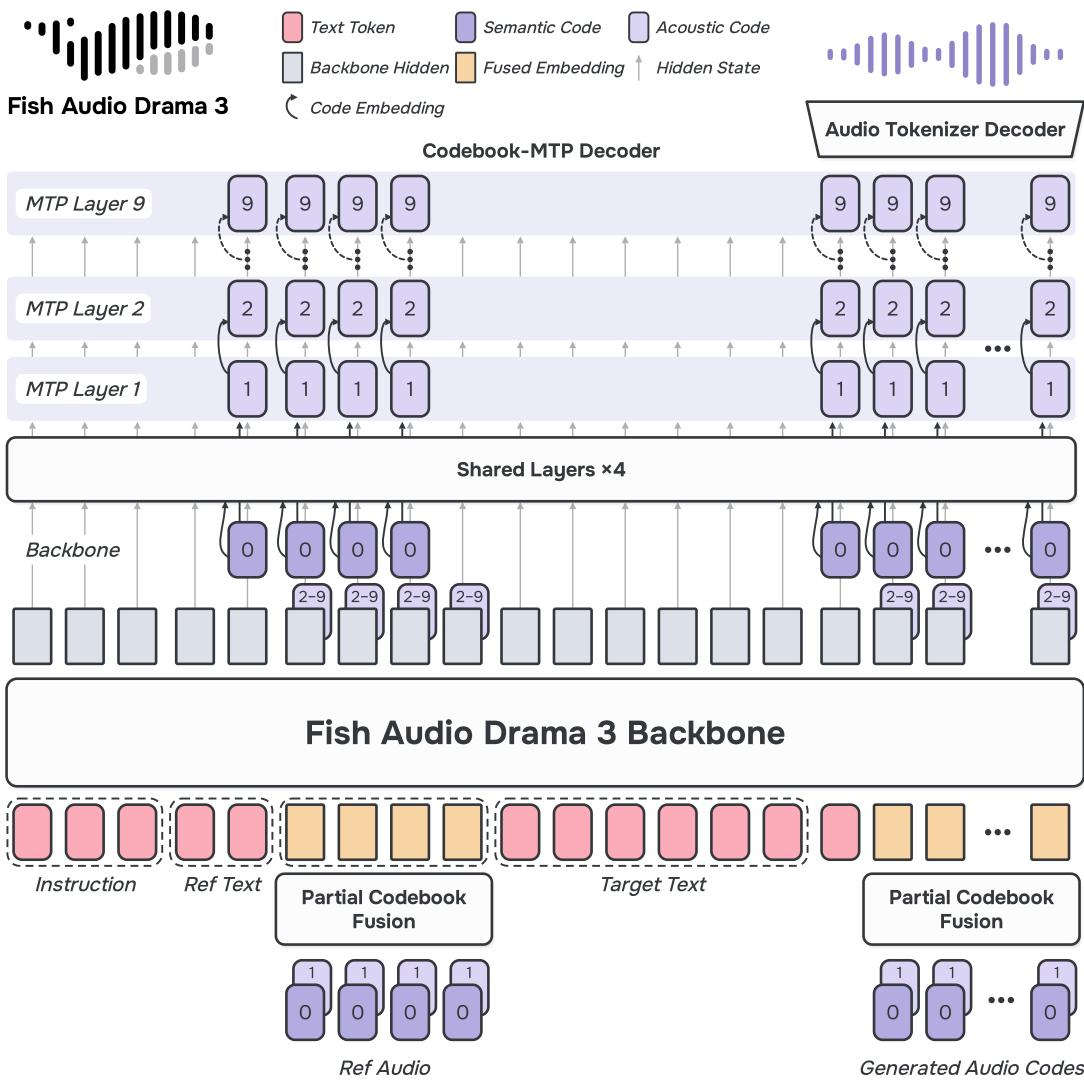
音频 Tokenizer 与主干 系统使用基于 Descript Audio Codec 的因果音频 Tokenizer,将 44.1 kHz 音频编码为约 21.5 帧/秒、每帧包含十个码本的帧。第一个码本表示语义内容,其余九个是残差向量量化器,提供逐级更细的声学细节。
主干由 Qwen3.5-35B-A3B 语言模型初始化。它采用适合长语音的混合线性注意力机制,将三个 Gated DeltaNet 层(以恒定大小状态维护历史)堆叠为块,并与一个门控全注意力层(在整个上下文范围内保留精确检索)组合。为控制计算成本,每一层都使用混合专家(MoE)前馈网络,将每个 token 路由到 256 个专家中的 8 个,每个 token 仅激活约 30 亿参数。
部分码本融合 与之前将所有十个码本都反馈回主干的设计不同,Drama 3 使用部分码本融合来限制 exposure bias。仅反馈语义码 (qt(0)) 和第一个声学码 (qt(1))。在音频帧 t 处,主干输入计算为:
xt=21(ELM[s(qt(0))]+E(1)[qt(1)])其中 ELM 是主干 token 嵌入,E(1) 是第一个声学码本的嵌入表。其余码 (qt(2) 至 qt(9)) 绕过主干,直接进入解码器。
Codebook-MTP 解码器 Codebook-MTP(Multi-Token Prediction)解码器取代了先前迭代中逐帧 Fast AR 设计。在位置 t,当主干预测下一帧的语义码 qt+1(0) 时,解码器在同一位置预测其余九个声学码 qt+1(1) 到 qt+1(9)。
解码器由 13 层组成:四个共享层,随后是九个按码本划分的层。
- 共享层:这些层将主干隐藏状态与预测的语义码以及输入帧的码 2 至 9 合并。这将主干状态、当前语义信息和继承的声学细节融合为单一表示。
- 按码本划分层:随后的九层分别预测一个特定声学码本。第 k 层接收前一层的隐藏状态,并注入第 k−1 层选择的码。
关键是,解码器中的每一层都会对整个序列(包括参考音频)进行因果注意力计算,从而使细粒度码能够基于完整上下文而不是摘要向量来预测。
参见框架图:
训练过程
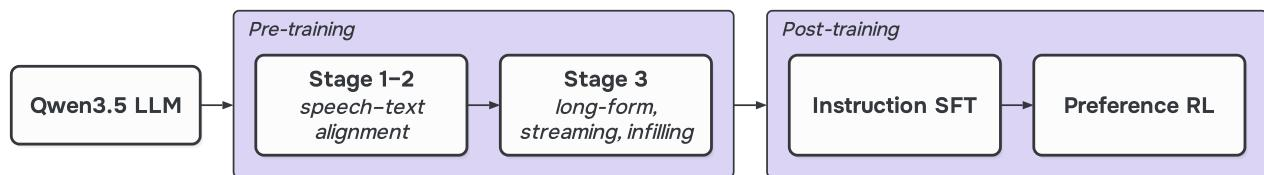
训练流程从预训练基础语言模型,到与语音任务对齐,再进行指令微调和强化学习。
预训练 模型使用转录语音和文本文档经历三个预训练阶段。
- 阶段 1 和 2:聚焦于语音-文本对齐,序列最长为 8K tokens。
- 阶段 3:将模型扩展到整段录音、流式输入和语音编辑,将最大序列长度提升到 16K tokens。
目标函数组合了文本损失、语义损失和码本损失:
L=Ltext+0.5Lsem+0.5Lcb其中 Ltext 是标准语言建模损失,Lsem 是语义码 qt(0) 的损失,Lcb 是九个声学码本上的平均损失。
指令 SFT 与强化学习 预训练后,模型在按 ChatML 风格格式化的指令上进行监督微调(SFT)。该阶段教导模型遵循指令、执行对话,并使用带索引的参考布局处理多说话人场景。
最后,使用 Group Relative Policy Optimization(GRPO)通过强化学习(RL)将模型与人类偏好对齐。一个单一奖励模型(RM)通过 Bradley-Terry loss 在人类偏好判断上训练,并对生成的 take 进行打分。RM 读取策略的 prompt 以及其后的音频 tokens,评估语音一致性和内容保真度,而不依赖可能惩罚表现力的外部 ASR 或说话人相似度指标。策略使用均值中心化优势进行优化:
Ai=Ri−G1j=1∑GRj其中 Ri 是 take i 相对于组内其他 take 的期望胜率。
如下图所示:
推理引擎优化
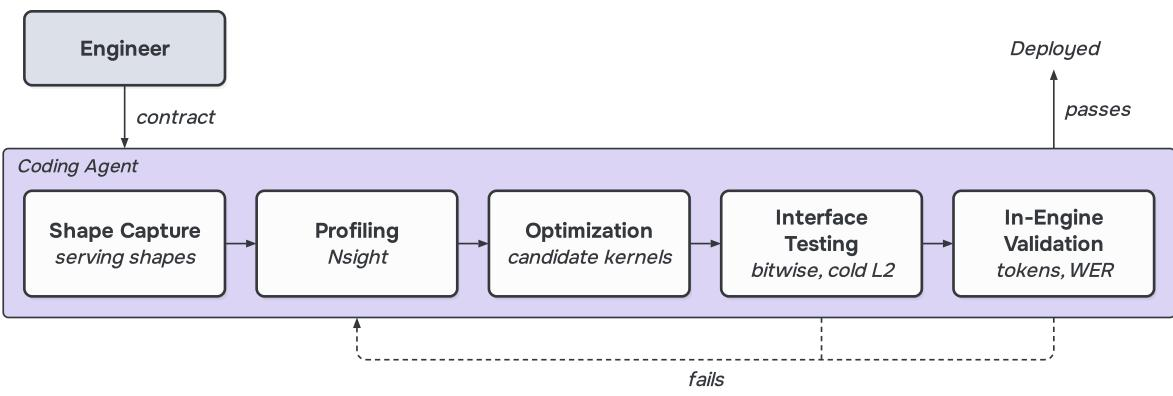
为支持实时流式推理,作者实现了形状驱动的 kernel 优化循环。通用 kernel 库对 TTS 服务中遇到的特定形状(例如小批次大小、细长矩阵)往往效率低下。优化过程循环执行五个步骤:从服务日志捕获形状、基于硬件 roofline 进行分析、编写候选 kernel、使用冷缓存进行接口测试,以及在引擎内进行验证。
该循环在工程师定义的严格约束下由编码 agent 执行。例如,Gated DeltaNet decode kernel 被优化以降低内存流量,MoE kernel 被开发为以分块缩放 FP8 运行,从而显著减少每帧读取的权重字节数,并提高单流解码速率。
参见框架图:
实验
实验在推理服务和公开语音基准上评测 Drama 3,使用基准特定参考音频、标准清晰度和说话人相似度协议,并重新生成无效输出。服务结果显示,更轻量的生成结构、FP8 专家以及 prefill 与 decode 分离,提升了流式吞吐量、容量和稳定性,同时不损害语音质量。定性发现也验证了该模型的单一模型设计:学习得到的偏好奖励更常遵循风格指令,并减少生成失败;同时,多参考克隆、多语言合成、流式生成、填充编辑和多轮修改都保持很强的语音质量和可控性。
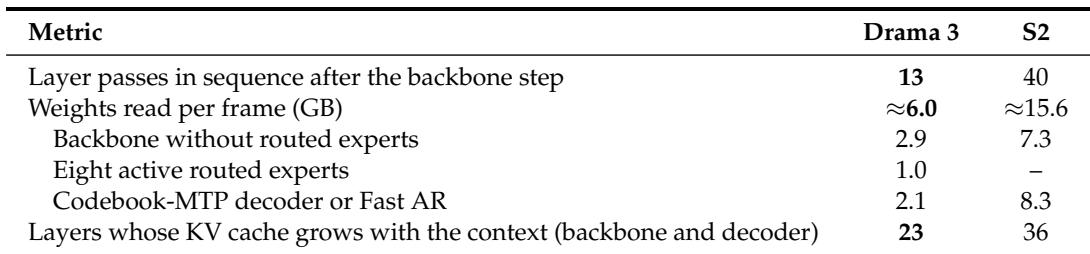
Drama 3 的每帧解码成本低于 S2,因为它使用更少的顺序层遍历,并且每帧只读取每个解码器权重一次。单遍 codebook-MTP 解码与 FP8 路由专家相结合,减少了数据移动字节数,从而在评测 GPU 上支持高于 S2 的帧率解码。Drama 3 在主干步骤后所需的顺序层遍历次数少于 S2。Drama 3 每帧读取的权重数据大幅减少,这得益于单遍解码和压缩专家存储。更低的内存流量使 Drama 3 在单流解码中相对 S2 获得帧率优势,并在更高并发下提升吞吐量。
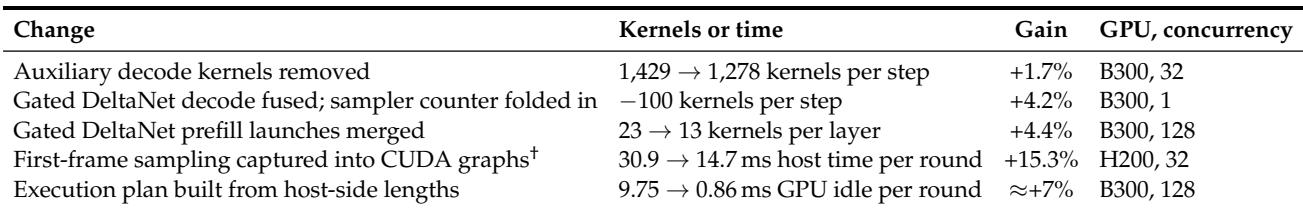
在 CUDA graphs 和 PDL 之下减少 kernel 启动,可通过移除辅助 kernel 并融合依赖操作来提高单流解码速率。报告中最大的收益来自将主机发起的首帧采样链捕获进 graph;同时,辅助 decode 清理、prefill launch 合并和主机端执行规划也提升了吞吐量。移除辅助 decode kernel 适度提高解码速率。融合 Gated DeltaNet decode 并折叠采样器状态提升吞吐量。合并 Gated DeltaNet prefill launch 降低每层开销。将首帧采样捕获进 graph 大幅削减主机端时间。主机端执行规划大幅减少 GPU 空闲时间。
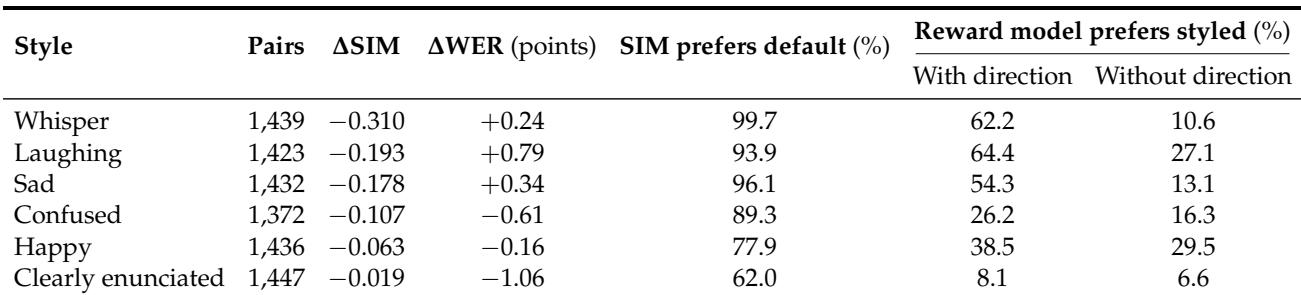
风格化相对每位说话人的默认朗读会降低说话人相似度,其中耳语和笑声的影响最强。它对转录错误的影响不一:在笑声情况下错误率增加,但在清晰发音朗读情况下错误率降低。学习得到的偏好奖励在风格作为指令提供时更常偏好风格化朗读;这与相似度评分不同,相似度评分通常偏好默认朗读。与默认朗读相比,耳语和笑声在说话人相似度上受到强烈贬低。为任意风格添加风格指令都会提高对风格化朗读的偏好。
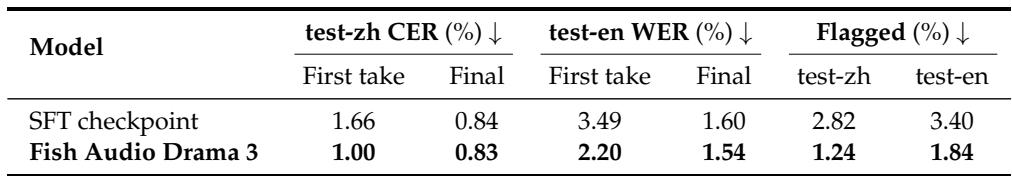
在中文和英文 Seed-TTS-Eval 评测中,Drama 3 的首次 take 和最终错误率均低于 SFT checkpoint。强化学习还减少被标记的 first take,表明通过信号检查失败的输出更少。当重新生成替换被标记的 take 后,Drama 3 仍保留轻微的错误率优势。与 SFT checkpoint 相比,Drama 3 同时改善 first take 和最终识别错误率。强化学习后,被标记的 first take 下降,即使没有转录奖励也是如此。重新生成被标记的 take 后,最终输出仍更优。
在零样本语音克隆中,为 Drama 3 提供多个参考片段可提升说话人相似度,同时保持词错误率和自然度不变。与引用的单参考系统相比,Drama 3 的 UTMOS 略高于两个基线,但单词准确率较低,并且与基准参考的相似度较低。使用多个参考会提升说话人相似度,但不改变词错误率或 UTMOS。使用单个参考时,Drama 3 在 UTMOS 上超过 OmniVoice 和 CosyVoice 3,但在词错误率和说话人相似度上落后于引用的系统。
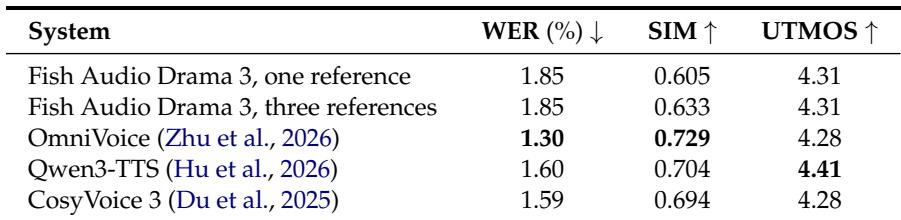
实验从效率、风格化、强化学习和零样本语音克隆等方面评测 Drama 3,验证其通过减少层遍历、单遍码本解码、FP8 专家和 kernel 启动优化获得更快的解码,并提升吞吐量。风格化会降低说话人相似度,尤其在耳语和笑声中,并对转录错误产生变化不一的影响;同时,风格指令会提高对风格化朗读的偏好。强化学习降低 first take 和最终识别错误,并减少信号检查失败;多个参考片段可在不影响单词准确率或自然度的情况下提升说话人相似度。