Command Palette
Search for a command to run...
面向长程工作智能体的可验证环境规模化
面向长程工作智能体的可验证环境规模化
摘要
工作智能体在数字工件上运行,以执行专业领域的知识密集型工作,需要支持长程交互和可信验证的训练环境。然而,手工构建的环境会产生高昂的工程开销,阻碍环境规模化;而合成方法则会牺牲工作区复杂度、真实性或基于证据的可验证性。为弥补这一缺口,我们提出 WORKFORGE,一种从现实资源构建可验证工作智能体环境的可扩展合成框架。WORKFORGE 首先从专家工作流出发,识别各工作流所需的资源、决策和交付物。随后,WORKFORGE 检索相关现实文件,并将其组织成工作区。WORKFORGE 检查工作区,提取关于其内容的具体且可检查的事实。这些事实锚点确定工作区可支持的任务类型及其结果验证方式。因此,WORKFORGE 直接从这些事实锚点推导每个任务的指令、解决方案计划,以及互补的程序化和语义验证器,使验证可追溯到可观测的工作区证据。此外,我们构建覆盖 40 个专业领域的 16.7K 个可验证环境,其工作区合计涵盖 60 种文件类型。对 Qwen3.5-35B-A3B-Base 进行后训练后,GDPval 从 45.5 提升至 73.6,APEX Score 从 5.0 提升至 21.3,同时使 Qwen3.5-27B 取得极具竞争力的表现,并超越强劲竞争对手。我们的分析证实了所提方法的有效性,并揭示了在数据量和交互跨度上的一致可扩展性表现。
一句话总结
腾讯与复旦大学提出 WORKFORGE,这是一个可扩展合成框架。它通过避免成本高昂的手工搭建或过度简化的合成设置,将专家工作流、检索到的真实世界文件以及由工作区派生的事实锚点转换为 16.7K 个可验证的 work agent 环境,覆盖 40 个专业领域和 60 种文件类型,使 Qwen3.5-35B-A3B-Base 在后续后训练中将 GDPval 从 45.5 提升到 73.6,并将 APEX Score 从 5.0 提升到 21.3,同时帮助 Qwen3.5-27B 取得高度有竞争力的结果。
核心贡献
-
WORKFORGE 被提出为一个可扩展框架,它利用真实世界资源构建可验证的 work agent 环境,具体方式是分析专家工作流、检索相关文件,并组织经过审计的工作区;这些工作区的可观察事实为任务规范、解决方案计划和验证标准提供锚点。它从这些事实锚点派生出每个任务的指令、计划以及相互补充的程序化验证器和语义验证器,使验证始终与工作区证据绑定。
-
该框架实例化了 16.7K 个可验证环境,覆盖 40 个专业领域,工作区共同覆盖 60 种文件类型和丰富的跨文件依赖关系。这些环境支持长时程交互,并为 agent 后训练提供监督。
-
在所得轨迹上微调 Qwen3.5-35B-A3B-Base,使 GDPval 从 45.5 提升到 73.6,使 APEX 从 5.0 提升到 21.3,覆盖五个基准;同时 Qwen3.5-27B 达到有竞争力的性能。受控分析显示,随着数据量和交互时程增加,性能增益持续存在。
引言
自主 agent 正在将大语言模型从对话式助手推向能够跨文件和工具完成专业工作流的数字工作者。这一转变很重要,因为真实交付物依赖包含复杂文件依赖关系的真实工作区,因此训练环境必须暴露真实摩擦并给出可验证反馈。以往环境合成常常依赖合成或模拟资源,由此产生的玩具工作区多样性有限,跨文件关系也有限;缺乏依据的评估还可能引入幻觉或无依据的要求。本文提出 WORKFORGE,这是一个可扩展框架,通过把任务规范和验证器评分细则锚定在可观察的工作区事实上,从真实世界数字资源构建可验证的 work agent 环境。作者将专家工作流作为蓝图,检索并分析真实资源以恢复文件角色、依赖关系和事实锚点,然后生成任务,并生成程序化和语义检查,用于可靠的轨迹采集。该框架生成覆盖 40 个领域的 16.7K 个环境;在轨迹上微调 Qwen3.5-35B-A3B-Base 可提升多个 agent 基准上的性能。
数据集
-
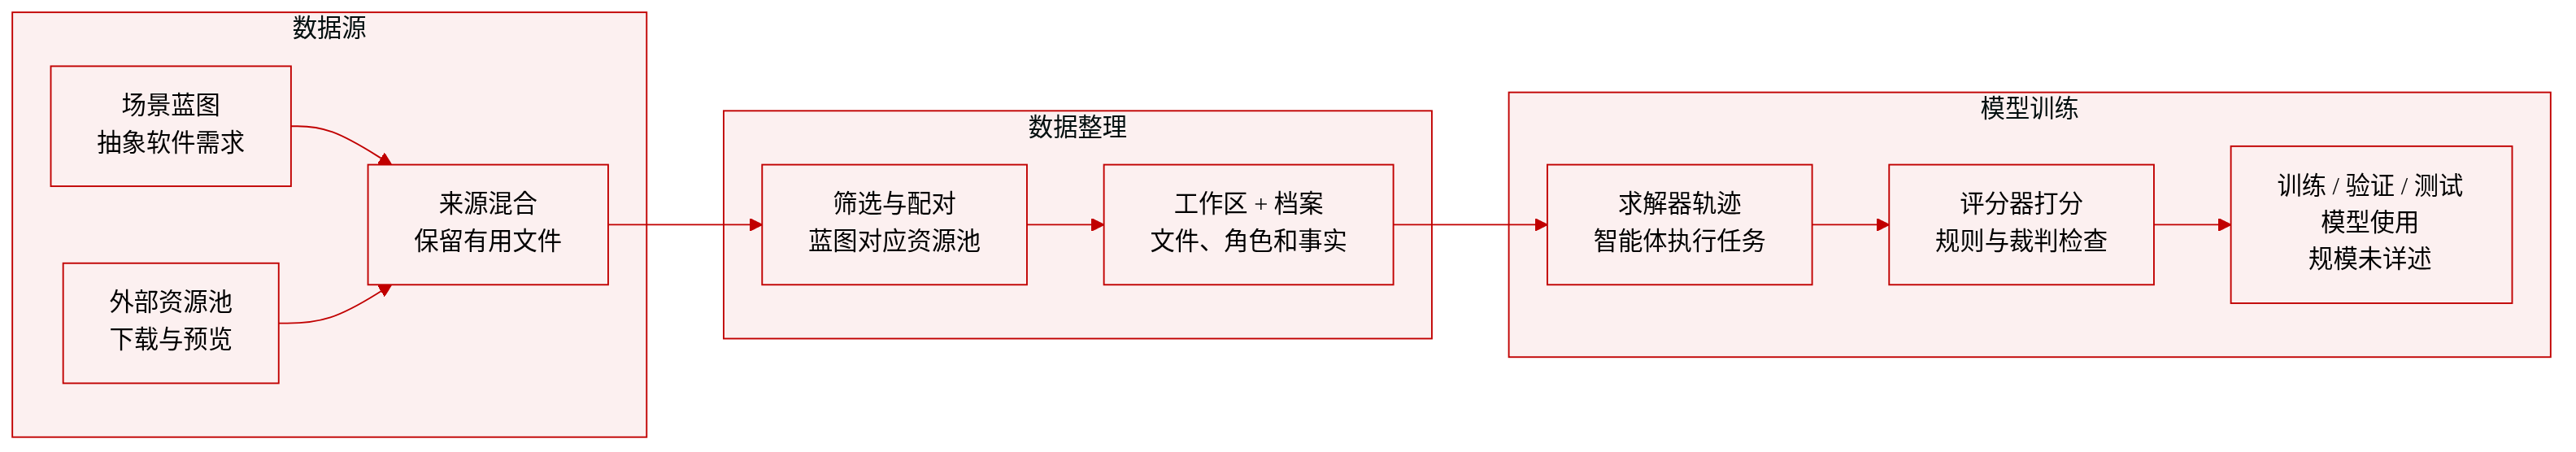
作者描述了一个由场景蓝图构建的合成 agent 数据集,场景蓝图被扩展为具体软件工作区。
-
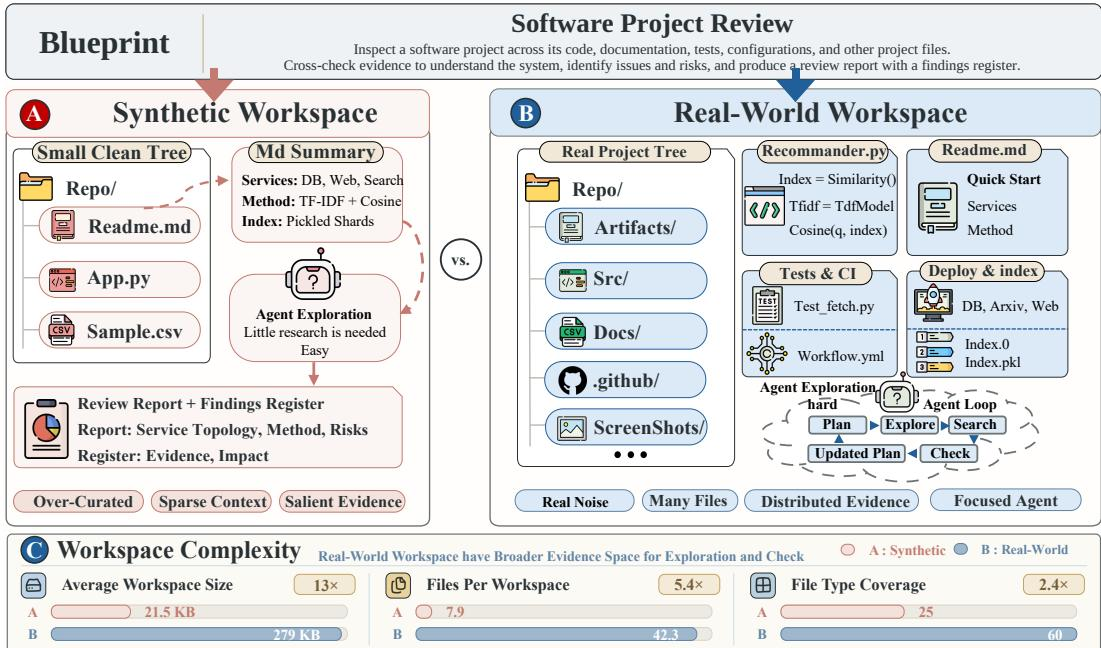
每个场景蓝图通过从外部来源获取不同资源池映射到多个环境。获取 agent 会搜索、读取、下载并预览资源,只保留相关工件,并将它们与蓝图的抽象要求关联。
-
每个保留环境包含一个由非空资源池实现的工作区。工作区保留所选资源池的原始文件组织,每个蓝图保留的环境数量记作 K_j。
-
每个工作区配有一个环境画像。画像概括领域、文件角色和可能的任务方向;记录可观察工作区事实;并存储工件模式和统计信息。这些画像为任务构造和验证提供事实锚点。
-
用于 agent 评估的数据集实例包括可见工作区、任务指令、轨迹记录、输出工件、程序化分数、语义分数和模型配置。轨迹通过让求解 agent 与工作区交互直至提交交付物或达到执行限制来生成。
-
rollout 后,程序化和语义评分器评估最终工作区和提交输出。完整执行记录作为评分后的轨迹数据保留,将 agent 行为与可验证结果关联。
-
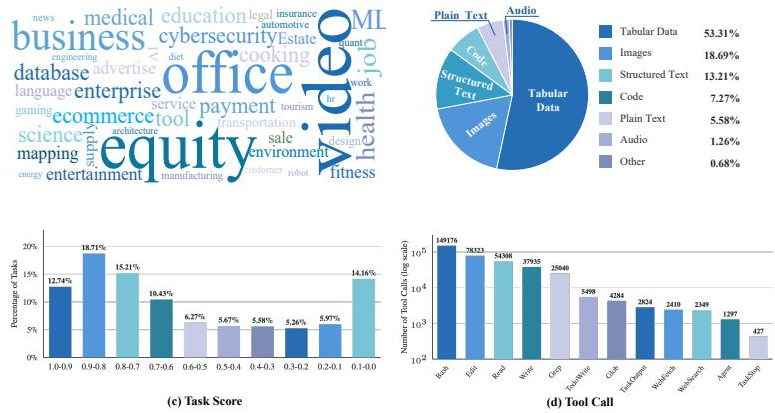
论文在报告中提及语料级标量统计、领域覆盖、文件类型、任务分数和工具调用分布,但提供的摘录未指定确切的子集大小、训练划分、混合比例、裁剪规则或元数据模式值。
方法
作者提出 WORKFORGE,一个旨在将专业工作流转换为真实且可验证的 agent 环境的框架。这种方法确保 agent 环境可以扩展而不牺牲真实性。整体框架通过四阶段流水线运行,如下图所示。
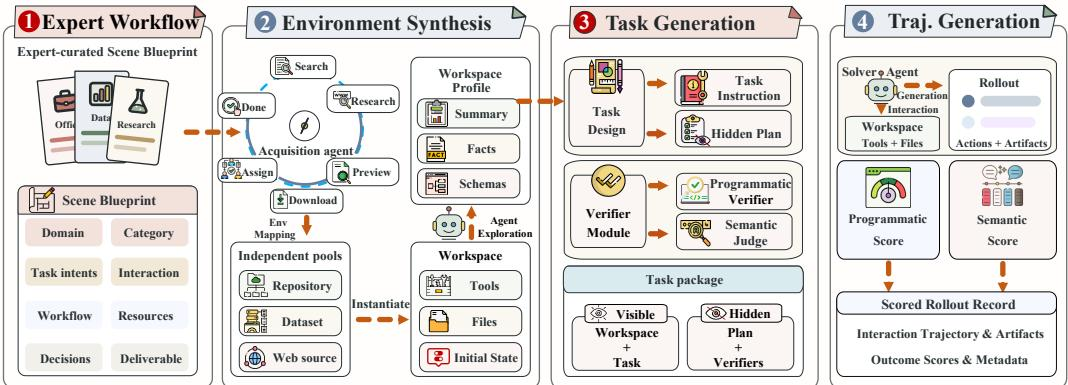
工作流规范 为了生成复杂的专业任务,作者让领域专家将其工作流提炼为可复用的场景蓝图。这些蓝图识别初始条件、领域特定操作和最终交付物之间的依赖关系。定义一个包含 M 个蓝图的集合 B={bj}j=1M,其中每个蓝图 bj=(Wj,Oj,Rj,Dj) 指定工作流上下文 Wj、预期交付物 Oj、所需来源和依赖关系 Rj,以及领域特定决策 Dj。每个蓝图作为连接专家意图和任务生成的种子。
环境合成 该阶段整合环境映射和环境画像,将每个蓝图实例化为具体工作区。对于场景蓝图 bj,该阶段产生一组环境 Env(bj)={(Wjk,Pjk)}k=1Kj。
环境映射表达蓝图与其具体环境之间的一对多关系。获取 agent 迭代搜索来源并下载资源,以形成不同资源池 {Rjk}k=1Kj。工作区实现为 Wjk=ϕRjk(bj)。
环境画像定义每个环境附带的描述。画像 Pjk=(Ujk,Fjk,Ajk) 包含领域与文件角色摘要 Ujk、工作区事实 Fjk、以及工件模式与统计 Ajk。该画像为任务构造和验证提供事实锚点。
任务生成 任务生成产生具有对齐需求和验证标准的可执行任务包。
任务设计结合场景蓝图与环境画像来指定专业目标。任务设计者共同生成可见指令 qjk 和隐藏解决方案计划 hjk:
(qjk,hjk)=(ftask(bj,Pjk),fplan(bj,Pjk))验证器设计将这些要求转换为原子评分细则集合 Vjk=Vjkprog∪Vjksem。程序化标准检查最终工件 Yjk,产生分数 Sjkprog。语义标准配置 LLM 评判器 Gjksem 来评估开放式要求,产生归一化分数 Sjksem。由此得到的任务包将可见输入与隐藏组件分离:
Tjk=visible(Wjk,qjk),hidden(Pjk,hjk,Fjk,Vjk,Gjkprog,Gjksem)轨迹生成 轨迹生成将静态任务包转换为观察到的 agent 行为。对于每个任务包 Tjk,求解 agent πθ 只接收可见对 (Wjk,qjk),并与工作区交互。该 rollout 过程记为:
(τjk,Yjk)=Rollout(πθ;qjk,Wjk)其中 τjk 记录有序消息和工具交互,Yjk 表示输出工件。执行后,评分器评估最终工作区和工件,产生程序化和语义分数。完整执行被保留为评分后的轨迹记录 zjk=(τjk,Yjk,Sjkprog,Sjksem,μjk)。所得语料库展现出多样的专业领域、文件类型和工具使用模式,如下图所示。
实验
实验在多个 work agent 基准上评估 WORKFORGE 训练的 agent,并与专有、大型开源和较小开源基线比较,同时消融实验检查训练框架、验证信号和工作区真实性的影响。总体结果表明,所提出训练流水线产生了强有力的通用 work agent,其中较小模型在 sub-100B 基线中表现良好,较大模型接近前沿能力,尤其在需要复杂工作区探索和证据整合的任务上。进一步分析表明,更广的真实世界数据、更长的交互轨迹、对齐的评估框架,以及混合验证,各自促进更持续的工具使用、更好的规划和更高质量的专业交付物。
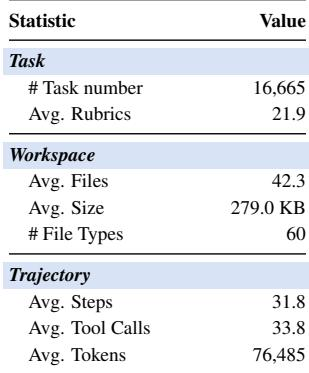
WORKFORGE 提供大量任务,每个任务具有多个评估评分细则,并包含许多文件和文件类型的异构工作区。它还记录包含工具交互、输出工件、程序化和语义分数的轨迹。这些任务、工作区和轨迹维度支持 agent 行为分析和扩展性研究。数据集包含大量任务,每个任务具有多个评分细则。工作区文件丰富且多样,平均包含许多文件和许多文件类型。轨迹记录捕捉有序 agent 交互、输出工件和评估分数。真实世界获取扩大了工作区规模和异质性,为 agent 提供更丰富的工件和证据空间。
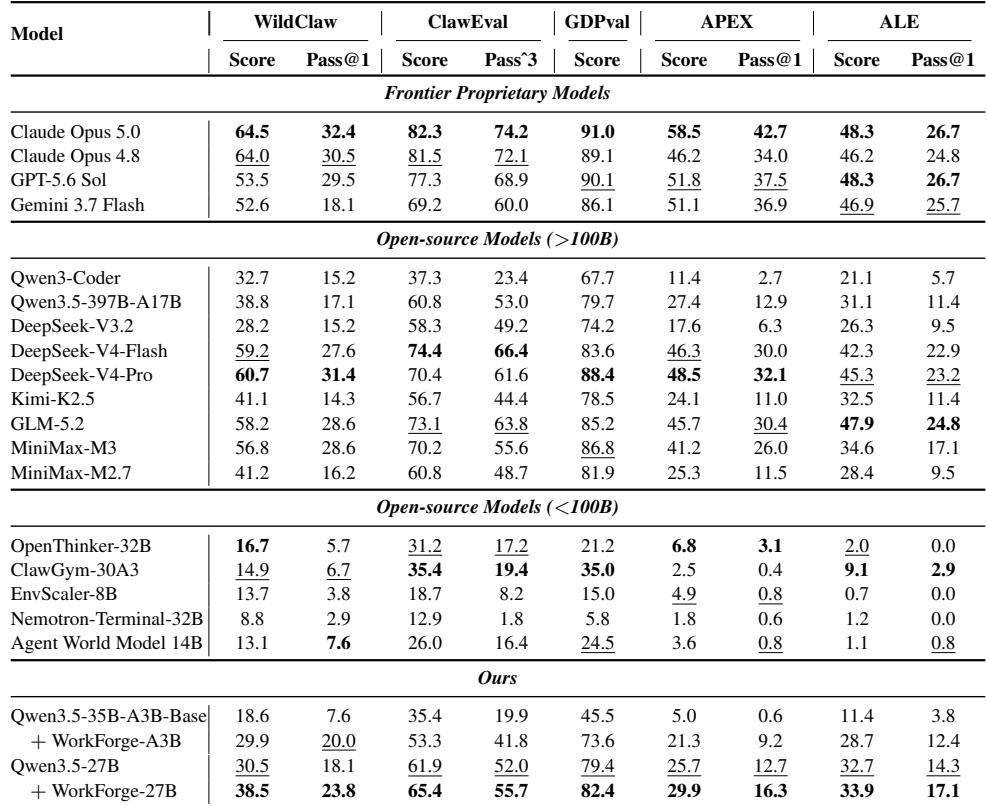
WORKFORGE-A3B 在 agent 能力基准上具有竞争力,在 GDPval 上尤其显著优于先前专门化的 sub-100B 模型,并且在严格通过率指标下保持强劲表现。WORKFORGE-27B 也在 WildClaw、ClawEval、GDPval、APEX 和 ALE 上改进一个较大的开源模型,以少得多的参数达到接近前沿的 GDPval 性能。WORKFORGE-A3B 在 GDPval 上大幅超越先前专门化的 sub-100B 基线,同时在 WildClaw、ClawEval、APEX 和 ALE 上保持竞争力。WORKFORGE-27B 在全部五个基准上均有改进,并缩小与 Claude 和 GPT 等前沿系统在 GDPval 上的差距。
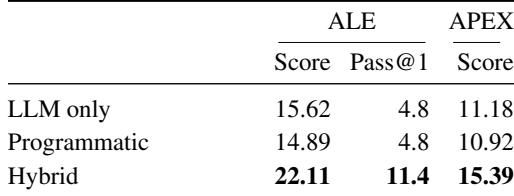
混合轨迹选择将基于 LLM 的质量验证与程序化检查结合,优于仅使用其中一种信号。这表明,来自精确工作区状态和内容质量的验证信号,为选择训练轨迹提供更有用的监督。混合验证在报告指标上产生最强结果。仅使用 LLM 和仅使用程序化选择的表现相似,且低于组合方法。
实验评估 WORKFORGE 的数据集设计、模型在 agent 基准上的能力,以及轨迹选择策略。数据集的众多任务、评分细则、多样化工作区和详细轨迹记录支持 agent 行为分析和扩展趋势分析。WORKFORGE 训练的模型在 agent 评估套件上展现有竞争力或改进的性能,在 GDPval 上提升尤其明显,并缩小与前沿系统的差距。同时使用程序化和语义验证的混合轨迹选择优于单独使用任一信号,这表明将工作区状态检查与内容质量评估结合可提供更好的监督。