Command Palette
Search for a command to run...
少读多解:面向 AI 智能体的外部内容令牌高效稀疏阅读
少读多解:面向 AI 智能体的外部内容令牌高效稀疏阅读
Zedong Liu Jiaan Wu Xinyang Ma Le Xu Kai Wang Yuanchao Hu Dingwen Tao Guangming Tan
摘要
面向 Web 的 AI 智能体会反复访问网页、文档、代码库和工具响应,然而当仅需稀疏证据时,阅读接口往往暴露整个对象。这种过度阅读增加了令牌和延迟成本,并可能稀释相关证据。我们提出 SparseRead,一个可复用的阅读控制层,在不修改智能体模型的前提下管理内容准入。其读取意图协议跟踪不断变化的需求和来源覆盖情况;自适应读取器后端选择证据的定位与暴露方式;预算读取门限以忠实的全视图回退机制约束每个回合的累计原始暴露量。统一的读取器接口支持在异构资源间进行可互换的证据获取。在包括 Claude Opus 5 在内的六个模型和五个场景中,SparseRead 将总令牌数最多降低 92.9%,将墙钟时间最多降低 89.0%,并在 97% 的设置中保持或提升了任务质量。在 Web 深度搜索任务上,它将令牌数降低 31.0%–43.0%,将任务完成时间降低 23.0%–37.0%。消融实验验证了这三项设计,而与三个智能体框架的集成则证明了其可移植性。
一句话总结
来自中国科学院大学、中国科学院计算技术研究所和松山湖材料实验室的研究人员提出 SparseRead,一种可复用的读取控制层,其 Read Intent Protocol、Adaptive Reader Backends 和 Budgeted Read Gate 在无需修改 agents 的情况下管理内容准入,将总 tokens 最多减少 92.9%,墙钟时间最多减少 89.0%,同时在 97% 的设置中保持或提升任务质量。
核心贡献
- SparseRead 是一种可复用的读取控制层,在无需修改 agent 模型的情况下管理内容准入,结合了用于不断变化需求和来源覆盖的 Read Intent Protocol、用于证据定位和暴露的 Adaptive Reader Backends,以及 Budgeted Read Gate,该门在每轮 episode 中限制累计原始暴露,并提供忠实的全视图回退。
- 统一 Reader 接口支持跨异构资源可互换的证据获取,并让检索或压缩方法作为可替换后端使用。
- 在包括 Claude Opus 5 在内的六个模型和五个场景上的评估表明,总 token 减少最多达 92.9%,墙钟时间减少最多达 89.0%,且在 97% 的设置中任务质量保持或提升;Web 深度搜索任务显示 token 减少 31.0-43.0%,时间减少 23.0-37.0%。消融实验验证了这三项设计,与三个 agent 框架的集成证明了可移植性。
引言
大语言模型 agents 越来越多地在网页、代码仓库和 API 响应上执行长周期任务,但外部观测往往占 tokens 的很大比例,并且可能跨模型调用持续存在。作者将这种错配描述为过度读取:即使决策只需要少量证据片段,agents 也会接收到对象级内容,而宽泛的上下文可能稀释相关证据且不提升质量。现有方法(如 KV-cache 压缩、观测掩码和检索)能降低表示开销或按需获取内容,但未能联合控制一次工件读取应暴露什么、跟踪跨不断变化意图的来源覆盖、限制累计暴露,并提供忠实的全视图回退。SparseRead 引入了一个读取控制层,agents 在其中表达 Read Intent,并收到一个具有显式覆盖范围的受限 EvidencePack,由自适应 Reader 后端和一个预算式 Read Gate 支持,该门在稀疏访问和全视图之间进行选择。
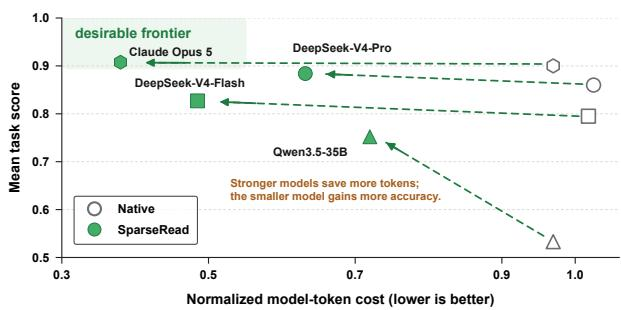
方法
作者观察到有用证据在源文档中往往很稀疏。对于长文档问答,标注的支持证据覆盖源 tokens 的中位数仅为 3.17%。这种稀疏性促使证据获取由当前信息需求而非固定摘要来指导。
读取预算分解见下方:
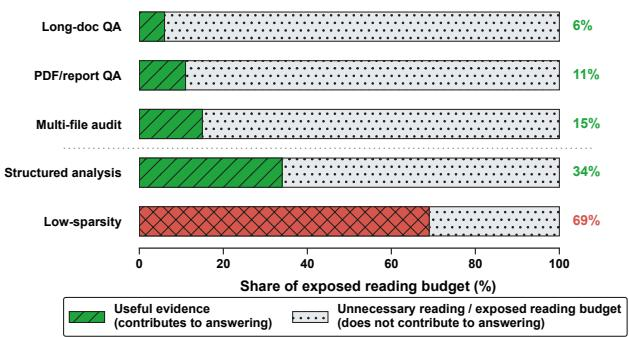
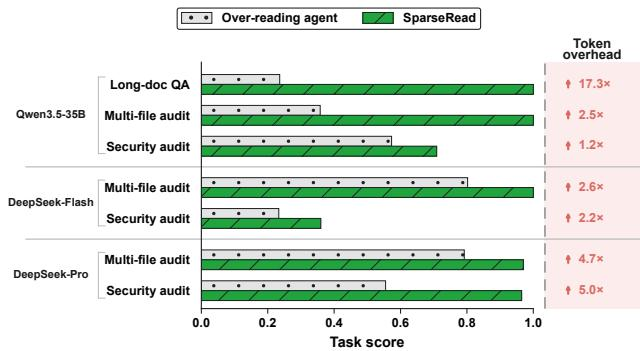
此外,宽泛读取的成本会跨模型调用不断累积。一步中暴露的内容可能保留在后续调用中,导致显著的按重放加权的暴露。如果宽泛读取总能提升质量,过度读取将只是成本问题,但选择性读取通常在减少暴露上下文的同时保持或提升得分。
如下图所示,全量读取的 agents 可能花费比 SparseRead 多最多 17.3 倍的 tokens,却未能提升任务得分。这表明宽泛上下文并不能免费替代读取控制。
为解决这些问题,作者指出仅靠检索或压缩是不够的,因为证据需求不断变化且机制边界不确定。最优读取策略取决于工件类型和具体任务要求。
受控读取的挑战见下方:
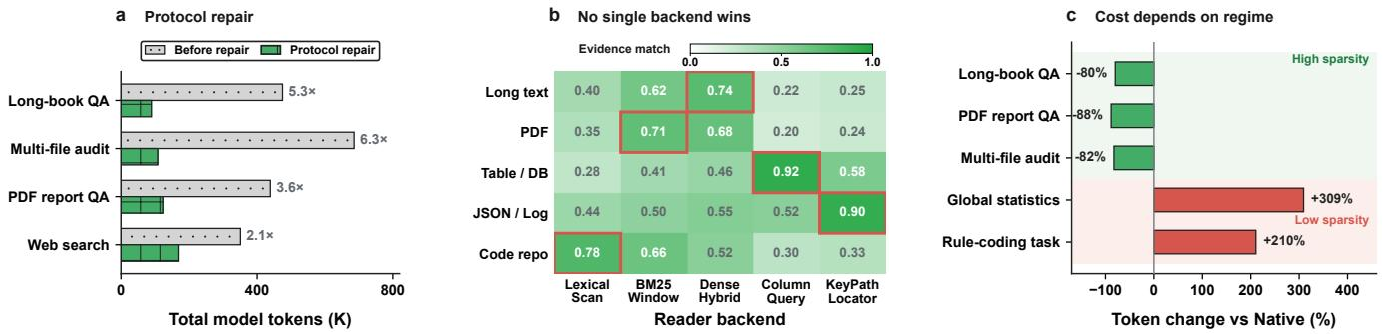
上图说明了这些挑战:协议修复显著降低 token 使用量;没有单一后端能在所有工件类型上胜出(例如,稠密混合检索适合长文本,而 key-path 定位器适合 JSON);成本收益高度取决于机制(稀疏读取在高稀疏性任务上节省 tokens,但在全局统计任务上增加 tokens)。
因此,作者提出 SparseRead,它将读取控制与证据获取分离。架构由控制平面和证据平面组成,二者通过将 Read Intent 映射到 EvidencePack 的公共契约连接。
该架构在框架图中说明:
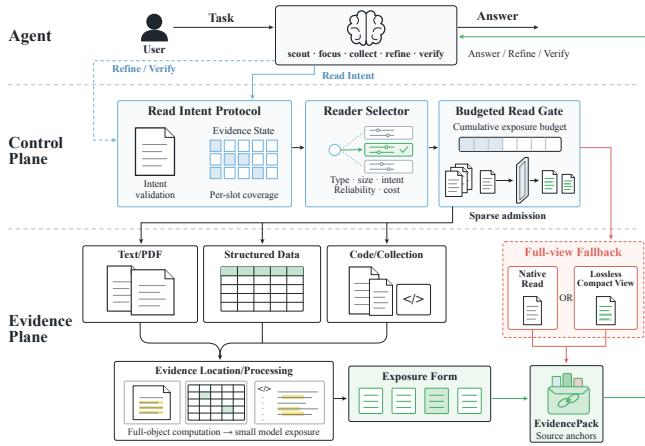
控制平面解释 agent 的读取意图,选择合适的 Reader 配置,维护证据记录,并管理进入模型上下文的内容。证据平面包含 Readers,它们声明支持的工件类型、操作和执行成本。Readers 获取证据,但不决定何时被调用。
Read Intent Protocol
该协议将读取视为由 agent 引导的一系列证据请求。每次访问时,agent 提供结构化的 Read Intent,描述其下一步决策所需内容。这种访问意图优先于从用户初始请求派生的会话意图。协议使用 SHA-256 指纹识别工件版本,以维护先前证据的有效性和相关性。它跟踪证据覆盖情况,识别哪些槽位具有支持证据、哪些仍未解决,而不判断充分性。agent 通过五个稳定操作进行交互:scout、focus、collect、refine 和 verify。
Adaptive Reader Backends
Reader 由其处理的工件定义。在 Reader 内部,证据获取涉及选择如何定位或处理证据,以及向 agent 暴露什么。SparseRead 根据工件类型、大小范围和 Read Intent h 自适应选择 Reader 配置 r∗。系统在可靠性阈值 pvalid(r∣g)≥τ 下,选择最小化估计成本 C(r∣g) 的配置:
r∗=argr∈Ro,hminC(r∣g)s.t.pvalid(r∣g)≥τ其中 Ro,h 表示工件 o 和意图 h 的兼容配置。这使得系统能适应不同工件类型,例如对表格使用列查询,对文本使用混合检索。
Budgeted Read Gate
Read Gate 决定何时选择性访问是值得的,以及何时回退到完整视图。它强制一个预算,使累计稀疏载荷 E 不超过成本最低的忠实全视图 f(o) 的长度 L。在交付一批内容前,Gate 会将其估计大小与剩余预算进行比较。如果下一批无法完整放入预算,则将其扣留,改为交付 f(o)。这确保总未加权工件暴露有界,防止不受控选择性读取的弊端,同时在 agent 可以用最少证据完成时保持节省。
实验
评估在六个模型、五个场景(包括长上下文理解、多文件审计、结构化分析、Web 深度搜索和科学脚本生成)上测试 SparseRead,并与朴素、检索和上下文压缩基线对比。主要结果显示,SparseRead 显著降低 token 使用量和墙钟时间,同时在几乎所有设置中保持或提升任务得分,并优于常常损失质量或增加成本的检索和压缩基线。使用 NanoBot、OpenCode 和 OpenClaw 进行的跨框架实验证实了无需重新训练的可移植性,大多数设置中得分保持或提升。消融实验将收益归因于组合的 Read Intent、自适应 Reader 后端和 Budgeted Read Gate,它们共同减少冗余读取、改善证据覆盖并控制资源暴露。
SparseRead 在每个被评估的 agent 框架和模型设置中都降低了 token 使用量和墙钟时间,而任务得分在大多数情况下保持或提升。节省中位数因框架而异,两个框架降幅较大,一个框架降幅较为温和。该方法通过薄适配器跨框架迁移,无需模型重新训练。在所有 18 个设置中,token 使用量和墙钟时间均降低,得分在 15 个设置中保持或提升。两个框架的 token 减少中位数约为 65%,第三个框架约为 31%,时间节省遵循相似模式。对于 Opus 5,token 节省范围约从三分之一到近五分之三,时间节省从不足三分之一到超过一半,并且各设置均有得分提升。通过薄适配器复用该协议、Readers 和 Gate,支持跨 agent 框架的可移植性,无需模型重新训练。
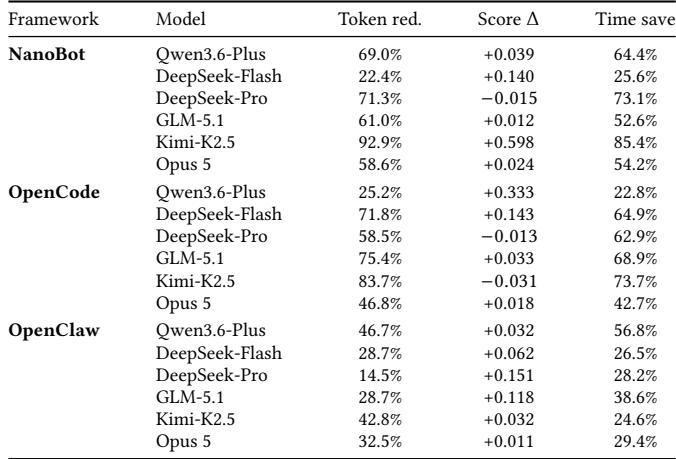
SparseRead 在多个 agent 框架和模型设置上进行了评估,始终降低 token 使用量和墙钟时间,而任务得分在大多数情况下保持稳定或提升。节省因框架而异,两个框架降幅较大,一个框架降幅较温和,该方法通过薄适配器跨框架迁移,无需模型重新训练。结果表明,SparseRead 在不同 agent 环境中提供了可移植的效率提升。