Command Palette
Search for a command to run...
TeleOCR:跨数字文档与相机拍摄文档的文档解析导航
TeleOCR:跨数字文档与相机拍摄文档的文档解析导航
Peng Cai Zhaofan Zou Shifa Liu Yikun Wang Jiawei Tang Kaicheng Yang Meng Tong MingKun Jiang Zhongjiang He Hao Sun
TeleOCR:面向数字文档与相机拍摄文档的统一文档解析
摘要
文档解析旨在将非结构化文档转换为结构化的、机器可读的表示。近期视觉语言模型(VLM)的进展显著推动了文档解析。然而,现有方法仍面临两大挑战。第一,基于 VLM 的解耦式方法高度依赖准确的版面分析,而相机拍摄文档中的几何畸变可能引入级联误差。第二,尽管基于 VLM 的端到端方法减轻了对显式版面检测的依赖,但它们在高分辨率场景下常常遭受冗余生成、幻觉以及结构推理不足等问题。为应对这些挑战,我们提出 TeleOCR,一个用于文档解析的统一框架。TeleOCR 引入形变感知学习,将几何感知纳入 VLM,并提出一种面向复杂版面表示的自适应采样机制。此外,我们开发了一种内容与结构解耦的学习策略,用于显式建模公式语法和表格结构,从而实现更有效的结构化表示学习。大量实验表明,TeleOCR 在多样化的文档解析基准上取得了最先进的性能。它在 OmniDocBench v1.6、Wild-OmniDocBench 和 PureDocBench 上分别取得 96.87、88.53 和 78.41 的综合得分,并在 ICDAR 2026 Sci-ImageMiner Challenge 中排名第一。这些结果验证了 TeleOCR 在复杂文档解析场景中的有效性与泛化能力。
一句话总结
中国电信人工智能科技(北京)有限公司提出 TeleOCR,一种统一的文档解析视觉语言模型框架。该框架融合了形变感知学习、自适应采样,以及针对公式语法和表格结构的内容-结构解耦建模,用于应对相机拍摄文档中的级联布局错误以及高分辨率端到端生成中的幻觉问题。在 OmniDocBench v1.6、Wild-OmniDocBench 和 PureDocBench 上,TeleOCR 分别取得 96.87、88.53 和 78.41 的综合得分,达到最先进水平,并在 ICDAR 2026 Sci-ImageMiner Challenge 中获得第一名。
核心贡献
-
TeleOCR 被提出为一个基于 VLM 的统一文档解析框架,融合了形变感知学习,包括区域级和全局点级机制,以在 VLM 内部建模几何感知和文档校正。该设计减少了相机拍摄文档中几何畸变导致的级联错误。
-
该框架加入了曲率引导的自适应采样以表示复杂布局,并针对公式语法和表格结构采用内容-结构解耦学习。大规模文档数据工程和结构感知渐进式训练支持文本、表格、公式、代码、印章和科学图形的解析。
-
在 OmniDocBench v1.6、Wild-OmniDocBench 和 PureDocBench 上,TeleOCR 的综合得分分别为 96.87、88.53 和 78.41,并在 ICDAR 2026 Sci-ImageMiner Challenge 中排名第一。这些结果证明其在复杂数字文档和相机拍摄文档解析场景中的有效性。
引言
文档解析将非结构化的文档图像转换为 Markdown 等结构化输出,可支持训练数据构建和检索增强生成。该任务的重要性在于,准确的文本识别、布局理解和结构重建会直接影响下游系统质量。已有方法存在取舍:端到端方法对相机引起的几何畸变更鲁棒,但计算开销可能较高,并将结构推理与内容生成耦合;解耦方法在干净的数字文档上表现良好,但在布局误差传播时效果下降。TeleOCR 是一个统一的解析框架,将形变感知学习嵌入 VLM,并用自适应布局分割取代传统检测。它进一步引入内容-结构解耦学习策略,先为表格和公式等任务预测结构,再生成内容,从而降低优化复杂度,并提升在数字文档、相机拍摄文档和高结构化文档上的鲁棒性。
数据集
-
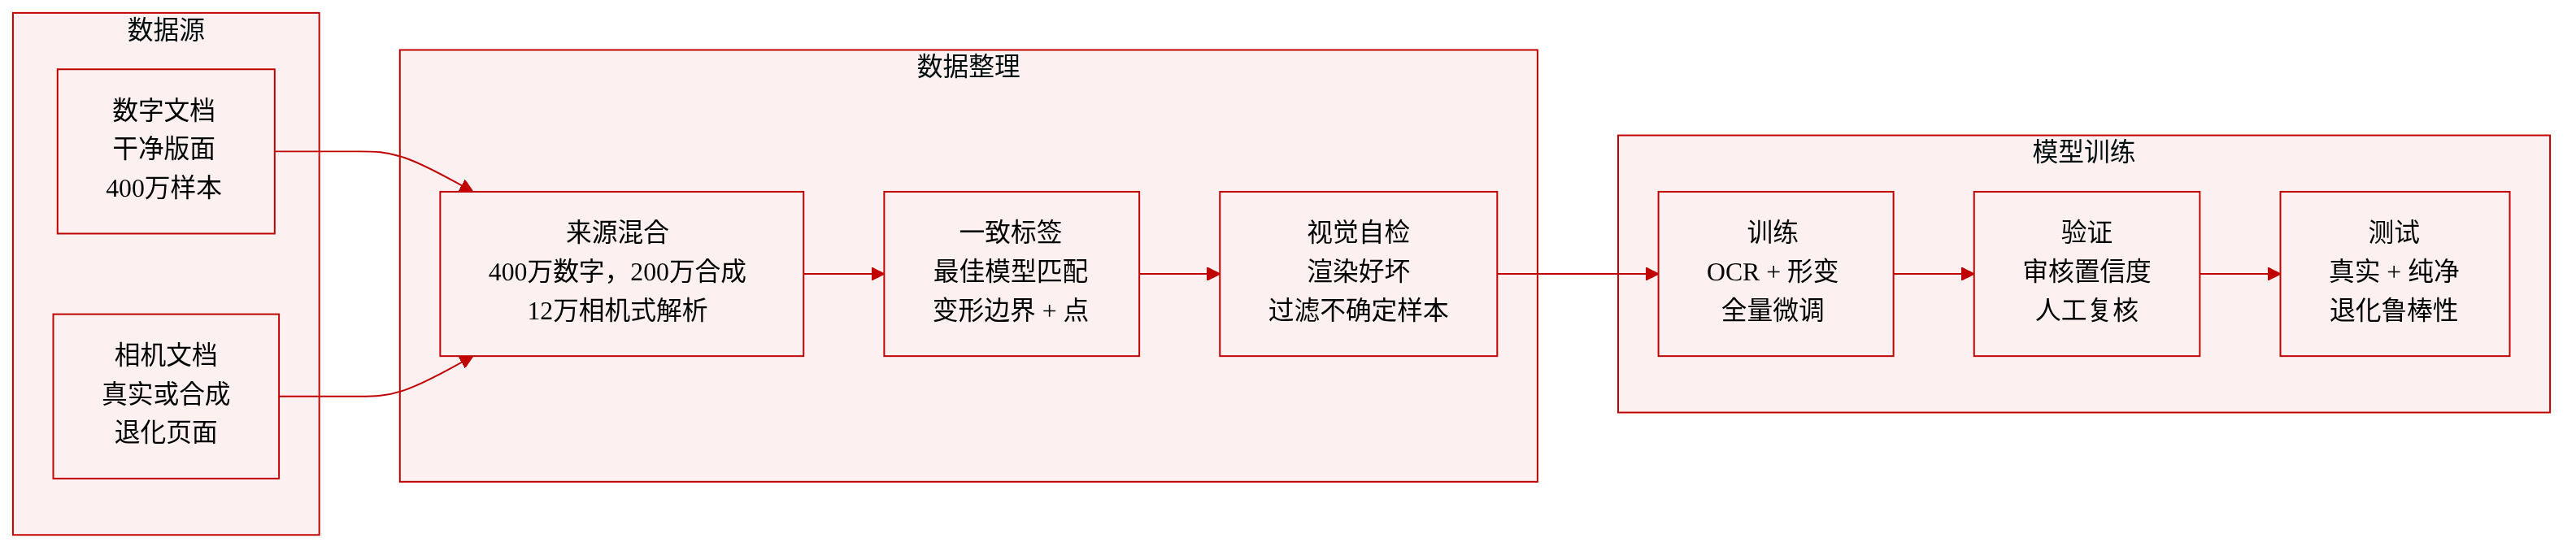
通过自动化数据工程流水线构建数据集,而非依赖大规模人工标注。该流水线主要有三个目标:生成可靠的伪标签,创建形变感知训练样本,并使用基于模型的审核器验证过滤后的数据。
-
高置信度伪标签来自多节点共识投票(MCV)。
- 多个异构模型预测同一文档样本。
- 按任务对一致性进行评分:布局使用 IoU,文本使用 Edit Distance,表格使用 TEDS,公式使用 CDM。
- 选择平均一致性最高的预测作为伪标签。
- 如果最佳得分未达到共识阈值,则将该样本转入自动纠错或人工校验。
-
训练数据统一了数字文档和相机拍摄文档。
- 数字文档提供干净的布局和解析监督。
- 相机拍摄文档通过合成形变表示,而不是仅采集真实拍摄文档。
- 对数字布局应用文档形变生成,产生畸变图像以及对应的扭曲几何标注。
-
在两个层级构建几何元数据。
- 区域级监督:沿未畸变布局边界按顺时针方向采样 N 个边界点,并序列化为坐标对。
- 点级监督:在未畸变文档平面上均匀采样 M by M 个控制点。
- 对图像、边界点和控制点施加相同的形变场,产生扭曲边界和扭曲控制点作为训练目标。
-
边界点采样采用曲率引导的 Douglas-Peucker 策略。
- 均匀采样可能在平坦区域过度采样,并欠采样折痕、拐角和裂缝。
- 对标准 Douglas-Peucker 距离加入局部曲率项。
- 较高曲率区域获得更高采样优先级,从而在有限采样预算下保留锐利折痕和局部结构细节。
-
Stage 2 形变感知训练集被描述为数字数据与合成相机拍摄数据的混合集合。
- 400 万数字文档布局样本。
- 200 万合成相机拍摄文档样本。
- 合成集合划分为 120 万区域级形变样本和 80 万全局点级形变样本。
- 这些样本使用布局坐标、全局形变控制点,以及通过 MCV 选择的区域边界点。
- 约 12 万高质量解析样本进一步增广了类相机退化,包括畸变、阴影和模糊。
-
构建辅助图像到图像验证数据集,用于训练自我判断模型。
- 正确预测会被重新渲染到视觉画布中,保留布局、文本结构、以 HTML 渲染图像表示的表格,以及从 LaTeX 渲染的公式。
- 错误预测通过基于规则和 LLM 引导的扰动生成,例如缺失布局区域、合并或拆分布局块、文本损坏、表格结构错误和公式语法错误。
- 原始图像与正确渲染构成正样本,原始图像与扰动渲染构成负样本。
- 该辅助验证数据集未报告确切总规模。
- 这些数据用于过滤伪标签、识别错误类型,并将低置信度样本路由给人工审核。
-
评估数据集聚焦退化文档和相机拍摄文档解析。
- Wild-OmniDocBench 基于 OmniDocBench v1.5 构建,通过打印、形变和多样光照条件下的图像采集,将数字文档转换为真实拍摄图像。它包含几何畸变、光照变化、屏幕截图伪影和环境噪声。
- PureDocBench-Degraded 由 PureDocBench-Clean 电子 PDF 构建,通过模拟数字退化和真实采集条件形成。用于测试在退化且高结构化文档布局上的鲁棒性。
-
未描述显式图像裁剪策略。处理和元数据构建围绕几何感知采样、形变监督、基于共识的伪标签选择,以及渲染视觉验证展开。
方法
采用统一流水线,将高质量数据构建与紧凑、渐进训练的视觉语言解析模型相结合。系统设计用于处理文本、布局、表格和公式等多样文档结构,同时减少对人工标注的依赖。在数据侧,流水线首先通过多节点共识生成可靠伪标签,然后为相机拍摄文档构建形变感知样本,最后使用自我判断模型验证和过滤解析结果。在模型侧,多阶段训练过程使模型从基础视觉语言对齐,逐步转向显式几何感知、结构化内容解析和基于强化学习的优化。
伪标签生成模块避免依赖单一解析器或检测器。定义一组异构模型 M={M1,M2,…,MN},每个模型针对同一输入文档样本 x 产生预测 yi=Mi(x)。两个预测之间的一致性通过任务相关一致性函数 S(yi,yj) 衡量,例如布局检测使用 Intersection-over-Union,文本识别使用 edit distance,表格解析使用 TEDS,公式解析使用 CDM。参见下图。
基于该一致性度量,每个预测获得一个共识分数,表示其与其余模型的平均一致性:
Ci=N−11j=i∑S(yi,yj)选择一致性最强的预测作为伪标签:
y^=yk,k=argimaxCi如果最高共识分数超过阈值 τ,则该样本被接受为高置信度训练实例。否则,模型间的不一致被视为不确定性信号,样本将转入自动纠错或人工校验。该机制减少单模型偏差,并防止系统性解析误差被反复传播到训练语料中。
下一阶段处理数字文档与相机拍摄文档之间的域差异。相机图像通常包含几何畸变、阴影、模糊和弯曲边界,可能破坏许多布局检测系统所依赖的矩形区域假设。为了引入形变感知,流水线从高一致性样本构建两类监督。对于区域级几何,沿未畸变布局边界按顺时针方向采样 N 个边界点,并序列化为点序列。对于全局几何建模,在平坦文档平面上均匀采样 M×M 个控制点。随后,对原始图像、边界点和控制点施加形变映射,生成合成类相机图像,并得到畸变图像以及对应的扭曲边界 Rw 和扭曲控制点 Pw。
在早期训练中,模型学习预测扭曲控制点 Pw,从而显式获取文档形变模式。扭曲区域边界 Rw 随后用于替代传统矩形框,将布局检测重构为边界点预测。这消除了对规则矩形布局区域的依赖,并使模型能够表示弯曲、折叠或不规则形状的文档元素。
为在有限点预算下提升边界表示,还引入曲率引导的 Douglas-Peucker 采样。标准均匀边界采样可能在平坦区域过度采样,并在拐角、裂缝和折痕处欠采样。该方法利用 Douglas-Peucker 距离保留全局轮廓形状,并使用归一化局部曲率调节点重要性:
Si=di(1+λκ^i)其中 di 表示点的 Douglas-Peucker 相关性,κ^i 是归一化局部曲率。当曲率较低时,该策略表现为普通 Douglas-Peucker 采样。当曲率较高时,靠近锐利折痕、拐角或局部不连续性的点获得更高优先级。当选中点的分数超过阈值时,它成为递归采样节点,从而在保留关键几何信息的同时避免引入过多监督噪声。
在共识投票和形变感知构建之后,流水线引入自我判断模型以提升伪标签可靠性。系统不再直接将原始文本、表格或公式输出与原始文档比较,而是将预测转换为视觉渲染。布局预测被投影到页面画布,文本被重组为段落,表格通过 HTML 风格的结构化表示渲染,公式被转换为图像渲染。这将跨模态图文验证转换为原始文档与重建输出之间更稳定的图像到图像一致性检查。
自我判断模型使用正负图像对训练。高置信度预测被渲染为正确候选,而基于规则和语言模型引导的扰动生成错误候选。扰动涵盖缺失、位移、重叠、合并、拆分或重排的布局区域;文本损坏、遗漏或误分类;表格结构错误;以及公式语法或类型错误。给定原始图像 I(x) 和渲染预测 I^y,模型在检查标准 E={ek}k=1K 下评估一致性:
rk=M(I(x),I^y,ek)各项分析被聚合为结构化推理序列 R=(r1,…,rK),并产生最终一致性判断。这使得自动过滤伪标签、识别错误类型和生成错误解释成为可能。低置信度样本随后可转入人工校验。
对于解析模型本身,采用约 1.2B 参数的紧凑视觉语言架构。该系统结合预训练视觉编码器、约 0.6B 参数的轻量语言模型,以及将视觉表示映射到语言模型嵌入空间的多层感知机对齐器。对齐器从零开始训练,而视觉编码器和语言模型提供预训练的感知和推理基础。参见下图。
模型通过四个渐进阶段训练。第一阶段执行视觉语言对齐。语言模型保持冻结,视觉编码器和 patch merger MLPs 使用面向 OCR 的数据、图像描述、交错图文数据和视觉问答监督进行优化。这建立基础字符识别和布局理解能力。
第二阶段引入形变感知训练。模型学习预测下采样几何控制点,将形变建模从稠密畸变场缩小为较小坐标集合。训练结合数字布局数据与通过共识选择的边界点、全局控制点和曲率引导边界表示构建的合成相机拍摄样本。额外解析样本通过畸变、阴影和模糊进行增广,以更好匹配真实相机条件。该阶段增强模型识别违反平坦矩形布局假设文档的能力。
第三阶段采用内容-结构解耦学习。对于公式解析,系统构建 syntax token 库,并从 LaTeX 标注中提取结构标签,使模型能够分别学习公式内容和语法结构。对于表格解析,模型使用表格拓扑 token 并移除单元格内容,迫使模型关注行列关系和合并单元格模式。这种分离支持文本、公式、表格和科学图形的统一建模,尤其是在必须保留结构语义而非仅识别字符的场景中。
第四阶段基于 Group Relative Policy Optimization 应用强化学习。由于监督 token-level loss 不能直接优化端到端任务解析质量,模型进一步对齐任务相关可验证奖励。对于文本、表格和公式,奖励根据输出格式和评估目标定义:
Rtask(y,y^)=⎩⎨⎧1−NED(y,y^),TEDS(y,y^),CDM(y,y^),Text,Table,Formula.其中 y 表示参考目标,y^ 表示模型预测。更高的奖励值表示预测与真实结果之间具有更强的结构或语义一致性。最终阶段在任务级目标下优化解析器,提升复杂真实文档解析场景中的鲁棒性。
实验
TeleOCR 在数字、真实拍摄、退化和科学图形到表格解析基准上评估,用于衡量准确性、鲁棒性和泛化能力。它在干净的数字页面上持续优于流水线式和端到端基线,尤其是在文本、表格和阅读顺序方面,同时公式处理表现具有竞争力。它也在真实相机拍摄和退化设置下保持较强表现,并通过内容-结构解耦学习有效迁移到科学图形到表格转换。
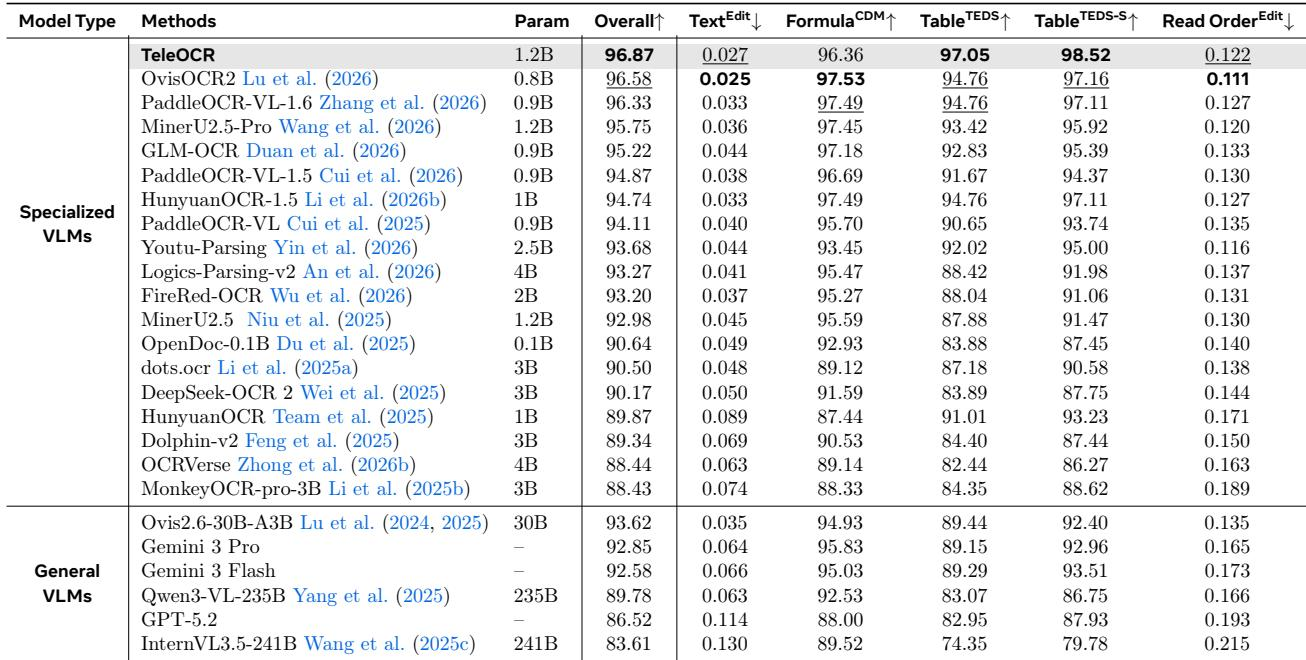
TeleOCR 在比较中取得最强综合结果,表格重建得分最高,文本和阅读顺序结果也接近最强。其公式识别具有竞争力,但落后于最佳公式指标,表明公式处理相比其他输出仍不占主导。公式误差与早期布局解析和基准标注粒度之间的不匹配有关。在评估模型中领先综合表现以及两项表格重建指标。公式识别受早期布局解析粒度和标注一致性限制。
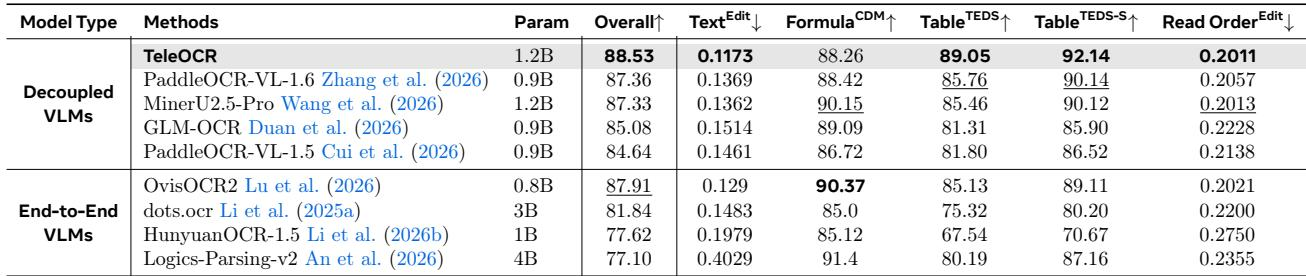
TeleOCR 在比较的相机拍摄文档解析方法中达到最高综合得分,并在文本、表格和阅读顺序指标上领先。其优势在结构化表格抽取中尤为明显,而公式表现仍接近强端到端基线。这些结果支持其在几何畸变、光照变化和环境噪声等真实拍摄退化下的强鲁棒性。TeleOCR 综合排名第一,并在比较方法中取得最佳文本 edit error、表格 TEDS 得分和阅读顺序误差。OvisOCR2 在公式抽取上具有竞争力,但在综合质量和结构化表格恢复方面落后于 TeleOCR。与公式抽取相比,比较方法在表格抽取上变化更大,表明其在退化真实拍摄布局上的鲁棒性较弱。
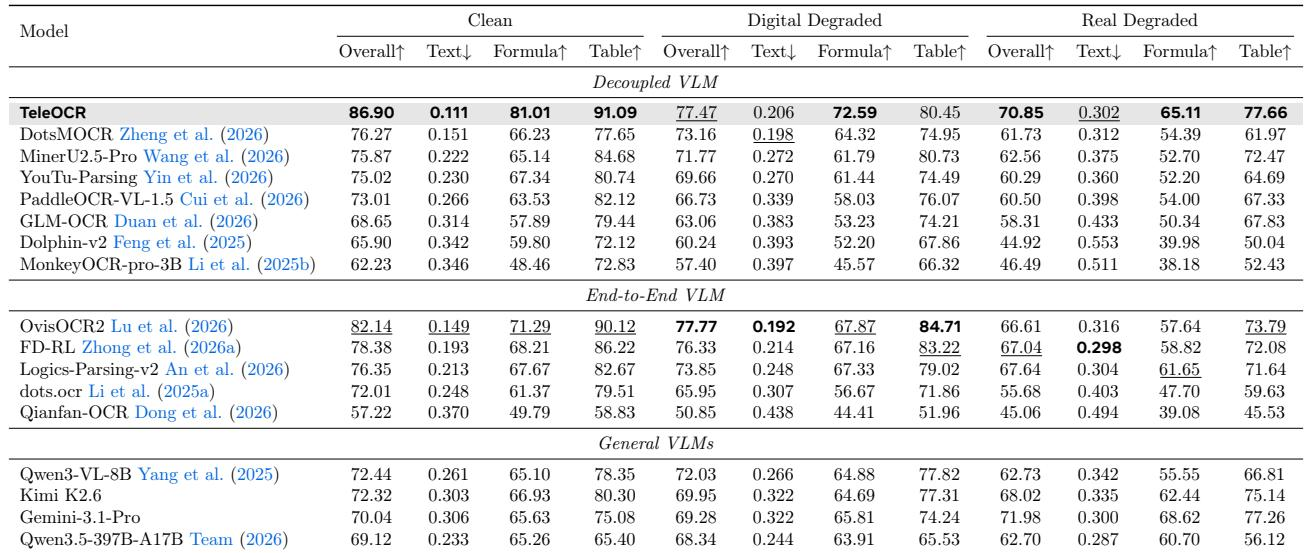
TeleOCR 在所列比较模型中的干净、数字退化和真实退化文档解析赛道上取得最高综合得分。结果表明,随着退化更严重,解析质量通常下降,但 TeleOCR 在综合表现上仍领先于其他系统。该模式支持在高质量渲染、模拟数字退化和真实拍摄条件下进行鲁棒文档解析。TeleOCR 在干净、数字退化和真实退化解析任务上综合领先。它在干净和真实退化赛道上具有最低文本 edit distance,并在各赛道上具有最强公式得分。表格重建在干净和真实退化赛道上最高,并在数字退化下保持竞争力。
TeleOCR 在数据抽取比较中领先,取得所列团队中的最高综合加权得分和最高 TEDS。它还明显优于最佳基线,并在 RMS 上相对于最强竞争对手具有竞争力。TeleOCR 综合排名第一,TEDS 和加权表现最强。VLMinators 是最接近的竞争者,具有可比 RMS,但 TEDS 和加权得分更低。
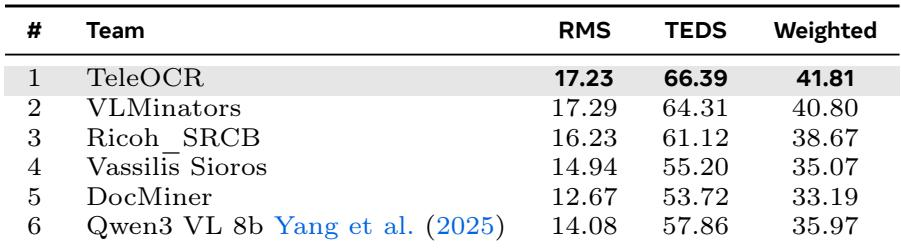
实验比较 TeleOCR 与其他文档解析和抽取方法在综合解析质量、相机拍摄鲁棒性、退化赛道和结构化数据抽取方面的表现。结果持续验证 TeleOCR 在文档理解方面的优势,尤其是在表格重建、文本质量、阅读顺序以及真实拍摄和模拟退化下的鲁棒性。公式识别仍具竞争力但不占主导,可能源于布局解析粒度不匹配和标注一致性问题。总体结果表明,TeleOCR 在实用文档解析设置中优于基线。