Command Palette
Search for a command to run...
以置信度记忆:具有概率保证的时空记忆不确定性量化
以置信度记忆:具有概率保证的时空记忆不确定性量化
Harry Zhang Nicolas Gorlo Luca Carlone
摘要
长时程机器人操作需要时空记忆来记录环境状态并供下游推理调用。场景图和检索增强系统将 VLM 描述锚定到具有丰富语义描述的持久 3D 实体上。然而,VLM 生成的描述存在噪声且在不同视角下不一致,现有系统将其视为绝对可靠的真值来源,缺乏检测不可靠存储描述的机制。我们针对多视角 VLM 记忆引入对象级语义不确定性:该分数度量以对象为中心的跨视角描述语义离散度,并识别语义上尚未明确的对象。随后,我们将不确定性分数纳入一个先进的空间-语义记忆系统,并将其命名为 UQ-DAAAM。UQ-DAAAM 利用该分数在固定查询预算下主动细化不确定对象,其方式是选择高质量视角并将所得多视角描述融合为单一对象描述。我们还推导出概率保证,表明(由我们的方法所选出的)更高质量的候选视角更有可能降低不确定性。实验表明,不确定性量化能够使具身 4D 记忆系统更可靠、更有效。特别是在 OC-NaVQA 基准上,UQ-DAAAM 实现了显著更大的不确定性降低和优于基线的时空问答性能。
一句话总结
MIT 研究人员提出了 UQ-DAAAM,这是一种具身时空记忆系统,可量化多视角 VLM caption 中的对象级语义不确定性,在固定查询预算下通过选择高质量视图并将生成的 caption 融合为单一对象描述来主动细化不确定对象,并提供概率保证,表明所选视图质量越高,越可能降低不确定性,从而在 OC-NaVQA 基准上提升可靠性与时空问答性能。
核心贡献
- 一种用于多视角 VLM caption 的对象级语义不确定性分数,将跨视角语义分歧与单视角不一致性结合起来,使记忆系统能够标记语义上尚未解决的对象,而不是把已存储描述视为可靠。
- UQ-DAAAM 中一种预算约束的主动细化和融合策略,将额外的视图查询分配给不确定对象,选择高质量视角,并将生成的多视角 caption 合并为稳定的对象描述。
- 一项概率保证将 DAAAM 的视图质量启发式与具有闭式更新的单步不确定性降低联系起来;UQ-DAAAM 在 OC-NaVQA 上取得最先进结果,不确定性降低幅度更大,时空问答性能优于基线。
引言
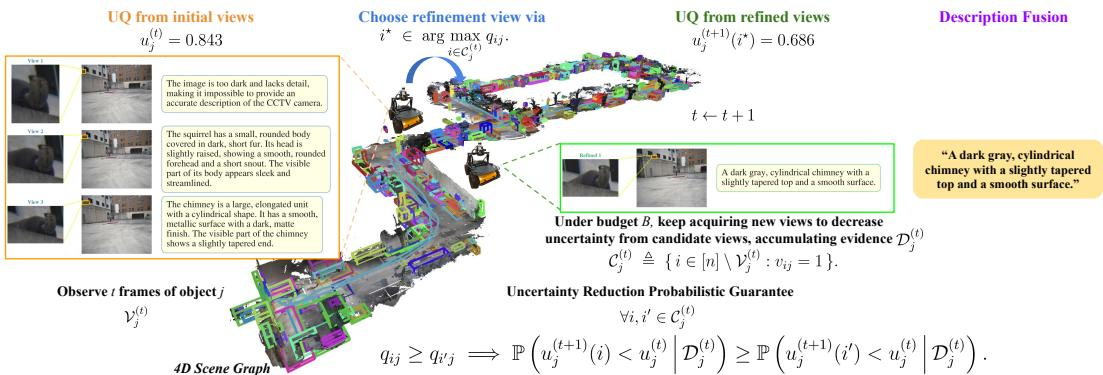
作者研究的是长时域机器人记忆问题,其中对象、agent 和区域的持久语义表示支撑下游时空推理与决策。近期系统建立在 3D 或 4D 场景图之上,并使用视觉语言模型存储开放词汇 caption,但这些系统通常把 VLM 注释视为 oracle 输出,尽管 caption 在不同视角下可能存在噪声且不一致。关键局限在于,当所选代表性视图质量较差时,不可靠的已存储描述可能悄悄破坏记忆。为弥补这一缺口,作者提出了 UQ-DAAAM,这是 DAAAM 的不确定性感知扩展,它基于跨视角 caption 嵌入散布为每个对象分配语义不确定性分数,然后在固定额外 VLM 查询预算下主动细化不确定对象。作者还给出了视图选择的概率论依据和闭式不确定性更新,报告了改进的不确定性降低效果以及在 OC-NaVQA 上的最先进性能。
方法
作者以 DAAAM 为基础,DAAAM 是一种实时 4D 场景图构建流程,它从 RGB-D 帧 fi 的滑动窗口中为每个被跟踪对象片段 oj 选择单个代表性帧。在原始形式中,一个二进制线性规划通过最大化视图质量分数 qij,在可见性和帧预算约束下,将每个片段分配给一个选中帧。随后由局部视觉语言模型为所选裁剪区域生成 caption,生成的文本被附加到场景图中对应的对象节点上。
提出的方法将这种分配从单视图证据扩展到多视图证据。该方法不再要求每个对象恰好选择一个帧,而是引入固定的每对象预算 r,并施加
i=1∑nyij=r∀j∈[m],其中 yij∈{0,1} 表示帧 fi 是否为对象 oj 的代表性视图。可见性和帧预算约束被保留,原始目标 ∑i,jqijyij 保持不变。因此,每个对象都与大小为 r 的所选视图集 Vj 关联,视觉语言模型为每个所选视图生成一个 caption cij。
对于不确定性量化,作者将每个 caption cij 映射到归一化语义嵌入
rij=∥ϕ(cij)∥2ϕ(cij)∈Rd.对象 oj 的所有所选视图的归一化嵌入被堆叠为语义证据矩阵
Rj=[r1j,…,rrj]∈Rd×r.由于仅凭语义散布在单个 caption 不可靠时会产生误导,作者还为每个 caption 分配不一致性权重
γij=exp(α(1−pij)),其中 pij 是该 caption 的平均逐 token 概率,α≥0 是缩放超参数。加权证据矩阵为
Zj=RjΓj,其中 Γj=diag(γ1j,…,γrj)。对象级语义散布矩阵为
Sj=Zj⊤Zj+λIr,其中 λ>0 是正则化常数。不确定性分数定义为
uj=logdetSj.该行列式度量由加权 caption 嵌入所张成的平方体积。当不同视图的 caption 指向不同语义方向,或当高度不一致的 caption 获得较大权重时,该值会增大。
如果某个对象的不确定性高于阈值 τ,agent 会主动获取额外视图。对于当前已选择 t 个视图的对象 oj,当前证据记为 Dj(t),候选集为
Cj(t)={i∈[n]∖Vj(t):vij=1}.下一视图根据贝叶斯最优实验设计原则选择。候选视图 i 的精确单步效用为
Δj(i∣Dj(t))=E[uj(t)−uj(t+1)(i)∣Dj(t)].为了使该过程可计算,作者推导了在添加视图 i 后增广散布矩阵的闭式更新。给定相似度向量 bij(t)=(Zj(t))⊤zij,增广矩阵为
Sj(t+1)(i)=[Sj(t)(bij(t))⊤bij(t)γij2+λ].作者进一步定义冗余分数
ηij(t)=(bij(t))⊤(Sj(t))−1bij(t)和 Schur 分数
sij(t)=γij2+λ−ηij(t).单步不确定性更新为
uj(t+1)(i)−uj(t)=logsij(t).由于评估精确期望效用需要对每个候选视图查询视觉语言模型,作者使用预先计算的视图质量分数 qij 作为低成本代理。在一阶随机占优假设下,质量更高的视图会产生随机意义上更小的 Schur 分数。这意味着在候选集上最大化 qij 等价于最大化精确的单步 BOED 效用
ij⋆∈argi∈Cj(t)maxqij.对于每个不确定对象,该方法使用细化预算 B。候选视图按 qij 排序,并依次查询排名靠前的视图。每增加一个 caption 后,都会重新计算不确定性分数。当不确定性降至 τ 以下、预算耗尽或没有可行候选视图时,细化停止。
在视图细化之后,作者通过受约束的基于 LLM 的融合步骤,将多视图 caption 集合聚合为单一对象描述。caption 按获取阶段排序,细化视图排在初始视图之后。系统指示 LLM 在解决冲突时优先采用较晚的细化 caption。如果仅初始视图之间存在分歧,聚合描述会以审慎语言保留备选内容,而不是消除歧义。LLM 还被限制为只能使用至少一个源 caption 中出现的信息,这降低了最终场景图描述中出现幻觉的风险。
实验
实验在 CODa 和 OC-NaVQA 基准上评估 UQ-DAAAM 在对象中心时空问答中的表现,并为事后视图细化设置固定预算。预算细化结果表明,不确定性引导的选择优于不细化、随机分配、基于质量的分配以及替代不确定性信号。不确定性降低和消融研究证实,细化能大幅解决初始不确定的对象,大部分收益来自较小的额外视图预算,并且受约束的分阶段融合与质量加权视图选择对性能提升有贡献。运行时和内存测试进一步验证,系统运行速度高于传感器速率,额外开销可忽略不计。
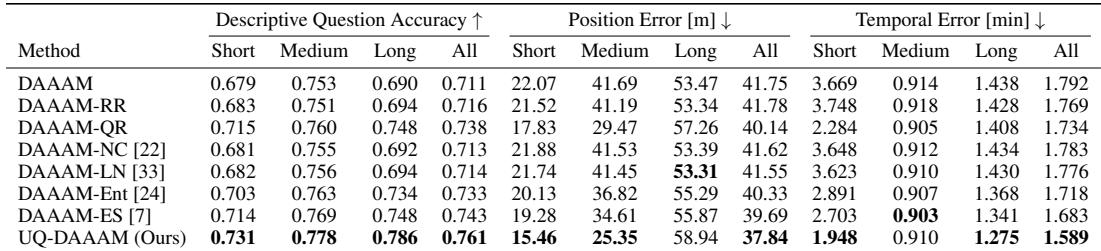
在 OC-NaVQA 上,DAAAM-QR 在比较方法中取得了最大的整体准确率提升和最低的整体位置误差,而 DAAAM-Ent 取得了最低的整体时间误差。随机细化和其他比较变体在准确率和误差指标上仍接近基线。位置误差收益集中在短时域和中时域,而长时域位置误差仍高于基线。DAAAM-QR 在所有时域上都提高了描述性问题的准确率,其中长问题的提升最大。DAAAM-QR 和 DAAAM-Ent 在短时域和中时域设置中降低了位置误差,但未改善长时域位置误差。DAAAM-Ent 取得了最低的整体时间误差,略优于 DAAAM-QR。DAAAM-RR、DAAAM-NC 和 DAAAM-LN 相对 DAAAM 几乎没有改进。
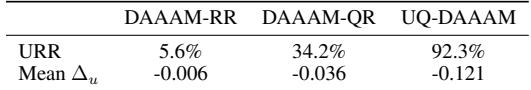
在固定细化预算下,UQ-DAAAM 比 DAAAM 变体更大幅度地降低不确定性。它的不确定性降低率最高,平均不确定性下降最大;DAAAM-RR 几乎未改变不确定性,DAAAM-QR 介于两者之间。在固定预算 B=2 下,UQ-DAAAM 实现了 92.3% 的不确定性降低率,而 DAAAM-QR 为 34.2%,DAAAM-RR 为 5.6%。平均不确定性降低也遵循相同的顺序:UQ-DAAAM 下降最大,DAAAM-QR 下降中等,DAAAM-RR 仅有轻微下降。
消融研究分离了细化预算、对象选择、视图选择、caption 融合和细化阈值的贡献。带有不一致性加权的完全基于不确定性的对象选择、质量加权视图选择、受约束分阶段融合以及适中阈值选择,都在提高准确率的同时降低了位置误差和时间误差。大部分细化收益在额外两个视图的预算下就已出现,之后收益递减。增加细化预算可提高准确率并降低位置误差和时间误差,大部分收益在 B=2 时实现,B=3 带来的额外收益较小。在对象选择规则中,完全不确定性选择表现最好,紧随其后的是无不一致性加权的不确定性,caption 离散度最低。质量加权视图选择产生了最强的视图细化结果,而随机视图选择明显降低性能,基于方向的启发式策略与质量加权策略表现接近。与不融合、仅初始视图融合、仅细化视图融合和无约束 LLM 融合相比,受约束分阶段融合取得了最佳的准确率和误差指标。随着阈值从第 10 百分位移动到第 30 百分位,细化性能有所提高,而第 40 百分位仅带来微小的额外收益,表明超过第 30 百分位后收益递减。

在 OC-NaVQA 基准上,DAAAM-QR 提供了最大的整体准确率提升和最低的位置误差,而 DAAAM-Ent 实现了最低的时间误差,改进主要集中在短时域和中时域,长时域位置误差提升有限。在固定细化预算下,UQ-DAAAM 比 DAAAM 变体更有效地降低不确定性,平均不确定性下降最大。消融结果表明,基于不确定性的对象选择、质量加权视图选择、受约束分阶段融合和适中阈值均能提高准确率并降低位置和时间误差,大部分细化收益在两个额外视图时实现,之后收益递减。