Command Palette
Search for a command to run...
WorldParticle:基于 Transformer 的拉格朗日粒子动力学统一世界模拟
WorldParticle:基于 Transformer 的拉格朗日粒子动力学统一世界模拟
摘要
构建一个无需针对特定求解器重新设计即可模拟多种物理现象的统一模拟器,是模拟科学领域的长期目标。我们提出了一种基于学习的粒子模拟器,其建立在单一 Transformer 架构之上,能够模拟布料、弹性固体、牛顿与非牛顿流体、颗粒材料以及分子动力学。该模型在共享的拉格朗日粒子表示上采用预测-校正设计。显式预测器首先在已知外力作用下推进粒子,生成一个能够刻画外部驱动运动但尚未包含粒子间相互作用的中间状态。随后,学习得到的校正器通过三个阶段预测残差位置和速度更新:粒子分词器编码局部粒子-粒子、粒子-边界以及拓扑引导的相互作用;超令牌编码器通过交替的自注意力和令牌合并,将粒子令牌分层聚合为一组紧凑的超令牌;超令牌解码器通过交叉注意力将超令牌恢复至粒子分辨率,从而预测每个粒子的位置和速度校正。渐进式令牌合并在编码器各层将令牌数量逐层减半,从而降低注意力计算成本,而解码器则通过紧凑的超令牌集合进行通信,而非全粒子对全粒子的注意力计算。在六类动力学类别中,同一架构能够泛化到未见过的材料、边界配置、初始条件和外力。我们进一步展示了其在交互式控制、逆向设计以及从真实世界操作数据中学习等下游任务中的应用,减少了对逐现象求解器工程的需求。
一句话总结
来自不列颠哥伦比亚大学、MIT CSAIL、佐治亚理工学院等机构的研究人员提出了 WorldParticle,这是一种统一的基于 Transformer 的拉格朗日粒子模拟器,采用预测-校正设计,通过粒子 tokenization、分层 super-token 编码与解码以及渐进式 token 合并来对布料、弹性固体、牛顿与非牛顿流体、颗粒材料和分子动力学进行建模,同时降低注意力成本,并支持下游控制、逆向设计以及从真实世界操作数据中学习。
核心贡献
- 一种统一的基于 Transformer 的粒子模拟器在单一架构中对布料、弹性固体、牛顿与非牛顿流体、颗粒材料和分子动力学进行建模,减少了对每种现象单独进行求解器工程的需求。
- 该方法在共享的拉格朗日粒子表示上使用预测-校正框架,将显式外力预测器与学习得到的校正器相结合,通过粒子 tokenization、带渐进式 token 合并的分层 super-token 编码以及 super-token 解码来预测残差位置和速度更新。
- 同一架构可泛化到未见过的材料、边界配置、初始条件和外力,并支持交互式控制、逆向设计以及从真实世界操作数据中学习等下游任务。
引言
在同一个框架中模拟多样化的物理现象是图形学、工程和分子建模中的长期目标,但传统求解器仍然高度专用:流体通常使用欧拉网格,固体使用拉格朗日有限元网格,而颗粒或原子系统使用粒子,这使得跨现象耦合变得困难。基于粒子的拉格朗日表示提供了一种通用状态格式,但仍依赖特定问题的本构关系和参数调优,且现有的学习型模拟器通常只针对单一现象设计,或绑定于固定几何。作者提出了一种基于粒子的预测-校正 Transformer,其架构在六种动力学类别中保持不变,包括布料、弹性固体、牛顿与非牛顿流体、颗粒材料和分子动力学。粒子 tokenizer 编码局部相互作用,而受多重网格启发的 super-token 编码器-解码器压缩 token 并恢复完整粒子分辨率,从而在每个校正步骤中提供全局通信。
方法
作者将拉格朗日粒子动力学的一个时间步建模为预测-校正过程。显式预测步骤对已知外力进行积分,产生一个中间状态,该状态考虑了外部加速度,但忽略粒子间相互作用。令 Xt,Vt,Ft∈RN×3 分别表示被模拟粒子的位置、速度和外力,并令 C∈RN×Cp 表示每个粒子的属性。静态边界粒子 (XB,CB) 表示墙壁或障碍物,T 表示可用的静止形状拓扑。预测步骤在一个时间步内对外力进行积分:
V~t=Vt+ΔtM−1Ft,X~t=Xt+2Δt(Vt+V~t)其中 M 为对角质量矩阵。然后,学习得到的校正步骤通过接收预测状态并输出残差更新来预测相互作用校正:
(ΔXt,ΔVt)=Fθ(X~t,V~t,C,T,XB,CB)从而得到 Xt+Δt=X~t+ΔXt 和 Vt+Δt=V~t+ΔVt。同时预测两个残差使模型能够表示来自隐式求解、接触投影、压力耦合和阻尼的效应。
校正器 Fθ 由三个主要组件组成,将通信分为局部尺度和全局尺度。如下图所示:
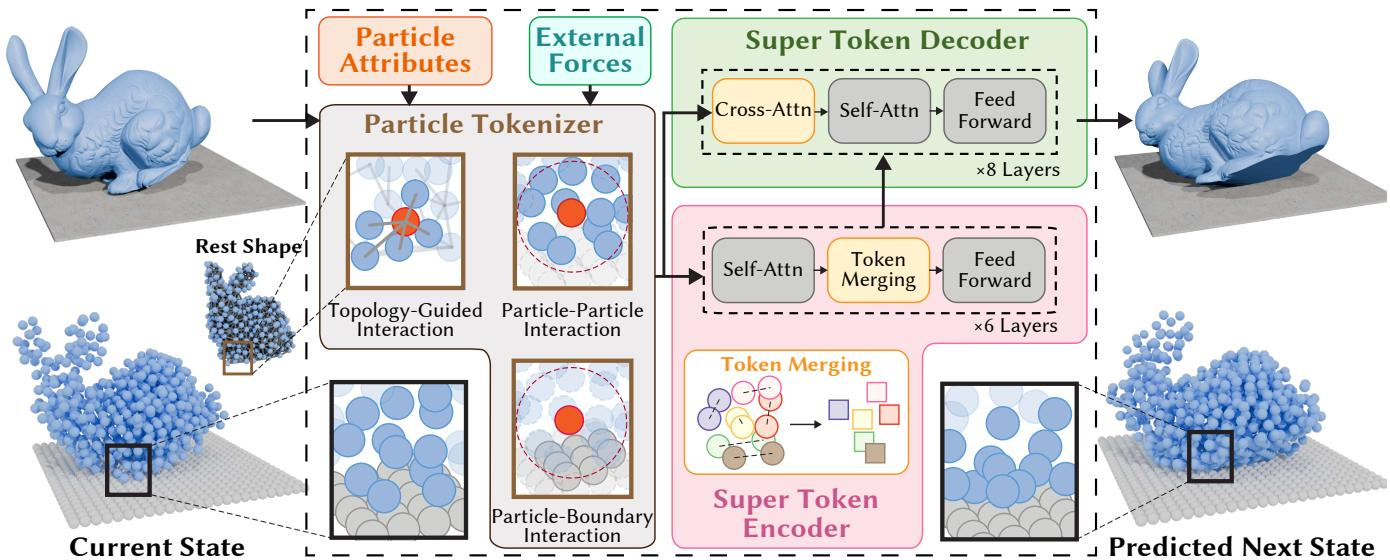
粒子 tokenizer 编码局部相互作用,super-token 编码器将粒子 token 压缩为动态生成的 super token,super-token 解码器将 super-token 信息提升回粒子分辨率,以产生位置和速度校正。
粒子 tokenizer 遵循粒子方法背后的局部性原理。对于每个粒子,它在紧凑邻域上评估相互作用:来自半径搜索的空间邻域、来自附近边界采样的边界邻域,以及由静止形状剖分邻接关系定义的拓扑邻域。每个分支通过可学习核 Wk 聚合邻居贡献,该核将相对位移映射为混合矩阵。粒子 token hi 将所有可用分支与粒子自身状态连接起来。
虽然粒子 token 捕获局部相互作用,但许多物理现象需要全局、长程通信。super-token 编码器通过在当前分辨率上交替进行全局自注意力和 token 合并来解决这一问题,其灵感来自分层粗化原理。每个编码器层首先应用带有三维旋转位置嵌入的多头自注意力,为所有 token 提供上下文。然后执行 token 合并,将序列长度减半。当前 token 被分成两个不相交的半部分,第一半中的每个 token 会贪婪地与第二半中余弦相似度最高的 token 进行匹配。token 合并过程可视化:
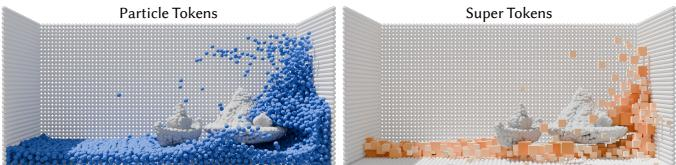
匹配的 token 对通过加权平均进行合并,未匹配的 token 保持原样。在合并之前应用自注意力,可确保每个 token 在当前尺度上下文中完成信息交换后再计算相似度。经过 Le 层后,剩余的 token 形成 super token,作为当前粒子系统的稀疏、可查询的潜在表示。
super-token 解码器通过 Ld 层将这一粗粒度上下文提升回粒子分辨率。来自 tokenizer 的原始粒子 token 和位置会直接传递给解码器。在每个解码器层中,粒子 token 通过交叉注意力查询 super token,然后进行自注意力以细化 token。所有注意力模块都使用三维旋转位置嵌入、残差连接和前馈网络。最后一个逐粒子 MLP 将细化后的 token 映射为位置和速度校正。
在训练方面,作者在所有动力学类别中使用相同的架构,并为每个类别训练一个网络。从初始真实状态开始,他们对预测-校正更新进行自回归展开,展开窗口包含多个状态,并将每个预测状态作为输入反馈。预测状态通过真实状态进行监督。训练损失结合了在展开过程中平均的每粒子、每步位置和速度误差,以及可选的物理约束损失,例如不可压缩流体的无散度正则化项。
实验
实验在六个类别上评估所提出的粒子动力学模型,包括流体、布料、沙子、非牛顿材料、弹性固体和蛋白质,使用来自成熟求解器的数据,并测试不同的材料参数、初始条件和边界。比较结果表明,该模型在长时间展开中保持稳定,而基线方法会出现漂浮粒子、布料爆炸和相互穿透;泛化实验表明该模型对未见过的初始条件和边界条件、更长的预测范围、新几何形状以及不同的粒子密度具有鲁棒性。消融实验证实,将局部 tokenization 与全局 super-token 通信相结合对于准确动力学至关重要,而物理信息正则化有助于减少发散,同时保持轨迹质量。其他应用展示了交互式力控制、通过可微分展开进行逆向设计,以及从真实世界点云观测中学习。
实验比较了六个粒子动力学类别的准确性和推理成本。布料和蛋白质模拟相对高效且准确,而流体展开的位置和速度误差明显大于所有其他类别。沙子和非牛顿流体的每步计算成本最高、吞吐量最低。流体动力学的展开误差远大于其他材料,位置和速度误差都高得多。布料在所有评估类别中实现了最快的推理速度和最低的每步计算成本。在测试系统中,蛋白质动力学在位置和速度误差方面最为准确。沙子和非牛顿流体的每步计算成本最高、帧率最低。
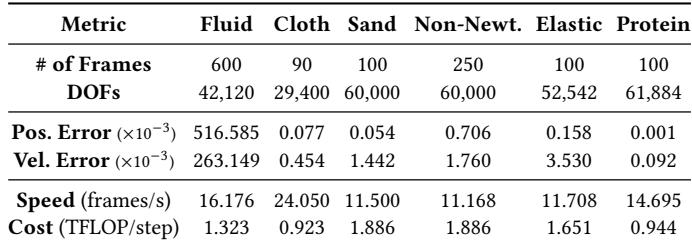
实验评估了六个粒子动力学类别的准确性和推理成本。布料和蛋白质是最高效且最准确的,其中布料实现了最快的推理速度和最低的每步计算成本,而蛋白质在位置和速度精度上表现最佳。流体展开显示的误差最大,而沙子和非牛顿流体的每步计算成本最高、帧率最低。