Command Palette
Search for a command to run...
语言模型对齐的理论极限
语言模型对齐的理论极限
Lucas Monteiro Paes Natalie Mackraz Barry-John Theobald Federico Danieli
摘要
语言模型(LM)对齐旨在改进模型输出以反映人类偏好,同时保留基座模型的能力。最常见的对齐方法包括:(i)强化学习,在 KL 散度约束下最大化期望奖励;(ii)best-of-N 对齐,从 N 个独立样本中选择奖励最高的输出。尽管这些方法被广泛使用,但在 KL 预算下奖励改进的基本极限仍未被充分理解。我们通过推导固定 KL 散度预算下可实现的最大期望奖励增益,刻画了 KL 正则化对齐的信息论极限。我们的第一个结果给出了最优奖励改进的闭式表达式,该表达式由 Jeffreys 散度项决定,而非先前分析中所用的 KL。我们进一步将该表达式重新表述为基座模型下的协方差,从而得到一个实用的估计器,能够仅凭基座模型样本预测可实现的对齐增益。我们将分析扩展到代理奖励设定,表明理想对齐与代理对齐之间的差距(奖励黑客行为)随奖励误差的增大以及 KL 惩罚因子的减小而扩大。随后我们证明奖励集成能够缓解奖励黑客行为,为这一实践中所用技术提供了理论依据。在实证方面,我们针对语言模型的两项任务——安全性和摘要——计算了 KL–奖励帕累托前沿,并表明 best-of-N 能够接近理论极限,而 PPO 和 GRPO 仍明显次优。我们的理论结果阐明了对齐文献中若干经验观察到的现象,并表明需要算法层面的改进,才能在不付出高昂推理成本的情况下实现最优对齐。
一句话总结
Apple 研究人员通过推导一个由 Jeffreys 散度而非 KL 决定的闭式最优期望奖励增益,以及一个基于基础模型样本的协方差估计量,刻画了 KL 正则化语言模型对齐的信息论极限,并证明奖励集成可缓解代理奖励黑客行为,而 best-of-N 在安全与摘要任务上接近理论帕累托前沿,PPO 和 GRPO 则不然。
核心贡献
- 该工作推导了 KL 正则化对齐下最优奖励提升的闭式表达式,表明其由 Jeffreys 散度项决定,而非此前推测的平方根 KL 缩放。
- 该工作将 Jeffreys 散度重构为基础模型下的协方差,得到一致估计量,从而仅凭基础模型样本即可恢复完整的 KL-奖励帕累托前沿。安全与摘要任务的实证结果显示,best-of-N 采样紧贴该前沿,而 PPO 和 GRPO 仍为次优。
- 该工作将分析扩展到代理奖励,证明黄金奖励与代理奖励对齐之间的差距随奖励均方误差和 KL 惩罚倒数增长,并表明奖励集成以 O(n−1/2) 收敛速度可证明地缓解奖励黑客行为。
引言
大型语言模型通常通过 KL 正则化强化学习或相关偏好方法进行对齐,以减少有害输出,但在固定 KL 散度预算下可达到的理论最大奖励仍不清楚。先前工作仅提供不可达上界,或依赖对语言模型或奖励模型的限制性假设。作者刻画了对齐的精确基本极限,表明最优奖励增益等于 KL 惩罚乘以 Jeffreys 散度,并将该量重新表述为可在对齐前仅从基础模型估计的协方差。这提供了一种有原则的方法,可将对齐方法与真实奖励-KL 帕累托前沿进行基准比较,同时也支持对代理奖励和奖励集成的理论分析。
方法
作者建立了一个综合理论框架,用于计算在 KL 散度惩罚下大型语言模型对齐的基本极限。他们不依赖经验训练来评估对齐性能,而是推导了闭式信息论界,并开发了仅需未对齐基础模型样本的可计算估计量。该方法使实践者无需执行任何对齐训练即可绘制奖励增益与 KL 散度的理论帕累托前沿。
为了刻画最优奖励提升,作者首先证明对齐后的奖励增益完全由 Jeffreys 散度决定,该散度是基础策略与对齐策略之间前向和反向 KL 散度之和。最优奖励提升由 λJD(πbase∣∣πr,λ) 刻画。超越不可计算的上界,他们证明期望奖励增益可以表示为基础策略下的协方差:
Δ(r,r′)=Covπbase(⋅∣x)(r′,Eπbase(⋅∣x)[er(x,y)/λ]er(x,y)/λ)该协方差形式至关重要,因为它将计算从最优对齐模型转移到可访问的基础模型和奖励模型。
在这一理论基础上,作者通过为期望奖励增益和相应 KL 散度引入蒙特卡洛估计量,使协方差刻画可操作化。通过从基础策略中抽取独立同分布样本,这些估计量计算配分函数和联合奖励项,以近似理论极限。作者正式证明这些估计量是一致的,并随着基础模型样本数量增加在概率上收敛到真实理论值。这一收敛保证确保仅使用有限的基础模型生成即可可靠估计整个帕累托前沿。
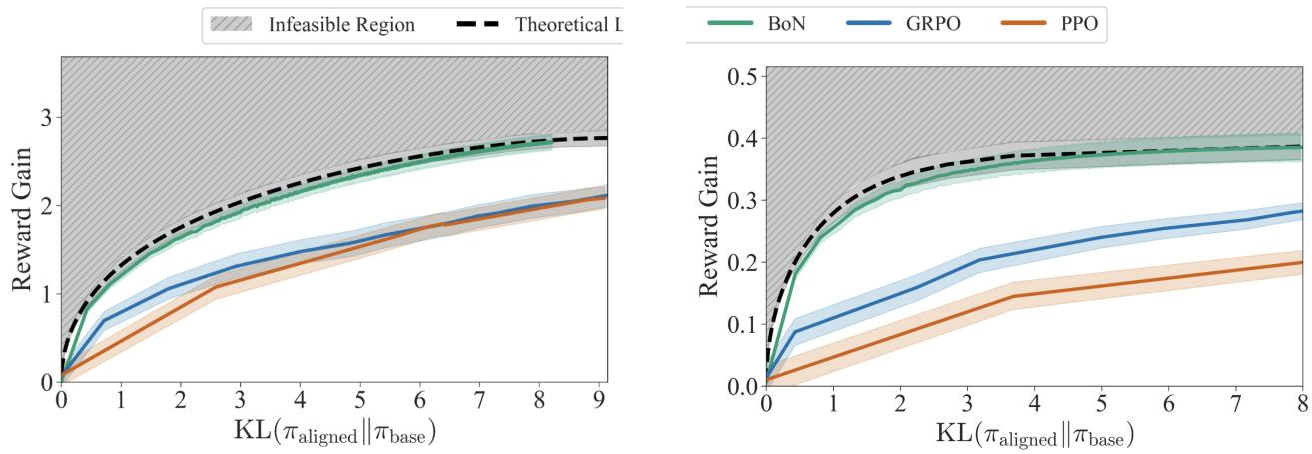
请参考下方框架图,直观理解理论极限与经验对齐算法的比较。
如图所示,理论帕累托前沿定义了在任意给定 KL 预算下可达到的绝对最大奖励。作者使用该框架对现有对齐方法(如 Best-of-N、GRPO 和 PPO)进行基准测试,揭示 Best-of-N 在整个权衡曲线上紧贴理论极限,而其他方法仍为次优。
此外,作者将其框架扩展到分析使用不完美代理奖励而非黄金奖励的实际挑战。他们形式化偏好残差的概念,以量化代理奖励与黄金奖励之间的差异。通过该形式化,他们证明由奖励黑客行为引起的性能退化由偏好残差的指数项控制。这一理论洞见明确说明为何针对代理奖励的激进对齐会导致严重的奖励黑客行为,尤其是当 KL 惩罚较小时。
为应对这一脆弱性,作者为奖励集成提供了形式化论证。他们建立了一个确定性 Lipschitz 界,将两个对齐模型之间期望奖励的差异与其底层奖励函数之间的距离联系起来。通过将该界应用于集成平均,他们证明集成多个代理奖励可缓解奖励黑客行为。具体而言,他们表明,对一个代理奖励集成进行对齐的模型的期望奖励以 O(n−1/2) 的期望速率收敛到最优黄金奖励期望。这一理论保证解释了奖励集成的经验成功,并提供了一种有原则的策略来对抗代理奖励残差引起的指数级退化。
实验
实验在 Reddit TL;DR 摘要和 BeaverTails 安全任务上评估理论 KL 与奖励极限,使用 Pythia-1B 和 Zephyr-7B 模型,并比较 GRPO、PPO 和 best-of-N。所提出的奖励增益和 KL 估计量在几千个基础模型样本内可靠收敛,确认帕累托前沿可在对齐训练前估计。Best-of-N 在不同 KL 预算下仍接近理论前沿,而 GRPO 和 PPO 显著低于该前沿,表明当前 KL 正则化强化学习方法仍留下了可观的奖励增益空间。