HyperAI
Command Palette
Search for a command to run...
Step-Audio-EditX 技术报告
Step-Audio-EditX 技术报告
摘要
我们提出 Step-Audio-EditX,这是首个基于大语言模型(LLM)的开源音频模型,能够实现富有表现力且支持迭代式音频编辑,涵盖情感、语调风格及副语言特征,并具备强大的零样本文本到语音(TTS)能力。其核心创新在于仅依赖大间隔(large-margin)合成数据,从而无需使用基于嵌入的先验信息或辅助模块。这种大间隔学习方法不仅实现了对语音的迭代式控制,还显著提升了语音表现力,标志着从传统上强调表征层面解耦的范式向全新方向的根本性转变。评估结果表明,Step-Audio-EditX 在情感编辑及其他细粒度控制任务中,均优于 MiniMax-2.6-hd 与 Doubao-Seed-TTS-2.0。
# 一句话总结
StepFun 推出 Step-Audio-EditX,这是首个开源的、基于 LLM 的强化学习音频模型,通过在 post-training 阶段仅使用大间隔合成数据,实现富有表现力的迭代式音频编辑和零样本 TTS,从而规避了基于嵌入的先验,并在情感编辑方面超越了 MiniMax-2.6-hd 和 Doubao-Seed-TTS-2.0。
# 核心贡献
- Step-Audio-EditX 是首个开源的、基于 LLM 的强化学习音频模型,用于情感、说话风格和副语言的高表现力迭代编辑,在情感编辑和细粒度控制任务上超越了 MiniMax-2.6-hd 和 Doubao-Seed-TTS-2.0。
- 仅在大间隔合成数据上进行 post-training,即可控制情感和说话风格,规避了对基于嵌入的先验或辅助模块的需求。
- 大间隔学习方法能实现跨声音的迭代控制和高表现力,这代表了从传统表示级解耦的根本性转变。
# 引言
最近的零样本文本到语音系统可以基于参考提示生成自然的语音,但它们会将情感、风格、口音和音色等属性锁定在该提示上,从而无法进行独立控制。在输入文本前添加风格或情感指令提供了部分可控性,但是当克隆的声音无法可靠地遵循指令时,这种方法往往无法解耦属性。作者提出了一种数据驱动的方法,该方法绕过了对抗训练或复杂表示建模的需要。他们设计了一个流程,用于创建高质量的训练对,其中语言内容保持不变,而目标属性显著变化,然后使用大间隔数据对这些训练对上的大语言模型进行 post-training。由此产生的模型 Step-Audio-EditX,是首个无需额外适配器模块,即可支持情感、说话风格和副语言的高表现力迭代编辑,以及稳健的零样本 TTS 的开源 LLM 音频模型。迭代编辑可以逐步增强或减弱目标属性,并且该方法可扩展到语速调整、降噪和静音修剪。
# 数据集
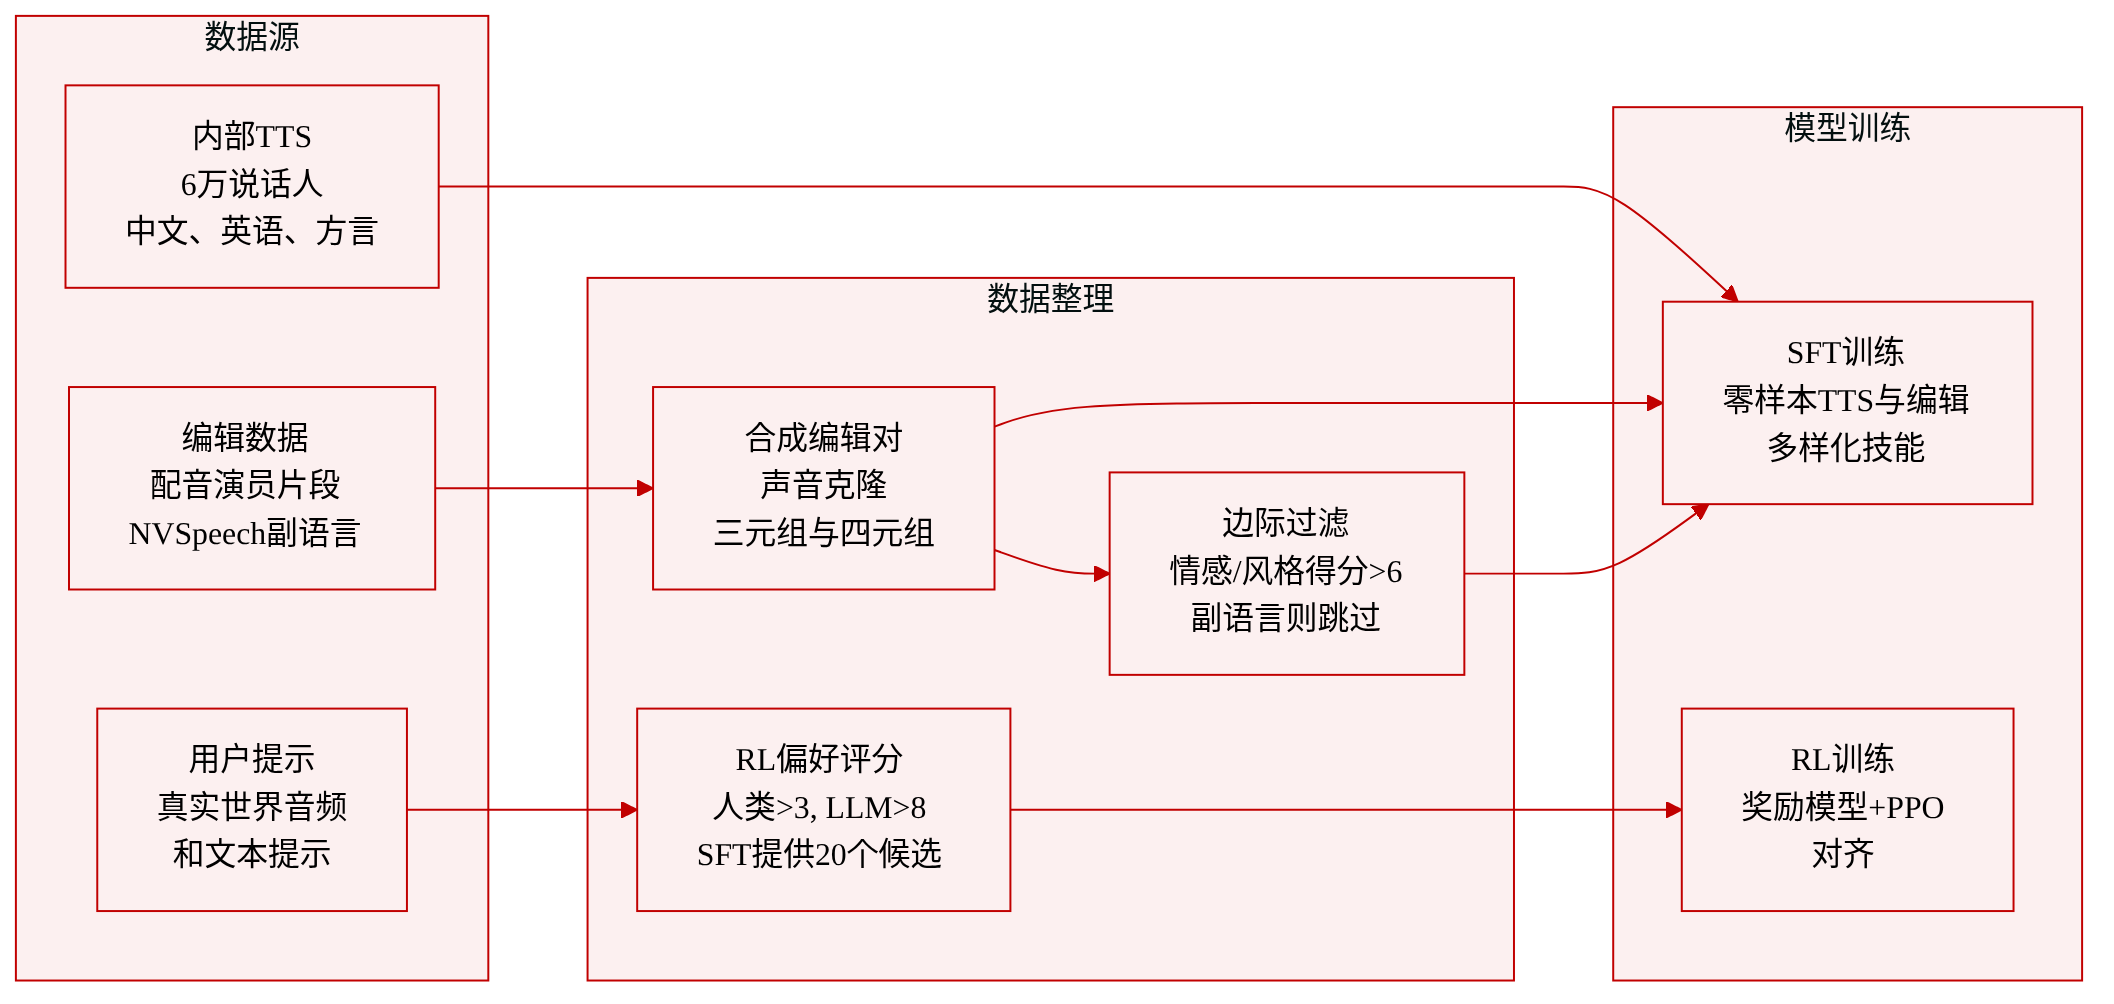
作者从两个主要分支构建了用于 Step‑Audio‑EditX 的 post‑training 数据集:监督微调(SFT)数据和强化学习(RL)偏好数据。所有数据工作都针对零样本文本到语音(TTS)和音频编辑能力。
**SFT 数据**
- **零样本 TTS** – 一个高质量、经专业标注的内部语料库,覆盖中文和英文,并包含少量用于方言支持的粤语和四川话。该数据集涵盖了约 60,000 个独特说话人,捕捉了说话人内和说话人间的差异,以确保多样化的表现力和稳健的零样本性能。
- **情感和说话风格编辑** – 一种大间隔合成方法:配音演员为每种情感/风格组合录制一个约 10 秒的片段。这些片段被用于零样本克隆流程(StepTTS),构建 (文本提示, 中性音频, 情感/风格音频) 的三元组。一个小型人工标注评分模型在一个 1-10 的尺度上对每个三元组评分;仅保留间隔分数高于 6(根据情感/风格调整)的样本。这种策略将复杂的情感描述转化为比较对,同时保持数据收集成本较低。
- **副语言编辑** – 一种使用 NVSpeech 语料库的半合成构建,该语料库包含丰富的副语言标注(例如,呼吸、笑声、填充停顿)。通过将原始 NVSpeech 音频/文本与一个移除副语言标签的版本配对,并通过语音克隆生成中性音频,构建四元组。由于该任务是具有较大固有间隔的时域编辑,因此不应用间隔评分,并且少量四元组就足以激发此能力。
**RL 偏好数据**
- **人工标注** – 收集真实世界的用户提示和音频。SFT 模型为每个提示生成 20 个候选回复。人工标注者在一个 5 分制上对每个回复的正确性、韵律和自然度进行评分。仅选择评分间隔大于 3 的被选/被拒对。
- **LLM 作为评判者** – 一个理解模型在一个 1-10 的尺度上对情感和风格编辑回复进行评分。基于这些分数形成偏好对,仅保留间隔超过 8 分的对。
**用途**
SFT 子集被直接用于灌输零样本 TTS 和多样化的编辑技能。RL 偏好对(人工和 LLM 评判)被用于训练奖励模型,并随后用于 PPO 对齐。未报告明确的混合比例;重点在于大间隔过滤和合成数据构建,以避免昂贵的人工标注。
# 方法
系统架构集成了三个核心组件:一个双码本音频 tokenizer,一个音频大语言模型(LLM)和一个音频解码器。音频 tokenizer 使用两个并行码本将参考或输入音频转换为离散 token。一个语言码本以 16.7 Hz 运行,词汇量大小为 1024,而一个语义码本以 25 Hz 运行,具有 4096 个码,以 2:3 的比例交错排列。这种双码本设计有意保留了大量的情感、韵律和副语言信息,这对于纯粹的内容解耦来说是一个限制,但对于验证大间隔 post-training 策略却是一个有用的特性。
音频 LLM 是一个 3B 参数模型,它从一个基于文本的 LLM 初始化,以利用其强大的语言能力。它在以 1:1 比例混合文本和音频双码本 token 的混合数据集上进行训练。该模型以聊天格式处理文本 token 及其对应的音频 token,仅生成双码本 token 序列作为输出。这种设计允许模型在统一的框架下同时处理零样本文本到语音和各种编辑任务,直接受益于为文本 LLM 开发的 post-training 技术。
音频解码器从预测的双码本 token 重建波形。它由一个建立在扩散 transformer 主干上的流匹配模块和一个 BigVGANv2 声码器组成。流匹配模块以输出的音频 token、参考音频和说话人嵌入为条件生成梅尔频谱图,之后声码器将其转换为音频。该流匹配模块在 200,000 小时的高质量语音上训练,在发音准确度和音色相似度方面取得了显著提升。
为了使模型能够执行情感和说话风格编辑,作者设计了一个大间隔合成数据流程。配音演员为每种情感和风格录制一个大约 10 秒的片段。对于每种组合,通过使用来自同一说话人的相应情感和中性片段作为提示音频,并通过带有描述目标属性的文本指令的零样本语音克隆接口合成输出,创建一个三元组 $\langle text_{prompt}, audio_{neutral}, audio_{emotion,style} \rangle$。一个在小型人工标注数据集上训练的间隔评分模型,在一个 1-10 的尺度上评估每对,并使用间隔分数阈值(通用下限为 6,根据情感和风格调整)选择样本。因为在监督微调期间,每个三元组都是从相同的情感或风格文本提示生成的,所以模型被迫专注于情感和风格的变化。
对于副语言编辑,一个“半合成”策略构建四元组 $\langle text_{without\_tags}, audio_{without\_tags}, text_{nv\_source}, audio_{nv\_source} \rangle$。原始 NVSpeech 音频和文本作为目标输出,而输入是通过在移除副语言标签后克隆原始文本生成的,这会生成一个缺少这些线索的音频版本。由于副语言编辑在时域中操作并表现出较大的固有间隔差异,因此不需要间隔评分模型;少量四元组就足以激发所需的编辑能力。
post-training 对齐分两个阶段进行:监督微调(SFT)之后是强化学习。在 SFT 中,模型以聊天格式使用不同的系统提示进行训练。对于零样本 TTS,提示波形被编码为双码本 token,再解码成字符串,并嵌入到系统提示的说话人信息中;用户提示包含要合成的文本,模型则用生成的音频 token 进行回复。对于编辑任务,统一的系统提示定义所有操作,用户提示提供原始音频和描述性编辑命令。模型进行一个 epoch 的微调,学习率从 $1 \times 10^{-5}$ 衰减到 $1 \times 10^{-6}$。
强化学习进一步提高了零样本 TTS 的稳定性以及编辑表现力,尤其是在源提示和目标输出在情感或风格上差异很大时(例如,高兴到悲伤,大声到耳语)。奖励模型从 3B 的 SFT 模型初始化,并使用 Bradley-Terry 损失,结合人工标注和 LLM 作为评判者生成的大间隔数据进行训练。它作为一个 token 级别的奖励模型,作用于双码本 token 对,避免了在奖励计算期间将 token 解码回音频的需要。奖励模型进行一个 epoch 的微调,采用余弦衰减学习率,起始值为 $2 \times 10^{-5}$,下限为 $1 \times 10^{-5}$。然后,使用对 SFT 模型最具挑战性的提示进行近端策略优化(PPO)。在 actor 开始训练前,critic 模型预热 80 步。actor 使用 $1 \times 10^{-6}$ 的初始学习率,余弦衰减至 $2 \times 10^{-7}$,PPO 裁剪阈值 $\epsilon = 0.2$,以及系数为 $\beta = 0.05$ 的 KL 散度惩罚。
大间隔方法自然地扩展到下游任务。对于语速编辑,通过使用 SoX 工具包进行语速扰动,创建三元组 $\langle text, audio_{source}, audio_{faster,slower} \rangle$,并且显著的 token 长度差异使得仅靠 SFT 就能进行有效编辑。对于降噪,通过向源音频添加噪声和混响,构建三元组 $\langle text, audio_{augment}, audio_{source} \rangle$。对于静音修剪,三元组 $\langle text, audio_{source}, audio_{trimming} \rangle$ 使用 Silero-VAD 提取并连接语音片段,移除静音部分。这些扩展展示了配对样本之间的足够间隔如何使模型通过 SFT 快速获得新的编辑能力,并可选择性地对具有挑战性的情况应用强化学习。
# 实验
评估在一个基准上进行,该基准使用 LLM 评判者来评估来自多个说话人的零样本克隆语音的情感、说话风格和副语言编辑。迭代编辑显著提高了情感和风格准确度,即使单次副语言编辑也达到了很强的性能,并且一致地泛化到闭源 TTS 系统;消融研究证实大间隔方法是收益的来源。该模型通常优于闭源模型的本地情感控制,并且整体方法在所有编辑任务中实现了高准确度和稳健的泛化。
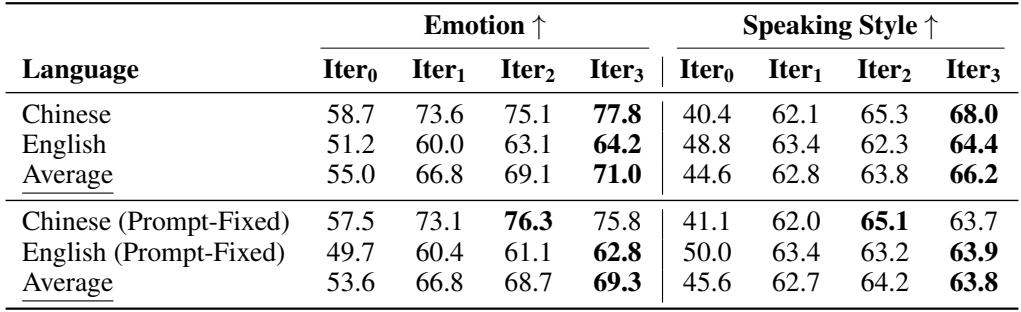
将编辑模型应用于零样本克隆音频,大幅提升了情感和说话风格准确度。第一次编辑迭代提供了最显著的增益,随后的轮次带来了进一步的、较小的改进。即使提示音频保持固定,准确度也继续上升,确认了编辑机制本身驱动了增强。第一次编辑迭代为情感和说话风格产生了最大的准确度跃升。在提示音频固定的情况下,每个编辑轮次的准确度仍然提高,表明编辑过程是稳健的。说话风格准确度遵循类似趋势,在初次编辑后急剧上升,并通过后续迭代继续增加。
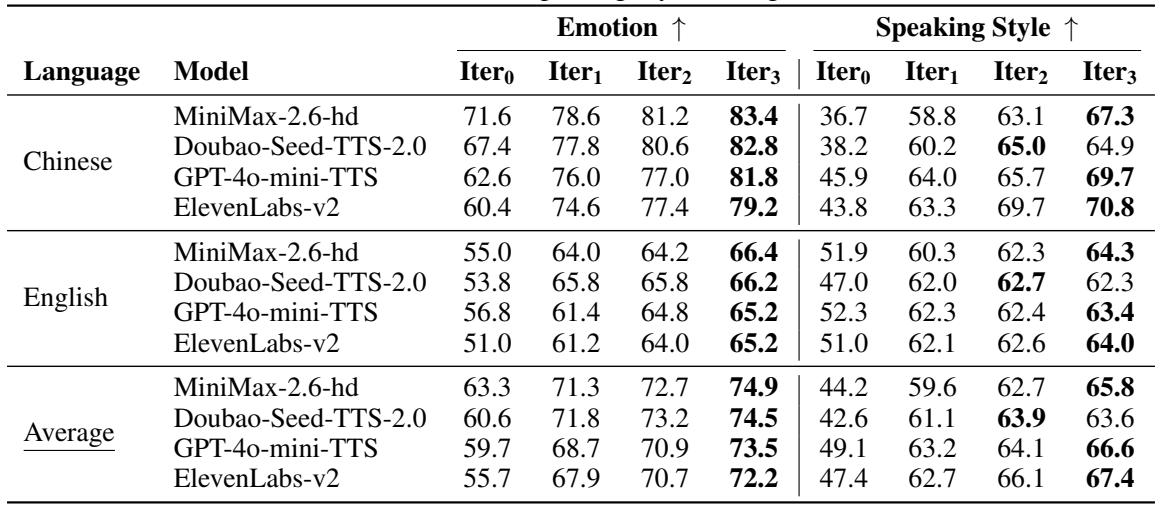
闭源 TTS 模型表现出适度的上下文情感和风格表达,但使用所提模型的单次编辑即可为情感和说话风格带来大幅准确度提升。增益在第一次迭代中最为显著,后续编辑进一步完善输出,准确度在第三次迭代中稳步上升。这种模式在所有测试的中文和英文语音模型中都成立,展示了强大的泛化能力。第一次编辑迭代在每个闭源系统的情感与说话风格准确度上都产生了巨大的提升。说话风格准确度从初始零样本克隆到第一个编辑版本,在绝对值上获得了尤其大的增益。迭代编辑继续改善这两个指标,尽管增量收益在第一次编辑后递减。
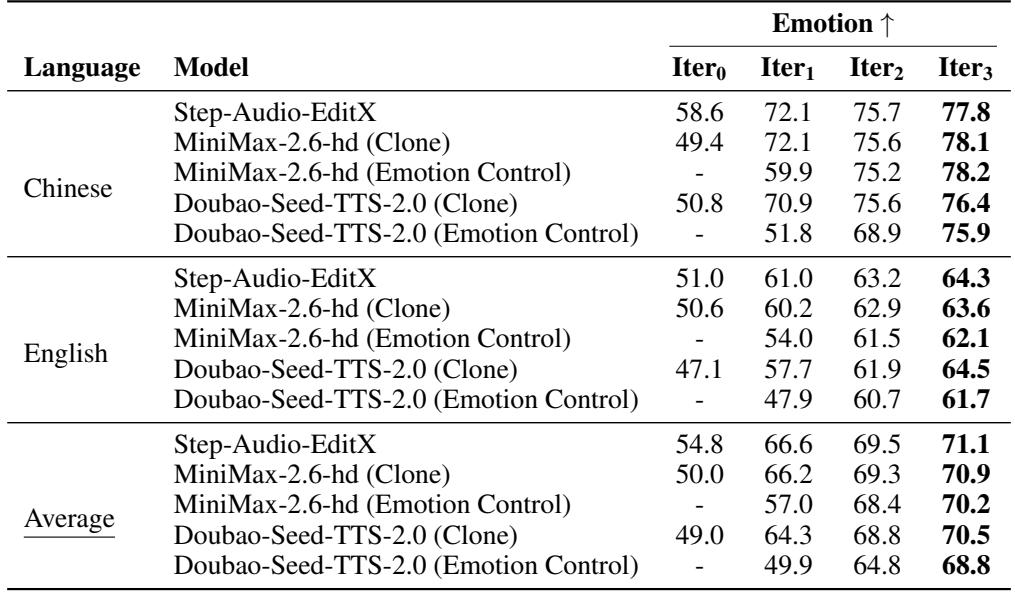
Step-Audio-EditX 的零样本克隆实现了比闭源 MiniMax 和 Doubao 克隆更高的初始情感准确度。单次编辑迭代显著提升了所有模型的情感准确度,并且编辑后的零样本克隆优于闭源系统的本地情感控制输出。连续的编辑轮次继续提高情感准确度,证明了迭代优化的有效性。Step-Audio-EditX 的零样本克隆产生了比 MiniMax 和 Doubao 克隆更高的基线情感准确度。一次编辑迭代为所有模型在中英文上都带来了巨大的情感准确度增益。使用一次迭代编辑零样本克隆,其情感准确度超过了闭源模型本地情感控制的效果。迭代编辑进一步提高情感准确度,每个额外轮次都贡献了增量收益。
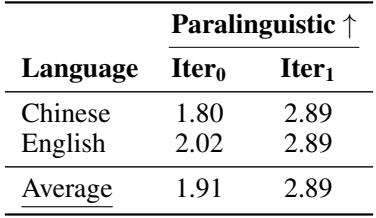
使用 Step-Audio-EditX 的单次编辑迭代显著改善了副语言复现,将一个 1-3 分制上的 LLM 评判者平均分从 1.91 提高到了 2.89。这一增益对中英文都成立,并且编辑后的质量可与闭源模型的本地副语言合成相媲美。一次编辑轮次将副语言分数从低基线提升到接近上限,中文从 1.80 提高到 2.89,英文从 2.02 提高到 2.89。编辑后,副语言性能与闭源模型直接合成副语言语音时的性能相当,展示了强大的泛化能力。
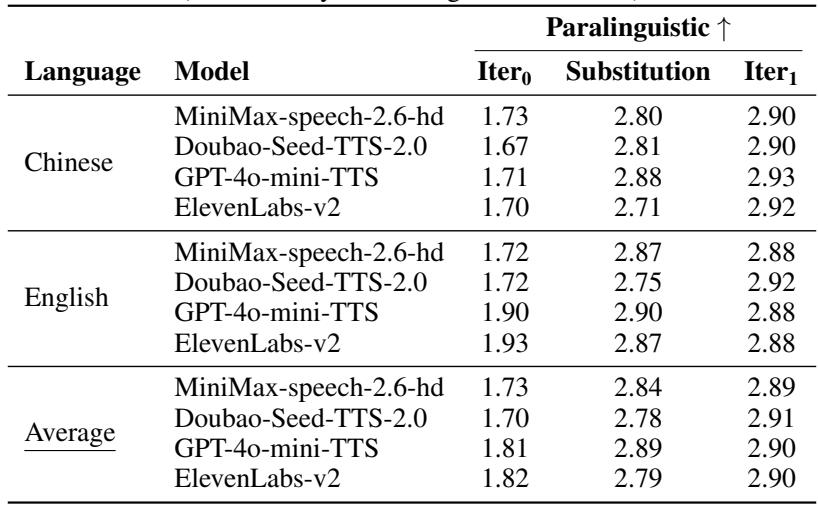
使用 Step-Audio-EditX 的单次副语言编辑迭代,在闭源 TTS 模型的中英文上显著提升了副语言复现效果。编辑后,分数在 1-3 分制上从未编辑音频的约 1.7 上升到约 2.9,达到了与模型本地副语言合成相当的质量。在编辑前将副语言标签替换为拟声词也取得了强劲的结果,尽管略低于直接编辑移除标签的音频。一次编辑迭代将所有测试模型和语言的副语言准确度从约 1.7 提高到约 2.9(1-3 分制)。编辑不含副语言标签的初始音频,其效果略优于拟声词替换方法(例如,对于中文 MiniMax,为 2.90 对比 2.80)。编辑后的副语言质量与闭源模型自身的本地副语言合成相当。
编辑模型为零样本克隆音频的情感和说话风格准确度带来了巨大的飞跃,第一次编辑迭代提供了最显著的增益,随后的轮次则带来了进一步的、较小的改进。这种模式在其自身的克隆和闭源 TTS 系统上都成立,单次编辑就始终将情感和副语言复现提升到可与模型本地控制能力匹敌或超越的水平。即使提示音频保持固定,这种增强也是稳健的,证实了迭代编辑机制本身驱动了改进,并且该方法在中英文上具有很强的泛化能力。