Command Palette
Search for a command to run...
PROFBENCH:多领域评分标准要求专业知识进行回答与评判
PROFBENCH:多领域评分标准要求专业知识进行回答与评判
Zhilin Wang Jaehun Jung Ximing Lu Shizhe Diao Ellie Evans Jiaqi Zeng Pavlo Molchanov Yejin Choi Jan Kautz Yi Dong
ProfBench 专业基准数据集
摘要
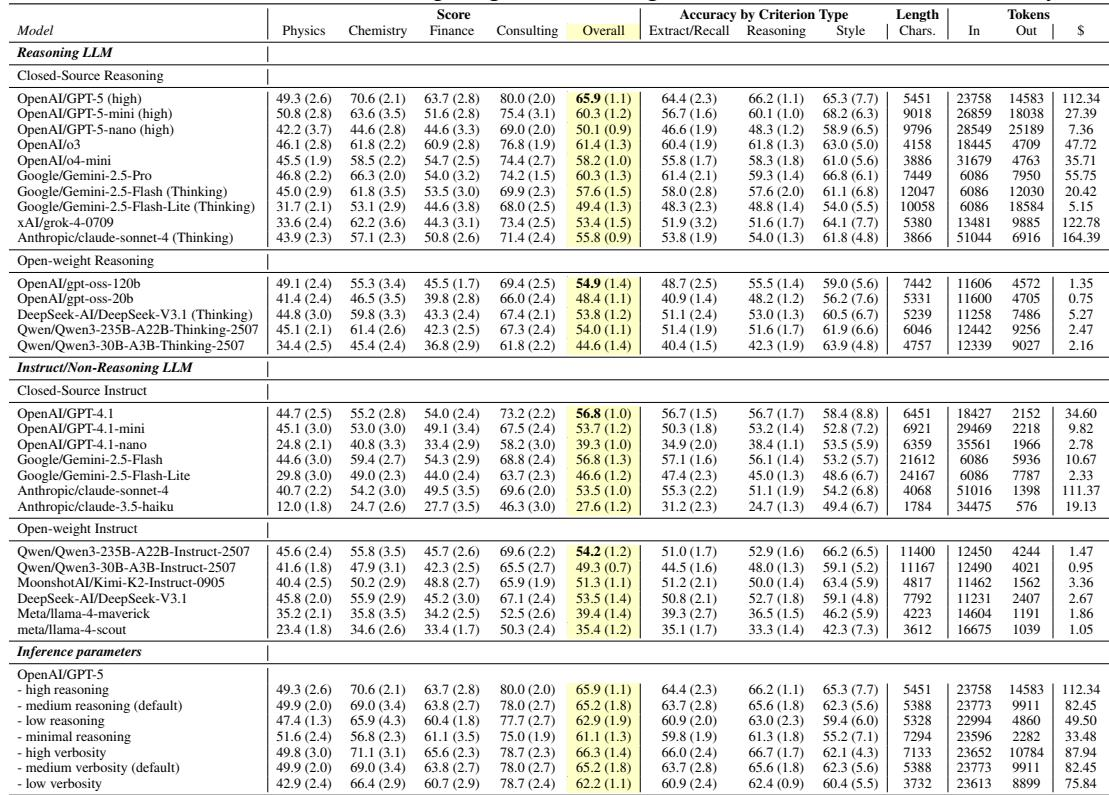
评估大型语言模型(LLM)的进步常常受限于验证响应的挑战,从而将评估局限于数学、编程和简短问答等任务。然而,许多现实应用要求评估LLM在处理专业文档、综合信息以及根据用户查询生成全面报告方面的能力。我们引入了ProfBench:一套包含超过7000个响应-标准配对的数据集,由具备专业知识的专家(涵盖物理学博士、化学博士、金融MBA和咨询MBA)进行人工评估。我们通过缓解自我增强偏差并将评估成本降低2-3个数量级,构建了稳健且经济高效的LLM评判器,以评估ProfBench评分标准,使其公平且可供更广泛的社区使用。我们的研究结果表明,即使是最先进的LLM,面对ProfBench也面临显著挑战,顶尖模型如GPT-5-high仅达到65.9%的总体性能。此外,我们识别了专有模型与开放权重模型之间的显著性能差距,并探讨了扩展思考在应对复杂专业知识领域任务中所起的作用。
一句话总结
来自NVIDIA的研究人员提出了ProfBench,这是一个包含超过7,000条专家评审标准的标准基准测试,涵盖物理博士、化学博士、金融MBA和咨询MBA领域,同时提供了廉价的LLM评判模型,将评估成本降低了2–3个数量级,并揭示出像GPT-5-high这样的顶级模型仅能达到65.9%的总体性能。
核心贡献
-
本文介绍了ProfBench,一个基于评分标准的标准基准测试,涵盖四个专业领域(物理博士、化学博士、金融MBA和咨询MBA),包含超过7,000条专家创建的响应-标准对,并表明即使是最强模型GPT-5-high也仅能达到65.9%的总体性能,展示了该基准测试对最先进LLM的难度。
-
本文评估了超过40个模型,既作为响应生成器也作为LLM评判模型,涉及这些专业任务,并分析了与开放权重模型和专有模型、推理变体和指令变体以及模型规模相关的性能趋势。
-
本文提出了偏差缓解方法,将LLM评判模型中的自我增强偏差降至最多1%(涵盖三家提供商),并将评估成本降低了2至3个数量级(使用o3模型大约花费$12),使该基准测试对更广泛的社区具有实用性和可访问性。
引言
带验证奖励的强化学习(RLVR)在正确性易于检查的任务中已被证明是有效的,例如竞赛数学或通过单元测试的代码,但它难以扩展到具有独特且明确答案的领域之外。基于评分标准的评分方法将复杂问题分解为强力响应必须满足的明确标准,为评估开放式的、具有专业意义的任务提供了一条路径。该方向的先前工作要么覆盖了狭窄的领域集合(健康、机器学习),要么受困于存在缺陷的基准测试:DeepResearch-Bench RACE包含许多受过教育的通才通过基本网络搜索即可回答的问题,并且依赖合成生成的评分标准,这些标准从未经过人类专家验证,导致对同时生成标准和参考答案的模型产生可测量的偏差。作者引入ProfBench以解决这些差距。这是第一个拥有专家创建评分标准的基准测试,涵盖化学、物理、咨询和金融领域,由具有博士学位或MBA级别专业知识的在职专业人员整理,包含超过7,000条响应-标准对。作者在答案生成和基于评分标准的评判两个任务上评估了超过40个模型,并提出了减少LLM评判模型提供商偏差的技术,将评估成本降低2至3个数量级,使该基准测试比现有评分标准框架更易访问、更公平。
数据集
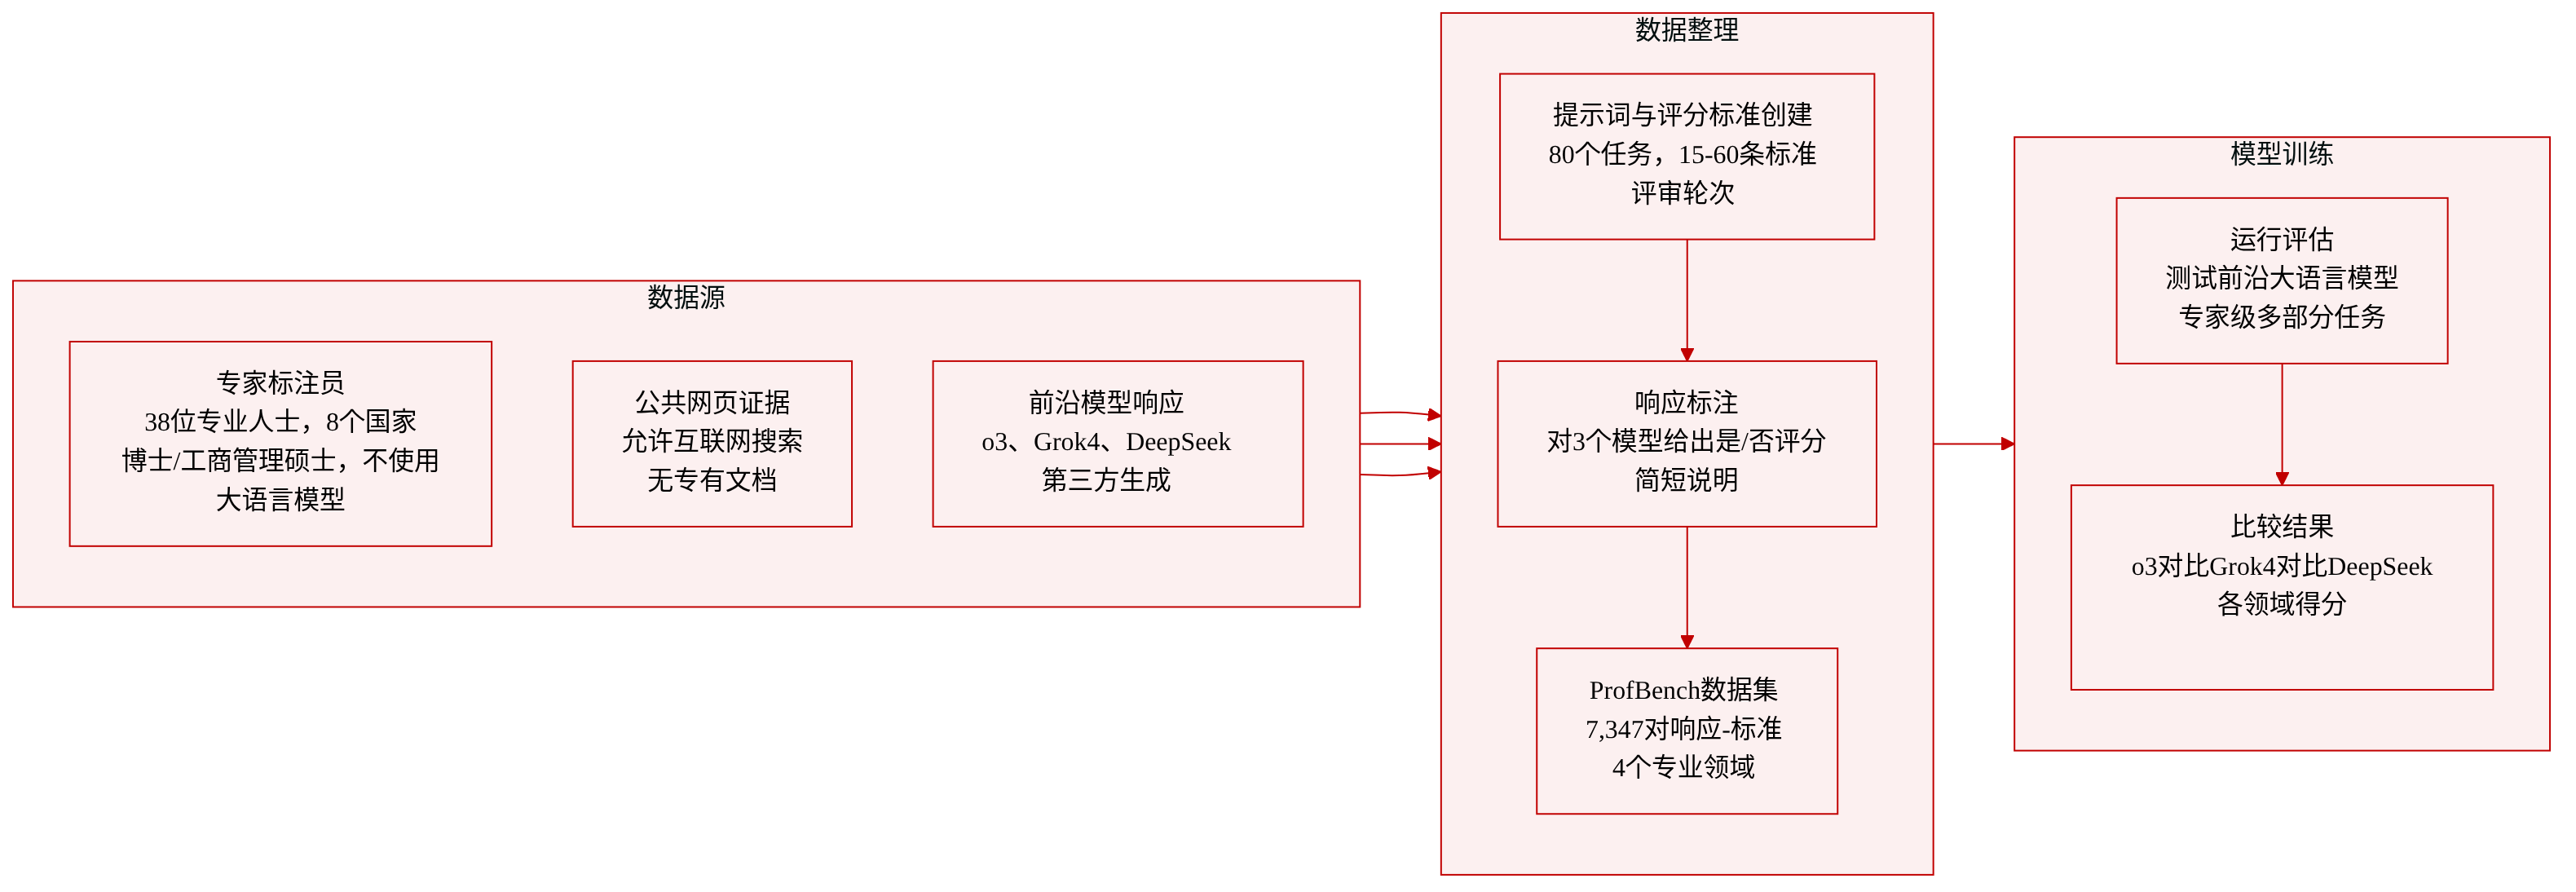
作者介绍了ProfBench,一个用于专业领域专长的基准数据集。以下是其组成、构建和预期用途的详细说明。
数据集概述和规模
- ProfBench包含80个不同任务中的7,347条人工编写的响应-标准对。
- 任务均匀分布在4个专业领域:化学博士、物理博士、金融MBA和咨询MBA。
- 该规模与现有基准测试相当:PaperBench使用20个任务中的8,316对,HealthBench使用数百个任务中的8,053对。相比之下,DeepResearch-Bench有100个任务,每个任务只有一个参考响应且没有人工编写的评分标准,每个领域平均只有2.3个英文任务。
- 作者指出,基于评分标准的评估数据集往往较小,因为每个任务都需要专家标注者投入大量时间(例如,具有行业经验的物理博士),这类人员难以招募且成本高昂。
标注者招募和资格
- 具有博士、MBA或同等工作经验的标注者由外包服务商招募和管理。
- 在纳入之前,标注者必须通过其领域专长测试,以及对其标注任务理解的测试,包括在模糊条件下工作和注重细节的能力。
- 共有来自8个国家的38名标注者参与。
- 在标注者中,44.7%拥有博士学位,18.4%拥有MBA学位,其余拥有相关学位(如金融学士或商学学士)以及相关工作经验。
- 标注者在获得最高学位后平均有5.24年的经验。
- 每位标注者每个任务花费约10至20小时,并且被限制最多贡献5个任务以确保提示的多样性。
- 标注的任何阶段都不允许使用LLM。
- 标注者的报酬远高于当地最低工资,时薪通常超过这些专业领域的全职就业水平,以吸引高素质的贡献者。
提示整理
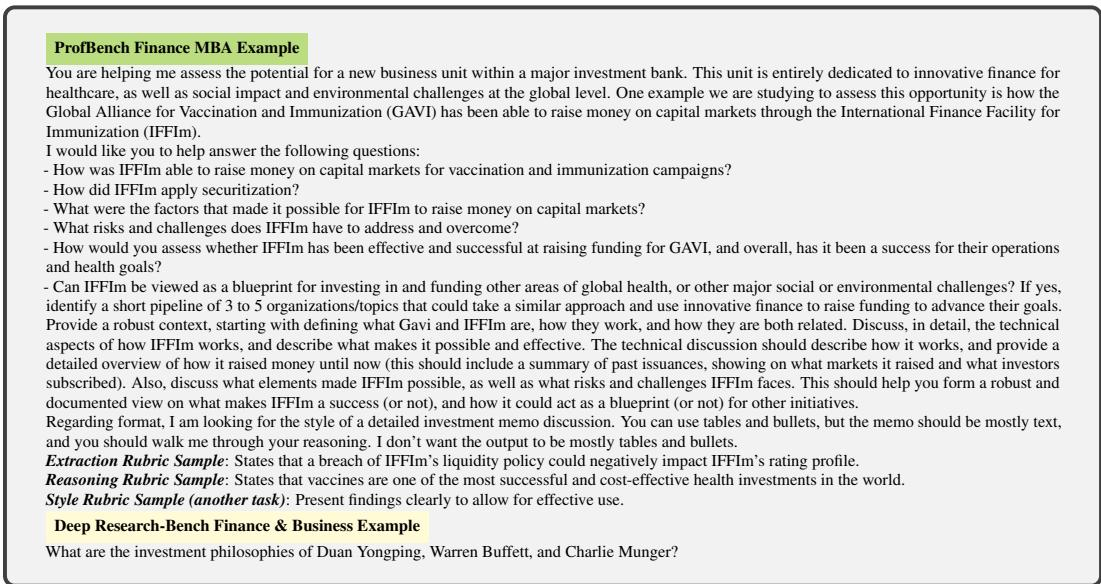
- 目标是创建截至2025年7月对前沿LLM(例如OpenAI o3、xAI Grok4、DeepSeek R1-0528)具有难度的任务。
- 提示被设计为标注者可能请初级同事协助的任务,产生通常包含多个相关子问题的多页报告。
- 所有提示和预期响应必须为英文且仅限文本。
- 标注者可以使用互联网搜索寻找支持性证据,但禁止使用不公开的专有文档。
- 标注者为每个提示提供了简要的理由说明,以确保创建具有目的性。
评分标准创建
- 对于每个任务,标注者创建15至60条评分标准。
- 每条标准可独立用于对响应进行评分,完整集合共同覆盖响应质量的各个方面。
- 每条标准包含描述和理由,后者旨在鼓励深思熟虑的创建。
- 标注者为每条标准分配了重要级别和一个或多个标准类型。
- 评审者(具有丰富领域专长)提供对标准集的整体反馈,并就保留或改进每条标准提出建议,可能进行多轮往返。
- 在标注者编写的标准中,41.4%在各个阶段被标记为需要改进,反映了评审过程中执行的高质量标准。
响应标注和使用
- 外包服务商使用标注开始时被认为表现最好的三个模型生成响应:OpenAI o3、Grok4和DeepSeek R1-0528,涵盖专有和开放权重模型。
- 标注者对三个响应中的每一个按照每条标准进行简单的"是"或"否"评分,并附上简要理由。
- 得到的响应-标准对作为评估跨四个专业领域模型性能的评估数据。该数据集用于测试前沿LLM在复杂、专家级任务上的表现,这些任务期望多个子问题和详细报告。
方法
将模型基准测试为LLM评判模型
作者将评判任务表述为二分类问题。对于每条评估标准,模型接收响应和标准,然后确定该响应是否满足该标准。这种表述紧密反映了双类自然语言推理任务,评判模型必须在蕴含(标准满足)和矛盾(标准不满足)之间做出决定。遵循PaperBench的设计,原始任务提示不会提供给LLM评判模型。标准的构建使其可以独立于提示进行评估,而提供提示可能会引入干扰评判模型的不相关上下文。
将模型基准测试为报告生成器
报告生成任务被形式化如下:给定一个提示以及一组基础文档,模型必须生成解决该提示的响应。这种有基础支撑的表述受到人类专业人士通常如何处理现实世界任务的启发,这一设计选择使其区别于HLE、GPQA和MMLU-Pro等热门基准测试,后者不提供基础文档。
生成的报告由评判基准中表现最佳的GPT-OSS-120B评判模型评分。该评判模型在物理、化学和风格相关标准上以高推理努力运行,在其他所有标准上以低推理努力运行。最终得分计算为标准满足率,按每条标准的重要级别加权:附加为1,次要为2,主要为3,关键为4。形式上,得分由下式给出
score=∑cwc∑cwc⋅1[criterion c is fulfilled],其中wc表示标准c的重要性权重。为验证该评分方案,作者比较了三个模型(o3、Grok4和R1-0528)的评判模型预测性能与人工标注性能。该方案在三个模型上仅产生0.7%到1.3%的评判模型预测分数与人工标注分数之间的差距,证实了其可靠性。
报告生成的推理设置与评判基准一致。由于任务期望长输出,作者为非推理模型生成最多32,000个token,对应于GPT-4.1的最大序列长度,为推理模型生成最多64,000个token,匹配Claude 4 Sonnet和Gemini 2.5 Pro的限制。为估计性能方差,每次生成重复16次,并报告平均值和标准差。
实验
实验在人工标注标准上按照二元蕴含式任务对LLM评判模型进行基准测试,通过偏差指数调整的Macro-F1衡量性能,然后使用表现最佳的开放权重评判模型(GPT-OSS-120B,具有领域特定推理努力)来评估报告生成器。结果显示专有模型在两个任务中均领先,但开放权重模型以极低的成本具有高度竞争力,而更大的模型和启用推理通常仅带来适度的性能提升。响应长度在阈值之后对报告质量的影响很小,移除基础文档会严重降低性能(9%到12%),而网络搜索仅能恢复部分损失。作者还证明,跨任务的自适应采样分配可以将推理成本降低到25%,而不影响估计的稳健性。
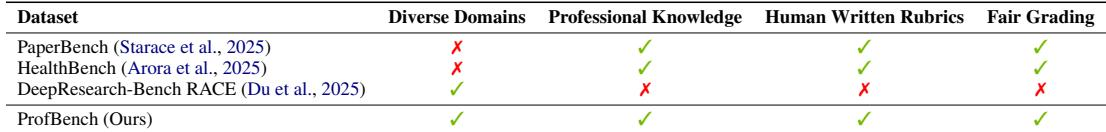
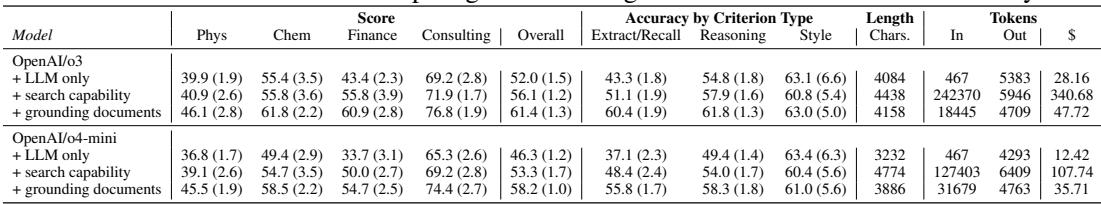
ProfBench独特地满足了所有四个评估方面,包括多样化的领域、专业知识、人工编写的评分标准和公平评分,而其他基准测试至少在一个方面存在不足。该基准测试也具有成本效益,推理成本远低于可比基准测试,并且可以通过跨任务自适应分配响应进一步降低成本而不牺牲稳健性。基础文档对性能至关重要,因为移除它们会导致显著下降,尽管网络搜索可以部分恢复。ProfBench是唯一覆盖多样化领域、专业知识、人工编写评分标准和公平评分的基准测试,而其他基准测试至少缺少一个方面。使用每个任务16个响应运行ProfBench花费48,而HealthBench为300,PaperBench为$8000,自适应采样可以将成本降低到25%而不损害稳健性。移除基础文档会使性能降低9.4%到11.9%,对信息提取任务的影响尤其显著,而网络搜索仅能部分恢复损失。
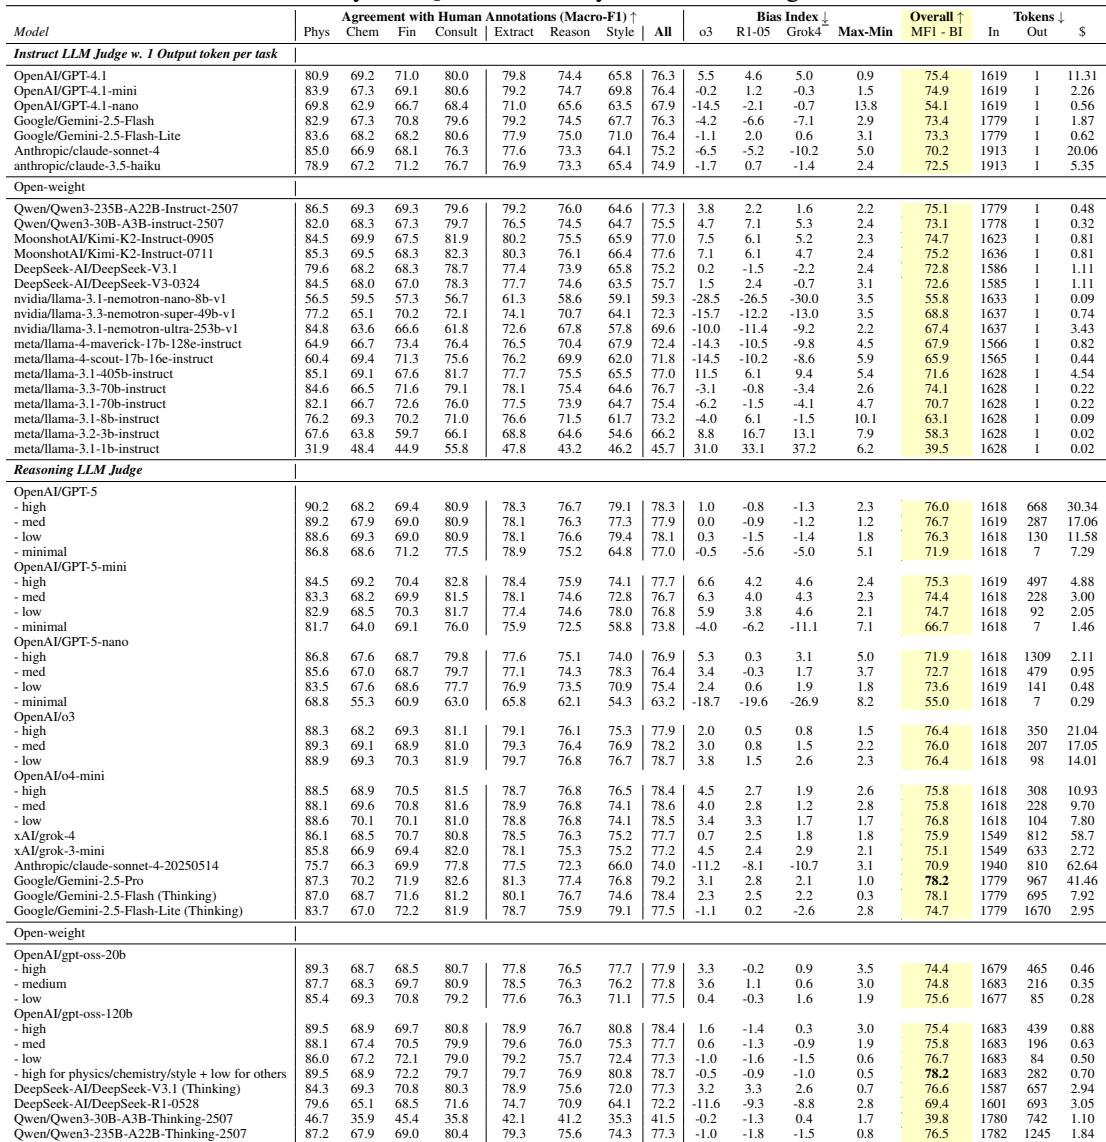
专有LLM评判模型在总体得分上达到最高,但开放权重模型以极低的成本接近该水平。更大的模型通常会提高性能,尽管收益在超过一定规模后会趋于平缓,后训练改进可能比规模更重要。启用推理模式通常有帮助,但收益因模型和推理努力水平而异。最佳专有评判模型达到78.2%的总体得分,但顶级开放权重模型仅落后0.2到1.5个百分点,同时成本低得多。在模型家族内扩展规模在超过阈值后收益递减,后训练升级带来的跳跃有时超过增加参数带来的收益。启用推理模式根据模型不同可将得分提高0.7到4.8个百分点,而更高的推理努力在不同模型上提供不一致的收益。偏差指数值差异很大,一些模型显示出负偏差(偏向模型输出)而另一些则显示正偏差,影响总体得分。
GPT-5作为报告生成器在总体性能上领先,尽管该基准测试被证明比几个流行的推理基准测试更具挑战性。物理是最困难的领域,而闭源模型通常优于开放权重模型,金融领域的差距最大。更大的模型在家族内会改进性能,但收益递减,启用推理模式仅产生适度的收益,表明仅靠扩展规模是不够的。GPT-5在总体得分上达到最高,但相对于其他已建立的推理任务,该基准测试仍然具有难度。物理是最具挑战性的领域,得分明显低于化学、金融或咨询。闭源模型在大多数领域优于开放权重模型,金融领域的性能差距最大。在模型家族内,更大的模型会改进性能,但随着规模增大收益缩小,表明收益递减。为同一模型启用推理模式仅产生小幅改进,有时推理版本的表现不如其指令对应版本。
向LLM生成器添加基础文档在两个模型上均产生最高得分,而仅依赖网络搜索相较于仅使用LLM提示可以部分恢复性能。o3模型在相同设置下始终优于o4-mini,基础文档带来的最大收益出现在提取/召回标准上。基础文档在两个模型上将总体得分相较于仅LLM提示提高了约9到11个百分点。网络搜索恢复是部分的,相较于仅使用LLM的基线增加了4到7个百分点,但仍低于直接文档基础支撑。提取/召回从基础支撑中受益最多,相较于仅LLM设置增加了约17到19个百分点。基于搜索的运行消耗的输入token远远多于原始基础文档,表明检索精度是一个瓶颈。
实验在多样化领域、专业知识、人工编写的评分标准和公平评分方面对ProfBench进行评估,表明它独特地满足所有标准,同时具有成本效益,特别是在自适应采样的情况下。基础文档对性能至关重要,因为移除它们会导致显著下降,而网络搜索仅能部分恢复。对于评判模型,专有系统略占优势,但开放权重模型在更低成本下具有可比性,后训练改进往往超过规模优势。作为报告生成基准测试,ProfBench被证明比常见推理任务更难,物理是最困难的领域,仅靠扩展规模会产生收益递减。