Command Palette
Search for a command to run...
SCBENCH:以 KV 缓存为中心的长上下文方法分析
SCBENCH:以 KV 缓存为中心的长上下文方法分析
SCBench 长上下文基准测试数据集
摘要
长上下文大语言模型(LLMs)已支持众多下游应用,但也带来了与计算和内存效率相关的重大挑战。为应对这些挑战,围绕 KV 缓存开发了长上下文推理的优化方法。然而,现有基准测试通常在单请求场景下进行评估,忽视了 KV 缓存在实际使用中的完整生命周期。这一疏忽尤为关键,因为 KV 缓存复用已在 LLM 推理框架(如 vLLM 和 SGLang)以及 LLM 提供商(包括 OpenAI、Microsoft、Google 和 Anthropic)中被广泛采用。为弥补这一空白,我们引入了 SCBENCH(SharedContextBENCH),一个从 KV 缓存视角评估长上下文方法的综合基准,涵盖:1)KV 缓存生成,2)KV 缓存压缩,3)KV 缓存检索,4)KV 缓存加载。具体而言,SCBench 使用具有共享上下文的测试示例,涉及 12 项任务和两种共享上下文模式,覆盖四类长上下文能力:字符串检索、语义检索、全局信息和多任务。借助 SCBench,我们对八类长上下文解决方案进行了广泛的 KV 缓存中心分析,包括门控线性 RNN(Codestal-Mamba)、Mamba-注意力混合(Jamba-1.5-Mini)以及高效方法,如稀疏注意力、KV 缓存丢弃、量化、检索、加载和提示压缩。评估在六个基于 Transformer 的长上下文 LLM 上进行:Llama-3.1-8B/70B、Qwen2.5-72B/32B、Llama-3-8B-262K 和 GLM-4-9B。我们的发现表明,次 O(n) 内存方法在多轮场景下表现不佳,而具有 O(n) 内存和次 O(n²) 预填充计算的稀疏编码表现稳健。动态稀疏性比静态模式产生更具表现力的 KV 缓存,混合架构中的层级稀疏性在降低内存使用的同时保持了强劲性能。此外,我们识别了长生成场景中的注意力分布偏移问题。
一句话总结
微软公司和萨里大学的研究人员提出了 SCBench,这是一个以 KV 缓存为中心的基准测试,用于评估长上下文大语言模型在生成、压缩、检索和加载等环节中的表现,其任务基于共享上下文场景。结果表明,sub−O(n) memory methods struggle in multi-turn scenarios while sparse encoding with $O(n)$ memory and $sub-$O(n^2) 预填充仍然保持稳健。
核心贡献
- 提出了 SCBench,这是一个以 KV 缓存为中心的长上下文大语言模型评估基准,涵盖 12 个任务,涉及两种共享上下文模式,并覆盖四个能力类别:字符串检索、语义检索、全局信息处理和多重任务处理。
- 提出了一个以 KV 缓存为中心的框架,将长上下文推理方法划分为四个阶段:生成、压缩、检索和加载,并在八个大语言模型(Llama-3.1-8B/70B、Qwen2.5-72B/32B、Llama-3-8B-262K、GLM-4-9B、Codestral-Mamba 和 Jamba-1.5-Mini)上评估了 13 种方法,涵盖八类技术,包括门控线性 RNN、混合模型、稀疏注意力和提示压缩。
- 研究结果显示,sub-O(n) 内存方法在多轮共享上下文场景中表现不佳,而具有 O(n) 内存和 sub-O(n²) 预填充计算复杂度的稀疏编码方法表现稳健;动态稀疏性比静态模式能够产生更有表现力的 KV 缓存,并且在长生成场景中会出现注意力分布偏移的问题。
引言
作者着手解决大语言模型(LLM)中高效长上下文推理日益增长的需求,这些模型目前支持从 128K 到 10M token 的上下文窗口。这些能力使得仓库级代码理解、长文档问答和少量样本上下文学习等真实世界用例成为可能,但同时也在推理过程中带来了高昂的计算和内存成本。先前的有效方法利用了 KV 缓存流程各个阶段的稀疏性,包括生成、压缩、检索和加载。然而,这些方法通常只在单请求基准上进行评估,无法捕捉真实世界的模式,如共享提示上下文、前缀缓存和多轮交互。查询条件压缩方法甚至可能在后续查询中失效,正如先前关于 Mamba 的研究所示。为了弥补这一差距,作者提出了 SCBench,这是一个以 KV 缓存为中心的基准测试,覆盖 KV 缓存的完整生命周期,包含 12 个任务和四项长上下文能力:字符串检索、语义检索、全局信息处理和多重任务处理,并涵盖两种共享上下文模式:多轮和多请求。他们还提出了 Tri-shape,一种无需训练即可改善首轮准确率的稀疏注意力方法。他们的评估涵盖了 13 种长上下文方法和 8 个开源大语言模型,揭示了次线性内存方法在多轮解码中会损失准确率,而 O(n) 内存方法在后续查询中更接近全注意力准确率。
数据集
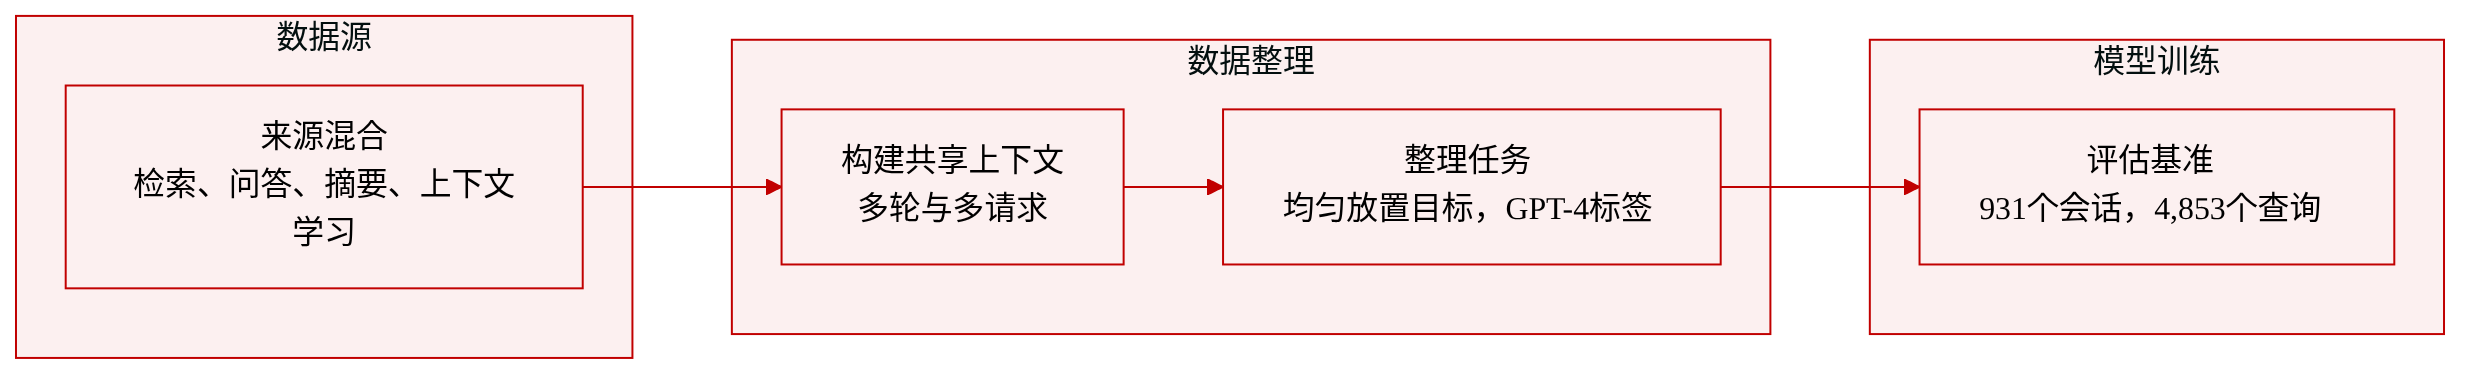
SCBench 是一个基准数据集,旨在评估四项长上下文能力:字符串检索、语义检索、全局信息处理和多重任务处理。它涵盖了两种共享上下文模式,即多轮和多请求,领域包括代码、检索、问答、摘要、上下文学习和多跳追踪。总共,SCBench 包含 931 个多轮会话和 4,853 个查询,平均每个会话有 5 轮。
按任务分组的数据集组成
-
字符串检索
- Retrieve.KV:基于包含随机键值对的大型 JSON 对象构建。每个会话检索 5 个键值对,目标键均匀分布在整个输入中。
- Retrieve.Prefix-Suffix:使用一个包含变长字符串的大型列表。模型必须检索一个满足指定前缀和后缀要求的字符串。仅共享前缀或后缀的干扰项可防止模型依赖简单的查找。
- Retrieve.MultiHop:改编自 RULER,嵌入 5 条多跳变量赋值链。每一轮需要检索给定值对应的具体链。
-
语义检索
- Code.RepoQA:从 RepoQA 扩展到 64K token。输入来自 Python、C++、Java、PHP、Rust、Go 和 TypeScript 的 GitHub 仓库。函数描述由 GPT-4 生成。每个会话在 5 轮中每轮检索一个函数。
- En.QA、Zh.QA、En.MultiChoice:从 InfiniteBench 扩展而来,使用基于虚构小说的人工标注问答测试。问题类型包括聚合(编译分散信息)和过滤(识别特定细节)。共享同一输入上下文的问答对被组合成共享上下文会话。
-
全局信息处理
- Many-shot ICL:来源于 Big-Bench Hard,包含三个子任务:日期理解、明显错误翻译检测和跟踪七个洗牌对象。所有子任务都是多项选择,有四个选项,上下文在各轮之间共享。
- Math.Find:从 InfiniteBench 扩展而来,将查找最大值扩展到在大型数组上查找最小值和中位数。
- En.Sum:由拼接的 arXiv 论文构建,长度从 8K 到 20K token。真实摘要平均 654 个 token,由 GPT-4 生成简洁的一句话摘要。目标文档均匀分布在整个上下文中。
-
多重任务处理
- Mix.Sum+NIAH:将文档摘要与“大海捞针”任务相结合。一个随机针被均匀插入 En.Sum 输入中,模型在摘要和检索之间交替进行。
- Mix.RepoQA+KV:将 RepoQA 与 KV 检索相结合。100 个键值对均匀插入源代码输入中,其中 4 个是目标键,其余为干扰项。模型在代码检索和 KV 检索之间交替进行。
共享上下文模式
- 多轮模式:后续轮次使用真实答案作为上下文,而不是模型生成的内容,反映了长上下文聊天和多步推理场景。这对于具有 KV 缓存复用的方法很重要,因为各轮之间的焦点转移可能导致信息丢失。
- 多请求模式:上下文跨会话或用户共享,例如协作的共享代码仓库。模型可以编码共享上下文并在请求之间复用 KV 缓存。这测试了依赖查询进行稀疏编码或解码的方法(如 MInference 和 SnapKV)在无查询访问时的泛化能力。
处理和使用细节
- 目标字符串、键值对和文档均匀分布在整个输入中,以测试全上下文利用率。
- 多轮设置中使用真实答案,以避免模型生成内容造成的错误累积。
- 该基准结合了共享上下文的任务,以模拟现实世界的多请求场景,其中模型必须处理混合工作负载。
方法
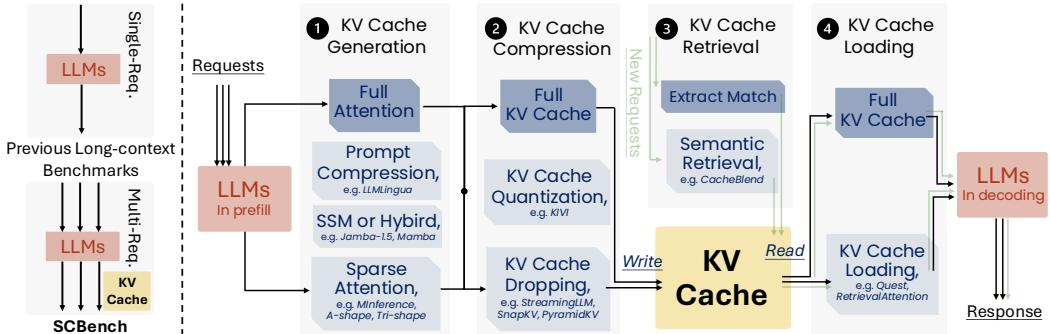
作者提出了一个统一的分析框架,通过以 KV 缓存为中心的视角来分类高效长上下文方法。该框架系统地将推理生命周期分为四个不同阶段:KV 缓存生成、压缩、检索和加载。
该框架的操作如下:
- KV 缓存生成: 这个初始阶段专注于高效处理输入提示以生成 KV 缓存。此类别中的技术包括稀疏注意力机制(例如,A-shape、Tri-shape)、状态空间模型(SSM)或混合方法(例如,Mamba),以及提示压缩方法(例如,LLMLingua 2)。
- KV 缓存压缩: 生成后,KV 缓存被压缩以在存储前降低内存成本。此阶段采用 KV 缓存丢弃(例如,StreamingLLM、SnapKV)和 KV 缓存量化(例如,KIVI)等方法。
- KV 缓存检索: 为减少首 token 时间(TTFT),根据请求的前缀从存储池中检索相关的 KV 缓存块。这涉及语义检索方法(例如,CacheBlend)或精确匹配。
- KV 缓存加载: 最后阶段动态地从外部存储(如 VRAM、DRAM 或 SSD)加载 KV 缓存到 GPU 片上 SRAM 中,以计算解码阶段的稀疏注意力。
在生成阶段,作者引入了 Tri-shape,这是一种无需训练的稀疏注意力方法,旨在提高多个请求之间的准确率。
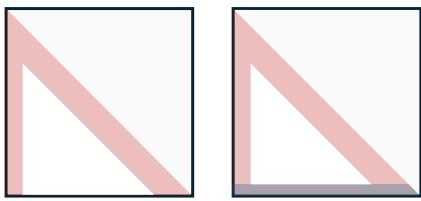
与标准的 A-shape 模式(仅保留注意力汇聚 token 和局部窗口)不同,Tri-shape 保留了最后一个窗口查询区域。这种修改为预填充形成了三角形稀疏注意力模式。这种设计增强了首轮和后续多请求交互的性能,同时保持了模型的指令遵循能力。
实验
评估使用 SCBench,这是一个包含 12 个任务的基准,覆盖多轮和多请求共享上下文模式中的四项长上下文能力,并在六个开源大语言模型上测试了八类长上下文方法。结果显示,大多数压缩方法在精确检索任务中失败,稀疏注意力和动态稀疏方法(如 MInference)表现最佳,而 KV 缓存压缩和提示压缩在共享场景中表现下降。分析表明,sub-O(n) 内存对于多轮解码几乎不可行,因为注意力模式跨查询会发生变化,稀疏编码比稀疏解码更稳健,并且高度可压缩的任务会高估模型的能力,而不可压缩的检索任务则能更真实地反映性能。查询依赖方法在无查询访问时准确率会下降,但 MInference 因其自适应稀疏模式而泛化得更好。
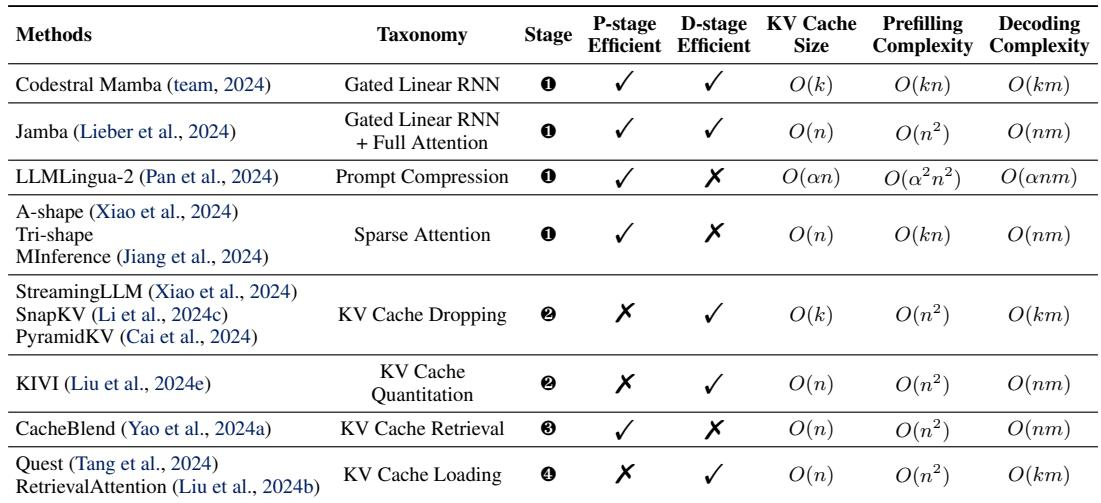
该表比较了 KV 缓存阶段的长上下文方法,标注了缓存大小和计算复杂度的差异。评估结果显示,稀疏注意力方法通常优于稀疏解码方法,尤其是在共享上下文场景中,而 KV 缓存压缩方法往往表现不佳。稀疏注意力方法(如 MInference 和 A-shape/Tri-shape)提供了高效的预填充并降低了复杂度,而 KV 缓存丢弃和量化仅提供解码阶段的效率。门控线性 RNN(如 Codestral Mamba)实现了恒定的 KV 缓存大小和线性预填充复杂度,与全注意力的平方复杂度形成对比。提示压缩将缓存大小按压缩因子成比例减少,但仍然产生平方的预填充复杂度,限制了其效率提升。
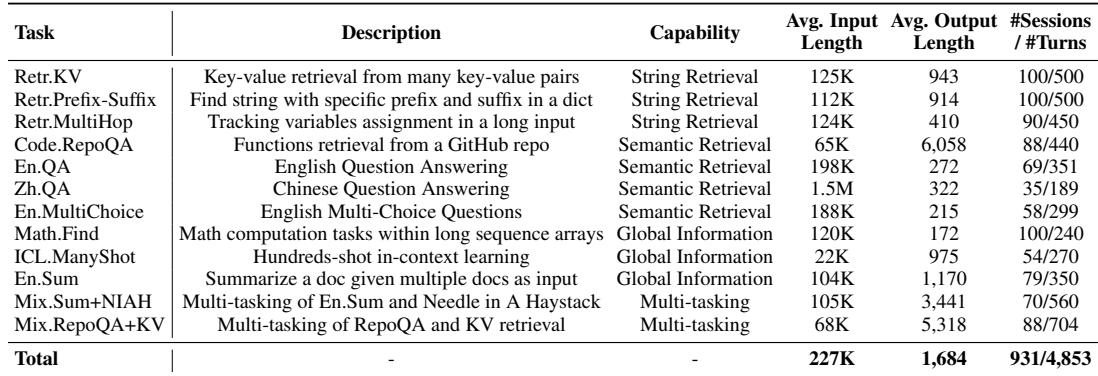
SCBench 包含 12 个任务,涵盖四项长上下文能力:字符串检索、语义检索、全局信息处理和多重任务处理,覆盖多轮和多请求上下文模式。任务的输入长度差异很大,语义检索任务(如中文问答)的输入长度远长于代码或英文问答任务。该基准包括近千个多轮会话和数千个查询,平均每个会话约 5 轮。字符串检索任务(如键值对和前缀-后缀匹配)的输入长度约为 110K-125K,输出相对较短。语义检索任务的输入长度跨度很大,从代码问答的 65K 到中文问答的 1.5M,而英文问答和多项选择保持在约 188K-198K。所有任务都组织成多轮会话,会话数量从 35 到 100 不等,轮次数约为会话数的五倍。
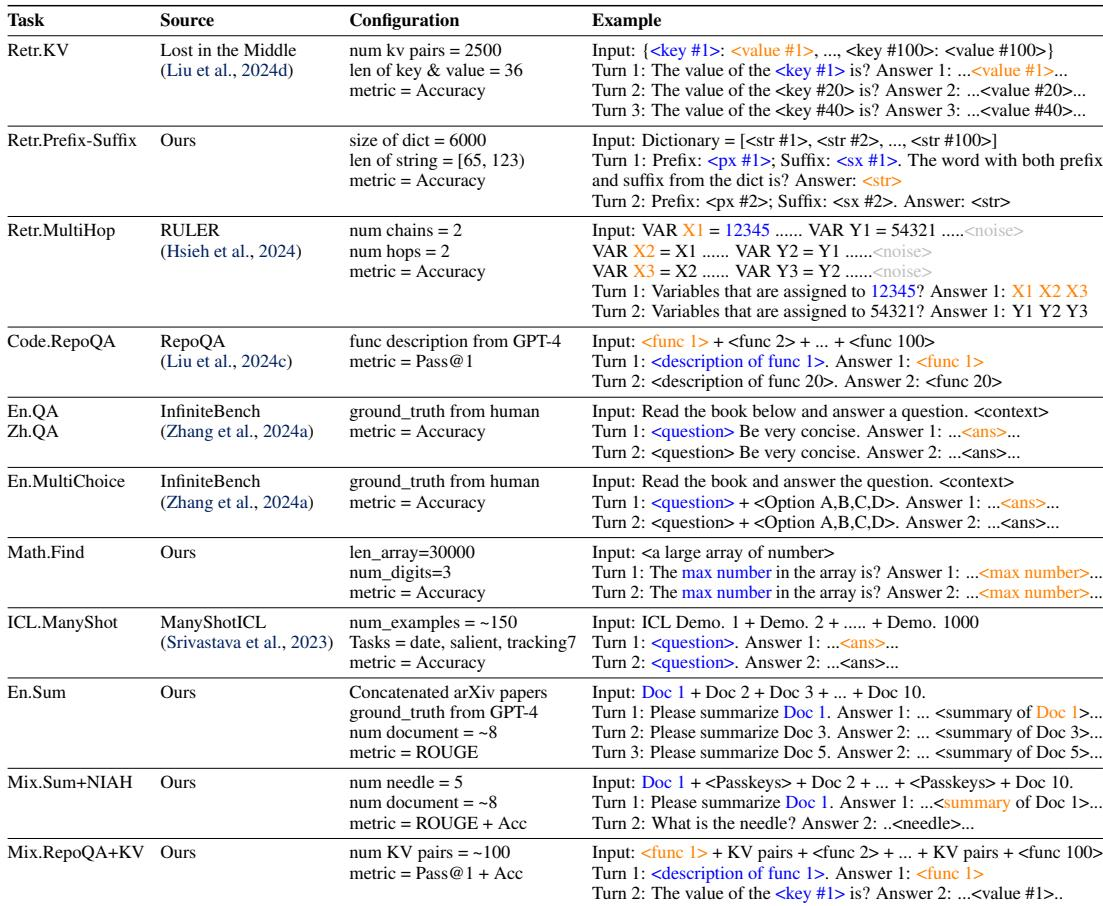
SCBench 包含 12 个任务,评估共享上下文模式中的四项长上下文能力,配置因来源、任务特定参数和评估指标而异。这些任务涵盖多个领域,旨在测试检索、推理和摘要能力,适用于多轮或多请求设置。每个任务使用定制输入和预期输出,一些任务利用现有基准,另一些则提出新配置。检索任务(如 Retr.KV 和 Retr.Prefix-Suffix)使用随机键值对或字符串字典,以准确率为指标,强调不可压缩上下文的利用。从 RULER 改编的多跳检索在轮次间链接变量赋值,测试模型跟踪间接引用的能力。代码仓库问答使用 GPT-4 生成的函数描述和 Pass@1,而英文和中文问答任务则依赖人工标注的真实答案,以准确率为指标。一个数学任务要求从大型数组中找出最大值,并在多轮中重复,突出共享上下文中的迭代数值推理能力。
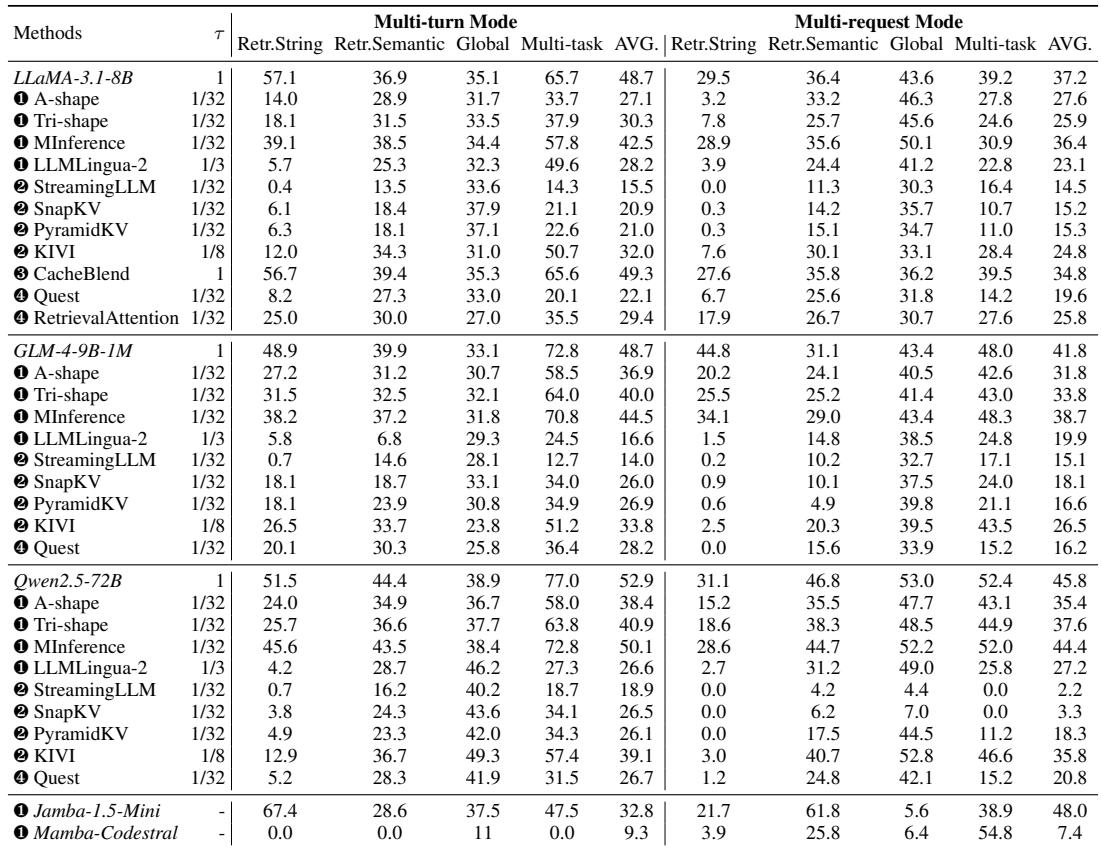
在共享上下文模式下,大多数长上下文压缩方法相对于全注意力基线表现不佳,尤其在精确检索任务中差异显著。MInference 作为一种动态稀疏注意力方法,在压缩方法中持续获得最高平均分,而静态稀疏解码和 KV 缓存压缩则大幅退化,尤其是随着请求累积。MInference 在多轮和多请求模式下均优于所有其他压缩方法,但仍落后于未压缩的基线。静态稀疏解码方法(如 StreamingLLM)在精确字符串检索任务上得到接近零的分数,表明查询无关的共享上下文存在严重限制。Tri-shape 稀疏注意力在任务间泛化相对良好,排名仅次于 MInference,而 KV 缓存压缩和提示压缩方法通常表现较弱。大多数压缩方法在精确检索任务上性能崩溃,包括 A-shape 和 LLMLingua-2,这表明 sub-O(n) 方法难以处理不可压缩的键值模式。
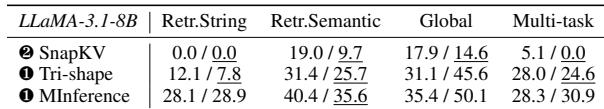
查询感知的长上下文方法在编码期间查询不可用时通常会退化,但退化程度因方法而异。动态稀疏注意力(MInference)在无查询访问时的泛化能力优于 KV 缓存压缩(SnapKV)和静态稀疏注意力(Tri-shape)。移除查询访问导致 SnapKV 和 Tri-shape 在大多数任务上性能大幅下降。MInference 在无查询情况下保持了相对较高的准确率,这可能归功于其自适应稀疏模式。静态稀疏注意力和 KV 缓存压缩对查询缺失的敏感性高于动态稀疏注意力。
评估使用 SCBench,该基准包含 12 个任务,覆盖多轮和多请求共享上下文模式中的四项长上下文能力。在所有设置中,大多数压缩方法都低于全注意力基线,精确检索任务尤其具有挑战性,静态稀疏解码和 KV 缓存压缩严重退化,而动态稀疏注意力(以 MInference 为首)泛化最佳。当编码期间移除查询访问时,查询感知方法的准确率下降,但动态稀疏注意力比 KV 缓存压缩或静态稀疏注意力更稳健,凸显了自适应稀疏模式在无查询情况下能更好地保持性能。