Command Palette
Search for a command to run...
MIND:面向大语言模型预训练的数学信息合成对话
MIND:面向大语言模型预训练的数学信息合成对话
Syeda Nahida Akter Shrimai Prabhumoye John Kamalu Sanjeev Satheesh Eric Nyberg Mostofa Patwary Mohammad Shoeybi Bryan Catanzaro
Nemotron-MIND 数学推理合成对话数据集
摘要
近年来,合成数据在提升预训练数据质量及下游任务准确性方面的效用已在大型语言模型(LLMs)中得到了广泛探索。然而,这些方法在复杂、多跳和数学推理任务中表现不足,因为合成数据通常无法为现有原始语料库补充互补知识。在这项工作中,我们提出了一种新颖的大规模、多样化的数学信息合成对话(MIND)生成方法,旨在提升LLMs的数学推理能力。具体而言,我们利用MIND基于OpenWeb-Math(OWM)生成合成对话,从而构建了一个新的数学语料库MIND-OWM。我们在不同对话设置下的实验表明,在对话参与者之间引入知识差距对于生成高质量数学数据至关重要。我们进一步确定了一种在预训练期间格式化并整合合成数据与原始数据的有效方式,以最大化数学推理的提升效果,强调需要对原始数据进行重构而非直接使用。与仅在原始数据上预训练相比,在MIND-OWM上预训练的模型在数学推理方面表现出显著提升(GSM8K:+13.42%,MATH:+2.30%),并在专业知识(MMLU:+4.55%,MMLU-STEM:+4.28%)和通用推理任务(GENERAL REASONING:+2.51%)中表现更优。我们发布了使用MIND生成的1380亿token的合成对话,可在https://huggingface.co/datasets/nvidia/Nemotron-MIND获取。
一句话总结
来自NVIDIA、卡内基梅隆大学和波士顿大学的研究人员提出了MIND,这是一种大规模方法,可从OpenWeb-Math生成数学信息引导的合成对话,以增强LLM的数学推理能力。该方法证明了在对话参与者之间融入知识差距并在预训练期间重构原始数据可最大化收益,在GSM8K(+13.42%)、MATH(+2.30%)、MMLU(+4.55%)和通用推理(+2.51%)上取得了显著提升,并发布了138B-token语料库。
核心贡献
- 论文提出了MIND,一种大规模合成对话生成方法,可将数学网页内容转换为嵌入多步推理的结构化对话,并表明编码对话参与者之间的知识差距是生成高质量数学训练数据的关键因素。
- 该工作识别了一种在预训练期间格式化并整合合成数据与原始数据的有效策略,证明在将原始数据与合成对话混合之前先对原始数据进行重构,比直接使用原始数据在数学推理上带来更大的提升。
- 结果表明,在MIND-OWM语料库上预训练的模型相对于原始数据基线取得了显著提升,包括GSM8K提升13.42%、MATH提升2.30%、MMLU提升4.55%、MMLU-STEM提升4.28%、通用推理基准提升2.51%,同时优于在3.6倍更大数据集上训练的模型;论文还发布了138B-token的合成对话语料库。
引言
大语言模型(LLM)在复杂数学任务中展现出强大的推理能力,但其性能高度依赖于预训练语料库的质量与结构。有效的数学数据必须经过格式化以鼓励逐步问题分解,然而策划高质量、结构化的数学数据集成本高昂且稀缺。先前的合成数据生成方法往往缺乏复杂数学任务所必需的多步推理结构,且许多先进模型不公开其数据策略,使开源工作处于不利地位。
为弥补这些不足,作者引入了MIND,一种可扩展的方法,利用现成的开源LLM将原始网络文本转换为多轮结构化对话。MIND将内容分解为逐步对话轨迹,深入探索每个步骤,并支持多样化的对话风格以丰富数据多样性。该方法在保留网络语料库多样性的同时嵌入动态推理,支持合成数据的持续扩展。作者证明,在MIND生成的对话上预训练7B模型可将数学推理能力较原始数据提升最高6.29%,优于在3.6倍更大的原始语料库上训练的模型,并将收益扩展到通用任务,为结构化推理数据提供了一种资源高效的替代方案。
数据集
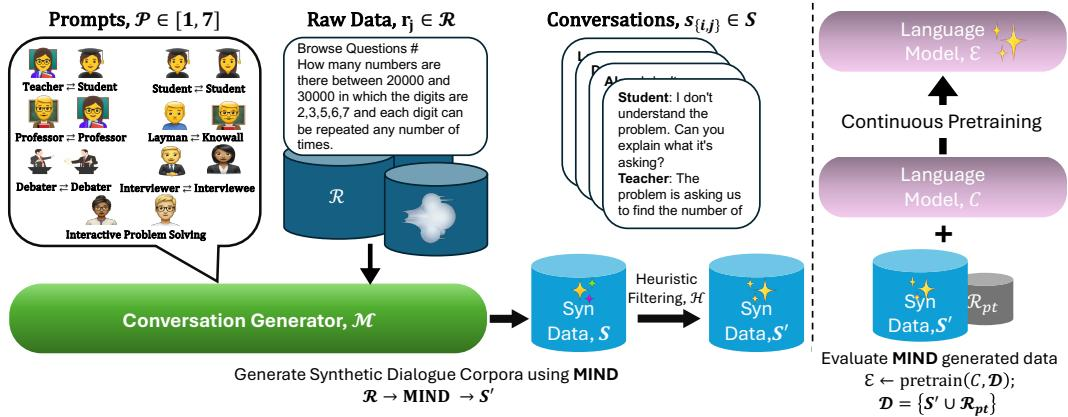
作者从非结构化的数学网络文本中生成了一个名为MIND(数学信息引导的合成对话,Math Informed Synthetic Dialogue)的合成数学对话数据集。
数据集构成与来源
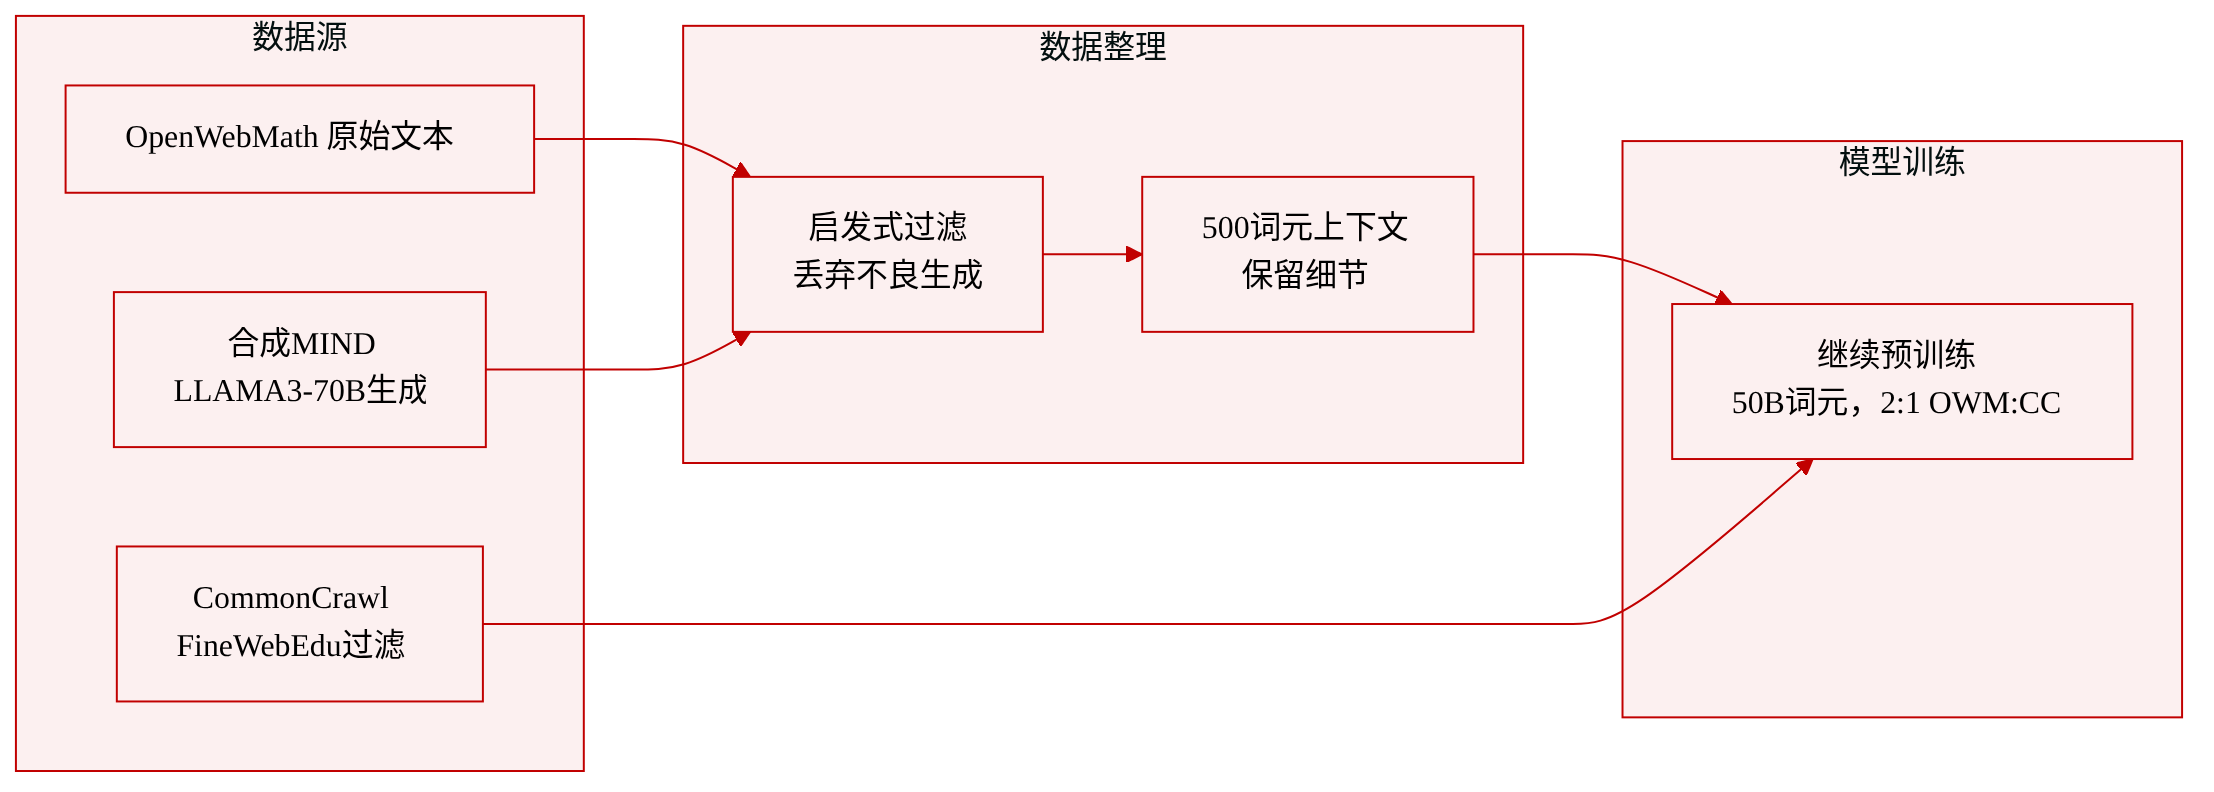
- 种子语料库为OpenWebMath,包含147亿token的高质量数学网络文本。
- 作者使用LLAMA3-70B-INSTRUCT,通过一组提示词(例如two students、teacher_student、debate)将原始文本转换为多轮对话。
- 每次生成时,迭代地采用500 token的上下文以保留原始文本中的细节。
子集版本
- OWM-4B:OpenWebMath的一个较小的子集,包含40亿token,用于快速评估全部七种提示词。来自该子集的合成数据标记为MIND-OWM-4B。
- OWM-14B:完整的147亿token OpenWebMath语料库。来自该语料库的合成数据称为MIND-OWM-14B。
过滤与处理
- 使用启发式过滤来丢弃较差的生成结果。基于LLM的评分曾被测试但被否决,因为它对所有生成结果的评分都很高,不适合用于筛选。
- 除500 token的上下文窗口外,未提及特定的裁剪策略。
预训练中的使用
- 基础模型在13个CommonCrawl快照(73.37%)、书籍/专利(9%)、论文(9%)、代码(5.12%)、Stack Exchange(2.66%)和Wikipedia(0.8%)的混合数据上预训练700B token。
- 持续预训练额外使用50B token,采用新的数据混合(D),将OpenWebMath(原始R或合成S')与13个CommonCrawl快照(17B token,经FineWebEdu分类器过滤)按2:1的比例混合。
- CommonCrawl部分在各实验中保持固定,而OpenWebMath部分在原始、合成或两者组合之间变化,以评估其相对重要性。
- 各实验的token分布保持一致,因此无论源数据规模如何,每个模型都从每个源中看到相同数量的token。
方法
作者提出了MIND,一个对话式合成数据生成框架,旨在增强大语言模型(LLM)的数学和复杂多跳推理能力。与仅修改表面形式的传统改写技术不同,MIND通过将原始文本转换为多轮对话来引入语义变化和结构化复杂度。该方法模拟人类问题解决过程,通过对话交互将复杂上下文分解为逐步子上下文。
参见框架图。整体流程从原始数据集R和一组精选的对话提示词P开始。预训练的LLM(记为M)作为对话生成器。该系统采用七种不同的对话场景来引导生成过程,包括"教师⇔学生"、"学生⇔学生"、"教授⇔教授"、"辩手⇔辩手"、"采访者⇔受访者"、"外行⇔万事通"以及"交互式问题解决"等场景。这些提示词专门设计用于指示LLM在保留原始信息的同时,鼓励详细、逐步的推理和解释。
对于来自数据集中的每个原始文本示例rj和选定的提示词pi,生成器M生成一个合成对话si,j。该转换形式化为:
si,j=M(pi∣∣rj)其中∣∣表示提示词与原始文本的拼接。针对固定提示词i生成的总合成数据表示为S={si,j∣j∈[1,N]}。作者使用LLAMA3-70B-INSTRUCT作为生成器M,因为它在对话任务中表现强劲。为确保上下文保真并防止细节丢失,生成过程在500 token的块上迭代执行。
生成之后,对合成数据集应用启发式过滤过程H,以去除低质量或不正确的生成结果。优化后的数据集记为S′:
S′=H(S)该过滤步骤对于维持合成对话语料库的高质量至关重要,该语料库专门设计用于提升推理能力。
由此产生的合成数据S′用于持续预训练以评估其有效性。作者从基础LLMC开始,在数据混合D上训练,该混合将合成数据S′与来自CommonCrawl快照的高质量预训练数据子集Rpt相结合。持续预训练过程定义如下:
E←pretrain(C,D);where D={S′∪Rpt}这产生了具有更强数学推理能力的增强模型E。训练配置与初始预训练设置保持一致,使用AdamW优化器和特定的学习率调度以确保稳定收敛。
实验
实验在MIND生成的合成对话数据上对7B模型进行持续预训练,并在数学、通用推理和专业知识基准上对比原始数据和改写数据进行评估。MIND生成的对话始终优于基线,最长的对话格式在所有任务上带来的提升最大。消融实验表明,提示词风格很重要,参与者之间明显的知识差距能改善解释深度,而像TWO PROFESSORS这样没有知识差距的风格则表现不佳。这些优势可扩展到MATHPILE等高质量种子语料库,并且即使使用较小的生成器模型也能保持,表明对话结构而非模型规模是推动改进的关键因素。
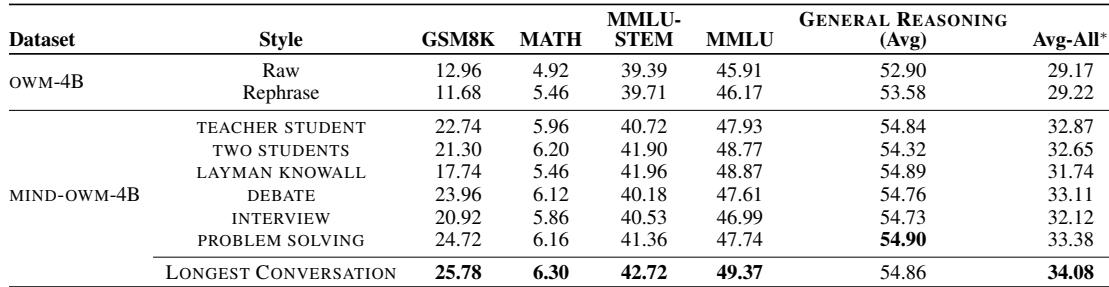
在由多种风格生成的MIND对话数据上进行持续训练,在所有推理任务上的表现始终优于原始数据或改写数据。为每条原始文本选择最长的对话可带来最大的提升,尤其是数学和专业知识基准。所有对话风格在GSM8K、MATH、MMLU-STEM、MMLU和通用推理上均优于原始数据和改写数据的基线。最长对话选择在各任务中带来最大的改进,凸显了多视角对话的优势。辩论风格和师生风格在数学方面的提升最强,而外行与万事通风格和双学生风格在专业知识和通用推理方面表现突出。
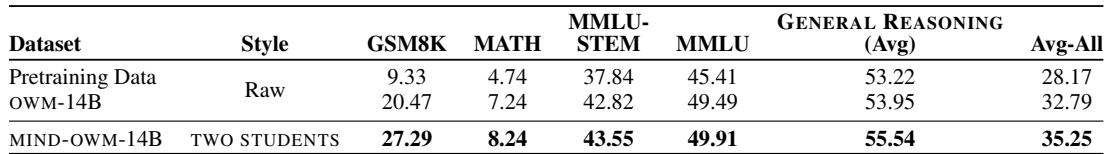
在MIND生成的合成对话数据上训练7B LLM,相比使用原始OpenWebMath或原始预训练混合数据,在数学、专业知识和通用推理基准上的表现均有提升。对话式方法,尤其是TWO STUDENTS风格,在所有评估任务中均带来一致的提升。MIND生成的合成对话在每个基准上均优于原始数据和原始预训练混合数据。TWO STUDENTS对话风格带来了最大的改进,尤其是在数学推理任务上。使用合成对话进行持续训练可同时增强专业知识能力和通用推理能力。
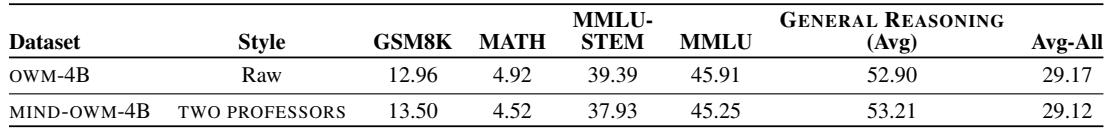
TWO PROFESSORS对话风格在持续预训练中的表现与原始数据相当或更差,与其他能改善推理能力的风格不同。这种不佳表现归因于专家参与者之间零知识差距,导致讨论停留在表面层面,缺乏深入分析或问题分解。TWO PROFESSORS对话在各基准上的表现与原始数据相当或更差。该风格缺乏参与者之间的知识差距,阻碍了详细解释和推理扩展。其他风格要么受益于显式的知识差距(例如LAYMAN KNOWALL、TEACHER STUDENT),要么受益于协作式非专家问题解决(例如PROBLEM SOLVING、DEBATE)。
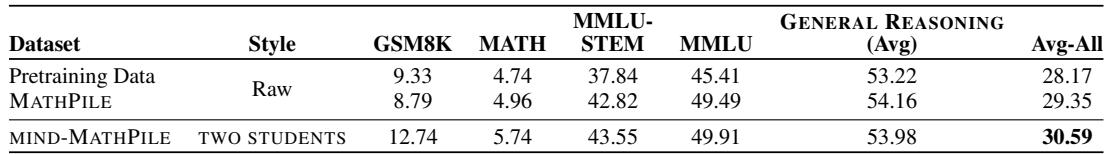
从高质量原始数据生成的合成对话可提升数学任务的表现,其中TWO STUDENTS风格相对原始数据有显著提升。对话风格的有效性取决于知识差距的存在,明确的知识差距有利于通用推理,而协作式问题解决有利于数学任务。来自MATHPILE的对话数据在数学基准上优于原始数据,TWO STUDENTS风格能带来进一步改进。具有显式或隐式知识差距的风格(例如TWO STUDENTS)会带来更详细的推理,这是数学表现的关键。
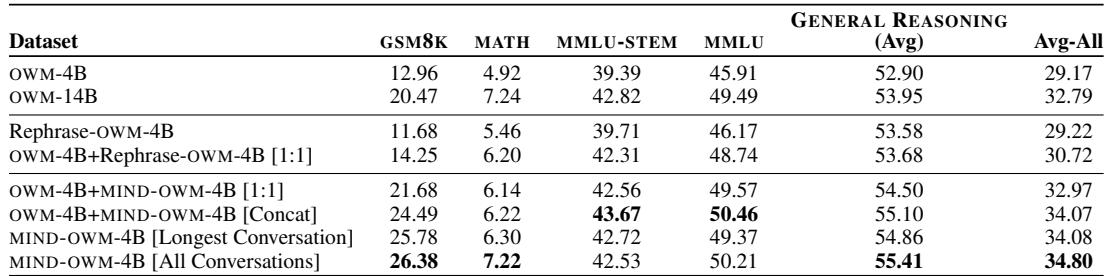
合成对话数据在所有训练配置下均始终优于原始数据。结合较小4B模型生成的所有对话风格,其表现超过了在3.6倍更大语料库上训练的较大14B模型,凸显了合成对话的效率和质量。虽然纯合成数据在数学基准上带来的提升最大,但混合原始数据和合成数据有利于通用推理任务。合成对话数据在每种测试组合下均优于原始数据。由4B模型生成的对话在所有任务上均优于使用3.6倍更多数据的14B模型。纯合成数据在数学基准上带来最大提升,而混合原始和合成数据则改善通用推理。
在多个基准上,使用MIND生成的合成对话数据训练7B模型,在数学、专业知识和通用推理方面始终优于原始数据和原始预训练混合数据。为每条原始文本选择最长的对话可带来最大的收益,具有知识差距或协作问题解决能力的风格(如two students和debate)被证明最为有效,而two professors因缺乏深度而表现不佳。合成对话也展现了效率,4B教师模型的输出优于在更多原始数据上训练的更大14B模型,混合原始和合成数据有利于通用推理,而纯合成数据则在数学方面实现最大提升。