Command Palette
Search for a command to run...
改进语言模型的上下文感知偏好建模
改进语言模型的上下文感知偏好建模
Silviu Pitis Ziang Xiao Nicolas Le Roux Alessandro Sordoni
RPR 合理偏好反转数据集
摘要
尽管基于成对偏好对语言模型(LMs)进行微调已被证明极为有效,但自然语言的欠明确性带来了严峻挑战。直接的偏好反馈难以解释,在多维标准可能适用的情况下难以提供,并且常常不一致,这要么是因为基于不完整的指示,要么是由不同的主体提供。为应对这些挑战,我们考虑采用两步偏好建模流程:首先通过选择上下文来解析欠明确性,然后基于所选上下文评估偏好。我们根据这两步来分解奖励建模误差,这表明除了上下文特定的偏好之外,对上下文进行监督可能是使模型与多样化的人类偏好对齐的一种可行方法。为此,模型评估上下文特定偏好的能力至关重要。基于此,我们贡献了上下文条件偏好数据集及配套实验,以探究语言模型评估上下文特定偏好的能力。我们利用这些数据集来(1)表明现有偏好模型受益于增加的上下文,但未能充分考虑上下文,(2)微调一个上下文感知的奖励模型,其在测试数据集上的上下文特定性能超过GPT-4和Llama 3 70B,以及(3)探究上下文感知偏好建模的价值。
一句话总结
来自多伦多大学、微软研究院、约翰霍普金斯大学和MILA的研究人员提出了一种两步式上下文感知偏好建模方法,该方法首先选择一个上下文来解决欠规格化问题,然后相对于该上下文评估偏好,将奖励建模误差分解为这两个步骤,以证明在监督偏好的同时监督上下文的合理性,发布了上下文条件偏好数据集,表明现有模型能从新增上下文中获益但未能充分考虑上下文,并证明其微调后的上下文感知奖励模型在测试数据集上实现了超过GPT-4和Llama 3 70B的上下文特定性能。
核心贡献
- 本文引入了RPR数据集,这是首批开源的上下文条件偏好数据集,其中偏好由上下文强烈决定,解决了语言模型对齐中直接偏好反馈的欠规格化问题。
- 实验表明,现有偏好模型能从新增上下文中获益,但往往未能充分考虑上下文,有时甚至完全忽略上下文,揭示了上下文特定偏好评估中的关键差距。
- 微调上下文感知奖励模型在测试数据集上实现了超过GPT-4和Llama 3 70B的上下文特定性能,并且一个单一的持久上下文(可能从数据中推断)可能足以大幅改善偏好预测。
引言
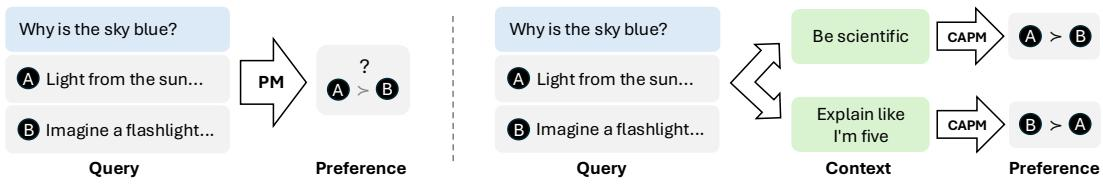
随着语言模型和基础模型扩展到需要遵循多样化指令和执行长程任务的现实应用中,确保其行为符合人类期望变得至关重要。标准方法通过对输出之间的成对偏好比较进行微调,使语言模型与人类偏好对齐。这种方法在处理模糊偏好查询时存在困难,因为用户身份、目标和其他上下文因素通常是未指定的。人类标注者在二元偏好判断上的一致性仅为约65%,当模型在这样的非基本偏好上训练时,隐式上下文偏见会被嵌入模型中。先前使用Bradley-Terry模型的工作通过Borda规则隐式地聚合了隐藏上下文中的偏好,这可能导致某些子群体得不到充分服务。
作者提出了一种两步式上下文感知偏好建模框架。第一步通过选择上下文来解决欠规格化问题,第二步相对于所选上下文评估偏好。这种分解显式地暴露了偏好背后的上下文假设,将对齐从纯粹的偏好建模转变为偏好建模与上下文监督的混合,并实现了对多样化用户的多元适应。作者证明了奖励建模误差的上界为上下文推断误差与上下文特定奖励建模误差之和,这为将上下文监督作为对齐路径提供了合理性依据。为支持这一点,他们发布了开源的上下文条件偏好反转(RPR)数据集,其中给定提示的偏好在替代上下文下发生反转。实验表明,当前模型能从新增上下文中获益,但有时无法充分权衡上下文,而在RPR数据上进行微调能显著改善上下文特定偏好预测。他们还证明了一个单一的持久上下文,如用户画像或系统提示,可以从少至16到32个表达偏好样本中推断出来,并可应用于多个查询。
数据集
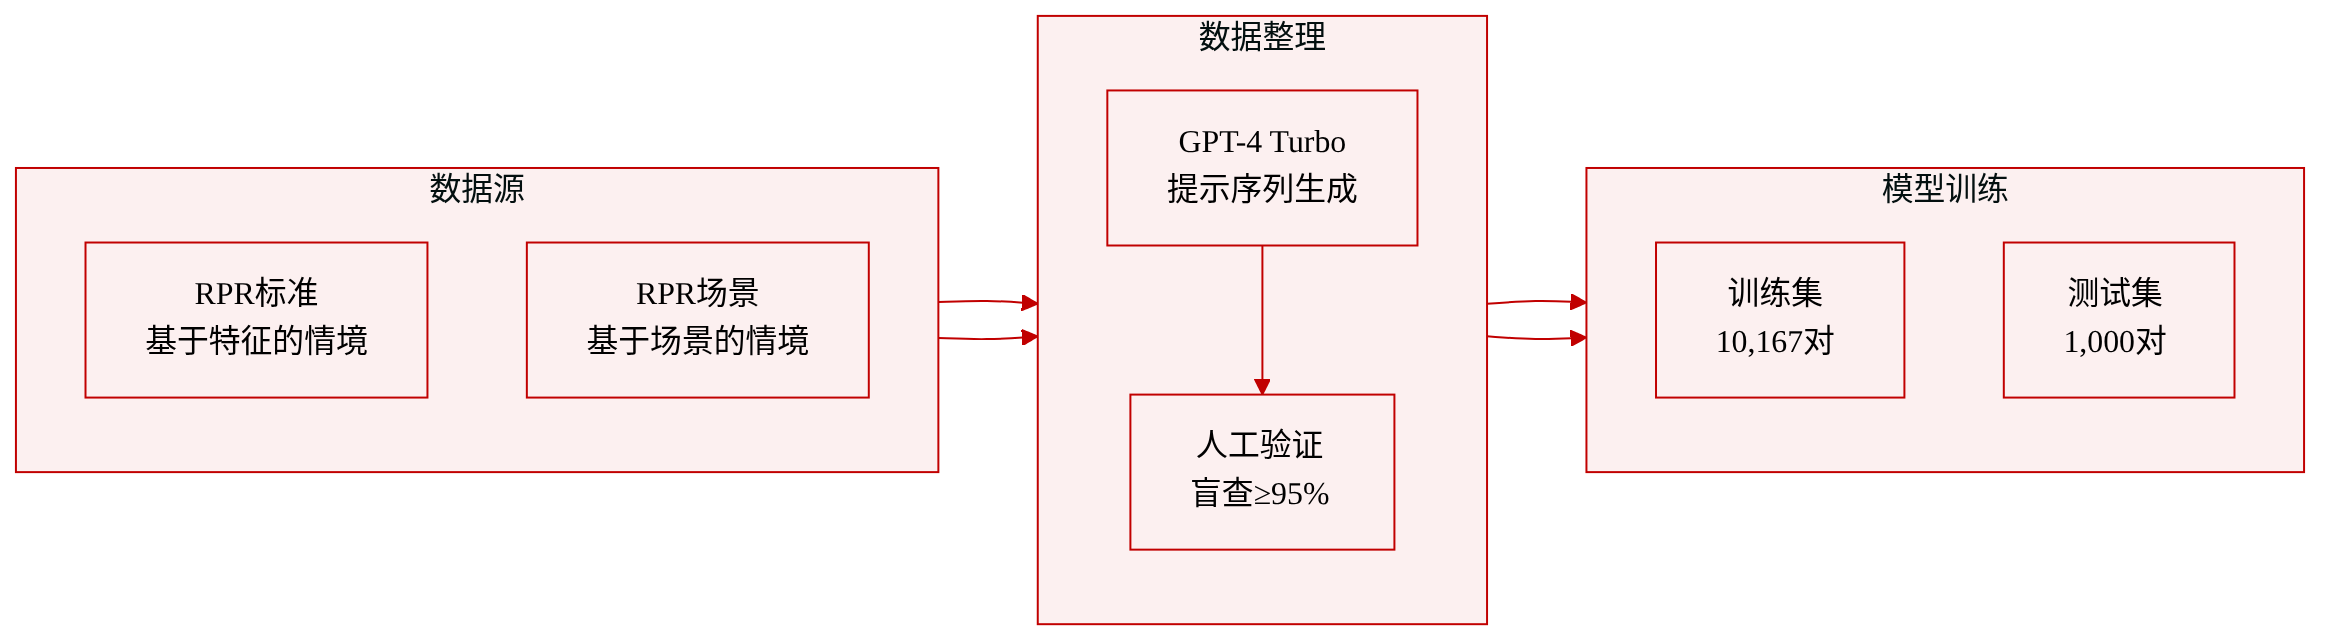
作者引入了合理偏好反转(RPR)数据集,这是一组合成偏好数据集,旨在衡量偏好预测是否对上下文敏感。数据集包含超过20,000个提示、上下文和偏好判断的配对元组,格式为(x,z,y1≻y2)。样本的构造方式使得同一提示的两个完成之间的偏好在没有上下文时完全模糊;对于每个上下文,都存在一个替代上下文使得偏好反转。这种设计确保数据集上的性能完全取决于模型解释上下文的能力。
数据集有两个基础版本:
- RPR Criteria:上下文是描述哪些特征重要的短句,例如"使用正式且专业的语气,强调C++的技术方面"。
- RPR Scenarios:上下文描述了导致欠规格化提示的场景,例如一位正在准备产品发布的营销经理。
数据由GPT-4 Turbo通过一系列旨在最大化有效性和避免无效或模糊样本的提示生成。通过盲选偏好查询进行的小规模人工验证发现两个分区的同意率至少为95%。
数据集分为10,167个配对样本的训练集和1,000个配对样本的测试集,训练和测试提示之间没有重叠。论文还在单独一节中用用户画像扩展了数据集。数据集公开于https://huggingface.co/datasets/microsoft/rpr。
方法
作者引入了一种意图效用形式化方法来建模用户与语言模型的交互,定义为四元组(T,X,Y,u),其中T表示意图空间,X是提示空间,Y是完成空间,u:T×Y→R是标量效用函数。按照标准Bradley-Terry模型,给定特定意图i时,偏好完成y1而非y2的概率表示为:
p(y1≻y2∣i)=σ(u(i,y1)−u(i,y2)),其中σ是逻辑函数。该形式化方法中的一个关键区别是,偏好和效用是相对于意图而非提示定义的。具有意图i的用户选择提示x∈X来查询模型,而被呈现偏好查询(x,y1,y2)的标注者会从x中隐式推断意图i,然后从伯努利分布B[p(y1≻y2∣i)]中采样偏好。
用户和标注者都可能持有意图上的分布而非单一固定意图。作者假设存在一个可能意图上的基础分布pˉ(i),以及给定意图下提示的条件分布p(x∣i),这为任何提示引出了一个自然的推断分布p(i∣x)。在这种观点下,提示是意图的部分规格说明;额外的上下文z∈Z(其中Z构成意图空间的离散分区)可以被附加以获得扩展提示(x,z)。为了在意图分布p下衡量效用,作者采用了期望效用模型:
u(p,y)=Ei∼p[u(i,y)].尽管标准RLHF不与该模型对齐,但它满足"理想"偏好标注的可取公理。定义u(x,y):=u(p(⋅∣x),y),期望的线性性给出分解u(x,y)=∑z∈Zp(z∣x)u((x,z),y)。为方便起见,效用差Δ(⋅,y1,y2):=u(⋅,y1)−u(⋅,y2)也线性分解:
Δ(x,y1,y2)=z∑p(z∣x)Δ((x,z),y1,y2).在标准RLHF中,使用提示偏好元组的数据集D={(x,y1≻y2)}来学习效用估计器u^:X×Y→R,通常称为奖励模型。作者假设存在一个上下文推断模型p^(z∣x),满足类似关系:
u^(x,y)=z∑p^(z∣x)u^((x,z),y).虽然标准RLHF从不学习这样的估计器,但该分析假设它隐式或显式地存在,并且u^(x,y)是通过分解而非直接评估计算的。由于u^仅在常数平移意义下唯一,因此通过效用差估计器Δ^(x,y1,y2):=u^(x,y1)−u^(x,y2)来衡量准确性。
特定偏好查询的绝对误差可以如下界定。令Δz表示Δ((x,z),y1,y2),作者推导出:
Δ(x,y1,y2)−Δ^(x,y1,y2)≤Context-weighted prediction errorz∑p(z∣x)Δz−Δ^z+Preference-weighted inference errorz∑Δ^z∣p(z∣x)−p^(z∣x)∣.等式通过添加和减去∑zp(z∣x)Δ^z并重新排列得出,最终不等式多次应用三角不等式。在假设单一上下文(即p(z=c):=1)且进行单一预测(p^(c^)=1)的情况下,界简化为:
Δ(x,y1,y2)−Δ^(x,y1,y2)≤True context prediction errorΔc−Δ^c+Subjective difference: true vs predicted contextΔ^c−Δ^c^.一般界和特定界都形式化了核心主张:如果能在真实上下文(或上下文分布)条件下准确做出预测,那么偏好建模问题就简化为上下文推断问题。
上界将总误差分解为上下文加权预测误差和偏好加权推断误差。在一个极端,设置Z=∅恢复了标准偏好建模,其中上下文推断误差为零,所有误差都来自给定提示条件下的偏好预测。在另一个极端,让Z退化使得z直接编码偏好响应(例如"偏好响应是y"),预测误差消失,但上下文推断问题变得等同于生成。在这两个极端之间,作者推测预测误差和推断误差之间存在平滑的权衡,如果单一上下文能消除一系列不同偏好查询的歧义,这种权衡就成立。他们的实验支持这一猜想:基于特定标准的条件化优于基于更抽象场景的条件化,而后者又优于将单一用户画像应用于所有查询的条件化。
当效用估计器u^在给定额外上下文时足够准确时,偏好建模问题在很大程度上可归约为上下文规格说明。在这种状态下,作者建议将标注资源分配给指定额外上下文,而不是让标注者对模糊提示的完成进行排序。这些标注随后可以训练上下文推断模型来消除提示的歧义。作者假设上下文空间的基数小于给定提示的完成空间的基数,这使得联合上下文偏好标注比单独偏好标注更具数据效率。这种方法的效果取决于语言模型是否真正对新增上下文敏感,作者在真实数据上评估了这个问题,并通过训练上下文条件奖励模型来解决。
实验
实验在多个数据集和模型上评估了上下文感知偏好建模,包括奖励模型、生成式裁判和微调的Mistral CARM,使用与上下文条件偏好的一致性指标。结果表明,访问上下文通常能改善性能,但模型有时会忽略对抗性上下文,这显示了改进空间。在RPR数据集上微调显著提升了上下文特定性能,达到或超过GPT-4 Turbo等更大模型,并且模型泛化到了增强的真实世界偏好数据集。最后,一个推断出的单一用户画像可以恢复约80%的偏好一致性,仅需2到4个样本即可解决默认偏差,16到32个样本即可恢复真实上下文的大部分收益。
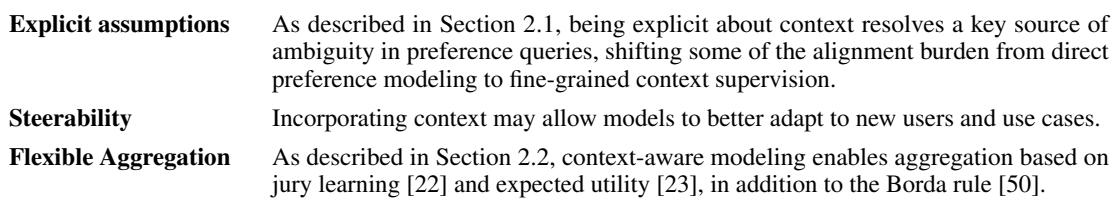
上下文感知偏好建模通过使隐式假设显式化来解决模糊性,提高对新用户和用例的适应性,并通过陪审团学习和期望效用等方法实现灵活的聚合。微调上下文感知模型还显著提升了上下文特定性能,通常达到或超过更大的基线模型。使上下文显式化解决了偏好查询中模糊性的关键来源,将对齐负担转移到细粒度的上下文监督上。融入上下文使模型能更好地适应新用户和用例。聚合灵活性超越了Borda规则,扩展到陪审团学习和期望效用。微调的上下文感知模型在上下文特定性能上优于其基础模型,媲美或超越GPT-4 Turbo和Llama 3等更大模型。
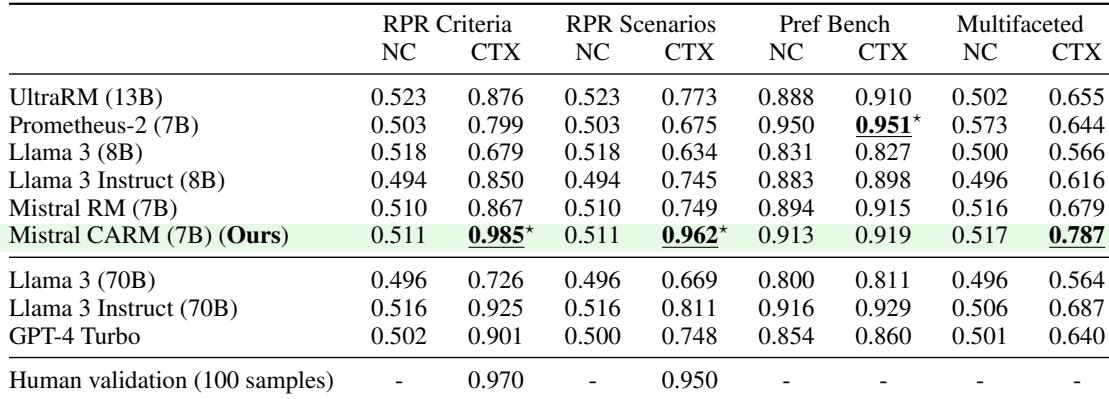
添加上下文通常能改善跨数据集的偏好评估,但当偏好在没有上下文时是模糊的情况下,收益最为显著。在RPR训练集上微调的模型在测试集上大幅优于未微调的对应模型。更大和经过指令微调的模型往往从新增上下文中获益更多。访问上下文能改善所有测试数据集的性能,在没有上下文时偏好最模糊的数据集上收益最大。在RPR训练集上微调相比未微调模型产生了明显更好的测试性能。更大和经过指令微调的模型从新增上下文中获益更多。
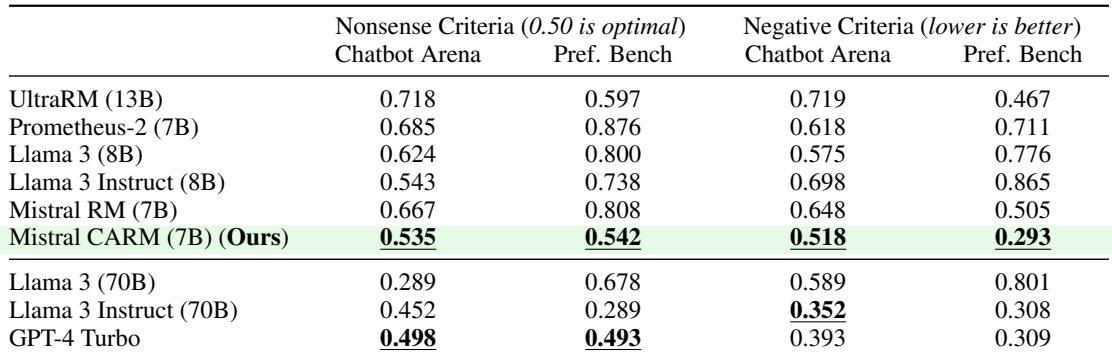
当前模型对措辞强烈的对抗性上下文基本上不敏感,即使上下文本应反转或随机化其预测,它们也常常无法调整预测。微调的CARM模型在两个对抗性标准上都优于其他小模型,但仍未达到最优行为,这表明存在很大的改进空间。即使有强烈的对抗性上下文,许多模型仍保持接近基线的分数,表明它们经常忽略新增的指令。微调的CARM在无意义标准(nonsense)和负面标准(negative)上都实现了小模型中的最佳性能。所有模型的性能仍远未达到最优,尤其是在无意义标准上,随机评分将达到0.50。
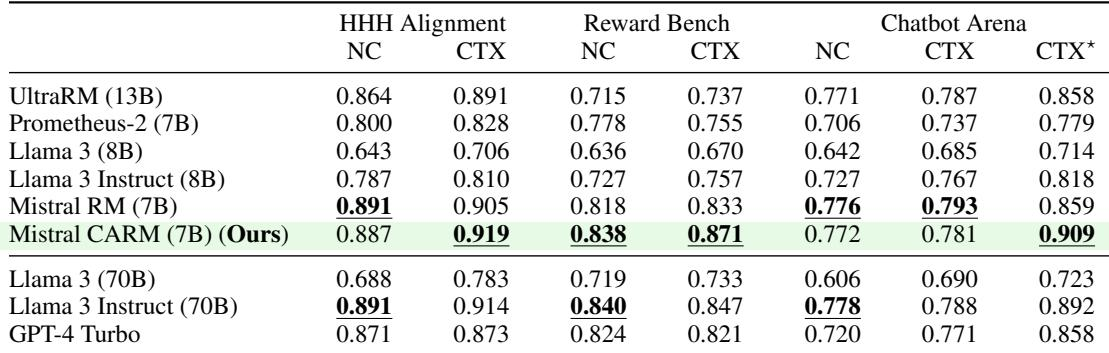
向偏好数据集添加上下文通常能改善所有测试模型的性能,但微调的上下文感知奖励模型(CARM)在获得高质量或特权上下文时在小模型中表现突出。CARM在大多数上下文增强设置中也显示出一致的增益,匹配或超过更大模型的性能。微调的CARM在上下文增强偏好任务上优于其他小模型,尤其是当上下文包含特权偏好信息时。上下文通常能提升大多数模型的性能,但CARM的提升更为显著,特别是在带上下文的HHH和Reward Bench数据集上。CARM相对于其基础模型的上下文特定增益在上下文从提示和表达的偏好中共同推断时最大,表明其在利用丰富上下文信号方面的优势。
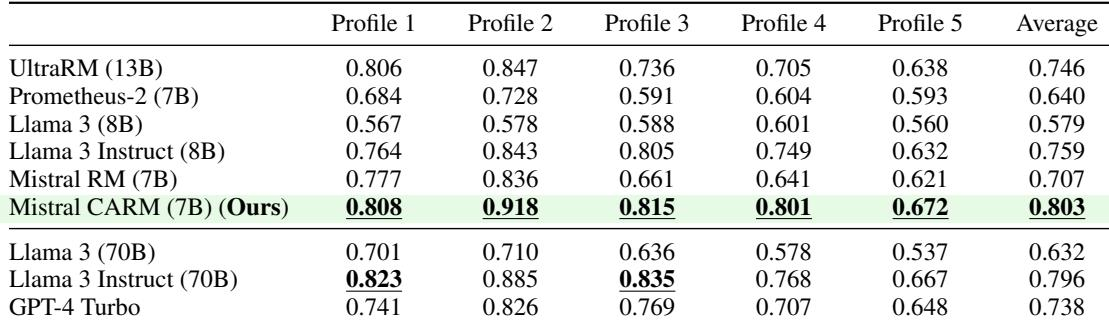
使用五个合成用户画像的实验表明,单一上下文可以有效地消除多个提示的偏好歧义。微调的CARM模型和Llama 3 Instruct在与GPT-4的画像条件标签的一致性上达到了最高水平,超过了GPT-4本身。这表明即使上下文是广泛的用户画像,上下文感知微调也能改善偏好建模。微调的CARM和Llama 3 Instruct在恢复画像条件偏好方面优于GPT-4。画像条件性能在不同画像间差异很大,最佳模型达到约80%的一致性。较小的微调模型达到或超过更大模型,表明有针对性的微调可以抵消模型规模优势。
在实验中,将显式上下文纳入偏好建模持续提高了评估准确性,特别是对于模糊偏好,微调的上下文感知奖励模型(CARM)通常达到或超过GPT-4和Llama 3等更大基线。然而,模型对强烈对抗性上下文仍然基本不敏感,性能仍远未达到最优行为,这表明还有改进空间。在合成用户画像测试中,单一上下文能有效消除偏好歧义,微调的CARM和Llama 3 Instruct在恢复画像条件偏好方面优于GPT-4,表明有针对性的微调可以抵消模型规模优势。