Command Palette
Search for a command to run...
AgentInstruct:面向智能体流程的生成式教学
AgentInstruct:面向智能体流程的生成式教学
Orca AgentInstruct 1M 合成指令微调数据集
摘要
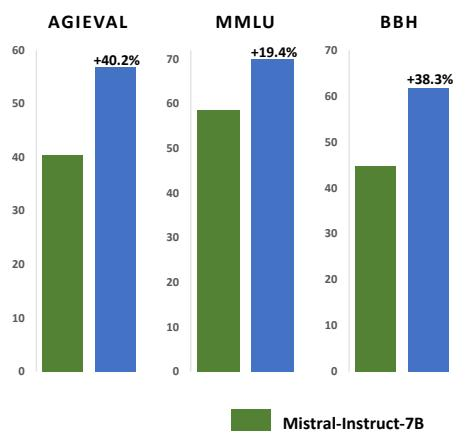
合成数据对于加速语言模型(无论是大型还是小型)的开发正变得越来越重要。尽管有一些成功的应用案例,研究人员也提出了关于模型崩溃以及模仿其他模型弊端的担忧。这种差异可以归因于合成数据在质量和多样性上的变化。有效使用合成数据通常需要大量的人力来进行数据整理。我们专注于将合成数据用于后训练,具体来说,即通过强大模型创建数据来教授另一个模型新技能或行为,我们将这种设置称为生成式教学。我们引入了 AgentInstruct,一个可扩展的智能体框架,用于自动创建大量多样且高质量的合成数据。AgentInstruct 可以仅使用原始数据源(如文本文档和代码文件)作为种子来创建提示和响应。我们通过创建一个包含 2500 万对的后训练数据集来展示 AgentInstruct 的实用性,该数据集用于教授语言模型不同的技能,如文本编辑、创意写作、工具使用、编码、阅读理解等。该数据集可用于任何基础模型的指令微调。我们使用这些数据对 Mistral-7b 进行后训练。将得到的模型(Orca-3)与 Mistral-7b-Instruct(使用相同的基础模型)进行比较时,我们在许多基准测试中观察到显著改进。例如,AGIEval 上改进 40%,MMLU 上改进 19%,GSM8K 上改进 54%,BBH 上改进 38%,AlpacaEval 上改进 45%。此外,它持续优于其他模型,如 LLAMA-8B-instruct 和 GPT-3.5-turbo。
一句话总结
在介绍AgentInstruct的过程中,这是一个可扩展的agentic框架,能够自动从原始种子数据生成多样化、高质量的合成后训练数据,产生2500万对提示-响应对,微软研究院的研究人员证明,使用这些数据对Mistral-7b进行后训练得到Orca-3模型,该模型在多个基准测试上相比Mistral-7b-Instruct取得了显著提升,AGIEval提升40%,MMLU提升19%,GSM8K提升54%,BBH提升38%,AlpacaEval提升45%,同时持续优于LLAMA-8B-instruct和GPT-3.5-turbo。
核心贡献
-
论文介绍了AgentInstruct,这是一个可扩展的agentic框架,通过使用包含超过100个子类别的分类法以及配备强大LLM、工具和反思流程的agents,从原始种子数据(如非结构化文本文档和源代码)自动生成大规模合成后训练数据,同时生成提示和响应。
-
这项工作展示了该框架的扩展能力,创建了一个包含2500万对的后训练数据集,涵盖文本编辑、创意写作、工具使用、编码、阅读理解、推理、数学和RAG等技能,仅使用公开可用的原始材料作为种子,不包含任何任务特定或基准测试数据。
-
结果表明,使用该数据集对Mistral-7B进行后训练得到Orca-3模型,在AGIEval上比Mistral-7B-Instruct提升40%,在MMLU上提升19%,在GSM8K上提升54%,在BBH上提升38%,在AlpacaEval上提升45%,在摘要基准测试上将幻觉减少了31.34%,并持续优于LLAMA-8B-instruct和GPT-3.5-turbo。
引言
合成数据已成为LLM训练中预训练、指令微调和RLHF等阶段的关键加速器,然而生成既高质量又多样化的数据仍然困难。先前的工作通常依赖强大的教师模型对现有提示集生成响应,但这可能导致模型崩溃、风格模仿而非能力提升,并严重依赖人工筛选和过滤。作者通过AgentInstruct解决了这些局限性,这是一种用于所谓生成式教学的agentic解决方案,利用具有反思、工具和超过100个子类别分类法的多agent工作流来自主生成提示和响应。AgentInstruct不需要种子提示,而是从原始非结构化文档开始,这些文档数量丰富,有助于学习通用能力而非特定于基准测试的行为。作者通过生成2500万对后训练数据集证明了其实用性,使用该数据集微调Mistral-7B产生Orca-3模型,在AGIEval、MMLU、GSM8K和BBH等基准测试上取得了显著提升,同时减少了幻觉,且未使用任何任务特定或基准测试种子数据。
数据集
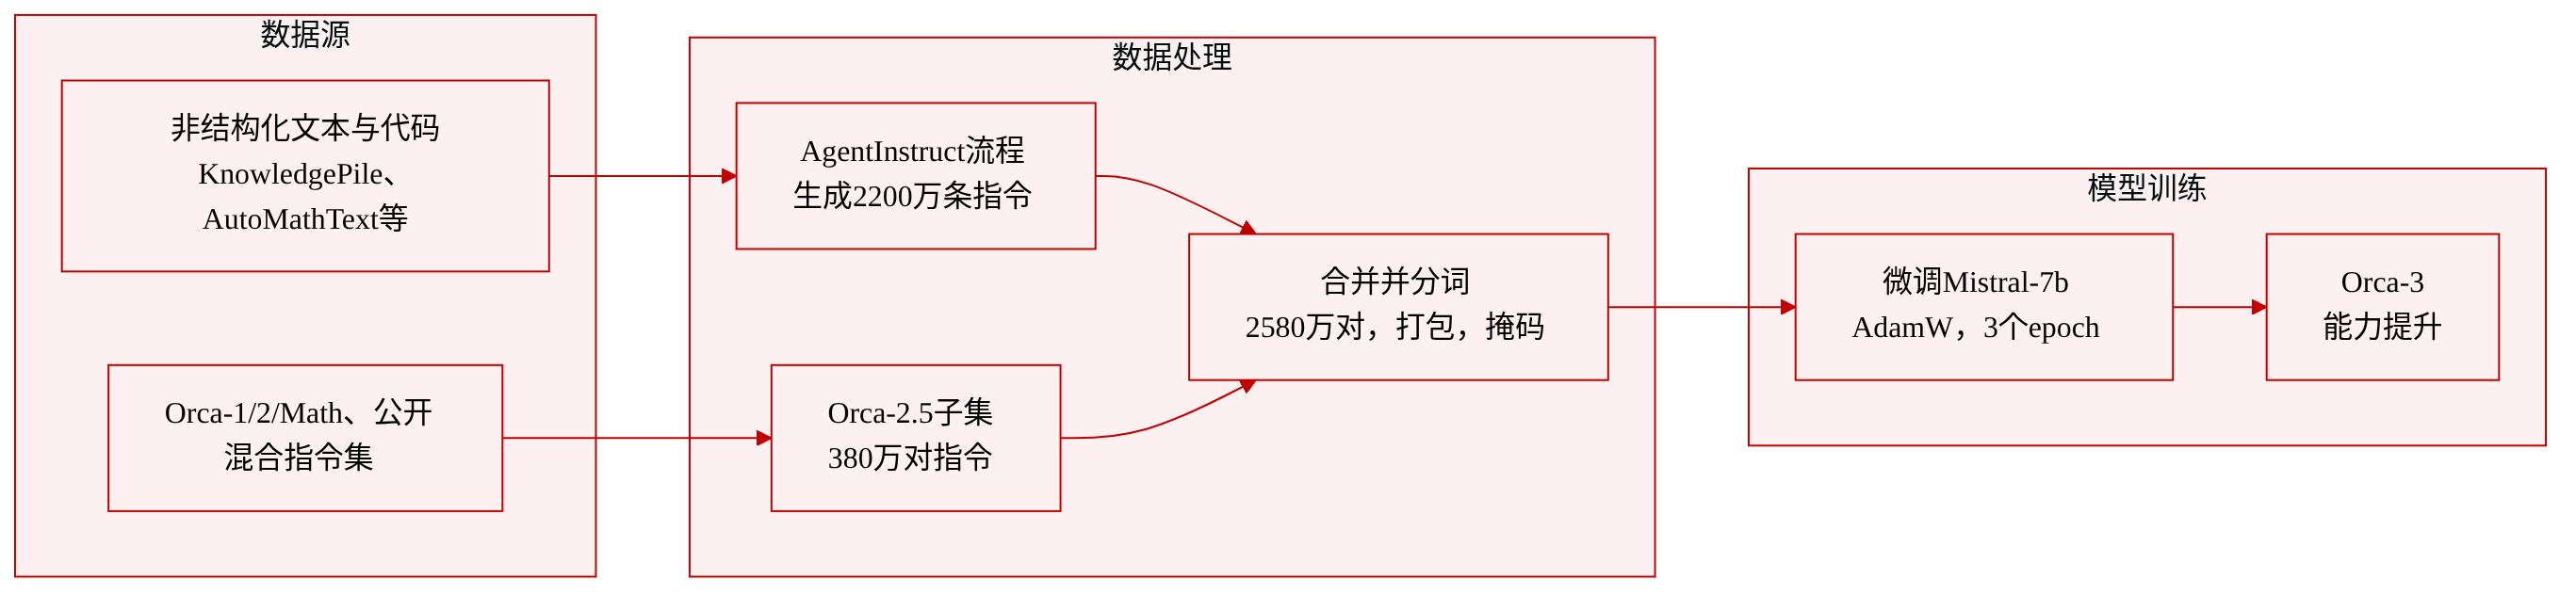
作者从两个主要组成部分构建Orca-3训练语料库。
主语料库构成
- 通过AgentInstruct Flow生成约2200万条指令,涵盖17种不同能力(详见其表1)。
- 生成的种子内容来自从KnowledgePile、AutoMathText、OpenStax子集以及Apache-2.0许可源代码文件子集中采样的非结构化文本和代码文件。
- 使用非结构化内容作为种子避免任何基准测试特定数据,使团队能够优化通用能力而非特定评估集。
- 额外的380万对配对指令来自Orca-1、Orca-2、Orca-Math以及其他公开来源的样本。这部分被称为Orca-2.5数据集。
- 合并后的语料库总计约2580万对配对指令,全部用于训练Orca-3。一个单独的模型Orca-2.5仅使用380万指令子集进行训练,以隔离AgentInstruct生成数据的影响。
训练使用和处理细节
- 2580万对配对指令用于微调Mistral-7b-v0.1,选择该模型是因为其公开的基础权重和宽松的许可证。
- 每对数据使用Mistral tokenizer进行分词,最大序列长度限制为8192并使用打包技术。
- 标签掩码确保训练损失仅基于提示条件下的响应计算。
评估数据集
- Orca-Bench作为留出测试集,所有17种策划能力每种技能包含100个样本。
- 开放域问答(ODQA)类别有两个测试子集:ODQA包含来自初始种子指令阶段的100个问题,Complex ODQA包含来自细化阶段的更复杂问题。
- Orca-Bench中的条目可能涉及多次交互。每个学生响应按0到10的尺度与教师(GPT-4)响应进行评估,最终得分按教师总分归一化。
- Orca-Sum是一个用于摘要和基于grounded数据转换的新基准。它从45个Hugging Face摘要数据集中采样数据,涵盖新闻、对话、科学、健康、社交、电子邮件和代码等领域,产生458个数据点。收集最多1000个候选点并仔细去重以避免与训练数据重叠。GPT-4为每个数据集生成40个特定于数据集的提示,每个数据点随机选择其中一个,迫使模型在不同格式和领域之间切换。
方法
作者提出了AgentInstruct,这是一个系统化的高质量合成指令微调数据大规模生成流程。如下图所示:
核心架构依赖于自动数据合成的agentic流程,同时确保各种推理和工具使用能力的多样性和复杂性。该流程通过三个不同阶段运行:内容转换、种子指令生成和指令细化。
在初始内容转换流程中,原始种子数据(如网络文章、教科书章节或源代码片段)被处理以创建针对下游任务生成优化的中间表示。一组专门的agents评估每个种子并应用风格或结构修改,例如将事实性文本转换为论证性段落或辩论。此步骤不仅标准化输入格式,还在生成的数据分布中引入大量变化。
在转换之后,种子指令生成流程对修改后的种子产生多样化的初始指令集。系统采用预定义分类法来指导agent选择,确保涵盖多个认知和功能类别。对于阅读理解,agents生成针对字面理解、批判性分析或逻辑推理的问题。对于工具使用场景,该流程从代码片段合成API描述并制定需要单步或多步API调用的任务,包括参数缺失或多余的场景。每个agent都设计有特定的系统提示和可选的工具使用能力来执行指定角色。
指令细化流程随后迭代增强生成指令的质量和难度。该阶段利用一个Suggester-Editor agent对。Suggester agent分析当前指令并提出增加复杂性的修改建议,例如引入不可回答条件、改变ground-truth答案或添加具有挑战性的干扰项。Editor agent随后实施这些建议,产生细化的指令-响应对。这个迭代循环持续到达到所需的复杂程度,有效模拟人工介入的策划过程而无需人工干预。
为了训练最终模型,作者利用了通过该流程生成的2580万指令-响应对数据集。基础架构是Mistral-7b-v0.1,在合成数据上进行监督微调。每对数据使用最大序列长度8192进行分词并打包以优化GPU内存利用。在前向传播期间应用标签掩码,确保交叉熵损失仅在模型生成的响应上计算而非提示上。训练配置使用AdamW优化器,权重衰减为0.1。学习率初始化为8×10⁻⁶,遵循余弦衰减调度,前500步进行线性预热。优化过程在152个NVIDIA A100 GPU集群上运行三个epoch,全局批大小为10,约200小时计算后结束。
实验
评估设置将Orca-3(使用AgentInstruct合成数据后训练的模型)与多个基线进行比较,包括Orca-2.5、Mistral-Instruct-7B和GPT-4,覆盖推理、阅读理解、数学、格式遵循、摘要和检索增强生成等广泛基准。结果一致显示AgentInstruct训练带来的显著收益:在留出的Orca-Bench上相比基线有显著改进,阅读理解的大幅提升使7B模型在LSAT部分匹配GPT-4,数学能力在不同难度级别上的大幅提升,以及超越Gemini Pro的格式遵循改进。该方法还将摘要幻觉减少了约三分之一,同时保持GPT-4级别的质量,并在医疗领域显著增强RAG性能,展示了向新领域有效迁移技能的能力。
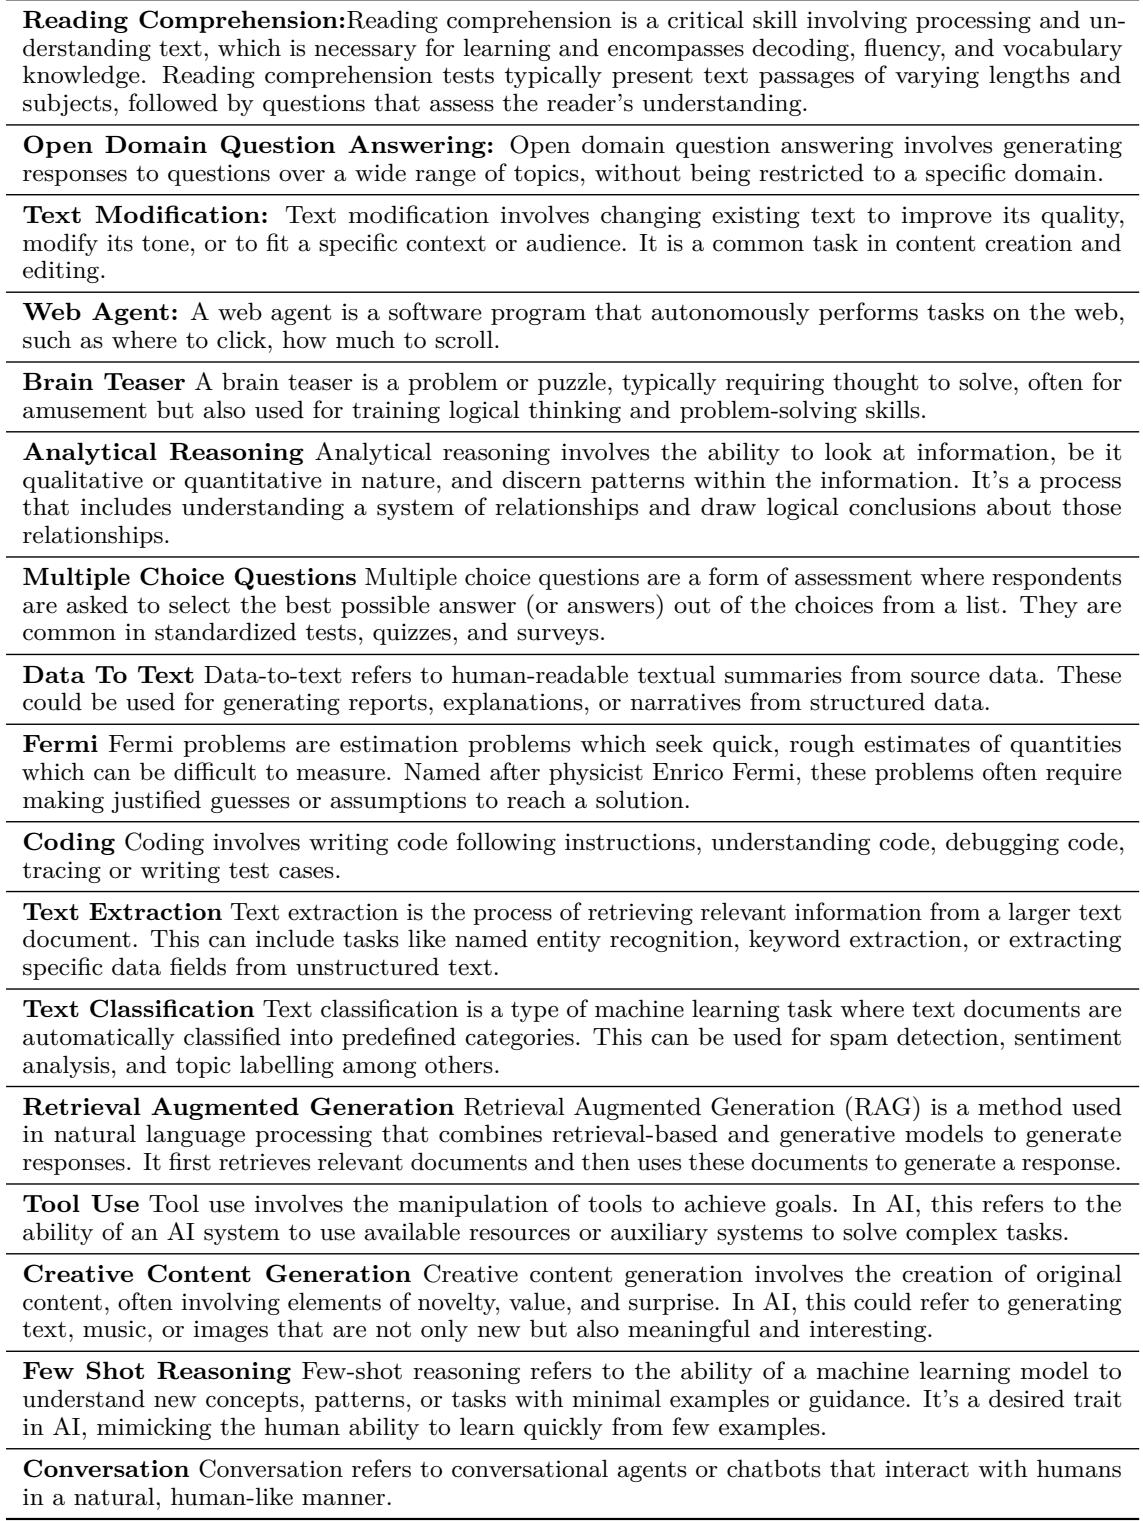
表格列出了实现AgentInstruct Flow的17种能力,涵盖阅读理解、开放域QA、文本修改、web agents、脑筋急转弯、分析推理、多项选择题和数据到文本生成等技能。这些流程用于从非结构化文本和代码源创建约2200万条指令的大规模合成数据集,随后与额外的配对指令组合以训练Orca-3。该方法旨在增强模型在多样化任务上的能力,同时避免基准测试特定数据。AgentInstruct Flow为17种不同能力构建,从阅读理解到数据到文本生成。合成数据集使用非结构化文本和代码文件作为种子生成,实现大规模和多样化的指令创建。以能力为中心的方法避免基准测试特定数据,优化通用技能而非特定测试性能。
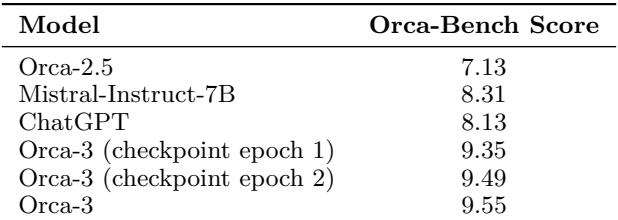
在Orca-Bench上,使用AgentInstruct数据训练的模型优于现有基线,最终Orca-3模型取得最高平均得分。收益在各训练检查点一致,显示随着更多训练epoch而逐步改进。Orca-3相比Orca-2.5基线平均提升约34%,相比Mistral-Instruct-7B提升约15%。最终Orca-3模型得分9.55,明显高于ChatGPT(8.13)和Mistral-Instruct-7B(8.31)。性能从epoch 1(9.35)到epoch 2(9.49)到最终模型(9.55)稳步提升,表明AgentInstruct数据带来了持续收益。
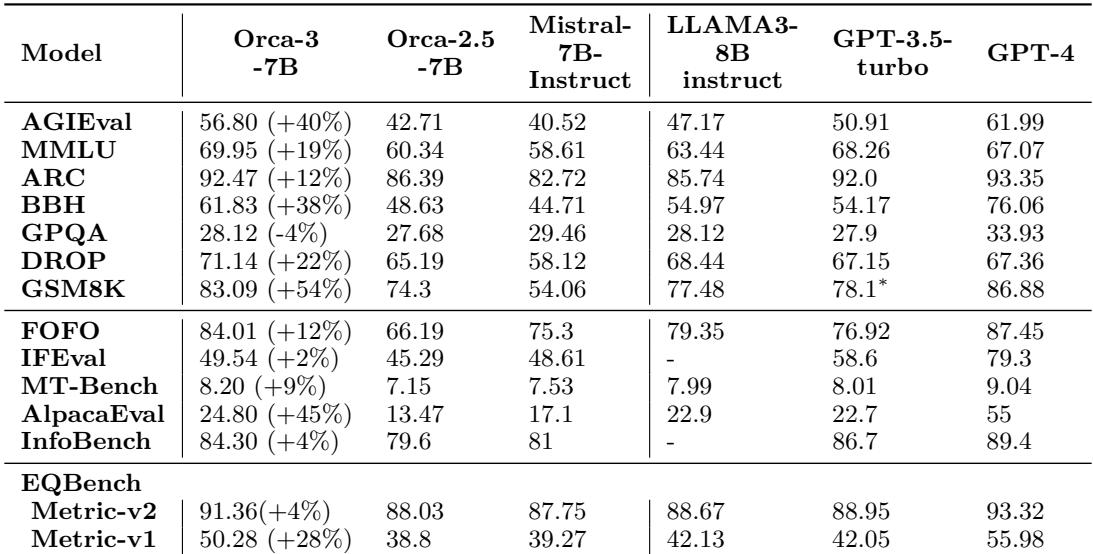
Orca-3在大多数基准测试上持续优于其基础模型Mistral-7B-Instruct,最大相对提升出现在GSM8K和AGIEval上。在多个任务上也超过了LLAMA3-8B和GPT-3.5-turbo等更大或专有模型,同时在ARC和MMLU上保持与GPT-4的竞争力。唯一明显的回退是GPQA,Orca-3略微落后于Mistral。Orca-3在GSM8K上相对于Mistral显示出最大的相对改进,提升54%,在AGIEval和BBH上也有强劲增长。Orca-3在MMLU、ARC、BBH和DROP上超过GPT-3.5-turbo,同时在ARC和MMLU上匹配或接近GPT-4。Orca-3唯一低于Mistral的基准是GPQA,相对下降4%。
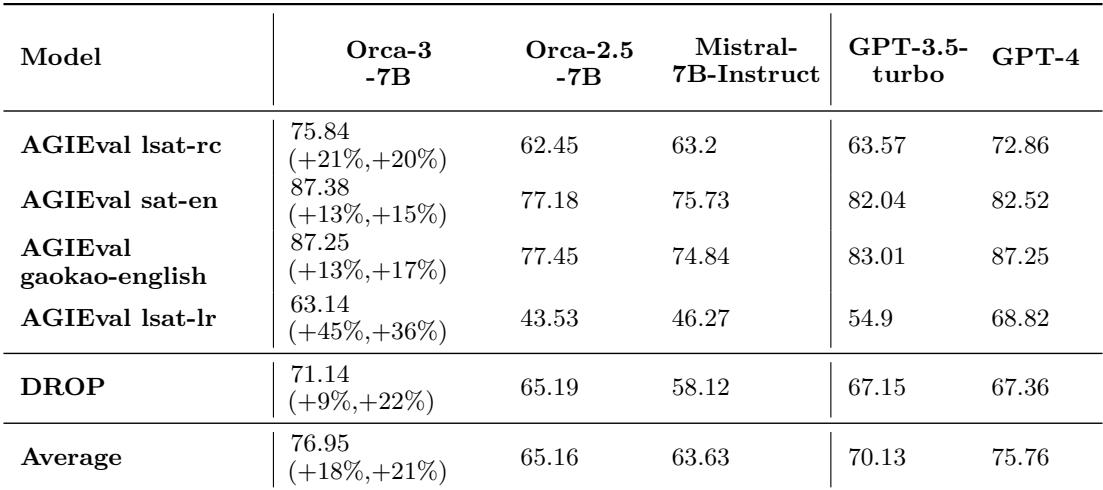
Orca-3在阅读理解基准上持续优于Orca-2.5和Mistral-7B-Instruct,平均分别提升18%和21%。最大提升出现在AGIEval lsat-lr上,Orca-3相比Orca-2.5提升45%,相比Mistral提升36%。其平均得分也超过GPT-3.5-turbo,接近GPT-4的水平。Orca-3在所有比较模型中除GPT-4外取得最高平均得分,超过GPT-3.5-turbo。最大相对提升在AGIEval lsat-lr上,Orca-3相比Orca-2.5提升45%,相比Mistral-7B-Instruct提升36%。在DROP上,Orca-3相比Mistral-7B-Instruct提升22%,是任务间第二大差距。Orca-3的收益在所有五个子任务上一致,每个指标上都优于两个基线。
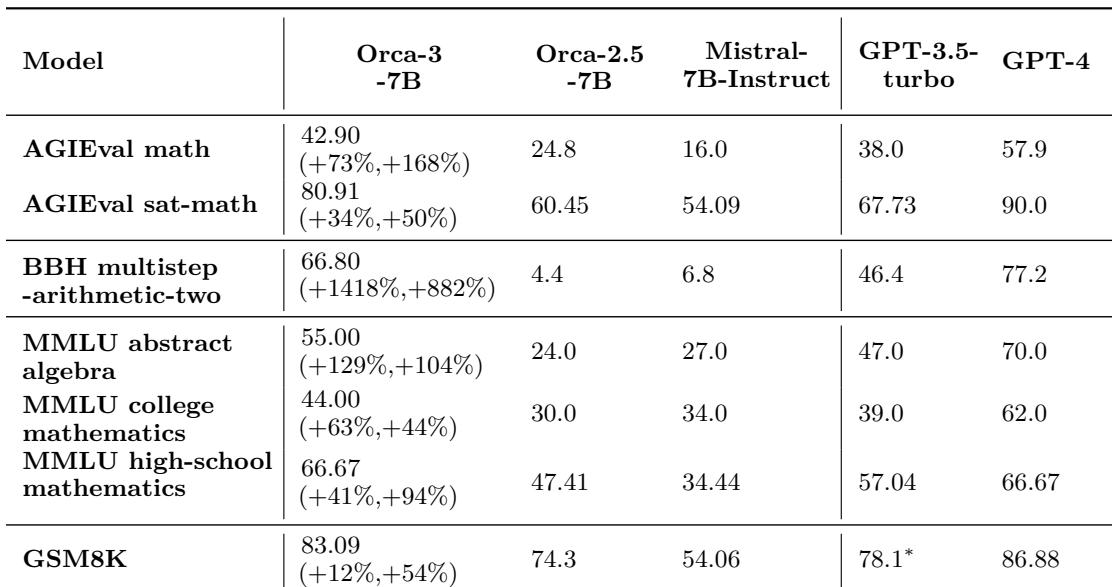
经过AgentInstruct训练的Orca-3模型在所有数学基准上持续优于Orca-2.5和Mistral-7B-Instruct,最大提升出现在多步算术和抽象代数上。改进幅度从约12%到超过1400%,展示了从小学到大学水平数学的有效技能迁移。Orca-3在多步算术上显示出巨大的相对提升,相比Orca-2.5提升超过1400%,相比Mistral-7B-Instruct提升超过880%。在抽象代数上,Orca-3几乎是Orca-2.5得分的两倍,是Mistral-7B-Instruct的三倍多,同时超过GPT-3.5-turbo。Orca-3在所有非GPT-4模型中取得高中数学的最高绝对得分,并在该基准上与GPT-4持平。在所有列出的基准上,Orca-3超越其直接前身Orca-2.5的幅度从12%到1418%不等,超过Mistral-7B-Instruct的幅度从44%到882%。
评估设置使用AgentInstruct Flow在17种能力上生成大规模合成数据集,随后用于训练Orca-3。在包括Orca-Bench、阅读理解、数学等多个基准上,Orca-3持续优于其基础模型和先前版本,经常超过GPT-3.5-turbo等更大或专有模型并接近GPT-4。收益随训练广泛且渐进,唯一明显的回退出现在GPQA上。总体而言,以能力为中心的数据合成被证明能有效提升通用技能,而无需依赖基准测试特定数据。