Command Palette
Search for a command to run...
TaskBench:面向任务自动化的大语言模型基准测试
TaskBench:面向任务自动化的大语言模型基准测试
Yongliang Shen Kaitao Song Xu Tan Wenqi Zhang Kan Ren Siyu Yuan Weiming Lu Dongsheng Li Yueting Zhuang
TaskBench 任务自动化基准数据集
摘要
近年来,大语言模型(LLMs)的显著进展激发了人们对任务自动化的兴趣,这涉及将用户指令描述的复杂任务分解为子任务,并调用外部工具执行这些子任务,在自主代理中扮演核心角色。然而,目前缺乏系统化和标准化的基准测试来促进LLMs在任务自动化方面的发展。为解决这一问题,我们引入了TASKBENCH,一个综合框架,用于评估LLMs在任务自动化中的能力。具体而言,任务自动化可分为三个关键阶段:任务分解、工具选择和参数预测。为应对这些阶段固有的复杂性,我们引入了工具图(Tool Graph)的概念来表示分解后的任务,并采用反向指令(back-instruct)方法生成高质量的用户指令。我们提出了TASKEVAL,一种多方面的评估方法,用于评估LLMs在这三个阶段的表现。我们的方法将自动化构建与严格的人工验证相结合,确保与人工评估高度一致。实验结果表明,TASKBENCH有效反映了各种LLMs在任务自动化中的能力,并为模型在不同任务复杂度和领域中的表现提供了见解,推动了当前模型所能达到的极限。TASKBENCH为推进基于LLM的自主代理提供了一个可扩展、适应性强且可靠的基准测试。
一句话总结
浙江大学、微软亚洲研究院和复旦大学的研究者提出了 TASKBENCH,这是一个综合框架,用于评估大语言模型在任务自动化三个关键阶段(任务分解、工具选择和参数预测)中的表现。该框架利用 Tool Graph 表示和 Back-Instruct 方法进行数据生成,并采用结合自动化构建与严格人工验证的 TASKEVAL 评估方法,以可靠地评估自主 agent 能力。
核心贡献
- 论文提出 TASKBENCH,一个可扩展且可靠的基准框架,用于评估 LLM 在任务自动化三个关键阶段(任务分解、工具选择与参数预测)中的能力。
- 论文提出 Tool Graph 概念,该概念对工具之间的真实依赖关系和相互连接进行建模,并配合 Back-Instruct 方法,将工具子图与用户指令对齐,以减少幻觉并提高数据真实性。
- 论文提出 TASKEVAL,一种结合自动化构建与严格人工验证的多维度评估方法。实验结果表明,TASKBENCH 能够有效反映 LLM 在不同任务复杂度和领域中的性能,并与人工评估表现出高度相关性。
引言
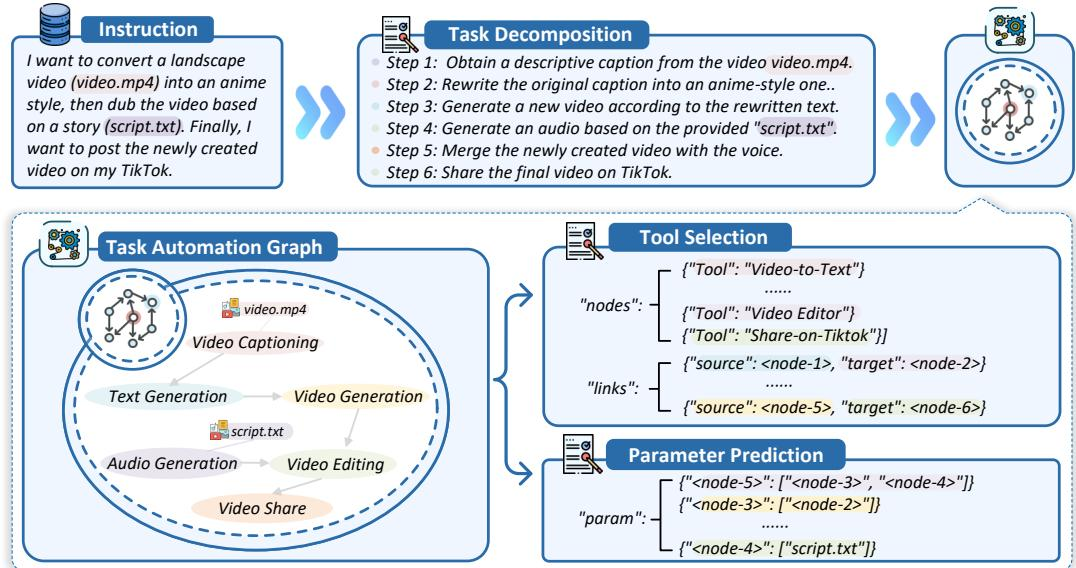
以大语言模型为核心的自主 agent 已成为人工智能研究的重要方向,任务自动化是其核心能力。这一能力涉及使用 LLM 理解用户指令,并通过多个阶段自主执行目标:任务分解、工具选择和参数预测。然而,该领域缺乏系统性、标准化的基准来全面评估这些能力。现实任务通常包含复杂指令、多个子任务和相互依赖的工具,这使得对工具依赖关系进行建模成为数据集构建和评估指标设计中的关键挑战。
现有基准存在不足。传统的基准如 MMLU、GSM8K 和 AGIEval 评估的是通用知识或推理能力,而非任务自动化。工具增强型基准如 APIBench、ToolBench 和 MetaTool 侧重于工具选择或问答等特定方面,但它们很少覆盖任务自动化的所有阶段,也未能充分建模复杂的工具依赖关系。这些方法中基于模板的数据生成和对人工验证的严重依赖进一步限制了其可扩展性和多样性。
为弥补上述不足,作者引入 TASKBENCH,一个用于评估 LLM 任务自动化能力的综合基准。作者首先提出 Tool Graph 概念,其表示工具之间的关系和依赖,克服了简单 API 文档或基于模板方法的局限性。在此基础上,作者应用反向指令(back-instruct)策略,从采样的子图中生成多样且真实的用户指令。多步骤质量控制流程(包括结构化采样、基于 LLM 和基于规则的自我批评机制以及广泛的人工验证)确保了数据的自然性和实用性。作者还提出 TASKEVAL,一个多维度评估框架,用于评估 LLM 在任务分解、工具选择和参数预测方面的表现。实验结果表明,由 TASKEVAL 支持的 TASKBENCH 能够有效反映 LLM 在多个维度上的能力,并与人工评估高度相关。
数据集
作者引入 TASKBENCH,这是一个专为评估 LLM 任务自动化能力而设计的基准。与以往依赖收集或指令方法的方案不同,作者采用反向指令(back-instruct)策略来模拟反映多任务之间复杂关系和更贴近实际用户指令的数据。
-
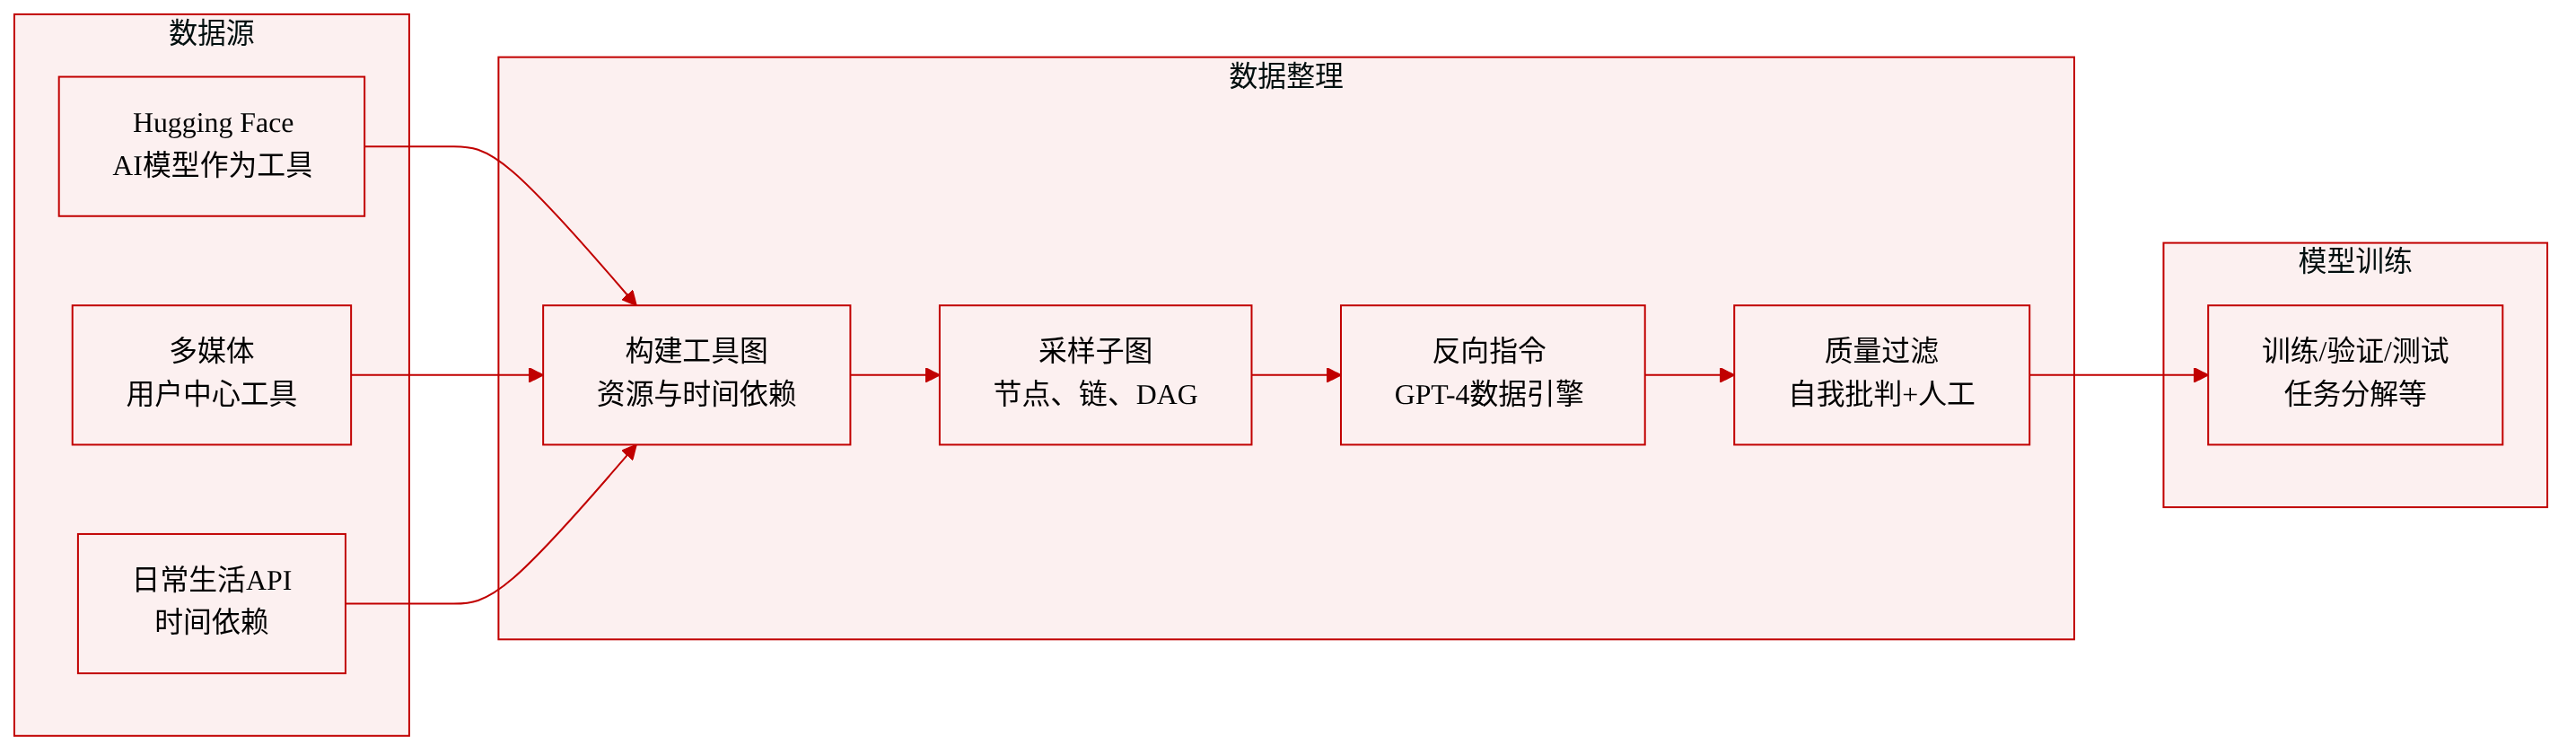
Tool Graph 构建:数据集围绕 Tool Graph(TG)构建,形式化定义为 G = (T, D),其中 T 是工具集合,D 是依赖关系集合。作者关注两种依赖类型:资源依赖(当工具 a 的输入类型与工具 b 的输出类型匹配时)和时序依赖(定义工具之间的执行顺序)。工具图从三个领域构建:
- Hugging Face:将 AI 模型视为工具,通过输入输出类型匹配确定连接。该图包含 23 个工具和 225 条边。
- Multimedia(多媒体):面向用户的更广泛工具,如文件下载器和视频编辑器,使用相同的连接策略。该图包含 40 个节点和 449 条边。
- Daily Life APIs(日常生活 API):如网络搜索和购物等服务,主要按时序依赖连接。该图包含 40 个节点和 1,560 条边。
-
子图采样:作者从工具图中采样子图,以获取有效的工具调用模式。使用三种子结构类型:
- Node,表示单个独立的工具调用。
- Chain,表示顺序工具调用。
- DAG,表示更复杂的调用,其中某个工具依赖于多个工具或对多个工具产生影响。 采样函数接受一个模式和一个大小(范围从 1 到 10 个工具),以控制采样子图的拓扑结构和规模。
-
Back-instruct 数据生成:作者使用 GPT-4 作为数据引擎,将采样得到的子图转换为用户指令。BackInstruct1 根据采样得到的工具骨架生成用户指令,而 BackInstruct2 则填充工具执行参数,并生成任务分解步骤以及最终的工具调用图。
-
质量控制:为确保数据质量,作者采用多步骤过滤:
- 自我批评机制,包括基于 LLM 的变体和基于规则的变体,检查生成的指令与采样工具子图之间的一致性。
- 人工验证,专家在统一标准的校准环节后,对指令的自然性、复杂度和一致性进行审查。
-
数据集统计与使用:数据集覆盖三个领域,Node:Chain:DAG 采样模式比例为 3:7:8。工具数量分布设置为 {0.1, 0.2, 0.3, 0.2, 0.1, 0.05, 0.025, 0.025, 0.025}。该基准使 LLM 能够完成完整的任务自动化流程,包括任务分解、工具选择和参数预测。
方法
作者引入了一个利用“Back-Instruct”策略的数据生成框架,以模拟任务自动化的用户指令。该方法支持对 LLM 在任务分解、工具选择和参数预测方面的评估。完整工作流程如下图所示。
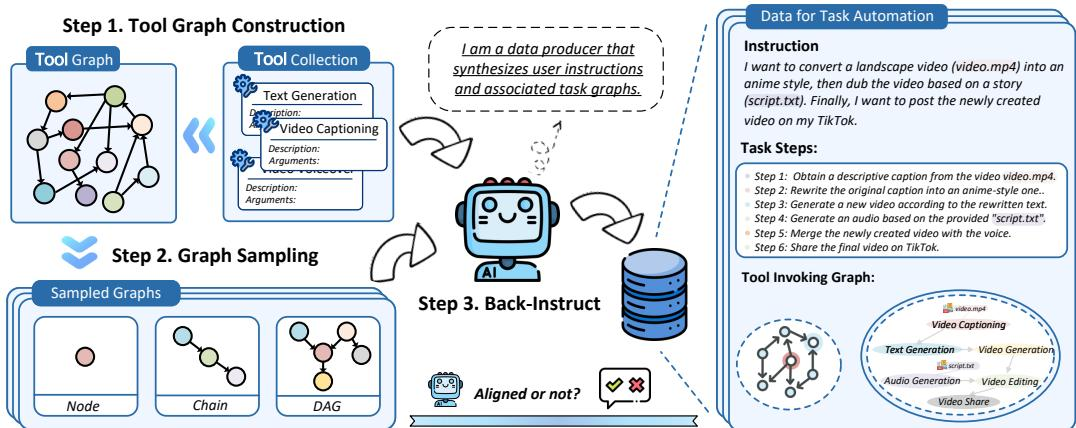
流程首先从 Tool Graph 构建 开始。作者聚合来自多种来源的独立工具,包括用于 AI 任务的 Hugging Face、用于面向用户操作的 Multimedia 工具以及用于网络搜索等服务的 Daily Life APIs。这些工具通过基于依赖关系建立边的方式组织成图 G。其中优先考虑两种依赖类型:资源依赖(一个工具的输入类型与另一个工具的输出类型匹配)和时序依赖(强制工具之间的顺序执行)。
图构建完成后,系统执行 图采样。从 G 中提取子图以创建多样化的结构模板,具体包括单节点、线性链和有向无环图(DAG)。采样过程以特定比例进行校准,以平衡生成数据中的复杂度和工具数量。
核心机制是 Back-Instruct,它从采样子图 Gs 中逆向合成用户指令。首先,LLM 生成一条需要子图内工具的用户指令 I,定义为 BackInstruct1(Gs)→I。由于子图仅勾勒出工具调用骨架,后续步骤会补充缺失的执行细节。LLM 填充参数以生成最终的工具调用图 Gˉ 以及相关的任务分解步骤 P,公式为 BackInstruct2(Gs,I)→{P,Gˉ}。
为保持高质量数据,框架融入了严格的质量控制机制。其中包括一个自我批评组件,具有两种变体:基于 LLM 的批评者,评估生成指令与采样子图之间的一致性;以及基于规则的批评者,通过比较节点和边来验证一致性。此外,还实施了人工验证流程,由专家对数据的逻辑连贯性、自然性和任务一致性进行审查,确保最终数据集适合用于基准测试。
实验
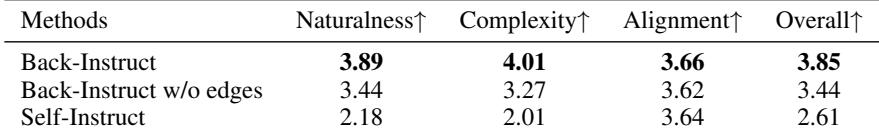
评估通过人工评价自然性、复杂度和一致性来验证 TaskBench 数据集质量,结果表明带有图边的 Back-Instruct 比无边变体或 Self-Instruct 能产生更自然、更复杂的指令。在 TASKEVAL 评估中(涵盖任务分解、工具选择和参数预测),GPT 系列模型始终领先,其中边预测比节点预测更困难,开源模型在复杂依赖关系上表现不佳。关键的影响因素包括代码预训练、指令跟随和 RLHF 对齐,且 TASKEVAL 与人工评估的强相关性证实了其作为基准的可靠性。
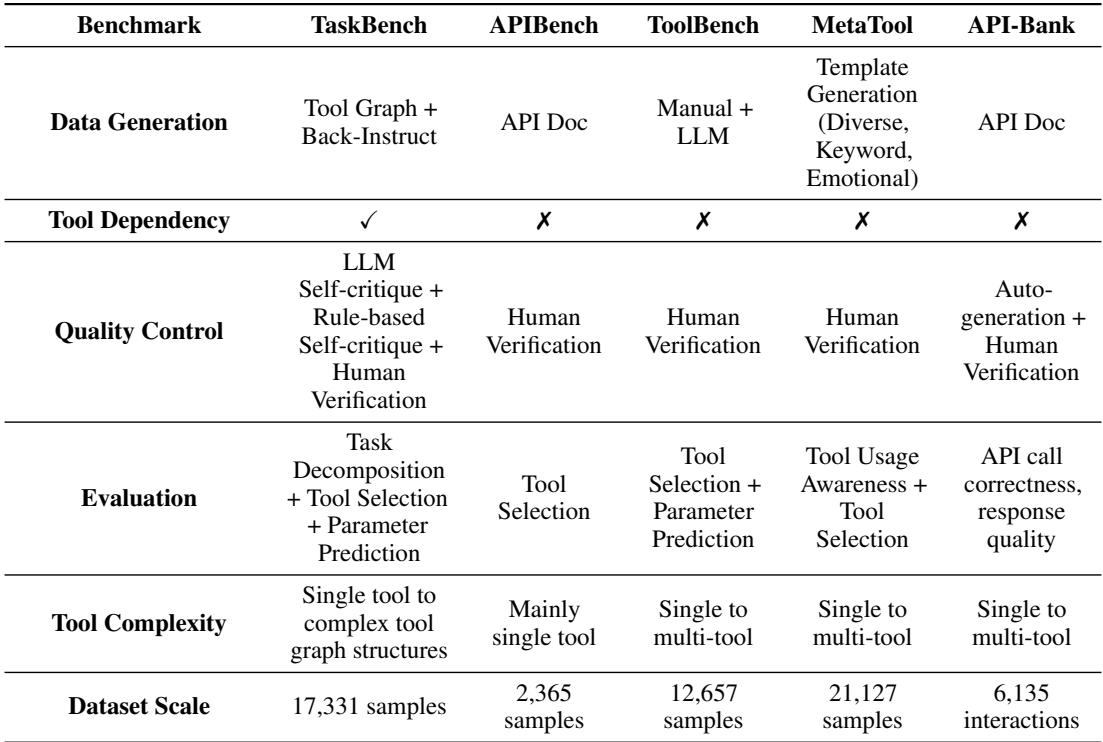
TaskBench 与现有的工具增强型 LLM 基准的区别在于,其使用 Tool Graph 进行真实依赖建模,并使用 Back-Instruct 策略进行数据生成,这提高了数据真实性并降低了幻觉风险。与以往主要依赖基于模板的生成或仅基于 API 文档的基准不同,TaskBench 在任务分解、工具选择和参数预测方面提供了更全面的质量控制和评估,其数据集规模更大、复杂性更高,涵盖从单个工具到多工具图结构。TaskBench 独特地将 Tool Graph 用于建模真实世界的工具依赖关系,而大多数其他基准不支持此类依赖建模。TaskBench 的数据生成将 Tool Graph 与 Back-Instruct 相结合,而其他基准则使用 API 文档或基于模板的方法。其评估覆盖任务分解、工具选择和参数预测,而许多基准仅关注工具选择或 API 正确性。TaskBench 支持从单个工具到复杂工具图结构的工具复杂度,这与某些其他基准类似,但采用了更集成的依赖建模方式。TaskBench 的质量控制使用 LLM 自我批评加规则验证,而其他基准主要依赖人工验证。
人工评估者对所有指标都给 Back-Instruct 打了高于其消融版本和 Self-Instruct 的分数,在自然性和复杂度方面提升尤为显著。从 Back-Instruct 中移除边信息会显著降低自然性和复杂度得分,而 Self-Instruct 在一致性相当的情况下总体得分最低。Back-Instruct 在自然性、复杂度和整体质量方面均优于无边变体和 Self-Instruct。移除边信息主要影响自然性和复杂度,而一致性保持相对稳定。Self-Instruct 产生明显更低的自然性和复杂度得分,表明其指令真实性和任务复杂度较弱。
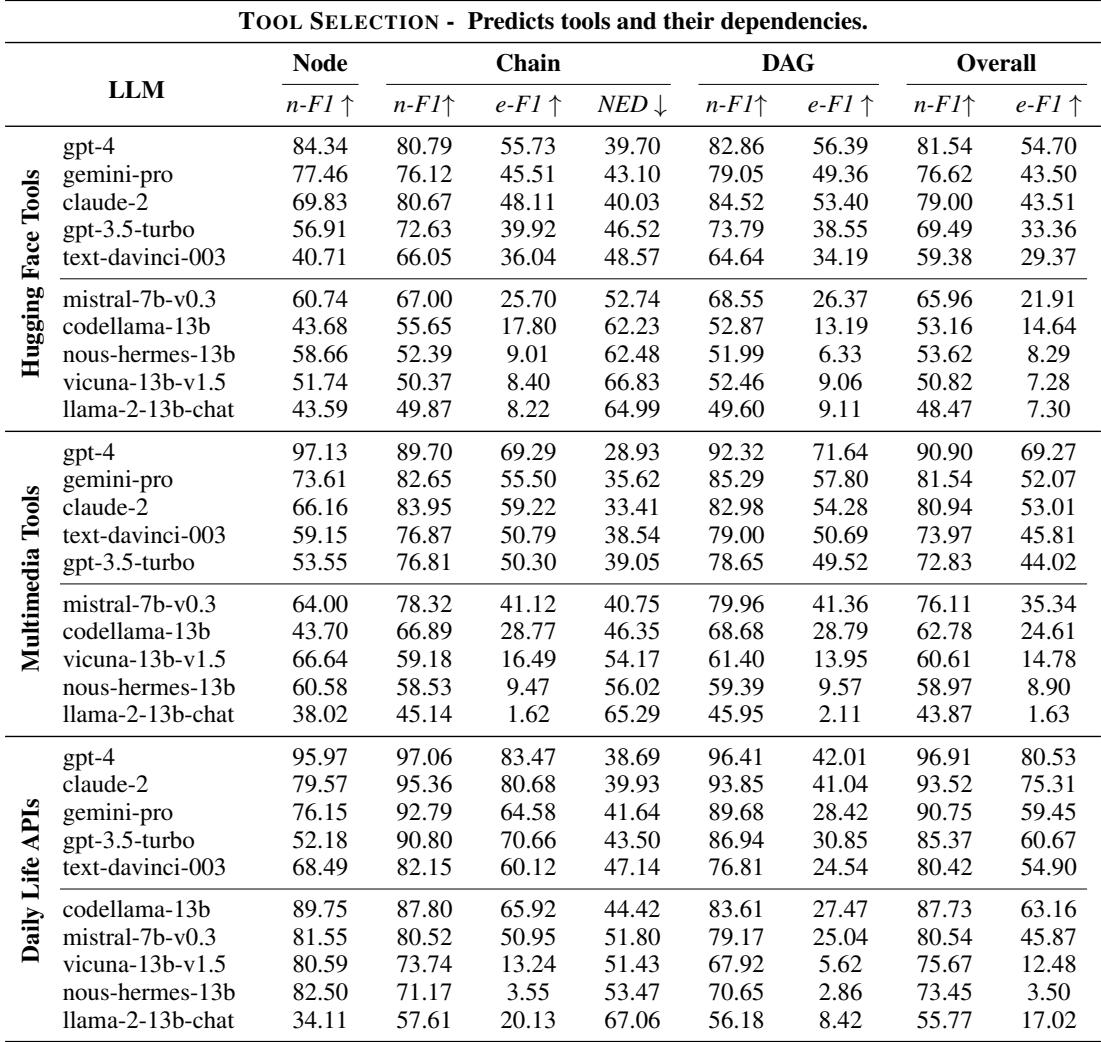
工具选择评估表明,LLM 在识别单个工具(节点预测)方面的表现始终优于捕捉工具间依赖关系(边预测),边 F1 分数通常落后约 20 分。模型排名随结构复杂度而变化:Mistral-7b 和 CodeLlama-13b 等开源模型在较简单的节点结构上可与 GPT-3.5-Turbo 竞争,但在更复杂的依赖图上则落后,而 GPT-4 在所有结构类型上表现最稳定且最优。所有模型的边预测难度始终大于节点预测,F1 差距约为 20 分。开源模型在简单节点任务上可匹配 GPT-3.5-Turbo,但在复杂依赖关系上表现不佳。GPT-4 总体领先,并在 Chain 和 DAG 结构上表现最稳定。
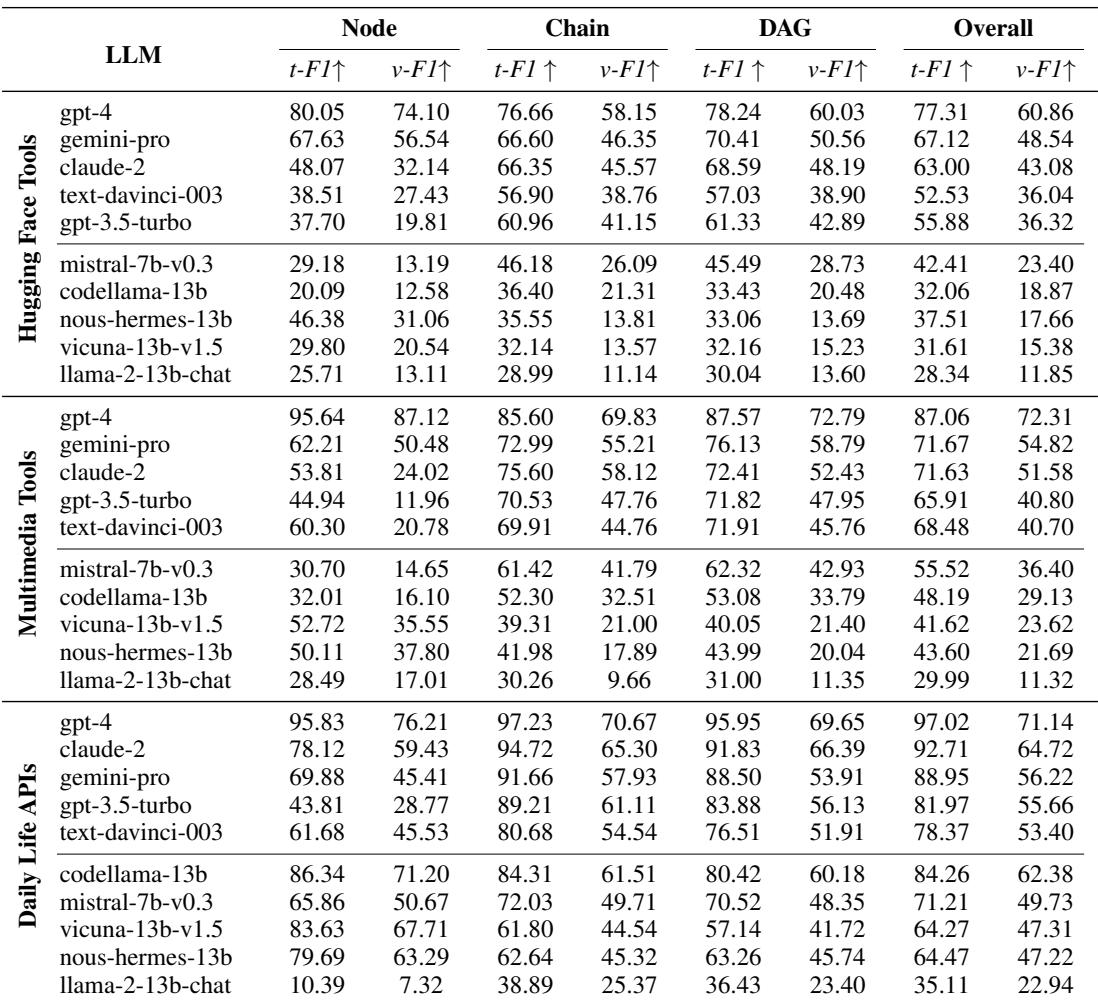
工具参数预测评估表明,GPT-4 在所有工作流类型上始终获得最高分,在参数名称和参数值识别方面均表现突出。Gemini-Pro 和 Claude-2 等闭源模型虽落后于 GPT-4,但优于开源替代模型。开源模型通常表现出较低的值级 F1 分数,表明在精确参数分配上存在差距。GPT-4 在 Node、Chain、DAG 和 Overall 设置下均以 t-F1 和 v-F1 指标领先所有模型。Mistral-7B 等开源模型表现最弱,尤其在 v-F1 上,凸显了正确预测参数值面临的挑战。所有模型的 v-F1 分数均低于 t-F1 分数,表明正确分配参数值比识别参数名称更加困难。
实验围绕 TaskBench 展开,这是一个使用 Tool Graph 进行依赖建模、使用 Back-Instruct 进行数据生成的工具增强型 LLM 基准。人工评估者认为其比消融变体或 Self-Instruct 变体更自然、更复杂。在各项任务中,边预测的难度始终大于节点预测,GPT-4 在工具选择方面持续领先,而开源模型在复杂依赖关系上表现不佳。在参数预测方面,所有模型都发现值识别比名称识别更困难,GPT-4 优于所有其他模型,其次是闭源模型,最后是开源模型。总体而言,实验结果验证了 TaskBench 的设计,并揭示了依赖建模和精确参数分配仍然是工具增强型 LLM 面临的关键挑战。