Command Palette
Search for a command to run...
TIC-CLIP:CLIP 模型的持续训练
TIC-CLIP:CLIP 模型的持续训练
Saurabh Garg Mehrdad Farajtabar Hadi Pouransari Raviteja Vemulapalli Sachin Mehta Oncel Tuzel Vaishaal Shankar Fartash Faghri
TiC-DataComp 时间持续学习数据集
摘要
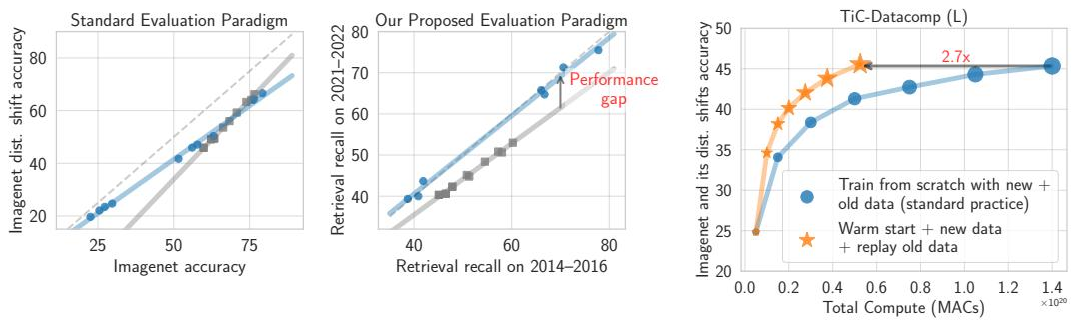
使大型基础模型保持与最新数据同步更新,其成本本身就很高昂。为避免不断重新训练所带来的难以承受的代价,必须对这些模型进行持续训练。然而,缺乏大规模持续学习基准或基线方法,进一步加剧了这一问题。我们引入了首批用于训练视觉-语言模型的网络规模时间持续(TiC)基准:TIC-DataComp、TIC-YFCC 和 TIC-RedCaps。其中,TIC-DataComp 是我们最大的数据集,包含超过 127 亿条带有时间戳的图像-文本对,跨越 9 年(2014–2022 年)。我们首先利用这些基准构建了多种动态评估任务,以衡量现有模型的时间鲁棒性。我们表明,与 OpenCLIP 仓库中最近训练的模型相比,OpenAI 的 CLIP(在截至 2020 年的数据上训练)在我们构建的 2021–2022 年检索任务上,零样本准确率下降了约 8%。随后,我们研究了如何在时间连续的数据上高效训练模型。我们证明,一种简单的基于回放的策略——从最后一个检查点继续训练并重放旧数据——与从头重新训练的标准做法相比,可将计算量减少 2.5 倍。
一句话总结
苹果公司和卡内基梅隆大学提出了TIC-CLIP,这是首个网络规模的时序持续(Time-Continual)基准(TIC-DataComp包含超过12.7B个带时间戳的图像-文本对,以及TIC-YFCC和TIC-RedCaps),用于揭示时间鲁棒性差距。研究发现,CLIP在2021至2022年的检索任务上零样本准确率下降约8%,并就此提出了一种基于回放的持续训练方法,与从头重新训练相比计算量降低2.5×。
核心贡献
-
提出了首个面向视觉语言模型的网络规模时序持续(TiC)基准,包括TIC-DataComp、TIC-YFCC和TIC-RedCaps。其中TIC-DataComp包含超过127亿个带时间戳的图像-文本对,时间跨度从2014年到2022年。
-
从这些基准中构建动态评估任务以衡量时间鲁棒性。结果表明,OpenAI使用截至2020年数据训练的CLIP模型,在2021至2022年的检索任务上与使用更新数据训练的模型相比,零样本准确率下降约8%。
-
验证了一种基于回放的持续训练方法,从最新检查点继续训练并回放旧数据。在从11M样本到3B样本的多种数据集规模下,该方法性能可与从头重新训练相媲美,同时计算量降低约2.5至2.7倍。
引言
像CLIP这样的大型多模态基础模型在静态网络规模数据集上仅训练一次,但现实世界不断产生新数据,导致其性能随时间推移逐渐下降。此前持续学习领域的工作大多依赖带有人为任务边界的合成基准,缺乏真实的数据演化过程;而针对CLIP的持续学习方法则侧重于下游任务适配,并未直接适应数据分布本身的演化。从头重新训练这些模型的计算成本极高,例如ViT-g-14模型需要24万A100 GPU小时。为解决这一问题,作者提出了TIC-DataComp,这是一个用于CLIP模型时序持续训练的基准,通过向CommonPool、YFCC和RedCaps等现有数据集附加爬取时间信息构建而成。其核心贡献是一种累积方法,从最新检查点进行热启动并回放所有旧数据,性能可与从头重新训练的理想基准(oracle)相媲美,同时计算效率高2.7倍。这凸显了模型随动态数据分布共同演化的关键需求,也暴露了ImageNet等静态基准在评估时间鲁棒性方面的局限性。
数据集
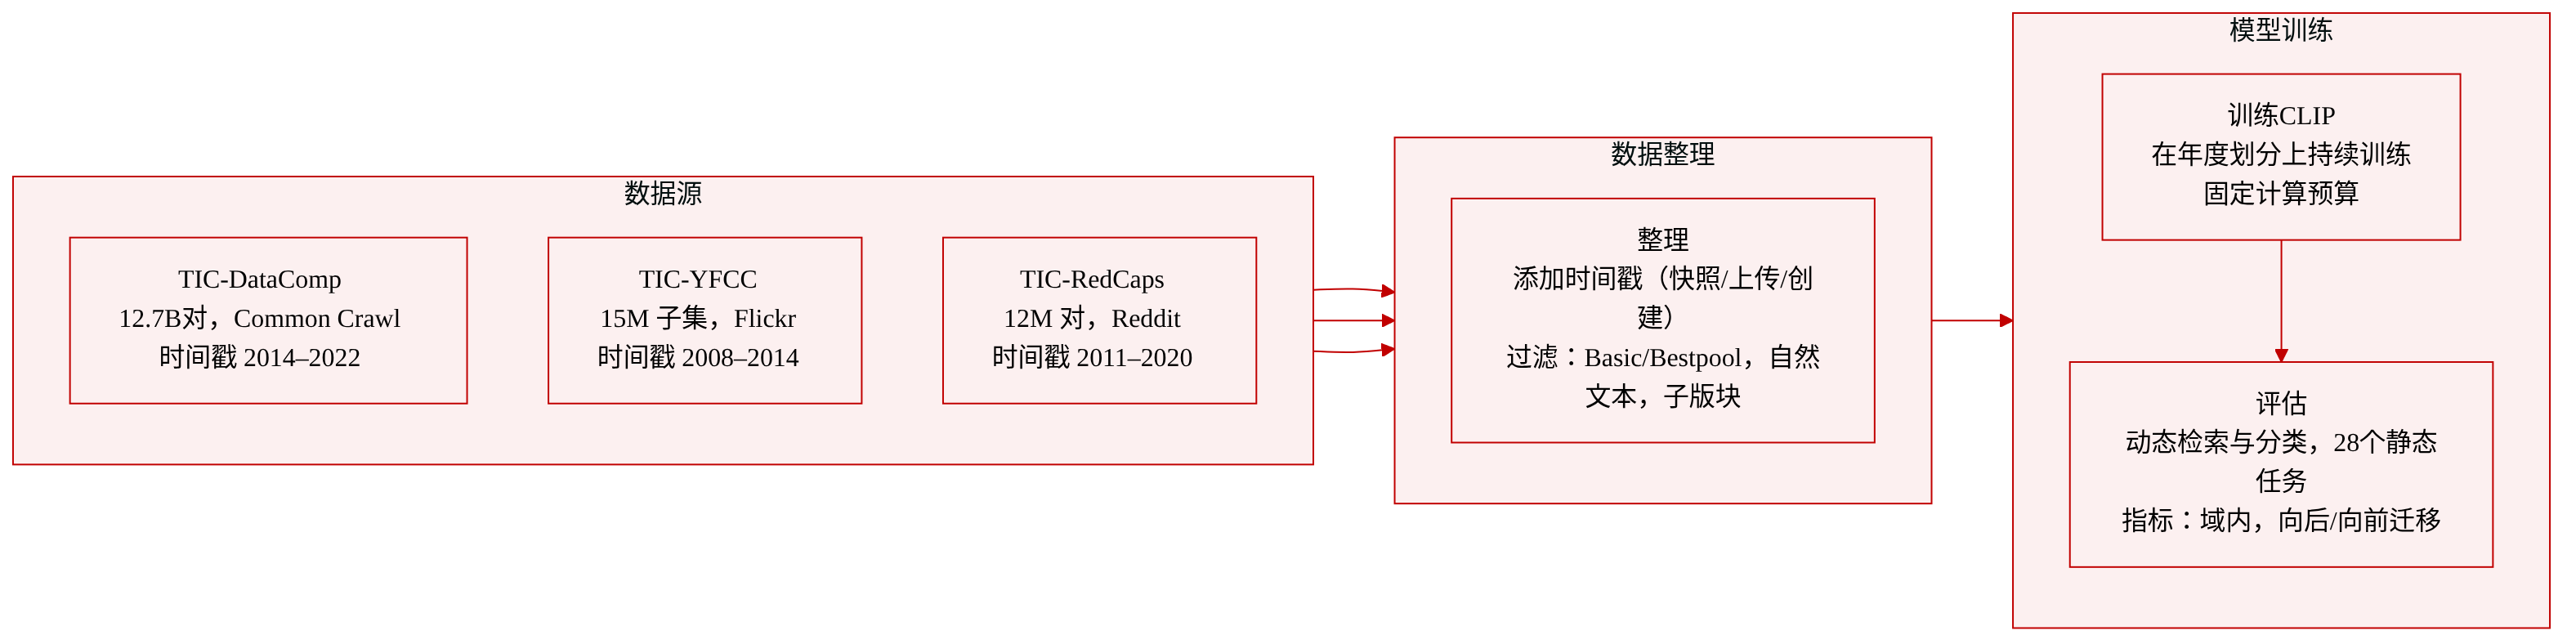
作者提出了TIC-CLIP,这是一个基于对比语言-图像预训练的视觉语言模型持续训练基准。与WiT或DataComp等静态数据集不同,TIC-CLIP按时间顺序以流式方式提供图像-文本对。作者构建了三个时序持续数据集,并定义了动态评估任务,以衡量模型在数据演化过程中的表现。
数据集构成与来源
- TIC-DataComp:最大的公开图像-文本数据集,包含来自Common Crawl的127亿个图像-文本对。作者为每个图像-文本对附加爬取时间元数据,保留其首次出现的最早快照,从而获得2014年至2022年的月度时间戳。实验中将数据整合为年度粒度。
- TIC-YFCC:基于OpenAI选取的YFCC15M子集,包含来自Flickr的带自然文本标题的图像。时间覆盖2008年至2014年,使用原始上传时间戳进行年度划分。
- TIC-RedCaps:来自人工筛选的subreddit集合的1200万图像-标题对,覆盖2011年至2020年。作者使用帖子创建时间戳进行年度划分。
过滤与规模细节
- 对于TIC-DataComp,作者使用CommonPool子集中的medium、large和xlarge规模进行实验。所有规模均使用Basic过滤,而涉及现成CLIP模型的Bestpool过滤仅用于xlarge规模。论文指出,Bestpool过滤可能使选出的数据偏向较早的时间步。
- TIC-YFCC仅保留标题包含自然文本的图像,沿用OpenAI原始过滤方式。
- TIC-RedCaps使用原始subreddit筛选结果,未额外进行过滤。
评估任务
作者构建了动态和静态两类评估任务。
- 动态检索:在不同时间戳下采样图像-文本对,给定图像或文本查询时衡量检索性能。该任务在三个数据集上均有构建。
- 动态分类:TIC-DataComp-Net,从CommonPool中的ImageNet类别构建。仅当标题恰含一个ImageNet同义词集,且同义词集定义与标题的句子嵌入相似度超过0.5时,保留该样本。与LAIONNet不同,作者不使用CLIP相似度分数过滤,以避免引入偏差。
- 静态任务:包含28个标准任务,包括ImageNet及其分布偏移、VTAB和Flickr30k检索,均采用零样本评估。
指标与用法
- 在每个时间步,模型在训练后用所有时间步的数据进行评估,生成性能矩阵。作者报告域内性能、反向迁移和正向迁移,分别基于矩阵对角线、下三角和上三角计算。附录中提出了修正指标以减轻反向迁移中的偏差。
- 提取出的评估样本已从训练集中移除,所有动态评估均为零样本。该基准旨在最大化静态任务性能,同时优化分布偏移和遗忘场景下的动态任务性能。
方法
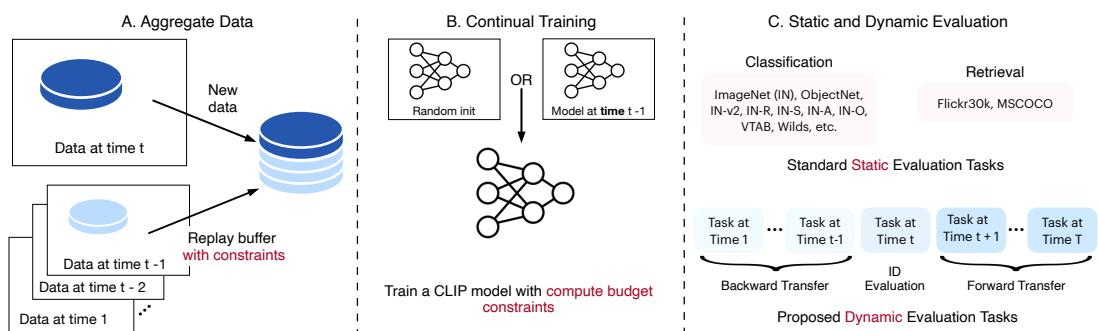
作者提出了TIC-CLIP,这是一个面向视觉语言基础模型持续训练的基准和实验协议,特别关注对比语言-图像预训练(CLIP)目标。与使用静态数据的传统方法不同,该框架运行在动态环境中,图像-文本数据随时间顺序到达。整个流程包括数据聚合、严格资源约束下的持续训练,以及涵盖标准任务和动态任务的双重评估策略。
整体工作流程参见下方框架图。
数据聚合与流式协议
该框架的基础依赖于时序持续数据集:TIC-DataComp、TIC-YFCC和TIC-RedCaps。这些数据集通过对现有大规模图像-文本语料附加辅助时间信息(如爬取时间戳或帖子创建日期)构建而成。数据以流式方式提供给学习器,通常按年度粒度聚合。例如,TIC-DataComp覆盖2014年至2022年,而TIC-YFCC和TIC-RedCaps覆盖较短的具体时间段。
为管理数据流入,系统采用流式协议,将新数据批次与包含历史数据的回放缓冲区相结合。这一聚合步骤对缓解灾难性遗忘至关重要。然而,框架设有内存预算限制,由于可能的数据过期策略,旧数据的保留受到限制,但允许保留最新模型检查点。
持续训练策略
方法论的核心是在每个时间步t以固定计算预算(以乘累加操作MACs衡量)训练一个可部署模型。作者评估了多种训练策略,以平衡可塑性(学习新数据)与稳定性(保留旧知识)之间的权衡:
- Oracle(理想基准): 作为上界基线,使用t×C的计算预算,在截至时间t的所有数据上从头训练模型。尽管计算成本极高,它代表了无限资源下的理想性能。
- Cumulative(累积): 使用固定计算预算C,在截至时间t的所有数据(新数据与回放的旧数据)上训练模型,并从时间步t−1的检查点初始化。为管理回放缓冲区,作者提出了多种采样策略:
- -All: 回放所有先前数据。
- -Exp: 使用大小为D的缓冲区,每步将旧数据量减半(例如保留D/2的较早数据和D/2的稍早数据)。
- -Equal: 将大小为D的缓冲区在所有先前年份中平均分配。
- Sequential(顺序): 仅使用时间步t到达的新数据训练模型,从上一步的最佳检查点初始化。该方法测试模型在无显式回放条件下的自适应能力。
- Restart(重启): 从随机初始化开始,在截至时间t的所有数据上训练,但受限于固定计算预算C。它有助于分离前向迁移和可塑性丧失的影响。
- Patching(修补): 利用顺序修补技术,从上一步的修补模型初始化当前训练。在时间t−1的修补模型与当前模型之间进行权重插值,并基于先前任务的检索性能优化混合系数。
- LwF(Learning with Forgetting): 仅使用新数据训练,但引入KL散度惩罚。该惩罚约束当前模型的图像-文本相似度矩阵与先前检查点的结果保持接近,从而保留过去分布的知识。
训练过程采用循环学习率调度。具体而言,每次顺序运行时使用余弦衰减调度,从而形成循环模式。实验发现这一策略是有效的,因为后续运行早期出现的训练损失升高会迅速下降,快于从头训练时的下降速度。
评估协议
该框架区分标准静态评估与所提出的动态评估任务。静态评估在ImageNet、ObjectNet和Flickr30k等既有基准上进行,这些基准不随时间变化。相比之下,动态评估任务专门衡量模型对随时间演化数据分布的鲁棒性,包括反向迁移(过去任务上的性能)、域内评估(时间t的当前分布内数据)和正向迁移(时间t+1的未来任务上的性能)。这种双重评估确保全面衡量模型在非平稳环境中的适应性和稳定性。
实验
作者构建了带时间元数据的时序持续基准(TIC-DataComp、TIC-YFCC、TIC-RedCaps),并提出了动态检索和分类任务,配合28个静态任务,在流式协议下评估持续训练的CLIP模型。使用全量历史数据回放的顺序训练(Cumulative-All)在动态任务上接近从头重新训练的Oracle,同时最高节省4倍计算量,但在更大规模下静态任务上出现一定差距。有限回放缓冲区的方法与全量回放保持竞争力,而无回放的顺序训练展现出较强的正向迁移能力,但在静态和反向迁移任务上出现显著损失。动态评估任务揭示了静态基准无法捕捉的分布偏移,如新兴概念和演化类别,并为模型选择提供了互补信号。
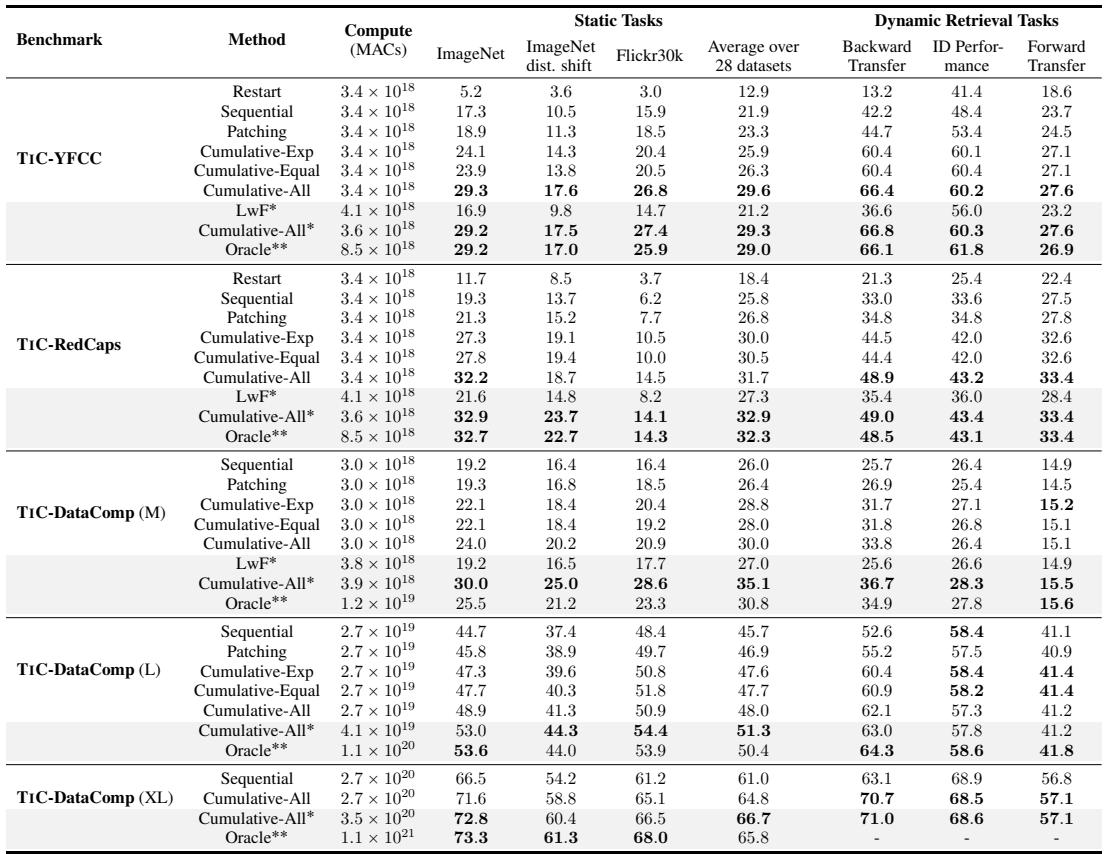
下表概述了CLIP模型的持续训练方法,各方法在数据回放量、是否从先前检查点初始化以及计算预算方面有所不同。Cumulative类方法使用回放数据并从上次检查点开始,而Restart则在所有数据上从头训练。这些方法与使用完整计算预算的Oracle基线进行比较。Cumulative类方法回放先前步骤的数据并从上次检查点初始化,每步计算预算为C。Oracle使用t×C的大型计算预算在所有累积数据上从头训练,作为上界参考。Restart使用截至时间t的所有数据但从随机初始化开始,而Sequential仅使用来自上次检查点的当前数据。Patching从先前检查点的修补组合初始化,以预算C在当前数据上训练。
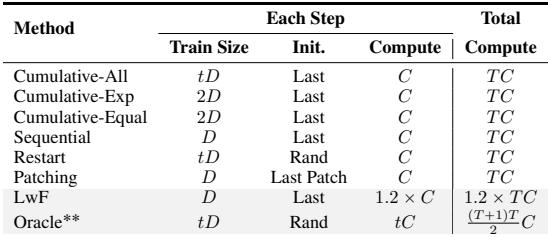
Cumulative-All通过回放所有先前数据,在动态任务上达到接近Oracle的性能,同时显著降低计算量,但在更大规模的静态基准上出现差距。无回放的顺序训练在大规模数据上展现出较强的前向迁移,但在静态和反向迁移任务上表现不佳。Patching和LwF等策略相比Sequential有所改进,但仍落后于Cumulative-All。Cumulative-All在动态评估上保持在Oracle的1%以内,同时计算量最高降低4倍。顺序训练在大规模数据上擅长前向迁移,但在静态和反向迁移任务上表现急剧下降。Patching和LwF相比Sequential提升了反向迁移,但Cumulative-All在无需额外计算的情况下在所有指标上均优于它们。
在ImageNet持续训练上,即使训练划分数量增加,Cumulative-All也能保持接近Oracle的准确率。即使在最多8个划分下,性能差距仍低于0.9%,这表明回放所有先前数据是一种可行且高效的策略。Cumulative-All在最多8个划分下与Oracle准确率差距保持在0.9%以内。准确率随划分增加仅略微下降,从1个划分时的80.9降至8个划分时的80.0。实验结果支持将回放所有先前数据作为从头重新训练的一种计算高效替代方案。
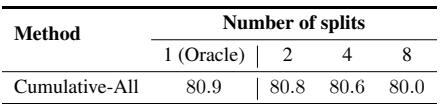
实验比较了CLIP的多种持续训练方法,包括累积回放、顺序训练、重启和修补,并与在全部累积数据上以完整计算量重新训练的Oracle基线进行对比。回放所有先前数据在动态任务上持续接近Oracle性能,同时使用显著更少的计算量,不过在更大规模的静态基准上存在一定差距。该方法优于顺序训练(前向迁移较强但反向迁移较弱)以及修补和LwF(改善了反向迁移但仍不足)。在多个训练划分的ImageNet实验中,累积回放保持接近Oracle的准确率,仅随划分数量增加出现轻微下降,证实了其作为完全重新训练的高效且可行替代方案。