Command Palette
Search for a command to run...
SALM:用于语音识别与翻译的具备上下文学习能力的语音增强语言模型
SALM:用于语音识别与翻译的具备上下文学习能力的语音增强语言模型
Zhehuai Chen He Huang Andrei Andrusenko Oleksii Hrinchuk Krishna C. Puvvada Jason Li Subhankar Ghosh Jagadeesh Balam Boris Ginsburg
NVIDIA-Nemotron-3.5-Transcribe-30B-A4B:指令控制的语音识别、翻译与音频问答
摘要
我们提出了一种新颖的语音增强语言模型(SALM),具备多任务和上下文学习能力。SALM 由冻结的文本大语言模型(LLM)、音频编码器、模态适配器模块和 LoRA 层组成,以适应语音输入及相应任务指令。统一的 SALM 不仅在自动语音识别(ASR)和语音翻译(AST)上取得了与任务专用的 Conformer 基线相当的性能,还展现出零样本上下文学习能力,并通过 ASR 和 AST 的关键词增强任务得到了验证。此外,我们提出了语音监督的上下文训练,以弥合 LLM 训练与下游语音任务之间的差距,从而进一步提升语音到文本模型的上下文学习能力。所提出的模型已通过 NeMo 工具包开源。
一句话总结
NVIDIA 研究人员提出了 SALM,一种语音增强语言模型,它结合了冻结的文本大语言模型(LLM)、音频编码器、模态适配器模块和 LoRA 层,在自动语音识别(ASR)和语音翻译(ST)任务上取得了与任务专用 Conformer 基线相当的性能,同时支持零样本上下文学习;通过语音监督式上下文训练进一步改进语音转文本模型,并且所提出的模型已通过 NeMo 工具包开源。
核心贡献
- 提出了 SALM,一种统一的语音增强语言模型,结合冻结的文本 LLM、音频编码器、模态适配器和 LoRA 层,用于多任务语音语言建模,其 ASR 和 AST 性能与任务专用 Conformer 基线相当,并通过 NeMo 工具包提供开源实现。
- 使语音转文本模型具备零样本上下文学习能力,通过对 ASR 和 AST 的关键词提升进行验证,无需外部上下文偏置图或学习到的关键词特定权重。
- 提出了语音监督式上下文训练,以弥合 LLM 训练与下游语音任务之间的差距,进一步增强语音转文本模型的上下文学习能力。
引言
大语言模型(LLM)通过指令微调和上下文学习,已经成为能力很强的通用学习器,这使得它们对识别、翻译和合成等语音任务具有吸引力。此前的语音-LLM 集成通常依赖文本作为接口,但仅使用文本接口可能丢失说话人、情感和口音等语音特有信息;深度音频嵌入方法虽然存在,但语音转文本模型的上下文学习仍未被充分探索。现有的关键词提升和上下文语音识别方法通常也使用外部关键词语言模型、WFST 或显式学习的上下文权重。作者提出了 SALM,通过用 NeMo 语音模型提示 Megatron LLM,构建统一的多任务语音语言模型。该方法在 ASR 和 AST 上与定制的 Conformer 基线性能相当,支持语音转文本关键词提升的零样本上下文学习,并引入语音监督式上下文训练以进一步提升该能力。
数据集
作者使用了以下数据集和数据处理步骤:
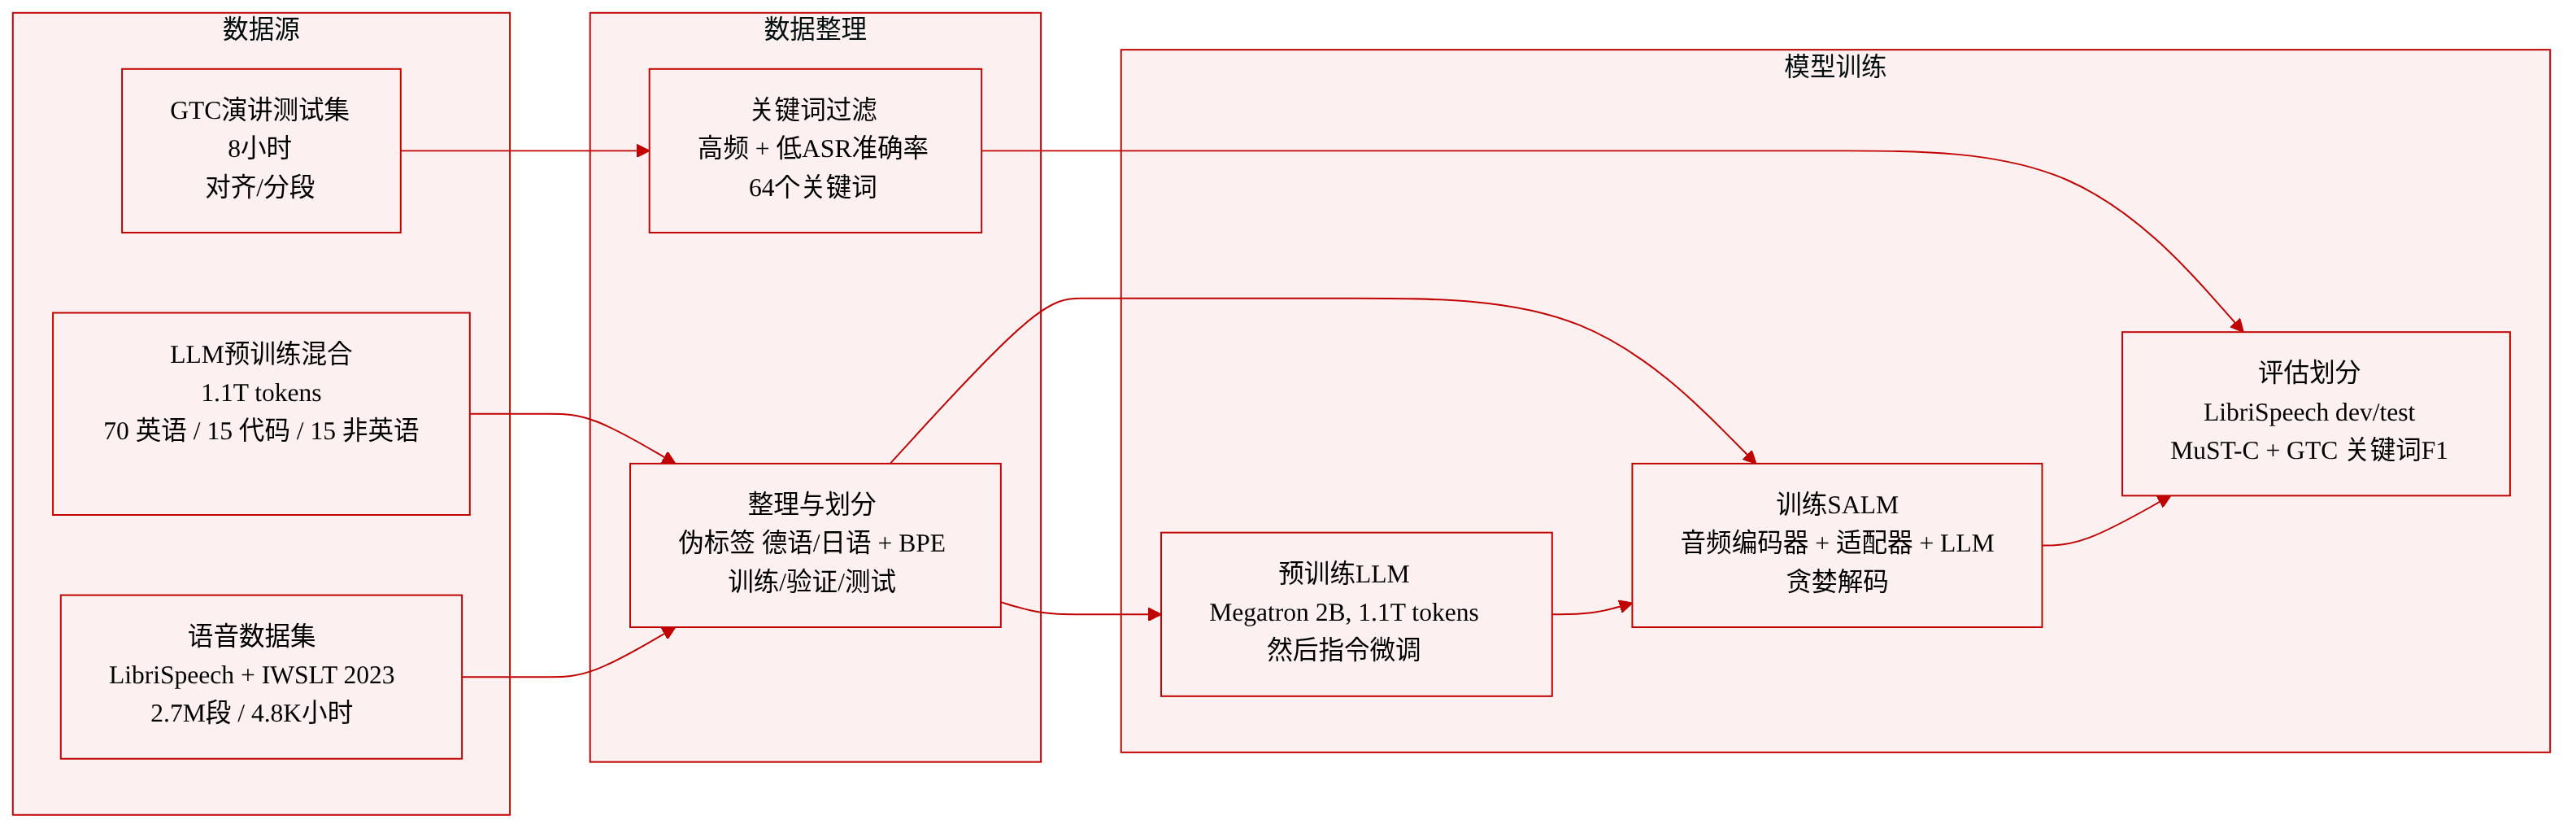
- LLM 预训练数据:一个 2B 参数的 Megatron LLM 在 1.1T tokens 上进行了预训练。混合数据包含 70% 来自网页抓取、新闻、对话、书籍和科学领域的英文文本;15% 来自 Stack 数据集的代码;以及 15% 来自 CommonCrawl 的非英文文本。随后该模型在公开的指令遵循数据集上进行了微调。
- 语音识别数据:SALM 在 LibriSpeech 训练集上进行训练。最佳检查点根据 LibriSpeech 开发集上的词错误率选择,最终评估使用 test-clean 和 test-other。
- 语音翻译数据:IWSLT 2023 Offline Track 可用的所有英文音频都与伪生成的德语和日语翻译配对。生成的训练集包含 270 万条片段,约 4.8K 小时音频。评估使用 MuST-C v2 tst-COMMON。目标语言文本用于训练 16384k 个 BPE 编码。
- 关键词提升数据:基于 NVIDIA GTC 演讲构建的内部测试集经过强制对齐和切分,总计 8 小时。关键词通过筛选在贪心解码下出现频率高且识别准确率低的单词和短语得到。默认关键词列表包含 64 个关键词,作者还研究了不同的关键词数量。关键词准确率通过与真实标注对齐后的精确率、召回率和 F 值来衡量。
方法
作者提出了语音增强语言模型(SALM),该模型直接在经过文本预训练和指令微调的大语言模型(LLM)上进行有监督语音指令微调。所得模型学习以语音提示、文本上下文和指令为条件,为各种语音任务预测文本输出。该架构可能赋予语音转文本模型上下文学习能力。
作者分别选择 Fast Conformer 和 GPT 风格的 Megatron LLM 作为语音和文本骨干。Fast Conformer 是重新设计的 Conformer,具有新的下采样方案,可在保持领先准确率的同时提高效率。具体而言,使用来自 NeMo 的 110M 预训练音频编码器和经过文本指令微调的预训练 2B Megatron LLM。
为引导 LLM 以音频编码器的输出为条件,作者引入了模态适配器和低秩适配(LoRA)层。两个具有 4 倍下采样的 Conformer 层作为模态适配器层,用于匹配文本和语音之间不同的信息速率与建模空间。所得语音提示实现了 320ms 的帧移。该提示被投影到 LLM 维度,并前置到文本上下文和指令之前,作为 LLM 的输入。在语音指令微调期间,向 LLM 添加 128 维 LoRA 层。LLM 权重保持冻结,梯度通过其余组件反向传播。
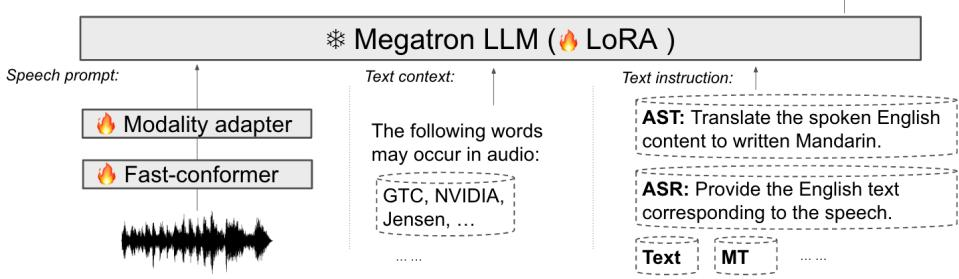
将语音模型与 LLM 结合的一个核心动机,是将自然语言处理(NLP)中的指令微调引入语音多任务学习,从而提供统一的语音模型。作者纳入了多种语音任务,例如自动语音识别(ASR)和自动语音翻译(AST),以及多样的指令。这种方法不仅促进指令遵循,还改善模态适配器层在不同任务上的泛化。该工作复用来自公开 ASR 和 AST 语料的语音与文本配对数据,并在训练期间随机前置任务指令。
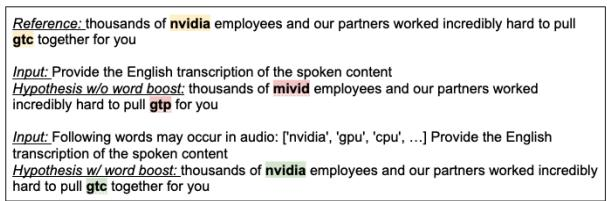
SALM 的另一个核心动机,是在语音任务中利用 LLM 的上下文学习(ICL)能力。ICL 允许模型无需额外参数更新即可对未见输入预测标签。作者在语音理解任务中评估该能力,并以关键词提升作为主要示例。关键词提升旨在使模型偏向于识别特定感兴趣词。在此语境中,上下文学习被定义为从提示文本上下文中学习提升词,而无需反向传播。作者以文本指令之前的可选文本上下文形式向模型提供关键词。这与以往关键词提升方法形成对比,后者需要在训练期间为提升词学习显式嵌入和权重,或使用外部偏置图。
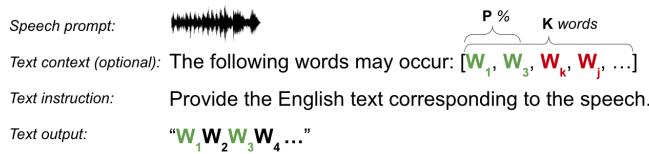
鉴于 LLM 预训练与 ICL 阶段在数据格式和学习准则上存在差异,作者提出了语音监督式上下文训练(Speech ICT),以增强模型在语音理解中利用文本上下文的能力。在语音指令微调阶段,通过从当前话语和数据集中的其他话语随机采样单词来增强有监督数据。这些采样词作为该话语的可选文本上下文加入。这种上下文训练策略旨在泛化到未见领域中的未见单词和语料。
实验
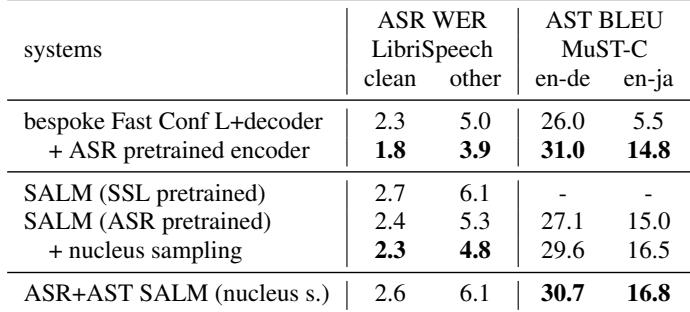
该工作在 LibriSpeech ASR、MuST-C 语音翻译和 GTC 关键词提升上评估了 SALM,一种由 Fast Conformer 或 SSL 音频编码器、模态适配器和 2B 参数 LLM 构建的语音语言模型。统一训练用于 ASR 和 AST 的 SALM 优于定制的 ASR 和 AST 基线以及仅训练 AST 的 SALM,但在 ASR 上不如仅训练 ASR 的 SALM;同时它在罕见词和专有名词上表现出优势,并受益于核采样以减少幻觉和删除问题。对于关键词提升,零样本上下文提示在无需外部偏置图的情况下获得了可比的提升,但仅在使用语音指令上下文微调时成立;与基线相比,它往往更好地处理短词、复合词和规范化词,但在较长短语上表现挣扎。初步的词典引导翻译结果整体上仅略好,但成功案例表明 SALM 能够自然地将提示中的词典术语纳入翻译。
SALM 取得了具有竞争力的 ASR 和 AST 结果,音频编码器的 ASR 预训练优于 SSL 预训练,核采样带来进一步增益。最佳 SALM 配置超过了从零开始训练的基线,但总体上仍落后于更强的经 ASR 预训练的定制基线。在 ASR 和 AST 数据上统一训练的 SALM 在 SALM 模型中取得了最高的 MuST-C BLEU,而其 ASR 性能略低于仅训练 ASR 的 SALM。相比于不使用核采样的同一 SALM 模型,核采样同时改善了 ASR 和 AST 指标。联合训练 ASR 和 AST 的 SALM 在 SALM 配置中取得了最佳的 MuST-C 翻译质量,但其 LibriSpeech ASR 性能略差于仅训练 ASR 的 SALM。
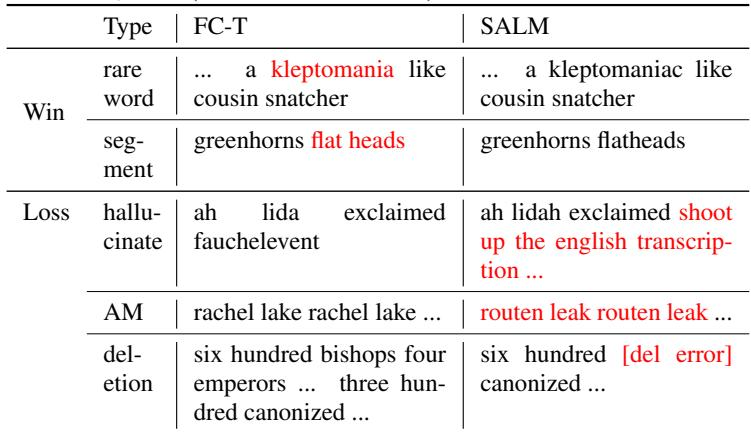
与 Fast Conformer-Transducer 相比,SALM 在罕见词、专有名词和复合切分上表现出相对优势。其主要弱点是幻觉和长片段删除,即可能编造或省略基线转录得更忠实的内容。据报道,核采样可缓解其中一些幻觉问题。SALM 往往在罕见词和专有名词上占优,包括基线会拆分或误识别的复合形式。SALM 往往在幻觉和删除案例中失败,有时会产生不相关的短语,或省略基线保留的长片段。
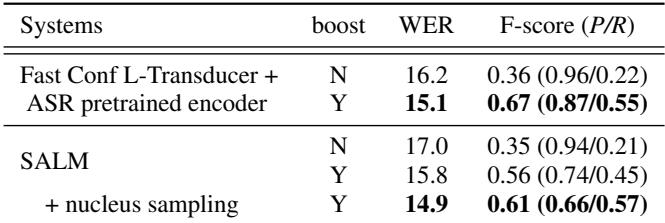
在没有关键词提升的情况下,SALM 与 Fast Conformer-Transducer 基线性能相当。对 SALM 进行关键词提升提示可同时改善 WER 和 F 值,加入核采样带来进一步增益。上下文提示方法获得了与传统外部偏置相似的相对提升增益,同时避免了外部偏置图或学习到的偏置嵌入。未进行提升的 SALM 与强大的 Fast Conformer-Transducer 基线表现相似。提示改善了 SALM 的关键词提升,核采样在 WER 和 F 值上提供了额外增益。上下文方法在无需外部偏置图或显式偏置嵌入的情况下,达到了与基线相对关键词提升相当的效果。语音指令上下文微调对于 SALM 有效遵循提示是必要的;没有它,仅会出现有限的改善。
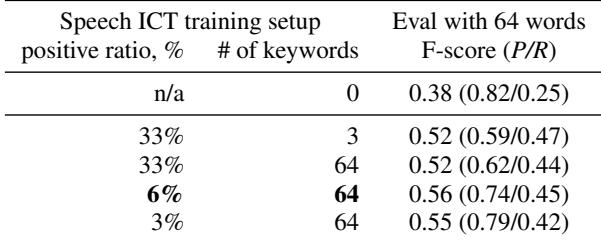
语音上下文训练对于有效的关键词提升是必要的:没有它,提示仅带来有限的 F 值改善,表现为精确率高但召回率低。添加增强的上下文训练数据显著改善了 F 值,而增强数据中适度的真实词正例比例提供了最佳平衡。调整该比例会改变精确率与召回率的权衡,而扩大提升词数量往往使精确率变差,召回率几乎不变。没有语音上下文训练时,提示对关键词提升的遵循效果较差,表现为精确率高但召回率低。添加带有增强数据的语音上下文训练可显著改善整体关键词提升 F 值。适度的正例比例可获得最佳 F 值;较高比例会降低精确率,而较低比例会提高精确率但降低召回率。扩大提升词数量会使精确率下降,而召回率几乎保持不变,原因是误接受更多。
对比突出了 SALM 与 fast conformer-transducer 基线之间互补的错误模式。SALM 在较短单词、复合词和文本规范化方面更强,而基线在较长单词和短语方面更强。SALM 还表现出幻觉和提前停止错误,而这些错误在基线中很少出现。SALM 胜出的例子包括 GPU、HPC、cuDNN、GeForce、NVLink 和 healthcare,而基线胜出的例子包括 NVIDIA、Omniverse、robotic 和 cybersecurity。SALM 的幻觉示例会添加重复或不相关的内容,例如“okay ladies and gentlemen clap your hands cla cla”,这种错误模式在基线中很少见。
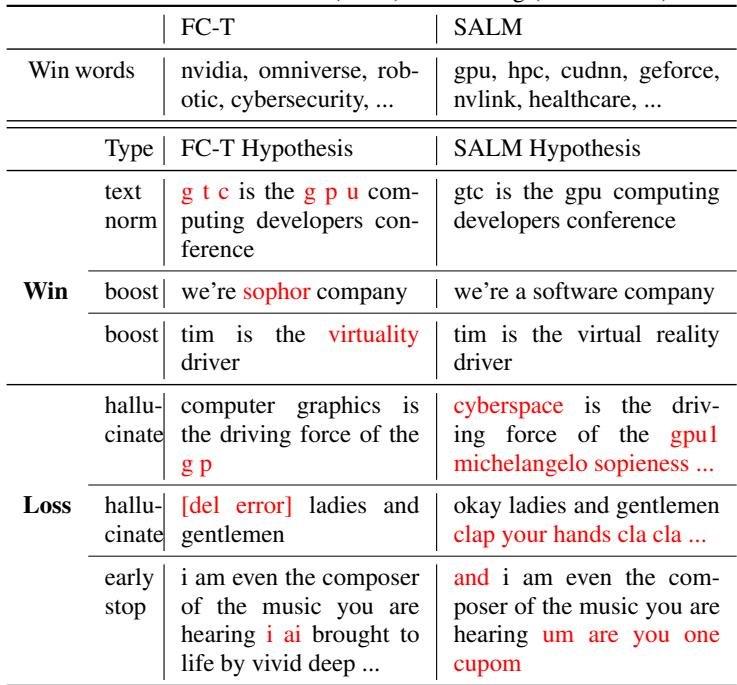
实验在 ASR、AST 和关键词提升任务上评估了 SALM,并与强大的定制模型和 transducer 基线进行对比,包括对 ASR 预训练、核采样和语音上下文训练的消融。SALM 整体具有竞争力,尤其在罕见词、专有名词、复合切分和文本规范化方面更强,同时更容易出现幻觉、长片段删除和提前停止。结合核采样的提示改善了关键词提升,并在无需外部图或嵌入的情况下达到了与传统偏置相当的增益,但有效的提示遵循需要语音上下文训练。