Command Palette
Search for a command to run...
Timewarp: 通过学习时间粗化动力学实现分子动力学的可迁移加速
Timewarp: 通过学习时间粗化动力学实现分子动力学的可迁移加速
Leon Klein Bruno Mlodozeniec Andrew Y. K. Foong Marc Brockschmidt Tor Erlend Fjelde Sebastian Nowozin Frank Noé Ryota Tomioka
Timewarp 分子动力学加速数据集
摘要
分子动力学(MD)模拟是一种广泛使用的技术,用于模拟分子系统,最常见的是在全原子分辨率下,其中运动方程以飞秒量级的时间步长进行积分(1fs≐10−15s)。MD 通常用于计算平衡性质,这需要从平衡分布(如玻尔兹曼分布)中进行采样。然而,许多重要过程,如结合和折叠,发生在毫秒或更长时间尺度上,无法通过传统 MD 有效采样。此外,针对每个研究的分子系统,都需要执行新的 MD 模拟。我们提出了 Timewarp,一种增强采样方法,它使用归一化流作为马尔可夫链蒙特卡洛方法中的提议分布,以玻尔兹曼分布为目标。该流在 MD 轨迹上离线训练,学习进行大的时间步长,模拟 105−106 fs 的分子动力学。关键在于,Timewarp 在不同分子系统之间具有可迁移性:一旦训练完成,我们证明它能泛化到未见过的全原子分辨率小肽(2-4 个氨基酸),探索其亚稳态,并提供相比标准 MD 的采样墙钟加速。我们的方法朝着通用、可迁移的 MD 加速算法迈出了重要一步。
一句话总结
柏林自由大学、剑桥大学、微软研究院AI4Science和莱斯大学的研究人员提出了Timewarp,这是一种基于归一化流的马尔可夫链蒙特卡洛提议分布,能够学习时间粗粒化动力学,步长可达105−106飞秒,从而实现对全原子分子动力学的可迁移加速,并在对未见小肽进行采样时相比标准MD获得墙钟加速。
核心贡献
- Timewarp是一种增强采样方法,在面向玻尔兹曼分布的马尔可夫链蒙特卡洛框架中使用归一化流作为提议分布,该流在MD轨迹上离线训练,以提出105至106飞秒的大时间粗粒化步长。
- Timewarp直接在全原子笛卡尔坐标中运行,实现了跨分子系统的可迁移性,使得单一训练模型无需重新训练即可推广到未见的小肽(2至4个氨基酸)系统。
- 结果表明,带有Metropolis-Hastings校正的Timewarp能够加速对未见二肽的渐近无偏采样,而不带该校正的版本则比标准分子动力学更快地探索二肽和四肽的亚稳态,且发现的亚稳态经验证具有物理意义。
引言
分子动力学(MD)是一种广泛使用的原子级物理系统模拟技术,能够在无需湿实验的情况下提供分子运动的详细洞察。其核心目标是从玻尔兹曼分布中进行高效采样,从而计算关键的生物物理量,如蛋白质折叠或配体结合的自由能。标准MD实现依赖于以小时步长(约1飞秒)离散化的朗之万动力学以保证稳定性,但许多生物分子具有被能垒分隔的亚稳态,需要毫秒级的模拟,对应约1012个积分步,使得直接模拟不可行。先前的增强采样方法(如粗粒化和元动力学)虽然有所帮助,但需要系统特定的领域知识,并且无法在分子系统之间迁移学习到的信息,即使这些系统表现出密切相关的动力学(如由20种氨基酸序列构成的蛋白质)。
作者引入了Timewarp,一种通用且可迁移的增强采样方法,在面向玻尔兹曼分布的马尔可夫链蒙特卡洛(MCMC)框架中使用归一化流作为提议分布。其主要贡献包括:第一种在通用笛卡尔坐标中运行并展示对未见小肽系统可迁移性的机器学习算法,以及首个对这些未见系统进行玻尔兹曼分布渐近无偏MCMC采样的墙钟加速。他们还将条件归一化流提议与Metropolis-Hastings(MH)校正步骤相结合,定义了确保细致平衡的MCMC算法,设计了一种基于置换等变Transformer的流模型,创建了一个包含数千个小肽MD轨迹的新型训练数据集,并展示了不带MH校正的Timewarp能够比标准MD更快地探索新肽的亚稳态。
数据集
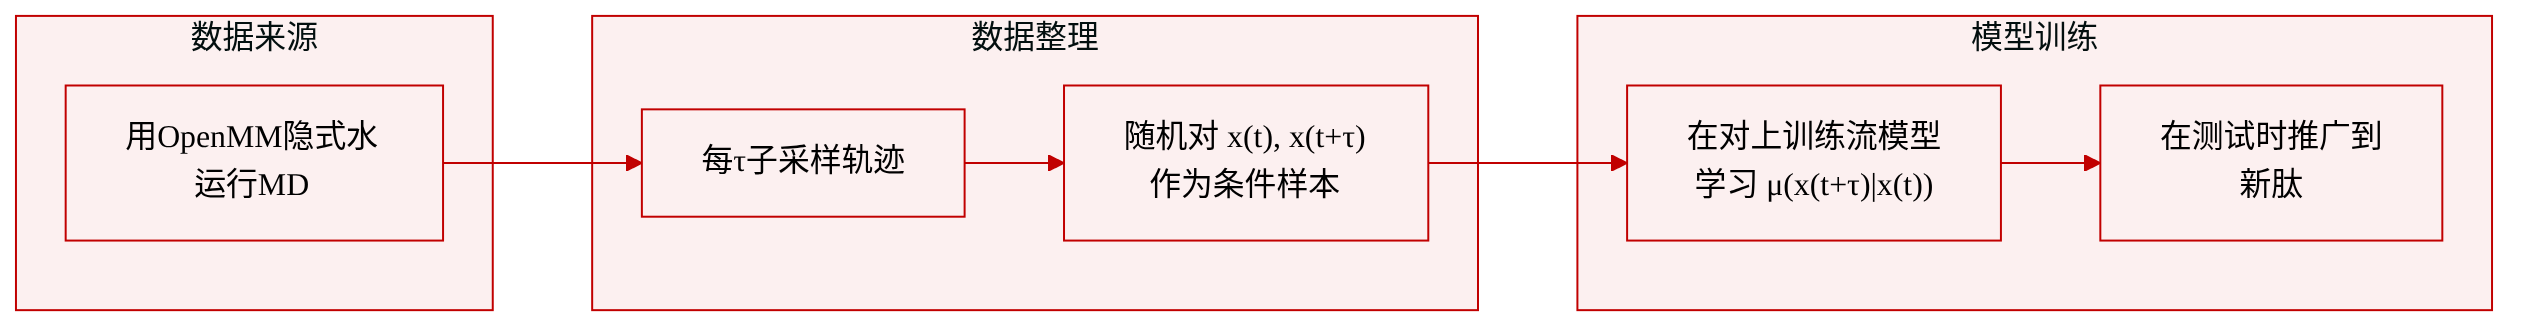
数据集组成与来源
- 作者使用OpenMM库对公式(2)进行积分,生成分子动力学(MD)轨迹。
- 他们在隐式水环境中模拟小蛋白质(肽),即不显式建模水分子的自由度。
关键细节与规模
- 数据集记为D = {T_i},其中i = 1至P,P为肽的总数。
- 每个MD轨迹按时间间隔tau进行子采样,因此单个轨迹表示为T_i = (x(0), x(tau), x(2tau), ...)。
训练中的使用
- 在训练过程中,作者从数据集中随机采样配对x(t)和x(t + tau)。
- 每对样本作为条件分布mu(x(t + tau) | x(t))的一个样本。
- 由于流是在多个肽的轨迹数据上训练的,因此可以在测试时推广到训练数据中未出现的新肽。
- 其他数据集细节见附录E。
方法
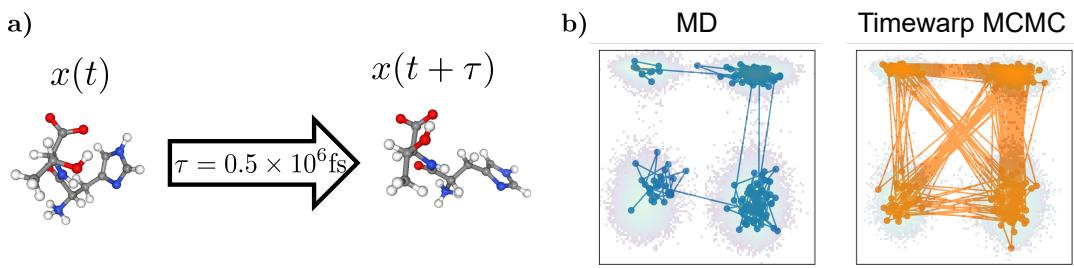
作者引入了Timewarp,这是一种深度概率模型,旨在近似分子动力学模拟在时间间隔τ上诱导的条件分布μ(x(t+τ)∣x(t))。该近似能够生成长时间步长的提议来采样分子构象,有效捕获亚稳态之间的跃迁动力学。如下图所示:
该方法的核心是条件归一化流pθ(x(t+τ)∣x(t))。为了增强表达能力并简化置换等变耦合层的构建,作者采用了增强归一化流框架。这涉及引入辅助潜变量,具体将潜速度zv视为服从标准高斯分布的非物理辅助变量,而实际位置zp则被变换。该架构基于RealNVP耦合层构建,如流程架构示意图所示。
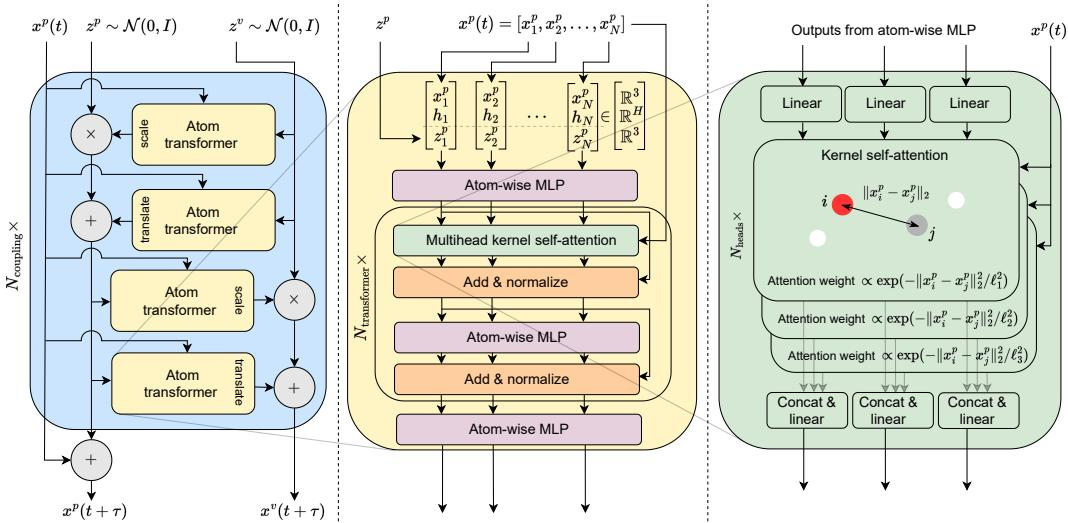
该流由堆叠的耦合层组成。在每一层中,位置潜变量基于辅助潜变量进行仿射变换,反之亦然。这些层中的尺度和平移函数由一个新颖的"原子Transformer"模块实现。该模块通过拼接原子的位置、学习到的类型嵌入和相关的潜变量来处理原子级特征。这些特征经过多层感知器(MLP)和多个Transformer层处理。
原子Transformer的一个关键创新是使用核自注意力代替标准的点积注意力。这一设计选择源于分子系统中力具有局域性的物理观察。原子i对原子j的注意力权重wij使用径向基函数(RBF)核定义,该核随原子间欧氏距离的平方衰减:
wij=∑j′exp(−∥xip−xj′p∥22/ℓ2)exp(−∥xip−xjp∥22/ℓ2)其中ℓ是可学习的长度尺度参数。作者采用多头版本,每个注意力头使用不同的长度尺度,使模型能够捕获不同空间尺度上的相互作用。
该架构设计尊重物理对称性。通过逐原子处理且不使用位置编码来强制置换等变性。通过居中输入位置来实现平移等变性,并通过训练期间的数据增强(对训练对施加随机旋转矩阵)来处理旋转等变性。
模型采用两阶段训练流程。第一阶段为似然训练,通过对分子动力学轨迹中采样的状态对进行最大似然估计来优化流。这使流的密度与真实条件分布对齐。第二阶段为接受率训练,模型微调以最大化Metropolis-Hastings(MH)接受概率。目标函数是接受率损失、似然损失和熵正则化项的加权组合。熵项防止模型收敛到导致微小状态变化的平凡提议,确保对状态空间的充分探索。
在推理期间,训练好的流在MCMC算法中充当提议分布。该过程迭代地从流中采样提议X~,根据面向玻尔兹曼分布的MH接受率决定接受或拒绝,并通过吉布斯采样重新采样辅助变量。另外,为了更快的探索,作者提出了一种有偏采样模式,接受能量变化低于某一阈值的提议,忽略MH校正以实现显著更快的状态空间遍历。
实验
Timewarp在小肽系统上进行了评估,包括丙氨酸二肽、二肽和四肽,使用MCMC和探索模式来加速对亚稳态的采样。在丙氨酸二肽和二肽上,它匹配了MD分布并实现了显著的加速,探索模式的增益更高,而在四肽上,MCMC经常遗漏状态,但探索模式通过短时间MD运行成功发现并验证了缺失的亚稳态。局限性包括接受率低、较大肽频繁遗漏状态,以及难以扩展到更大的系统或捕获过渡态,不过作者建议未来与其他增强采样方法集成。