Command Palette
Search for a command to run...
BERTSCORE:使用 BERT 评估文本生成
BERTSCORE:使用 BERT 评估文本生成
Tianyi Zhang Varsha Kishore Felix Wu Kilian Q. Weinberger Yoav Artzi
摘要
我们提出 BERTSCORE,一种用于文本生成的自动评估指标。与常见指标类似,BERTSCORE 计算候选句子中每个 token 与参考句子中每个 token 的相似度分数。然而,不同于精确匹配,我们使用上下文嵌入来计算 token 相似度。我们在 363 个机器翻译和图像描述系统的输出上进行了评估。BERTSCORE 与人类判断的相关性更好,并在模型选择方面提供比现有指标更强的性能。最后,我们通过一个对抗性释义检测任务表明,与现有指标相比,BERTSCORE 对具有挑战性的示例更加稳健。
一句话总结
康奈尔大学和 ASAPP Inc. 的研究人员提出了 BERTScore,一种自动文本生成评估指标,该指标使用上下文 BERT 嵌入而非精确匹配来计算 token 相似度,并表明该指标与人类判断的相关性更好,在 363 个机器翻译和图像字幕系统中能更有效地选择模型,并且在对抗性释义检测上比现有指标更稳健。
核心贡献
- 提出 BERTSCORE,一种自动文本生成评估指标,使用上下文 BERT 嵌入而非精确匹配来计算 token 相似度,从而支持宽松匹配和可选的基于语料的重要性加权。
- 对 363 个机器翻译和图像字幕系统输出的评估表明,BERTSCORE 与人类判断的相关性更好,并且比现有指标提供更强的模型选择性能。
- 对抗性释义检测任务表明,BERTSCORE 对具有挑战性的示例比现有指标更稳健。
引言
自然语言生成(如机器翻译和图像字幕)的自动评估需要衡量候选文本与参考文本之间的语义等价性。BLEU 和 METEOR 等广泛使用的指标依赖表面形式的 n-gram 重叠或启发式匹配,因此通常无法稳健地匹配释义,并可能忽略语义上重要的语序变化。作者引入了 BERTScore,一种评估指标,它使用预训练的 BERT 上下文嵌入,将句子相似度计算为 token 嵌入之间余弦相似度之和。该方法在没有任务特定监督的情况下捕获保留意义的词汇变化和远距离依赖,作者表明它与人类判断的相关性比现有指标更强。
方法
作者提出了 BERTSCORE,一种通过利用上下文嵌入来计算参考句与候选句之间 token 级相似度以评估文本生成的指标。该方法不依赖精确字符串匹配或静态词嵌入,而是使用 BERT 等上下文嵌入。这些模型根据相同单词周围的上下文为其生成不同的向量表示。输入文本被切分为词片,Transformer 编码器通过交替的自注意力和非线性变换计算每个 token 的最终表示。
一旦 token 被嵌入,框架会计算软相似度。作者使用参考 token 向量与候选 token 向量之间的余弦相似度。通过使用预归一化向量,该计算可简化为内积。为了计算最终得分,该方法采用贪心匹配,将某个句子中的每个 token 与另一个句子中最相似的对应 token 配对。
如下图所示,完整流程对参考句和候选句依次进行上下文嵌入、成对余弦相似度计算和最大相似度匹配。
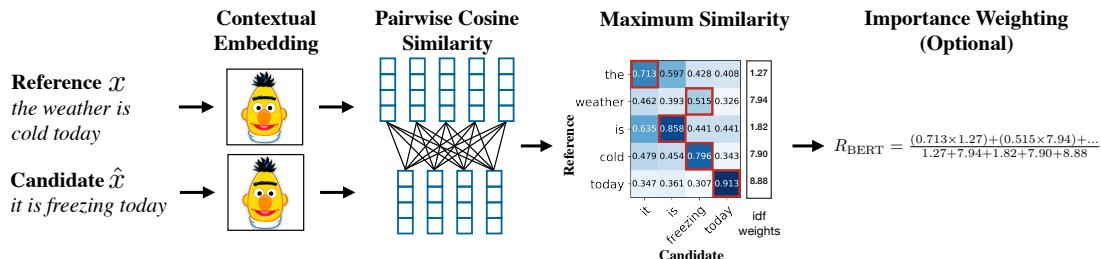
召回率、精确率和 F1 分数均由这些匹配相似度计算得出。召回率 RBERT 和精确率 PBERT 定义如下:
RBERT=∣x∣1xi∈x∑x^j∈x^maxxi⊤x^j,PBERT=∣x^∣1x^j∈x^∑xi∈xmaxxi⊤x^j最终 F1 分数 FBERT 以调和方式结合这两个指标。
为了提高指标灵敏度,作者引入了一种可选的重要性加权机制,使用从测试语料库计算出的逆文档频率分数。这确保稀有且高度指示性的词比常见词对最终得分贡献更大。idf 加权召回率定义如下:
RBERT=∑xi∈xidf(xi)∑xi∈xidf(xi)maxx^j∈x^xi⊤x^j最后,由于预归一化向量将原始余弦相似度分数限制在较窄的数值范围内,作者实现了一种基线重缩放技术以提高分数可读性。他们通过对来自大型单语语料库的随机配对句子的 BERTSCORE 进行平均,计算经验下界 b。随后使用该基线对原始分数进行线性重缩放,使数值更接近标准的 0 到 1 范围,而不改变该指标的排序能力或与人类的相关性。
实验
实验在机器翻译的 WMT 数据集和图像字幕的 COCO 2015 Captioning Challenge 上评估 BERTScore,并在对抗性释义分类上进行了额外的稳健性测试。在机器翻译中,BERTScore 在系统级和片段级与人类判断的相关性以及模型选择方面始终位居前列,片段级相对于 BLEU 的提升尤为明显。在图像字幕中,它以较大优势优于所有任务无关基线,并且 idf 加权被证明是有益的。稳健性分析表明,BERTScore 在具有挑战性的 PAWS 对抗样本上保持了较强的释义检测性能,而其他指标则大幅下降。
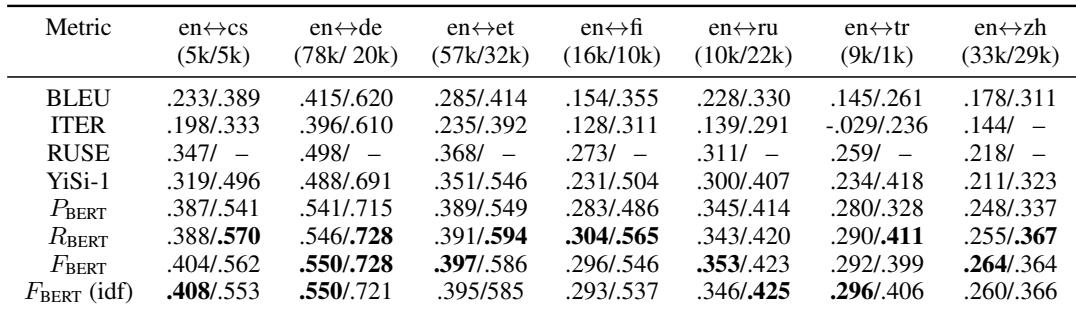
BERTScore 变体,尤其是 F_BERT,在大多数 WMT18 语言对上通常取得很强的系统级 Pearson 相关性,通常与 BLEU、ITER 和 YiSi-1 相当或更优。RUSE 在译为英语的设置中具有竞争力,但由于没有可用的训练模型,缺少译自英语的结果。土耳其语译为英语的设置是一个显著例外,其中 BERTScore 相关性更低且波动更大。F_BERT 在大多数语言对和方向上始终是最强指标之一,通常与 BLEU、ITER 和 YiSi-1 相当或更优。RUSE 在译为英语的情况下具有竞争力,但由于缺少训练模型而没有译自英语的结果。
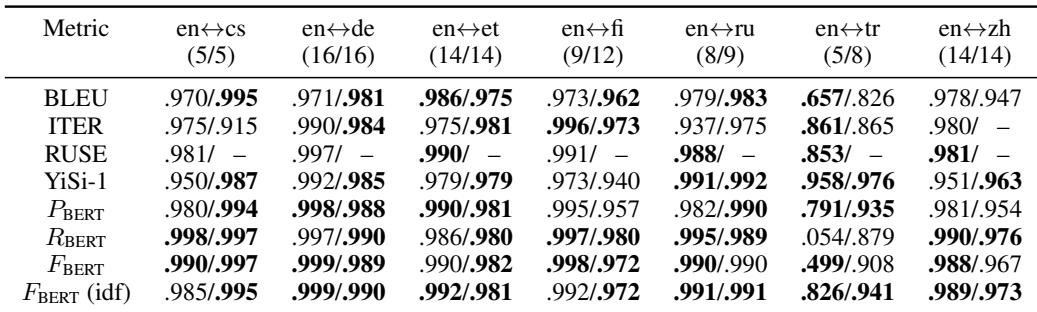
在 WMT18 系统级相关性中,BERTScore 变体通常属于最强指标,F_BERT 在大多数语言对和方向上与 BLEU 和 ITER 相当或更优。RUSE 在译为英语的设置中具有竞争力,但缺少译自英语的结果。土耳其语语言对是一个显著例外,多个指标的相关性下降,而 YiSi-1 表现尤其出色。F_BERT 在大多数语言对和翻译方向上往往与 BLEU 和 ITER 相关性相当或更优。RUSE 报告了很强的译为英语相关性,但没有译自英语的值,而 YiSi-1 在土耳其语语言对上尤其强。
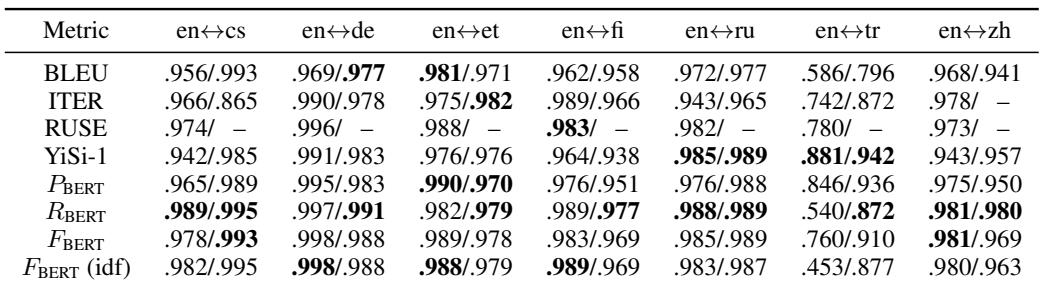
在 WMT18 混合系统模型选择中,BERTScore 变体始终属于最强指标,F_BERT 在大多数译为英语方向和若干译自英语方向上领先或接近领先。RUSE 在译为英语评估中具有竞争力,但在译自英语设置中不可用,此时 BERTScore 和 YiSi-1 提供了最佳替代方案。总体而言,没有一个指标能在每种语言对和方向上都占主导地位。F_BERT 在大多数译为英语方向上是模型选择的最佳指标,BERTScore 变体也在若干译自英语语言对上领先或并列领先。RUSE 在某些语言对上取得最高的译为英语准确率,但没有译自英语结果,因此 BERTScore 和 YiSi-1 在这些方向上是领先指标。
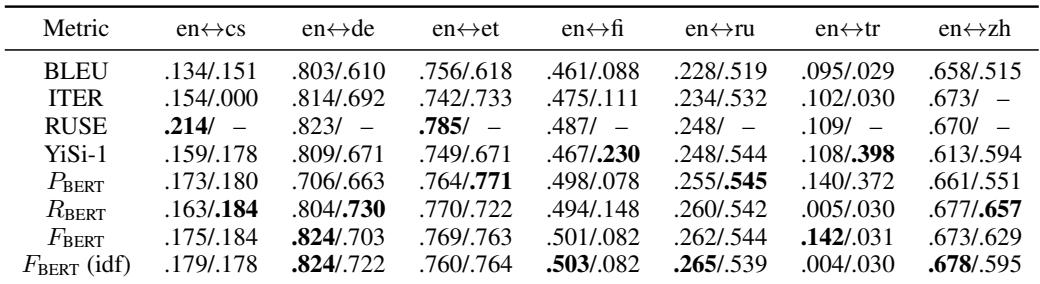
WMT18 上的片段级结果显示,在所有语言对的译为英语和译自英语方向上,BERTScore 变体通常取得与人类判断最强的 Kendall 相关性。RUSE 仅在译为英语中具有竞争力,因为其监督模型可用,而 BLEU 和 ITER 落后于其他指标。BERTScore 与 BLEU 之间的差距尤其明显,表明 BERTScore 对示例级分析更可靠。BERTScore 变体在几乎所有语言对和翻译方向上都是表现最佳者。F_BERT 和 R_BERT 通常是片段级最强的 BERTScore 配置。RUSE 在译为英语中表现具有竞争力,但在译自英语中不可用,限制了其适用性。BLEU 和 ITER 始终表现出较低的片段级相关性,BLEU 远落后于 BERTScore。
在 COCO Captioning Challenge 上,学习到的图像感知指标 LEIC 取得了与人类判断最高的相关性,而 BLEU 和 ROUGE-L 等 n-gram 指标相关性较差。SPICE 是所列任务无关指标中最强的,论文报告称 BERTSCORE 以较大优势优于所有任务无关基线。LEIC 使用图像作为额外输入并针对 COCO 进行了优化,其报告的相关性最高。BLEU 和 ROUGE-L 显示出较弱或接近零的相关性,表明严格的 n-gram 匹配对图像字幕评估不可靠。SPICE 在所列的非图像指标中相关性最强。论文指出,BERTSCORE 在此任务上以较大优势优于所有任务无关基线。
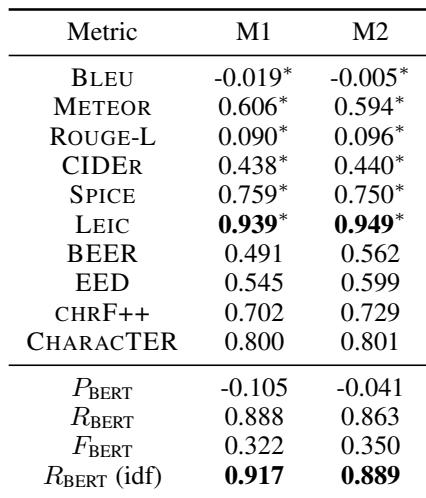
实验在 WMT18 系统级相关性、混合系统模型选择、片段级相关性和 COCO 图像字幕上评估 BERTScore。BERTScore 变体,尤其是 F_BERT,始终属于最强指标,并且在大多数语言对和方向上通常与 BLEU、ITER 和 YiSi-1 相当或更优,土耳其语是显著例外,而 RUSE 因模型不可用仅限于译为英语设置。片段级结果显示 BERTScore 明显领先,而 BLEU 和 ITER 落后,这支持其用于示例级分析的可靠性。在 COCO 上,BERTScore 以较大优势优于任务无关基线,而 n-gram 指标相关性较差,图像感知的 LEIC 表现最佳。