Command Palette
Search for a command to run...
从膜分割到颗粒定位,深度学习框架MemBrain v2打通冷冻电镜分析全流程,显著提升分析速度和处理通量
冷冻电子断层成像(cryo-electron tomography,cryo-ET)是一种强大的成像技术,能够以亚纳米分辨率对天然细胞内部的分子环境进行三维成像,为研究细胞器、膜结构和大分子复合物提供独特窗口。然而,cryo-ET 所捕获的生物学复杂性也给数据标注和分析带来了巨大挑战,其中,由于低信噪比、缺失楔伪影(missing wedge artifacts)以及膜相关颗粒的复杂性,膜结构分析仍然是制约 cryo-ET 研究效率的重要瓶颈。
过去,研究人员已经开发了 TomoSegMemTV、U-Net 以及 TARDIS 等多种工具,但不同方法往往分别解决膜分割、颗粒定位或膜几何分析中的某一个环节,缺少一套完整流程。深度学习方法提供了另一种选择,研究人员近年来已经提出多种基于卷积神经网络(CNN)的方法,用于在 cryo-ET 数据中定位颗粒,然而其中许多方法高度依赖经过大量人工标注的体数据,而这类工作不仅耗时,而且在技术上难以实际完成。
在此背景下,来自亥姆霍兹慕尼黑研究所、慕尼黑工业大学和巴塞尔大学生物中心的研究团队推出了 MemBrain v2,这是一套基于深度学习的框架,将上述任务整合到一条更加简洁、高效的分析流程中。
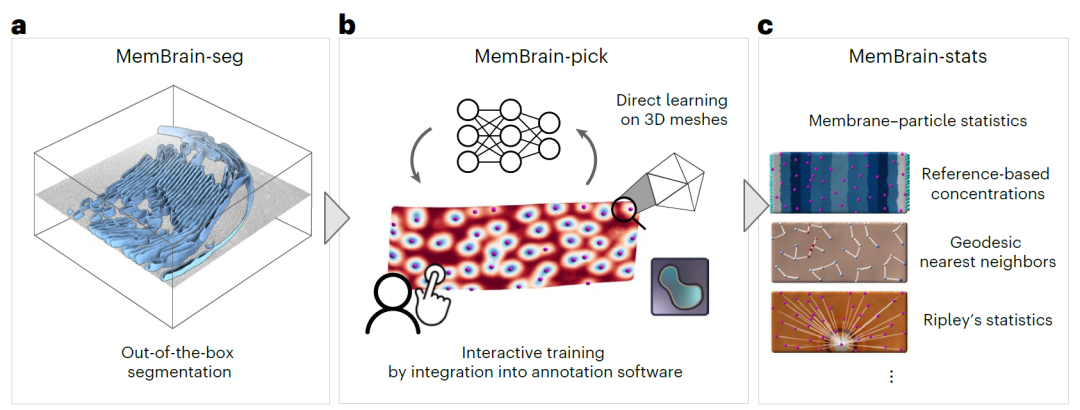
其中,MemBrain-seg 利用多样化、协作生成的训练数据集,并结合针对性的模型训练策略,实现了在不同断层成像条件下具有较强泛化能力的膜结构分割;MemBrain-pick 则将几何约束与深度学习相结合,实现对膜结合颗粒的高数据效率定位,从而减少对大规模人工标注数据的依赖;MemBrain-stats 提供了对颗粒分布的定量分析能力,通过计算空间分布指标,进一步解析膜内颗粒的组织方式。总体而言,MemBrain v2 能够无缝融入冷冻电子断层成像工作流程,为膜结构分析提供一套更加易于使用、结构化且集成度更高的解决方案。
相关研究成果以「MemBrain v2: an end-to-end tool for the analysis of membranes in cryo-electron tomography」为题,已刊登 nature methods。
研究亮点:
-
MemBrain v2 构建了一套从膜结构分割、颗粒定位到统计分析的端到端膜分析流程
-
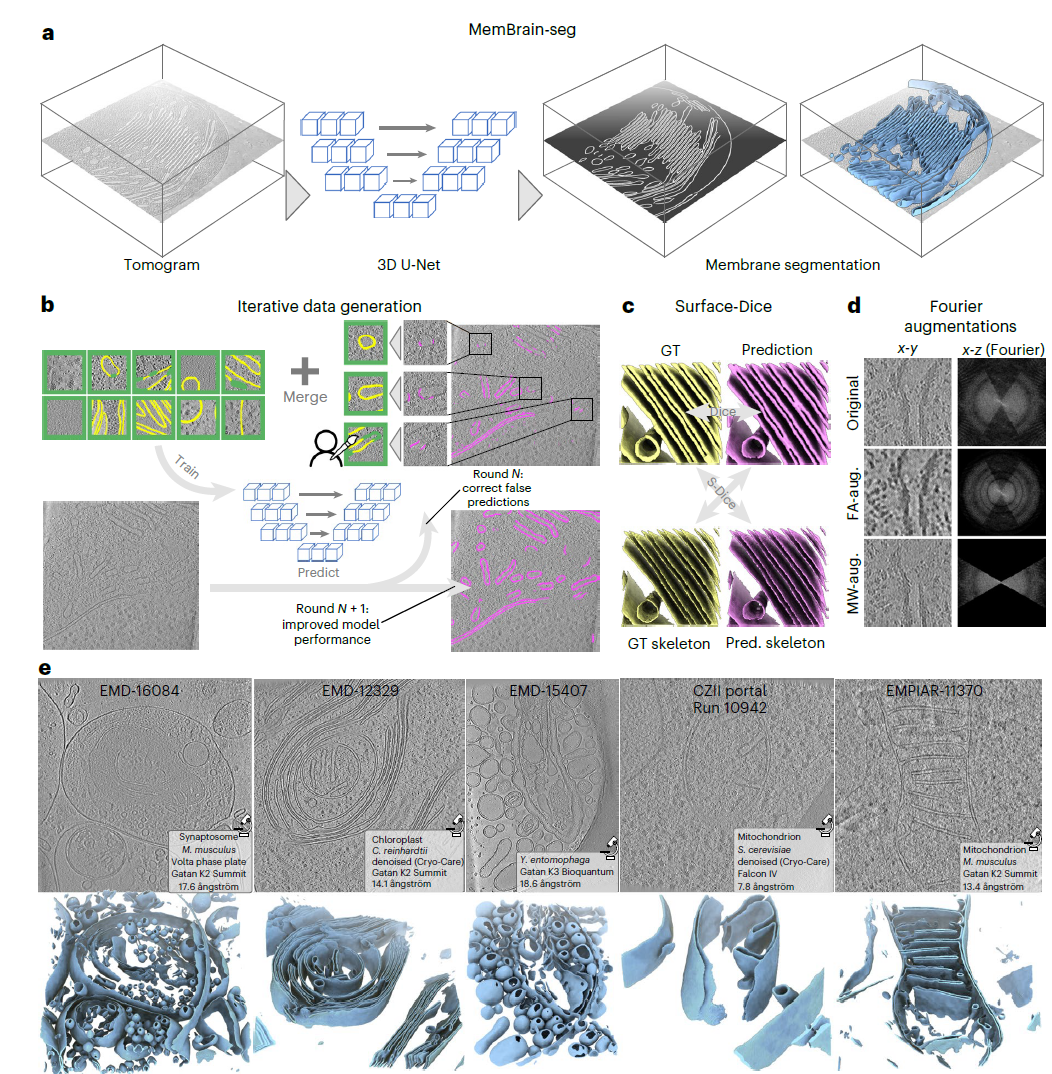
MemBrain v2 引入了Surface-Dice 指标,与传统 Dice 分数相比,该指标对膜结构的拓扑连续性更加敏感
-
通过兼顾多功能性与易用性,MemBrain v2 为 cryo-ET 膜分析提供了一种直观的解决方案,可以应用于多种数据来源,帮助研究人员探索更加广泛的生物学问题
论文地址:
https://www.nature.com/articles/s41592-026-03178-8
从菠菜到衣藻:一个持续迭代的数据集
对于深度学习模型而言,MemBrain v2 真正值得关注的并不只是网络结构,还有其背后的训练数据构建方法。研究团队并没有依赖单一来源的数据,而是采用类似主动学习(active learning)的迭代方式,不断寻找模型最难处理的区域,再通过人工校正将这些「困难样本 」重新加入训练集。
最初,项目使用来自菠菜(S. oleracea)数据集的膜结构分割 patch,这些 patch 最初由 TomoSegMemTV 完成标注。随后研究人员使用 MITK Workbench 对这些 patch 进行人工细化,每个 patch 的尺寸为 160 个体素,并为每个体素分别赋予背景(background)、膜(membrane)或 ignore 三类标签。这一迭代细化过程最终获得了 69 个经过准确标注的菠菜叶绿体 patch。
为了提升模型在不同成像条件和成像设备下的泛化能力,研究人员进一步将这一方法扩展至来自 EMPIAR-11830 的莱茵衣藻(C. reinhardtii)断层图。由于两组数据的成像条件存在差异,模型在初始阶段对该数据集的分割效果明显低于菠菜数据集。为改善模型在该数据集上的表现,研究人员对 33 个 patch 进行了迭代式重新标注,这些 patch 覆盖了类囊体膜、线粒体和高尔基体等结构。
为了进一步提升模型在自身数据之外的适用性,该团队还与其他研究团队展开合作。相关团队在各自的数据集上测试 MemBrain-seg,并针对模型表现不佳的区域提供重新标注的 patch。经过严格的质量评估后,从这些合作数据中获得了 27 个额外 patch,显著提升了训练数据集的多样性。
为进一步提升模型性能,研究团队还利用了现有的少量公开可用膜结构分割数据源。首先,使用开源断层成像模拟器 PolNet 和 CryoTomoSim 生成了 40 个膜结构 patch,其中每个模拟器分别生成 20 个 patch。此外,还整合了一个由外部研究人员完成标注的数据集,即从公开可用的 DeePiCt 数据集(EMPIAR-10988)中提取了 15 个可靠的膜结构分割 patch。这些区域均选自 MemBrain-seg 初始阶段表现较差的区域,从而进一步提升了训练数据集的多样性。
MemBrain v2:一套端到端膜分析流程
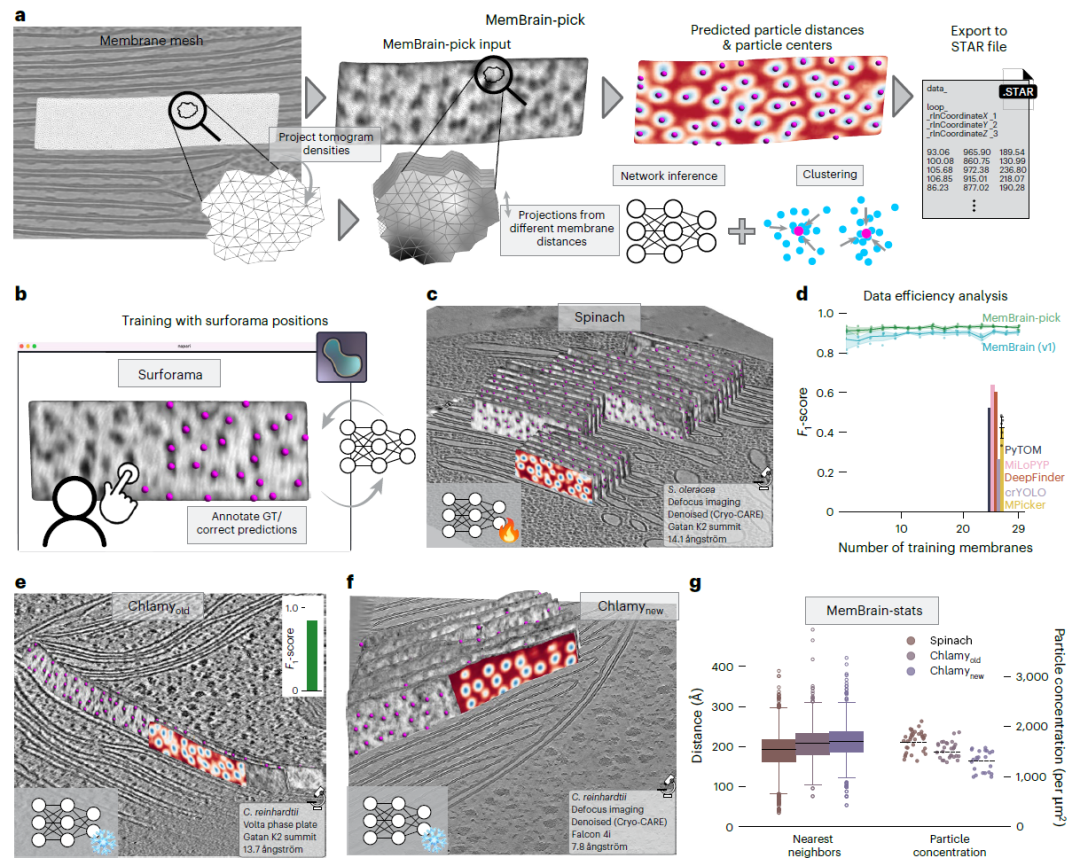
MemBrain v2 是一套模块化分析流程(如下图),旨在简化 cryo-ET 数据集中膜结构及其相关颗粒的分析,其三个核心模块——MemBrain-seg、MemBrain-pick 和 MemBrain-stats 协同工作,实现膜结构分割、颗粒定位与定量分析。
MemBrain-seg:一种通用化的膜结构分割方法
MemBrain-seg(如下图) 是一款基于 U-Net 的程序,只需执行一条命令,即可根据输入的断层图生成三维膜结构分割结果。该模型基于一个多样化且经过迭代优化的数据集进行训练。该数据集通过精细的人工标注与修正,并在与研究社区密切合作的基础上生成,以确保能够覆盖不同类型和不同形态的膜结构。与此同时,研究团队在网络训练过程中引入了针对冷冻电子断层成像特点的数据增强方法以及面向膜结构的损失函数。这些策略共同保证了膜结构能够被准确且连续地勾勒出来,从而便于后续可视化和下游分析。
MemBrain-pick:一种用于高效定位膜相关颗粒的交互式工具
MemBrain-pick (如下图)专门用于高效定位膜结合颗粒,例如膜蛋白。研究团队训练神经网络直接在膜表面上运行,使模型能够将膜的几何结构纳入预测过程,从而缩小搜索空间,同时提升定位准确性和数据利用效率。该模块还与基于 Napari 的交互式工具——例如 Surforama ——实现集成,使研究人员能够快速标注和调整颗粒位置,并在真实标注(GT)数据生成与模型训练之间实现顺畅衔接。
MemBrain-stats:颗粒分布的定量分析
MemBrain-stats 则利用 MemBrain-seg 和 MemBrain-pick 的输出,对膜表面的颗粒分布进行定量分析。该模块能够计算包括颗粒浓度、测地线最近邻距离(geodesic nearest-neighbor distance)以及 Ripley 统计量(Ripley’s statistics)在内的关键指标(如下图)。通过将膜形态与颗粒组织方式联系起来,MemBrain-stats 能够帮助研究人员进一步探究 cryo-ET 数据集中膜结构与颗粒组织之间的结构和功能关系。
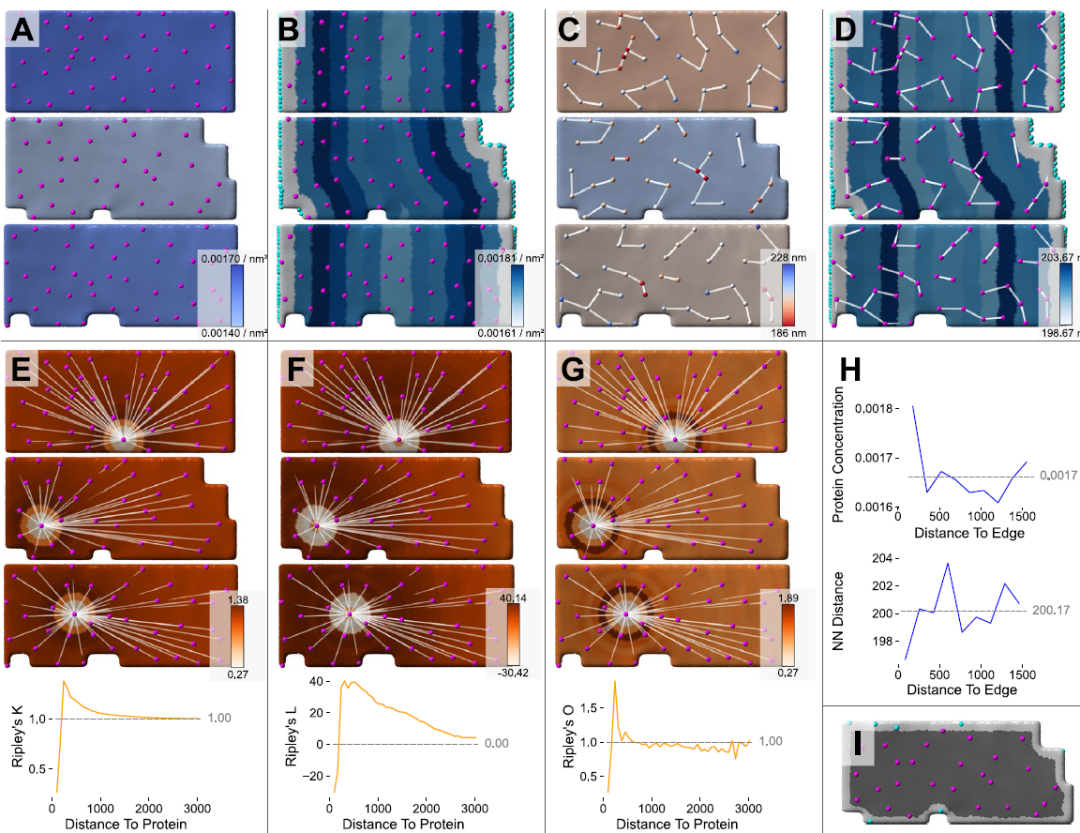
MemBrain-stats 可视化结果
MemBrain v2 采用模块化设计,在兼顾灵活性的同时降低了使用门槛。整个框架提供简洁易用的命令行接口(CLI),并能够与Napari插件无缝集成,以支持交互式标注和可视化。
MemBrain v2 显著提升了分析速度和处理通量
研究人员利用 MemBrain-stats 对预测得到的类囊体膜颗粒分布进行了定量分析,并将结果与此前发表的堆叠类囊体膜中全部颗粒的测量值进行了比较(如下图 g)。对于菠菜,所得结果与已发表的颗粒浓度高度一致:菠菜数据中每平方微米的颗粒数为 1,688 个,此前发表的结果为 1,714 个/μm²。对于莱茵衣藻,预测得到的颗粒浓度略高于此前报道的数值:Chlamyold 和 Chlamynew 分别为 1,492 个/μm²和 1,316 个/μm²,而已发表结果为 1,292 个/μm²。
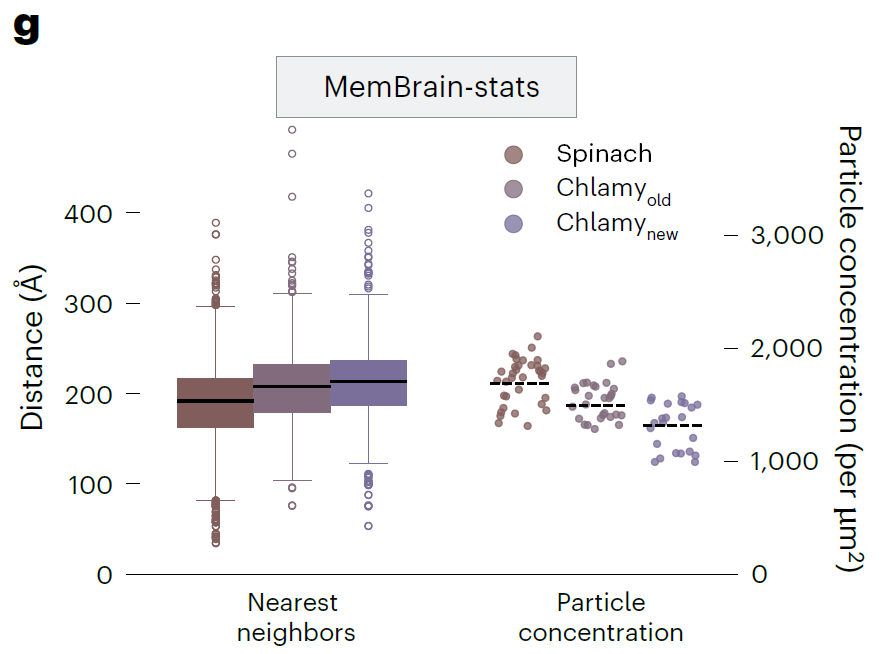
总体而言,这套经过简化的 MemBrain v2 工作流程,在堆叠类囊体膜的分析中取得了与此前人工分析相当的结果,同时显著提升了分析速度和处理通量。研究人员进一步利用这一流程,分析其他类型膜结合颗粒的高阶组织方式,包括藻胆体(phycobilisomes)和核糖体。
测试应用:类囊体膜上的藻胆体组织
研究人员将 MemBrain v2 应用于一套高分辨率的红藻叶绿体冷冻电子断层成像数据集(EMD-31244),展示了该方法如何高效提取藻胆体链的颗粒位置及其空间分布模式(如下图)。
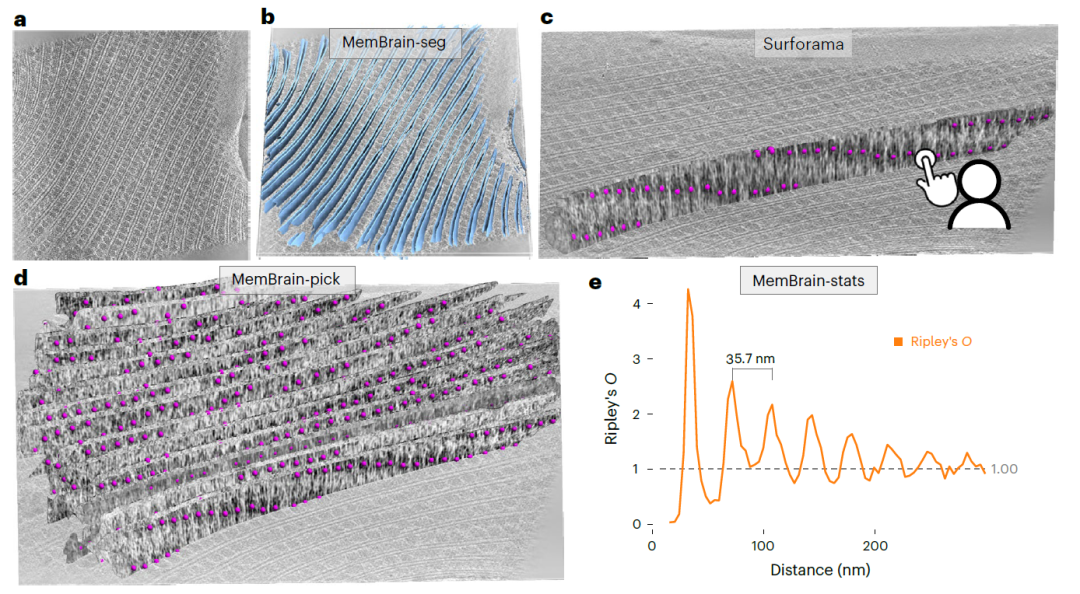
在第一步处理中,MemBrain-seg 对所有类囊体膜均生成了清晰分离且具有较高精度的分割结果(上图 b)。随后,研究人员利用 MemBrain lasso 工具执行连通分量分析(connected component analysis),从整体分割结果中提取单个膜结构实例,并在 Surforama 中进行可视化。借助这一交互式可视化界面,研究人员能够高效地对 6 个选定膜结构实例中的藻胆体链单元位置进行人工标注(上图 c)。这些人工确定的位置随后作为 GT 数据,用于训练 MemBrain-pick 模型。模型训练完成后,MemBrain-pick 被应用于断层图中剩余的 23 个膜结构,并成功识别出整个断层图范围内的藻胆体位置。预测结果显示,藻胆体沿膜表面呈现出明显的周期性排列(上图 d)。
为了对这种空间组织方式进行定量分析,研究人员进一步利用 MemBrain-stats 计算 Ripley’s O 函数。结果证实,藻胆体之间存在规则的间距,约为35 nm(上图 e)。这一周期性与此前人工测定的 34.5 nm 高度一致,证明了该自动化方法的可靠性。
测试应用:核膜上的多核糖体链组织
在 MemBrain v2 的另一项端到端应用中,研究人员分析了核膜外膜上的核糖体分布,旨在识别核糖体的定位和取向模式。在分析包含细胞核周边区域的断层图时,MemBrain-seg 准确分割出了核膜以及其周围的全部细胞质膜结构(下图 a)。研究人员随后利用 MemBrain lasso 工具提取感兴趣的核膜结构,并在 Surforama 中进行可视化,从而高效标注 GT 核糖体位置(下图 b)。
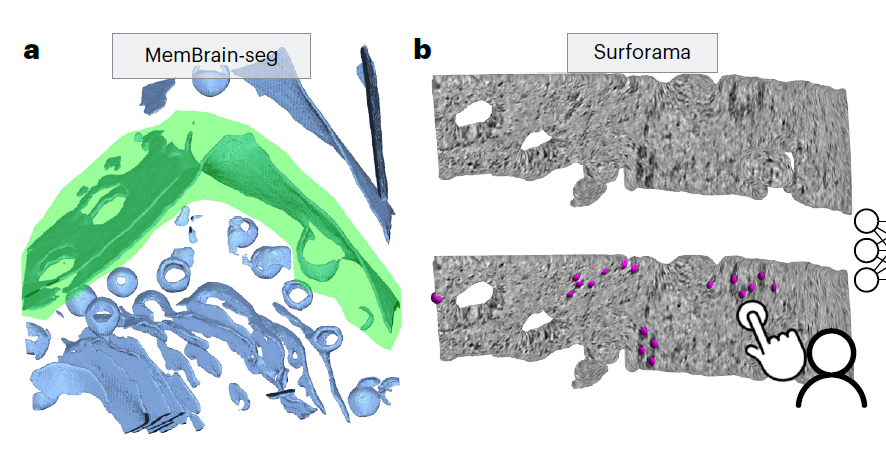
为了实现核糖体定位自动化,研究人员首先人工标注了 13 个膜结构,并据此训练 MemBrain-pick 模型;随后利用该模型对剩余的 79 个膜结构进行预测,共检测到 4,515 个核糖体位置(预测示例见下图 c)。
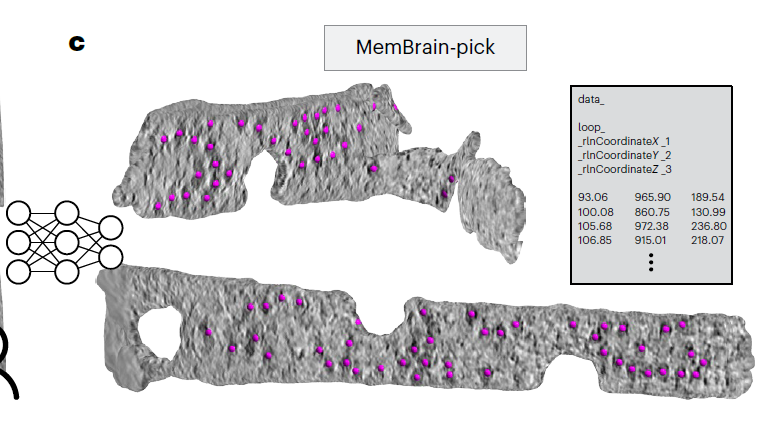
为了验证这些预测结果,研究人员使用 STOPGAP 进行了亚断层平均(subtomogram averaging,STA)。最终得到的结构图清晰呈现了一个与膜结合的核糖体(下图 d),其中还包括跨膜 TRAP 复合物的密度信号。平均结构中还出现了较为模糊的外围密度,这些密度很可能对应邻近的核糖体;通过观察颗粒定位结果的空间分布,也可以得到相应印证(下图 e)。基于 MemBrain-stats 输出的结果,研究人员进一步综合考虑最近邻之间的夹角、距离以及链的连续性等约束条件,提取出了多核糖体链(poly-ribosome chains)。
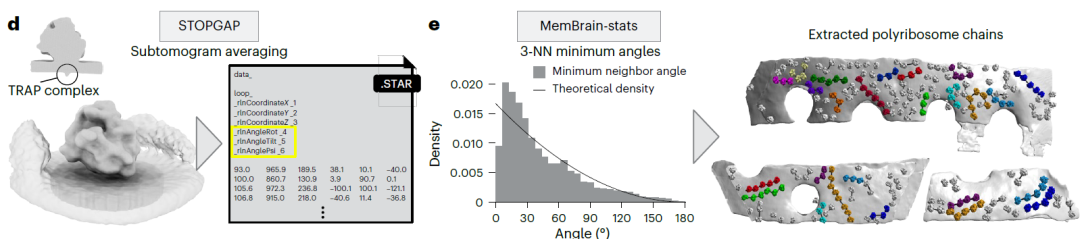
d,STA结果。左图:亚断层平均结果,展示了一个与膜结合的核糖体
e,左图:三个最近邻(3-NN)最小夹角的直方图
这一从原始断层图出发,最终识别出多核糖体链的端到端 MemBrain 分析流程,有望促进研究人员在不同生物体中开展核糖体生物学研究。
结语
当然,MemBrain v2 并非没有局限。其性能仍受到训练数据多样性、膜状非目标结构以及 cryo-ET 自身对比度和噪声水平的制约,对于信号微弱、被遮挡的颗粒,以及容易被强膜密度掩盖的小型整合膜蛋白,准确识别仍存在挑战。同时,分割厚度也不完全等同于真实生物学膜厚度。
未来,通过进一步扩充训练数据,并与 TomoTwin 等互补工具结合,有望提升其对不同膜结构和蛋白质复合物的适用能力。更重要的是,MemBrain v2 将膜分割、颗粒定位与空间定量分析整合为一套开放、易用且可扩展的工作流程,并兼容 STAR、STA 及 Surface Morphometrics 等分析体系。随着更多研究团队参与数据和工具的共享,这类 AI 方法有望进一步降低 cryo-ET 复杂三维数据的分析门槛,推动研究从依赖人工经验的图像识别走向更加自动化、规模化和可重复的定量分析。
参考文献:
https://phys.org/news/2026-09-ai-automates-3d-membrane-manual.html
https://phys.org/news/2026-09-ai-automates-3d-membrane-manual.html