Command Palette
Search for a command to run...
精准预测美国失业率和贫困率,谷歌人口动态基础模型 PDFM 已开源,可增强现有地理空间模型
疾病、经济危机、失业、灾害……人类世界长期以来被各种各样的问题「侵扰」,了解人口动态对于解决这类复杂的社会问题至关重要。政府相关人员可以通过人口动态数据来模拟疾病的传播,预测房价和失业率,甚至预测经济危机。然而,在过去几十年间,如何准确预测人口动态,对研究人员和政策制定者来说一直是一项挑战。
传统了解人口动态的方法往往依赖于人口普查、调查或卫星图像数据。这些数据固然很有价值,但它们各自都有自己的缺点。比如,人口普查虽然全面,但无法频繁进行且成本高昂;调查可以提供局部见解,但往往缺乏规模和普遍性;卫星图像提供了广泛的概览,但缺乏有关人类活动的详细信息。为了弥补这些缺点,多年来,谷歌构建了大量数据集,希望了解人口行为特征。
近日,谷歌提出了一种新颖的人口动态基础模型 (Population Dynamics Foundation Model, PDFM),利用机器学习整合了全球范围内可用的丰富地理空间数据,大大扩展了传统地理空间模型的能力。在涵盖健康、社会经济与环境的 27 项任务中,研究人员对 PDFM 进行了插值、外推和超分辨率问题的基准测试。研究发现,在所有 27 项任务的插值中,PDFM 均实现了最先进性能;在外推和超分辨率任务中,有 25 项取得了最佳表现。研究人员还展示了 PDFM 可以与最先进的预测基础模型 (TimesFM) 结合,成功预测失业率和贫困率,性能优于完全监督的预测方法。
相关研究以「General Geospatial Inference with a Population Dynamics Foundation Model」为题,发表于 arXiv 。同时,研究人员在 GitHub 上发布了所有 PDFM 嵌入和示例代码,便于研究社区将其应用于新的用例,进一步赋能学术研究与实践。
PDFM 项目开源地址:
https://github.com/google-research/population-dynamic
研究亮点:
* 研究人员引入了一种解耦嵌入架构,将嵌入维度按数据来源进行分区,确保模型能够关注所有输入并保留每种数据的相关信息,同时为下游任务提供数据源级的可解释性
* 研究人员展示了如何使用 PDFM 增强最先进的预测基础模型 TimesFM,从而改善县级失业率和邮政编码级贫困率的预测。类似方法也可用于利用 PDFM 嵌入增强其他现有地理空间分类和回归模型
* 通过在插值、外推、超分辨率和预测任务中的强劲表现,研究人员证明 PDFM 可以轻松扩展到需要地理空间建模的多种应用场景,包括科研、公益事业、公共与环境健康,以及商业领域
 论文地址:
https://arxiv.org/abs/2411.07207
开源项目「awesome-ai4s」汇集了百余篇 AI4S 论文解读,并提供海量数据集与工具:
https://github.com/hyperai/awesome-ai4s
数据集:五大通用数据集
为了开发 PDFM,研究人员收集并整理了 5 大数据集,覆盖邮政编码和县级的地理区域,具体如下:
① 聚合搜索趋势数据集 (Aggregated Search Trends):研究人员计算了 2022 年 7 月前 500 个查询的聚合计数 (aggregate counts),要求其在每个邮政编码区域内搜索次数至少为 20 ,从而形成了超过 100 万条独特查询。然后其按这些查询的全国范围流行度进行排名,以每个查询出现的邮政编码总数为指标,从中选取了最常见的前 1,000 条查询,作为全国邮政编码级别聚合搜索趋势活动的代表。
② 地图数据集 (Maps):研究人员选取了 2024 年 5 月 Google Maps 中最常见的 1,192 种兴趣点类别,这些类别至少出现在 5% 的邮政编码中。每个类别覆盖了广泛的兴趣点位置,例如,「医疗设施」类别包括儿童医院和大学医院。然后其计算了每个地理边界内可用设施的总数,并在邮政编码和县级生成了一个归一化的 1,192 维特征向量。
③ 繁忙度数据集 (Busyness):对于地图数据中的每个兴趣点类别,研究人员计算了这些类别在一个月内相关地点的访问量总和,以概括这些类别的繁忙度。
④ 天气与空气质量 (Weather & Air Quality):研究人员收集了天气和空气质量数据,并对 2022 年 7 月的逐小时数据进行了汇总,使用均值、最小值和最大值进行描述。完整的变量列表包括:平均海平面气压、总云量、 10 米高度 U 风分量、 10 米高度 V 风分量、 2 米高度温度、 2 米高度露点温度、太阳辐射、总降水率、空气质量指数、一氧化碳浓度、二氧化氮浓度、臭氧浓度、二氧化硫浓度、可吸入颗粒物 (<10μm) 浓度、细颗粒物 (<2.5μm) 浓度。
⑤ 遥感数据 (Remote Sensing):研究人员结合了从 SatCLIP 的 ViT16-L40 版本模型生成的卫星图像嵌入数据,以每个邮政编码的质心为索引获取嵌入。 SatCLIP 模型旨在成为一个全球通用的地理位置编码器,汇总了从 2021 年 1 月 1 日至 2023 年 5 月 17 日期间的 Sentinel-2 卫星影像中的 10 万个图块。
研究人员结合数据集与图神经网络 (GNN) 架构,训练了一个生成嵌入的基础模型,这些嵌入具有普适性而非针对某一特定任务。
模型架构:使用 GNN 高效直观地解决地理空间问题
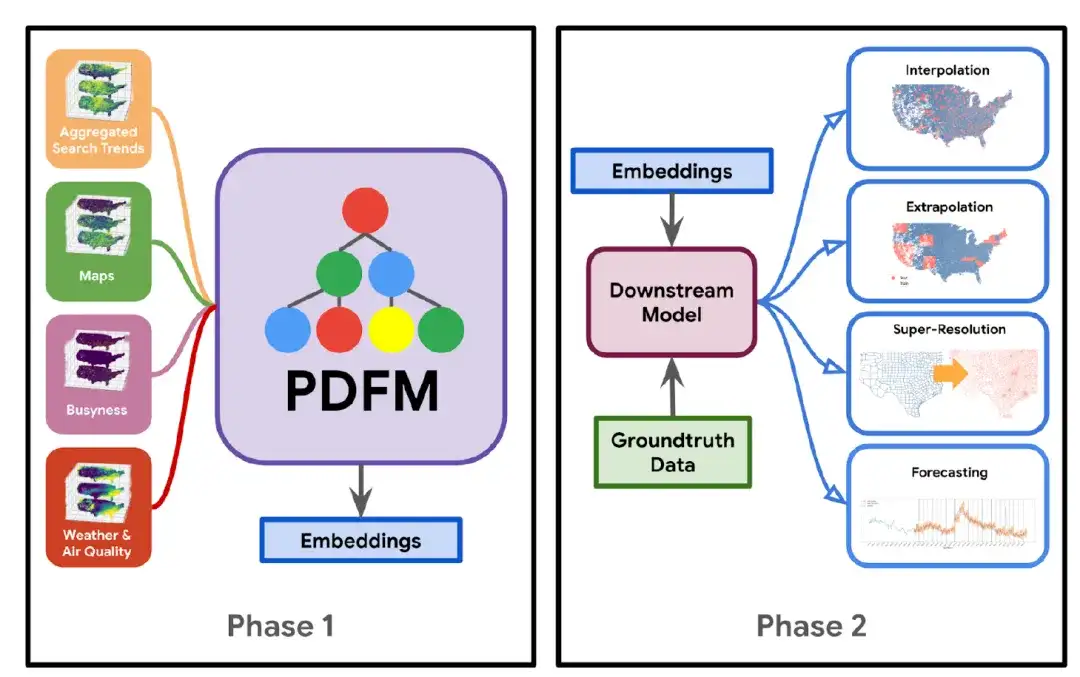
PDFM 模型的构建如下图所示:在第 1 阶段 (Phase 1),研究人员结合数据集与图神经网络 (GNN) 架构,训练一个生成嵌入 (Embeddings) 的基础模型,这些嵌入具有普适性而非针对某一特定任务;在第 2 阶段 (Phase 2),利用这些嵌入 (Embeddings) 和现有任务的特定真实数据 (Groundtruth Data),学习一个下游模型 (如线性回归、简单的多层感知器或梯度增强决策树),从而将其应用于多种任务,包括插值 (interpolation) 、外推 (extrapolation) 、超分辨率 (super-resolution) 和预测 (forecasting) 。
* 插值任务:是指根据已知数据点的值,通过推断和填补未知数据点的值
* 外推任务:是指通过已有的数据或经验推断超出当前已知范围的情境、趋势或结果
* 超分辨率任务:是指通过算法将低分辨率图像或数据提升为高分辨率
* 图的构建:研究人员使用县级和邮政编码作为节点,通过近邻关系建立边,构建了一个异质的地理空间图。构建的地理空间图具有同质的节点集,将邮政编码和县级节点视为相同类型的节点集,并且具有异质的边集,边的类型不同,连接着节点。
* 子图采样:进行子图采样,以便为大规模 GNN 的训练创建子图,并为模型添加随机性。其从种子节点开始,按照广度优先方式遍历每个边集,以加权的方式采样固定数量的节点,并在到达四跳距离 (four hops) 时终止。
具体而言,研究人员从种子节点开始,按照广度优先方式遍历每个边集,以加权的方式采样固定数量的节点,并在到达四跳距离时终止。这种方法导致的子图数量等于邮政编码和县级节点的总数。
* 预处理:对所有特征应用按列标准化,并通过裁剪压缩特征值范围的极端端点。
* 建模与训练细节:采用 GraphSAGE (一种归纳方法) 来通过利用节点特征信息学习节点嵌入。 GraphSAGE 可从局部邻域聚合信息中学习生成嵌入的函数。对于聚合架构,使用 GraphSAGE 中提出的池化架构,其中来自邻域节点的节点状态通过一个带有 ReLU 转换的全连接层进行传递,转化后的旧状态和邻域节点状态通过逐元素加和的方式进一步聚合。研究人员使用 GraphSAGE 架构来促进一次消息传递,经过 GNN 层后,添加一个大小为 330 的线性层,将节点级表示编码成压缩的嵌入。
* 超参数调优:从 20% 的种子节点 (包括县和邮政编码) 中均匀采样,组成验证集进行调优,调优的超参数包括丢弃率、节点嵌入的大小、 GraphSAGE 隐藏单元和层的数量、嵌入大小、正则化和学习率。
研究结果:在插值、外推、超分辨率和预测任务中表现强劲
PDFM 是一种灵活的基础模型框架,能够应对美国大陆范围内的多种地理空间挑战。通过整合多样化的数据集,PDFM 嵌入在 27 项健康、社会经济和环境任务中,超越了现有的最先进 (SoTA) 位置编码方法 (如 SatCLIP 和 GeoCLIP) 。
在插值任务中,PDFM 在所有 27 项任务上表现出色;在外推和超分辨率任务中,则在 25 项任务中领先。此外,研究人员展示了 PDFM 嵌入如何增强预测模型 (如 TimesFM) 的性能,从而改进对县级失业率和邮政编码级贫困率等重要社会经济指标的预测。这都凸显了其在研究、社会公益、公共与环境健康以及商业领域中的广泛应用潜力。
具体实验结果如下:
① 插值实验
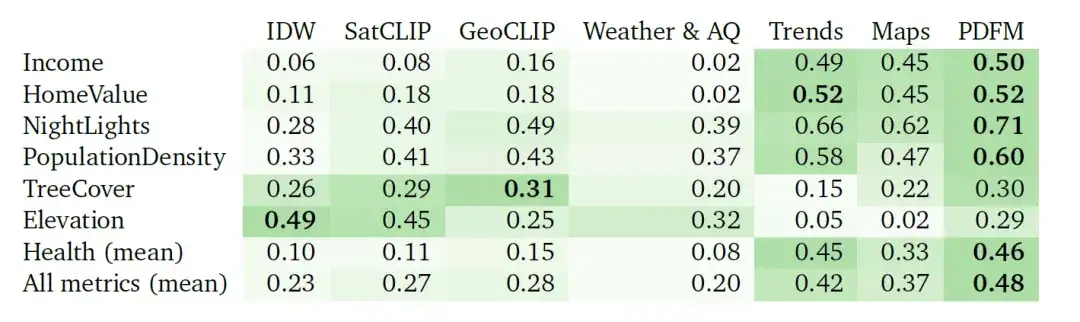
下图展示了在健康 (Health) 、社会经济 (Socioeconomic category) 和环境 (Environmental) 三个类别的 27 项任务上的完整插值实验结果,使用 ² 指标评估不同模型性能(较高值表示模型更好地解释了目标变量标签的方差)。如图,PDFM 在社会经济和健康任务类别中显著优于 SatCLIP 和 GeoCLIP 。
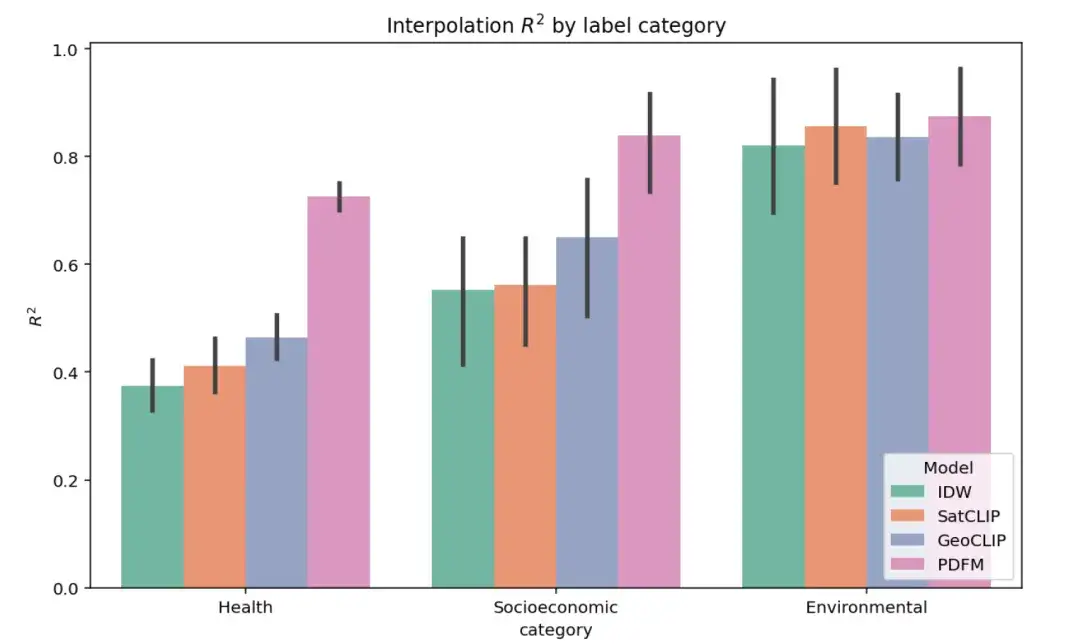
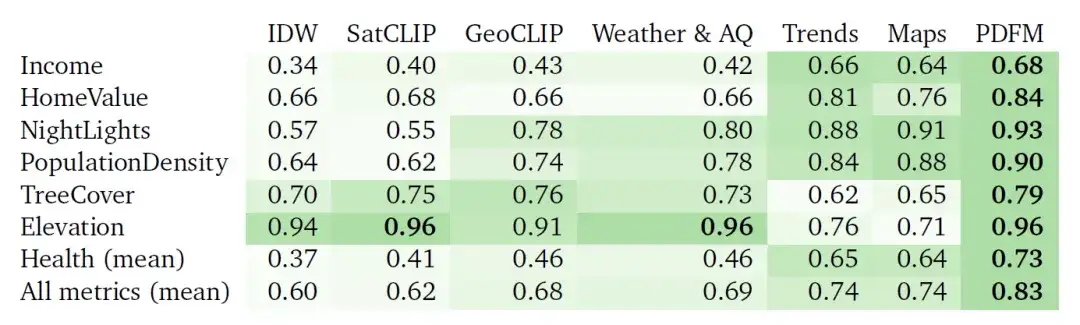 表:插值 ² 结果 (值越高越好) 。这些实验比较了基于逆距离加权 (IDW) 插值、 SatCLIP 嵌入、 GeoCLIP 嵌入、 PDFM 嵌入及其子组件(天气与空气质量、聚合搜索趋势、地图和繁忙度)的表现,使用 GBDT 作为下游模型。
② 外推实验
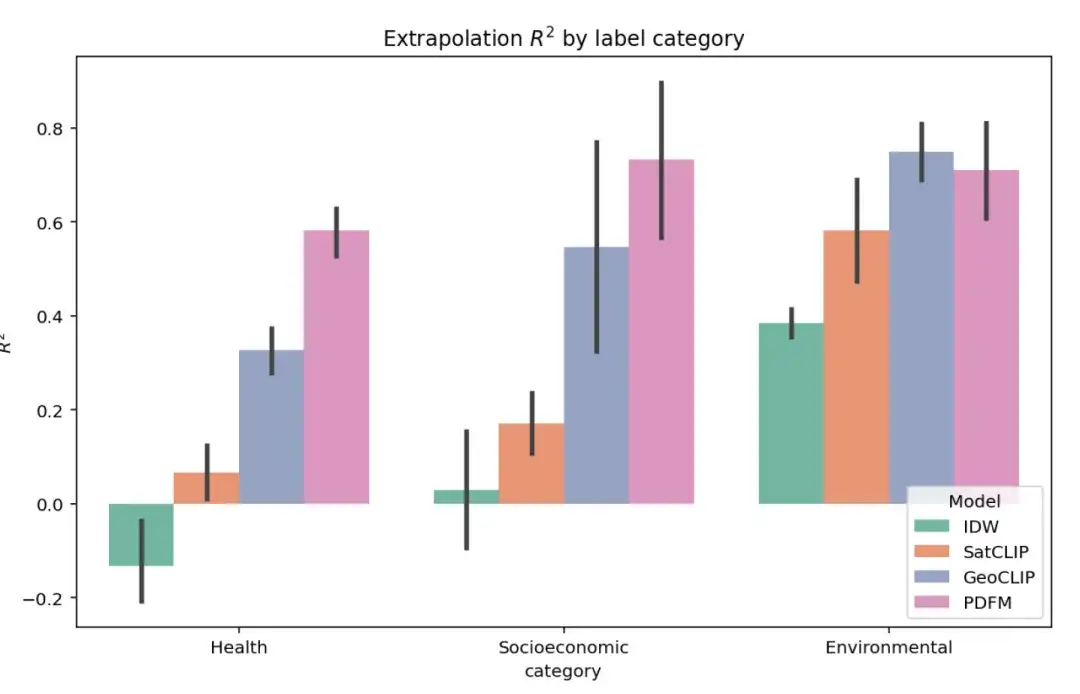
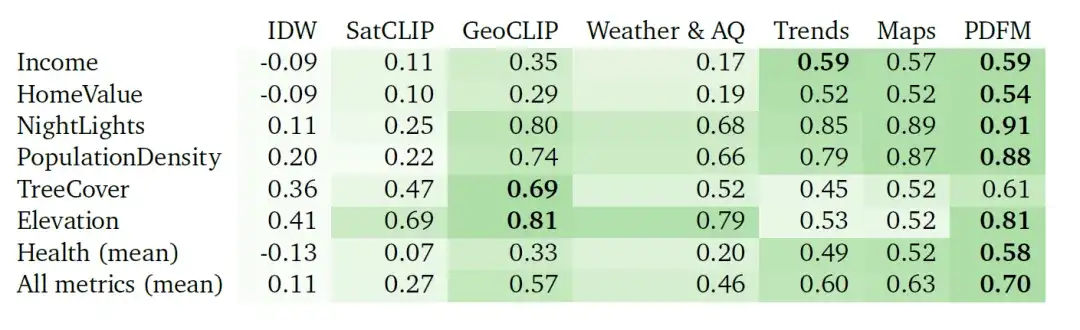
下图展示了在健康 (Health) 、社会经济 (Socioeconomic category) 和环境 (Environmental) 三个类别的 27 项任务上的完整外推实验结果,依然使用 ² 指标评估模型性能。如图,尽管 GeoCLIP 在处理环境任务时稍占优势,PDFM 在预测健康和社会经济变量方面明显优于其他所有基线模型。
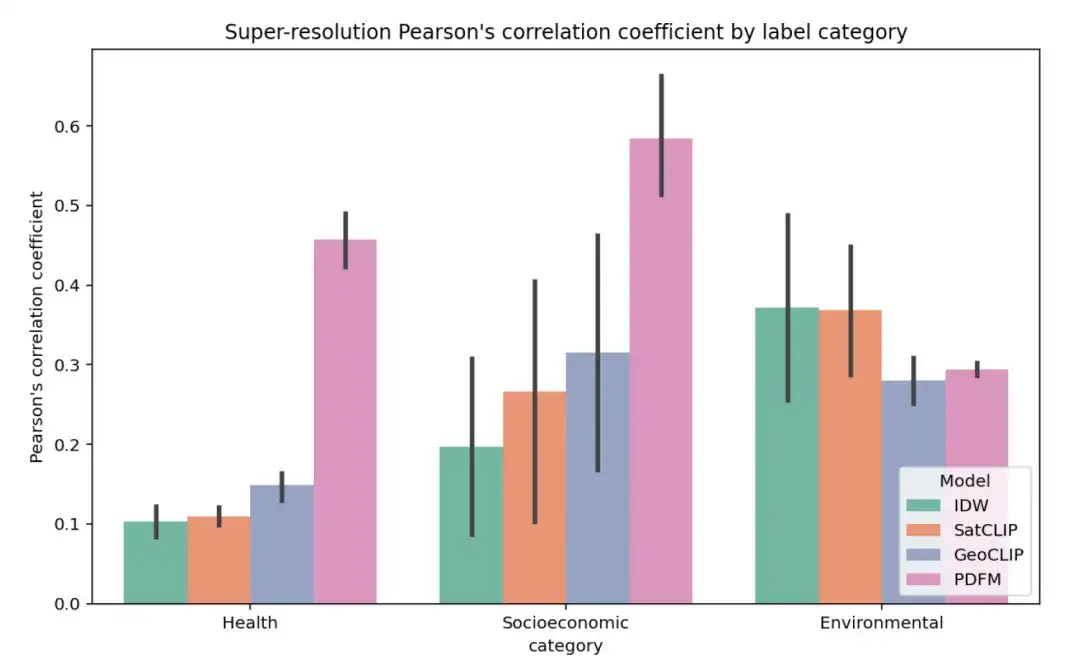
下图展示了 27 个任务的超分辨率实验完整结果,任务按健康 (Health) 、社会经济 (Socioeconomic category) 和环境 (Environmental) 分组,使用县内平均皮尔逊相关系数 (r) 作为指标(较高值表示模型的预测值与邮政编码级别的真实标签更相关)。
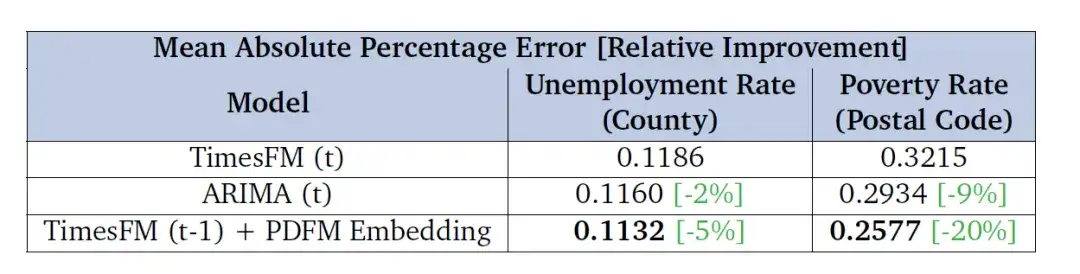
研究人员还评估了使用 PDFM 嵌入来修正 TimesFM (一种通用单变量预测基础模型) 预测误差的效果,其主要目标是评估这些嵌入在未来时段(6 个月的失业率预测和两年的贫困率预测)中的改进效果。下表中的结果显示,结合 PDFM 嵌入的模型在 MAPE 指标上超越了 TimesFM 的基线性能,也优于 ARIMA——这表明 PDFM 嵌入能显著增强 TimesFM 的预测效果。
地理空间人工智能 (GeoAI) 蓬勃发展
PDFM 模型的诞生,可以说是对地理空间数据的又一次深入挖掘和利用。所谓地理空间数据,通常涉及从许多不同来源以不同格式收集的大量时空数据,可以包括普查数据、卫星图像、天气数据、手机数据、绘制图像和社交媒介数据等信息。通过科学的方式共享、分析和使用地理空间数据,能够为人类社会发展提供许多有益的洞察,比如预测失业率、房价,模拟某种药物的影响或是灾后人口的迁移等等。
不过,海量的地理空间数据如何有效处理是一项挑战,随着人工神经网络模型的出现,地理空间人工智能(GeoAI)的概念应运而生,业界也在此方面做出了许多探索。
比如,2024 年 4 月,为了提升成矿预测模型的可解释性,以及成矿过程中因地质因素导致的空间非平稳性,浙江大学的研究团队提出了一种新的地理空间人工智能方法——地理神经网络加权逻辑回归 (geographically neural network-weighted logistic regression, GNNWLR) 。该模型集成了空间模式 (spatial patterns) 和神经网络,结合 Shapley 加性解释理论,不但能够大幅提升预测的准确性,并且能够在复杂的空间场景中提升矿物预测的可解释性。
点击查看详细报道:优于五大先进模型,浙江大学杜震洪团队提出 GNNWLR 模型:提升成矿预测准确性
2024 年 6 月,浙江大学 GIS 实验室的研究人员在地理信息科学领域知名期刊 International Journal of Geographical Information Science 上发表了题为「A neural network model to optimize the measure of spatial proximity in geographically weighted regression approach: a case study on house price in Wuhan」的研究论文,创新性地引入神经网络方法对观测点间的多种空间邻近性度量 (如欧式距离、旅行时间等) 进行非线性耦合,得到优化的空间邻近性度量 (OSP),从而提升模型对房价预测的准确性。通过模拟数据集和武汉市房价实证案例的研究,论文提出的模型被证明具有更好的全局性能,能更准确地描述复杂的空间过程和地理现象。
点击查看详细报道:精准预测武汉房价!浙大 GIS 实验室提出 osp-GNNWR 模型:准确描述复杂空间过程和地理现象
未来,随着 AI 技术的持续发展,地理信息产业将拥有更坚实的技术底座、更便捷的开发工具,从而推动人类步入地理空间智能时代。
参考资料:
1.https://arxiv.org/abs/2411.07207
2.https://research.google/blog/insights-into-population-dynamics-a-foundation-model-for-geospatial-inference/
3.https://www.ibm.com/cn-zh/topics/geospatial-data
4.https://mp.weixin.qq.com/s/eQz5N-cFTtGIkDk7IqMZxA
5.https://www.xinhuanet.com/science/2