Command Palette
Search for a command to run...
浙大团队发表 3D 视图合成新方法,效果远超 NeRF 、 NV
只需几个不同视角的视频,就能把整个人体形象 360° 无死角地构建起来,不得不说,AI 的脑补能力越来越强大。这样的工具,今后将可能为影视业、体育节目呈现等带来新的突破。
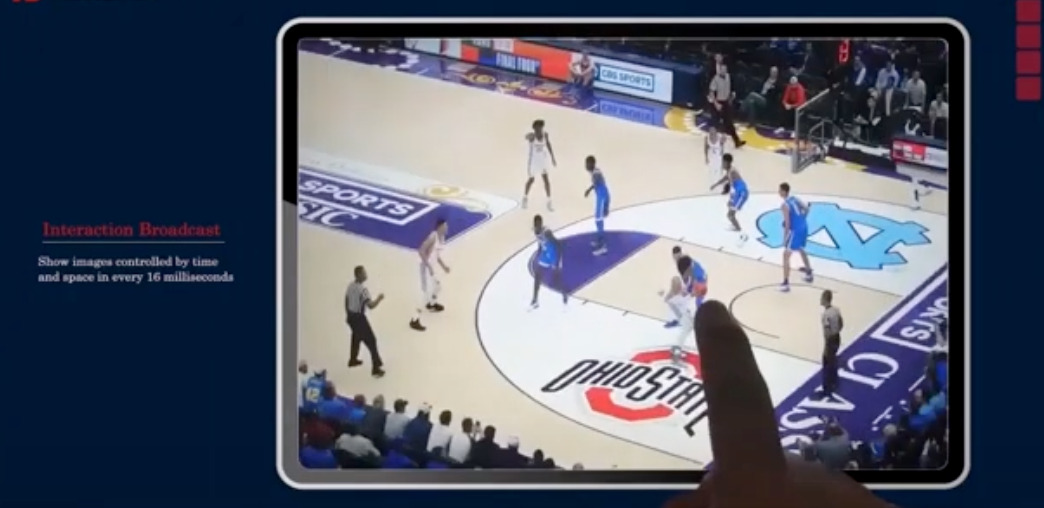
未来,我们的看电影、球赛以及演唱会等的方式,可能被「自由视角视频」(free-viewpoint video)彻底改变。
你可能不知道什么是「自由视角视频」,但你应该体验过 VR 、 AR 视频,或者玩过 3D 游戏,这些都属于自由视角视频的范畴,其特点便是:可以从任意角度观看,提供完全沉浸式的观感。

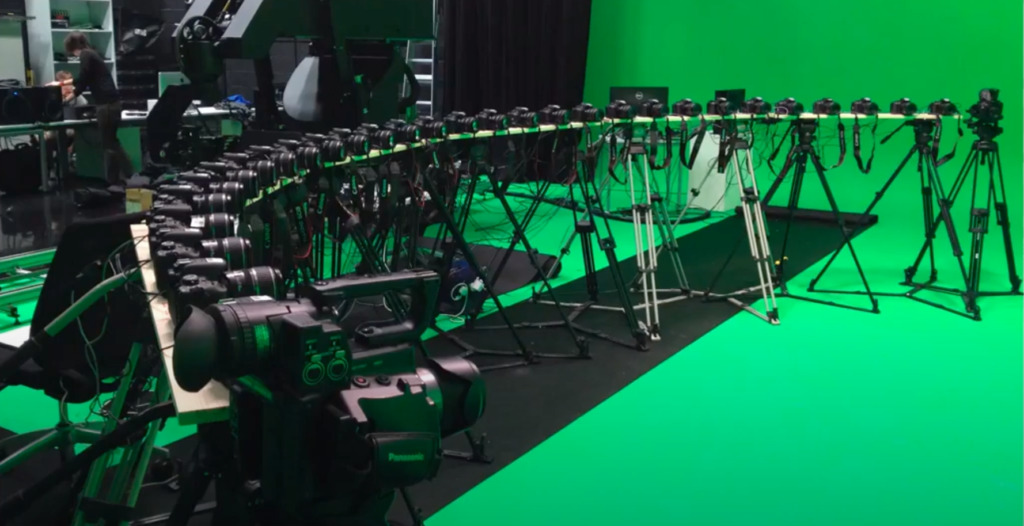
还有一种方式,可以摆脱这些限制,只需输入少量角度拍摄的人体镜头,便可合成 360° 的人体 3D 新视图。这便是来自浙江大学的研究人员,最近发表的最新成果。
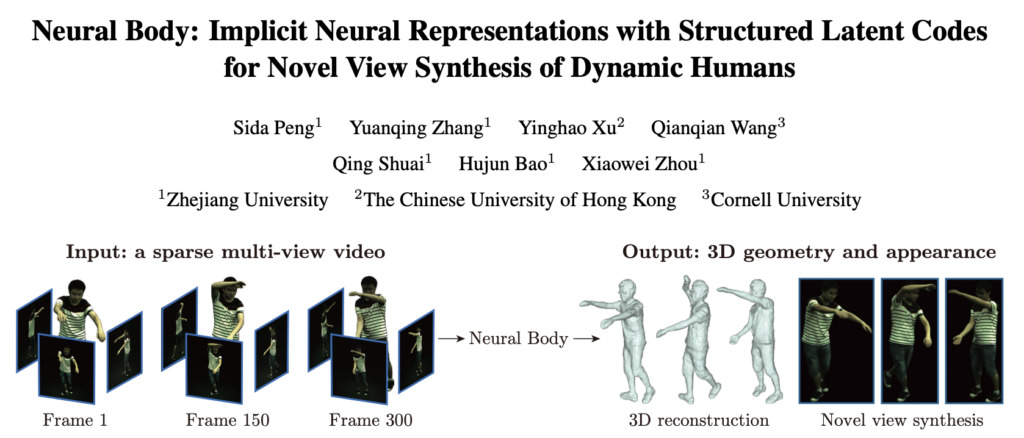
12 月底,该团队在 arxiv 上发表了新论文《Neural Body: Implicit Neural Representations with Structured Latent Codes for Novel View Synthesis of Dynamic Humans》,提出一种新的人体表示 Neural Body,用稀疏多视角视频进行动态 3D 人体新视图的合成。经过实验验证,该方法优于此前的其它方法。
素材不多,也能生成优质 3D 视图
目前,无论是影视节目,或是体育赛事,我们所看到的都是来自单个摄像头所拍摄的画面。如果能够得到「自由视角视频」,想看哪里看哪里,那一定会是上帝视角一般的体验。
事实上,AI 近几年也在研究这个问题,并诞生了诸如 NeRF 、 Neural Volumes(简称 NV)等视图合成方案。
不过,目前已有的研究表明,在密集的输入视图条件下,学习三维场景的隐式神经表示可以获得很好的视图合成质量。然而,如果视图是高度稀疏的,表示学习将是不适定的。
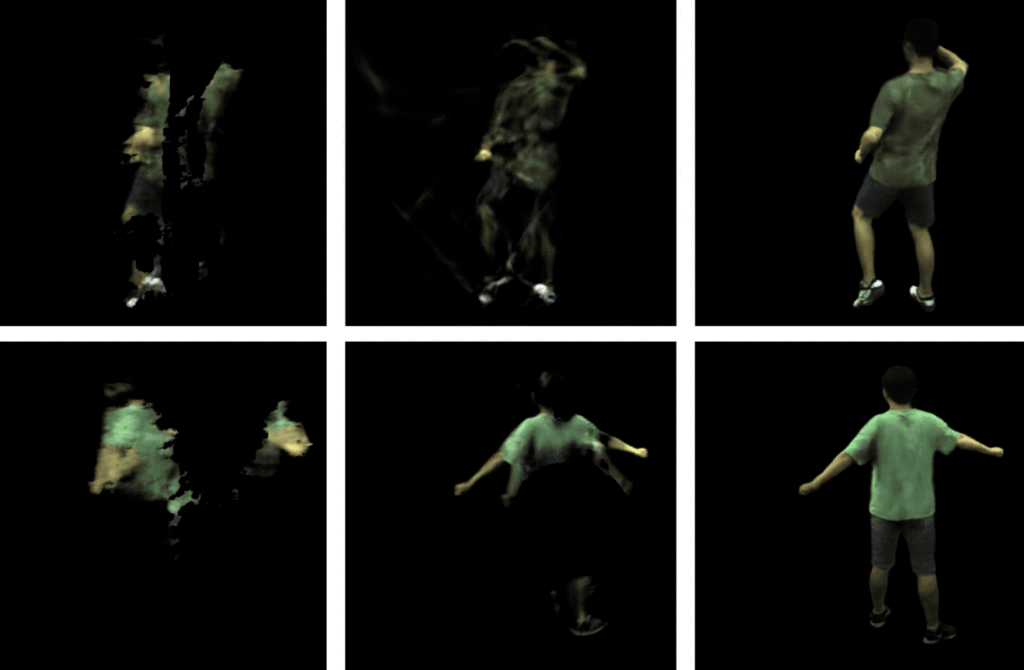
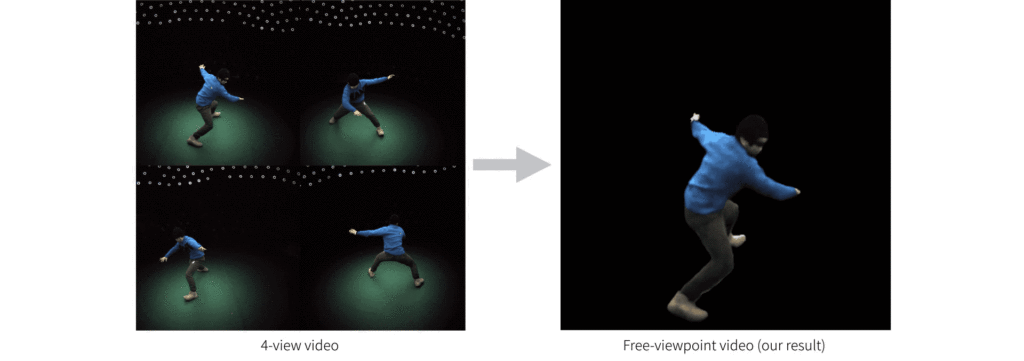
团队的最新研究成果中,提出了 Neural Body 。这是一种新的人体表示,它假设在不同帧上学习到的神经表示共享,锚定在一个可变形网格上的相同的潜码集,以便跨帧的观察可以自然地集成。可变形网格也为网络提供了几何指导,以更有效地学习 3D 表示。

团队在 demo 演示中,展示了其方法从做出各种动作的人物的单目视频中,重建移动的人物的能力。
得到 Neural Body,分五步走
一、结构化的潜码
为了控制潜码的空间位置与人体姿态,团队将这些潜码锚定到一个可变形人体模型 (SMPL) 。 SMPL 是一个基于皮肤顶点的模型,它被定义为形状参数、姿势参数和相对于 SMPL 坐标系的刚体变换函数。
潜码与神经网络,一起用于表示人的局部几何和外观。将这些代码锚定在一个可变形的模型上,能够表示一个动态的人。通过动态人的表示,团队建立了一个潜在变量模型,将同一组潜码映射到不同帧的密度和颜色的隐式域中,自然地整合了观察结果。
二、代码扩散
由于结构化的潜码在三维空间中比较稀疏,直接对潜码进行插值会导致大多数三维点的向量为零。为了解决这个问题,团队将表面上定义的潜码扩散到附近的三维空间。
由于代码的扩散不应该受到人在世界坐标系中的位置和方向的影响,他们将代码的位置转换为 SMPL 坐标系。
代码扩散还将结构化潜码的全局和局部信息集合起来,有助于学习隐式域。
三、密度和颜色回归
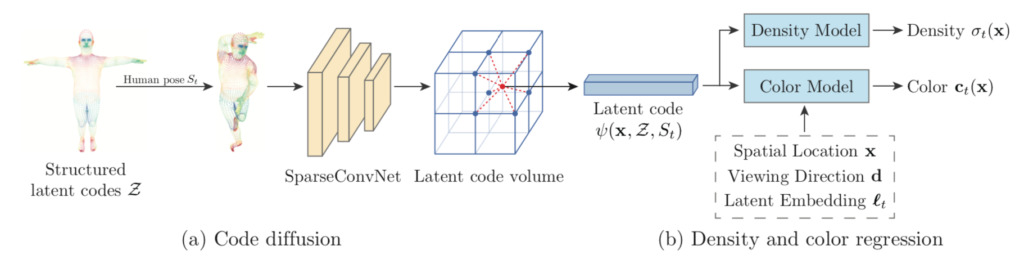
四、体绘制
在给定的视点下,团队利用经典的体绘制(volume rendering,也称立体渲染)技术,将 Neural Body 渲染成二维图像。
然后,基于 SMPL 模型估计场景边界,接着,Neural Body 会预测这些点的体积密度和颜色。
在体绘制的基础上,通过对渲染图像和观测图像的比较,对模型进行了优化。
五、训练
与基于帧的重建方法相比,该方法利用视频中的所有图像来优化模型,并拥有更多的信息来恢复 3D 结构。
此外,团队采用 Adam 优化器来训练 Neural Body 。训练在四个 2080 Ti GPU 上进行。对于一个共 300 帧的四视图视频,训练通常需要大约 14 小时。
经过以上五个步骤,Neural Body 得以实现基于少量视图的自由视角视频合成,而且与其他方法对比,效果明显优于前者。
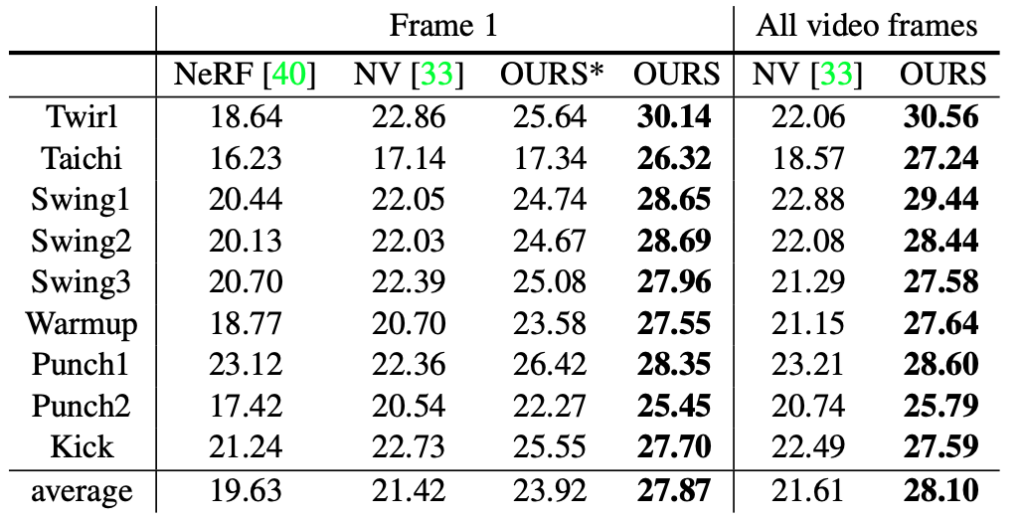
AI 的脑补技术,让 3D 效果的实现越来越简便,而它的应用也不止是影视业与体育赛事直播领域,对于游戏开发者、健身指导、 3D 广告提供商等来说,都是能够大大提升工作效率与效果的工具。