Command Palette
Search for a command to run...
البيانات الميكروبية التربة الضخمة يصعب تصنيفها، وBBERT يكشف عن مؤشرات التصنيف والوظيفة من قراءات قصيرة بطول 100 زوج قاعدي
تتمتع النظم البيئية الميكروبية بتركيب معقد للغاية، ويفهم هذا التعقيد أساسياً للكشف عن العمليات المختلفة التي تحافظ على عمل المحيط الحيوي، ولا يمكن إنجاز هذا العمل دون تحليل مجموعات بيانات التسلسل الضخمة. واليوم، أصبحت هذه الموارد الغنية بالبيانات متاحة على نطاق واسع: آلاف مجموعات البيانات الميتاجينومية العامة التي تغطي مختلف الأحياء الحيوية على الأرض، وجميعها متاحة للتنزيل والمجانية.
من بين هذه البيانات، تحظى الميتاجينوميات الخاصة بالتربة بأهمية بحثية استثنائية. يمكن أن يكشف تسلسل الميتاجينوميات باستخدام تقنية البندقية (Shotgun Metagenomics) في البيئات المعقدة مثل التربة عن تنوع بيولوجي غني للغاية. ومع ذلك، بسبب نقص قواعد البيانات المرجعية الشاملة بما يكفي، لا يمكن الحصول على تعليقات تصنيفية أو وظيفية دقيقة لمعظم القراءات القصيرة (Short Reads) الناتجة عن تسلسل البندقية، مما يجعل الهيكل الوظيفي الحقيقي للمجتمعات الميكروبية صعب التحليل بشكل شامل.
في هذا السياق، اقترح فريق بحثي من الجامعة العبرية في القدس BBERT، وهو نموذج لغوي كبير للنوكليوتيدات مُحسَّن لتحليل القراءات القصيرة. أجرى الباحثون اختبارات على مجموعات بيانات ضخمة من الميتاجينوميات التربة، ووجدوا أن BBERT يمكنه تحديد السمات النحوية للتسلسلات البكتيرية دون الحاجة إلى الاعتماد على قواعد البيانات المرجعية، وتحديد نطاقها التصنيفي (Taxonomic Domain)، وإمكانية الترميز (Coding Potential)، وإطار القراءة (Reading Frame) بدقة مباشرة من القراءات القصيرة التي لا يتجاوز طولها 100 زوج قاعدي (bp). بالإضافة إلى ذلك، يمكن لنموذج BBERT تحويل القراءات الميتاجينومية القصيرة مباشرة إلى تسلسلات أحماض أمينية بكتيرية، مما يوفر الدعم للبحث والتطبيقات اللاحقة. أظهر BBERT أيضاً ميزة في التجميع الميتاجينومي من الصفر (De Novo Assembly): حيث يمكنه تقليل عدم التطابق والفجوات أثناء عملية التجميع، مع تقليل وقت التشغيل. استخدم الباحثون بشكل إضافي بيانات الميتاجينوم من عقيدات جذور البقوليات البرية للتحقق، وأظهرت النتائج أن التصفية باستخدام BBERT لا تعزز جودة التقسيم (Binning) بشكل كبير فحسب، بل تسرع أيضاً سرعة التجميع من الصفر بشكل كبير.
نُشرت النتائج البحثية ذات الصلة تحت عنوان «Fast and accurate taxonomic domain assignment of short metagenomic reads using BBERT» في مجلة Nucleic Acids Research.
أبرز نقاط البحث:
- تجاوز BBERT في آن واحد قيود الطرق السابقة القائمة على النماذج اللغوية الكبيرة من حيث الإنتاجية والدقة.
- يمكن أن يؤدي استخدام BBERT كمرشح أولي قبل تحليل الميتاجينوم إلى تحسين سرعة التعليق الوظيفي وجودة التجميع من الصفر، وتقليل أخطاء التجميع، وتحسين جودة التقسيم.
- يوفر BBERT طريقة تصنيف سريعة لا تتطلب قواعد بيانات مرجعية للقراءات القصيرة، مما قد يطلق القيمة البحثية لعدد كبير من أرشيفات بيانات الميتاجينوم الحالية.
عنوان الورقة البحثية:
https://academic.oup.com/nar/article/54/19/gkag1002/8971853?login=false
مجموعات البيانات: من التدريب على الجينومات البكتيرية إلى التحقق في بيئات الميتاجينوم المعقدة
خلال تطوير وتقييم BBERT، قام الباحثون بتنظيم وبناء نوعين من مجموعات البيانات.
- النوع الأول مخصص للتدريب المسبق للنموذج، ويتضمن بيانات جينومية من 1416 نوعاً بكتيرياً. لضمان تغطية جيدة لشجرة التطور الحيواني للبكتيريا، تم سحب جينومين عشوائيين من كل فصيلة بكتيرية من قاعدة بيانات RefSeq.
- النوع الثاني مخصص لمعايرة وتقييم النموذج، ويتضمن 899 نوعاً بكتيرياً من 396 جنساً مختلفاً، بالإضافة إلى 1200 نوع حقيقي النواة من 823 جنساً مختلفاً. من الجدير بالذكر أن هاتين المجموعتين منفصلتان تماماً على مستوى الجنس التصنيفي، ولا يوجد أي تداخل بين الأجناس فيهما.
في الوقت نفسه، لبناء مجموعة بيانات جينومات مرجعية مُفلترة تمثّل التنوع الحقيقي للنوى في البيئة الترابية، حدد الباحثون أولاً قائمة الأصناف المستهدفة من خلال مراجعة دراسات الباركود الميكروبي الواسع (Amplicon Metabarcoding) للـ rRNA 18S وITS في المجتمعات الميكروبية الترابية. شملت الدراسات ذات الصلة مشروع الأرض الميكروبيومي (Earth Microbiome Project)، ومسح التربة الأوروبي الشامل LUCAS، والدراسات الاستقصائية للتنوع الحقيقي للنوى والفطريات في التربة العالمية.
من خلال التحليل الشامل للأدبيات المذكورة أعلاه، تم تحديد ثمانية سلالات رئيسية حقيقية النوى تُظهر باستمرار وفرة عالية في المجتمعات الميكروبية الترابية، وهي:
- الكيركوزوا (Cercozoa)
- الهدبيات (Ciliophora)
- الأوميكوتا (Oomycota، مجموعة الهيتروكونتس)
- الغلوميركوتا (Glomeromycota، أي الفطريات الجذرية الشجرية)
- الموكوروكوتا (Mucoromycota)
- الأسكوميكوتا (Ascomycota)
- الديدان الأسطوانية الحرة المعيشة (Free-living Nematoda)
- الأميبوزوا (Amoebozoa)
بالإضافة إلى ذلك، أضافت مجموعة البيانات أيضاً الطحالب الخضراء ذات الصلة بالبيئة الترابية، والأصناف النباتية البرية التي تتوفر لديها بيانات تسلسل جينومي.
ولمراعاة العشوائية المحتملة في عملية تجميع الأنواع، تم تقسيم جميع الإدخالات الجينومية في مجموعتي بيانات المعايرة والتقييم إلى 20 مجموعة متساوية الحجم حسب المستوى التصنيفي للجنس، بحيث تم تقسيم البكتيريا وحقيقيات النوى إلى 20 مجموعة لكل منهما على حدة. داخل كل مجموعة، تم توزيع وفرة الأنواع عشوائياً وفقاً لتوزيع لوغاريتمي طبيعي (Log-normal Distribution). بعد ذلك، تم دمج المجموعات من مجموعتي البيانات بشكل ثنائي لإنشاء 20 مجموعة فرعية مركبة. تمتلك كل مجموعة فرعية تركيبة مستقلة من أجناس البكتيريا وحقيقيات النوى. من بين هذه المجموعات الفرعية العشرين، استُخدمت العشر مجموعات الأولى (مجموعات البيانات 1–10) للدقة الدقيقة للنموذج (Fine-tuning)، بينما خُصصت المجموعات العشر المتبقية (مجموعات البيانات 11–20) لتقييم النموذج.
إطار BBERT: تمكين نماذج اللغة الكبيرة من تعلم السمات البكتيرية من تسلسلات الحمض النووي DNA
BBERT هو نموذج مطور بناءً على معمارية BERT، ويهدف إلى الكشف خارج التوزيع (OOD) لتسلسلات النيوكليوتيدات المشتقة من الجينومات البكتيرية. تكمن الفكرة الأساسية في استخدام التسلسلات البكتيرية فقط أثناء التدريب، لتحديد ما إذا كان التسلسل المُعطى مشتقاً من البكتيريا. لبناء نموذج لغة كبيرة قائم على تسلسلات النيوكليوتيدات وقادر على إجراء الكشف خارج التوزيع للجينومات البكتيرية، اعتمد الباحثون عملية تطوير ثلاثية المراحل:
- التدريب المسبق لمعمارية BERT باستخدام قراءات الجينومات البكتيرية فقط؛
- الدقة الدقيقة (Fine-tuning) لمهمة التصنيف بين بكتيري/غير بكتيري؛
- تقييم أداء النموذج في مهمة تصنيف القراءات البكتيرية ومقارنته بأدوات BERTax و Tiara و REMME.
① التدريب المسبق للنموذج
استخدم التدريب المسبق لـ BBERT مجموعة بيانات بكتيرية تحتوي على تسلسلات نيوكليوتيدية قصيرة اصطناعية تم توليدها عن طريق أخذ العينات، حيث يبلغ طول كل تسلسل 100 زوج أساسي (bp)، ويهدف ذلك إلى محاكاة قراءات تسلسل الميتاجينوم والأخطاء المحتملة في التسلسل. خلال عملية التدريب، اعتمد الباحثون نموذج اللغة المقنّع (Masked Language Model) كهدف تحسين، حيث يتم إخفاء 30% من الرموز (Tokens) في التسلسلات المدخلة، مع تحسين قدرة النموذج على استنتاج هذه الرموز المقنّعة بناءً على السياق. من خلال هذه العملية، يتعلم النموذج تمثيل النيوكليوتيدات المفقودة اعتماداً على المعلومات المتوفرة في القراءات.
استمر تحسين عملية التدريب المسبق على مراحل، كل مرحلة تتكون من 5–10 دورات تدريبية (Epochs)، حتى تحقيق النتائج المثلى، مع حفظ جميع نقاط التفتيش الوسيطة (Checkpoints، أي أوزان النموذج). عادةً، لوحظ انخفاض مستمر في خسارة التدريب بالتزامن مع تحسن متزايد في دقة التصنيف. عندما توقف تقدم التدريب ولم تعد هناك تحسينات ملحوظة في أداء النموذج، تم إنهاء التدريب.
② الدقة الدقيقة للنموذج
بعد ذلك، لتمكين BBERT من تنفيذ مهمة تصنيف القراءات البكتيرية، أضاف الباحثون رأس تصنيف خفيف الوزن (Classification Head) إلى النموذج: طبقة خطية مُضافة فوق تضمينات الرموز (Token Embeddings) الناتجة عن مُرمّز BBERT (Encoder)، تُستخدم للتنبؤ المباشر بما إذا كانت القراءة مشتقة من البكتيريا.
تم تدريب رأس التصنيف باستخدام التعلم الموجّه. خلال التدريب، لم يتم تجميد أوزان نموذج BBERT المدرَّب مسبقاً، بل تم إجراء دقة دقيقة مشتركة للمُرمّز ورأس التصنيف، مما سمح للتمثيلات السماتية التي تعلمها المُرمّز بالتكيف مع مهمة التصنيف الحالية. لتجنب عدم استقرار أوزان التدريب المسبق، تم تعيين معدلات تعلم مختلفة لرأس التصنيف والمُرمّز: معدل تعلم المُرمّز 1×10⁻⁶، ومعدل تعلم رأس التصنيف 1×10⁻⁵، مع استخدام المُحسّن AdamW.
وجدت الدراسة أن استراتيجية تجميد الطبقتين السفليتين من مُرمّز المحول (Transformer) والدقة الدقيقة للطبقات المتبقية كانت فعالة بشكل أفضل. يُخرج النموذج النهائي احتمال أن تكون القراءة مشتقة من البكتيريا، ويُرمز له بـ bact_prob؛ وعندما يكون bact_prob أكبر من 0.5، تُصنف القراءة على أنها مشتقة من البكتيريا.
③ تقييم النموذج والمقارنة
أخيراً، قام الباحثون بإحصاء والإبلاغ عن مؤشرات الأداء التصنيفي الإجمالي للنموذج على مجموعات البيانات، ومقارنة نتائج الاختبار المرجعي مع BERTax و Tiara و REMME.
النتائج: تم التحقق من دقة تصنيف BBERT، والتعليق الوظيفي، وكفاءة التجميع
① أداء BBERT يتفوق على أدوات التصنيف العميقة المتقدمة الحالية
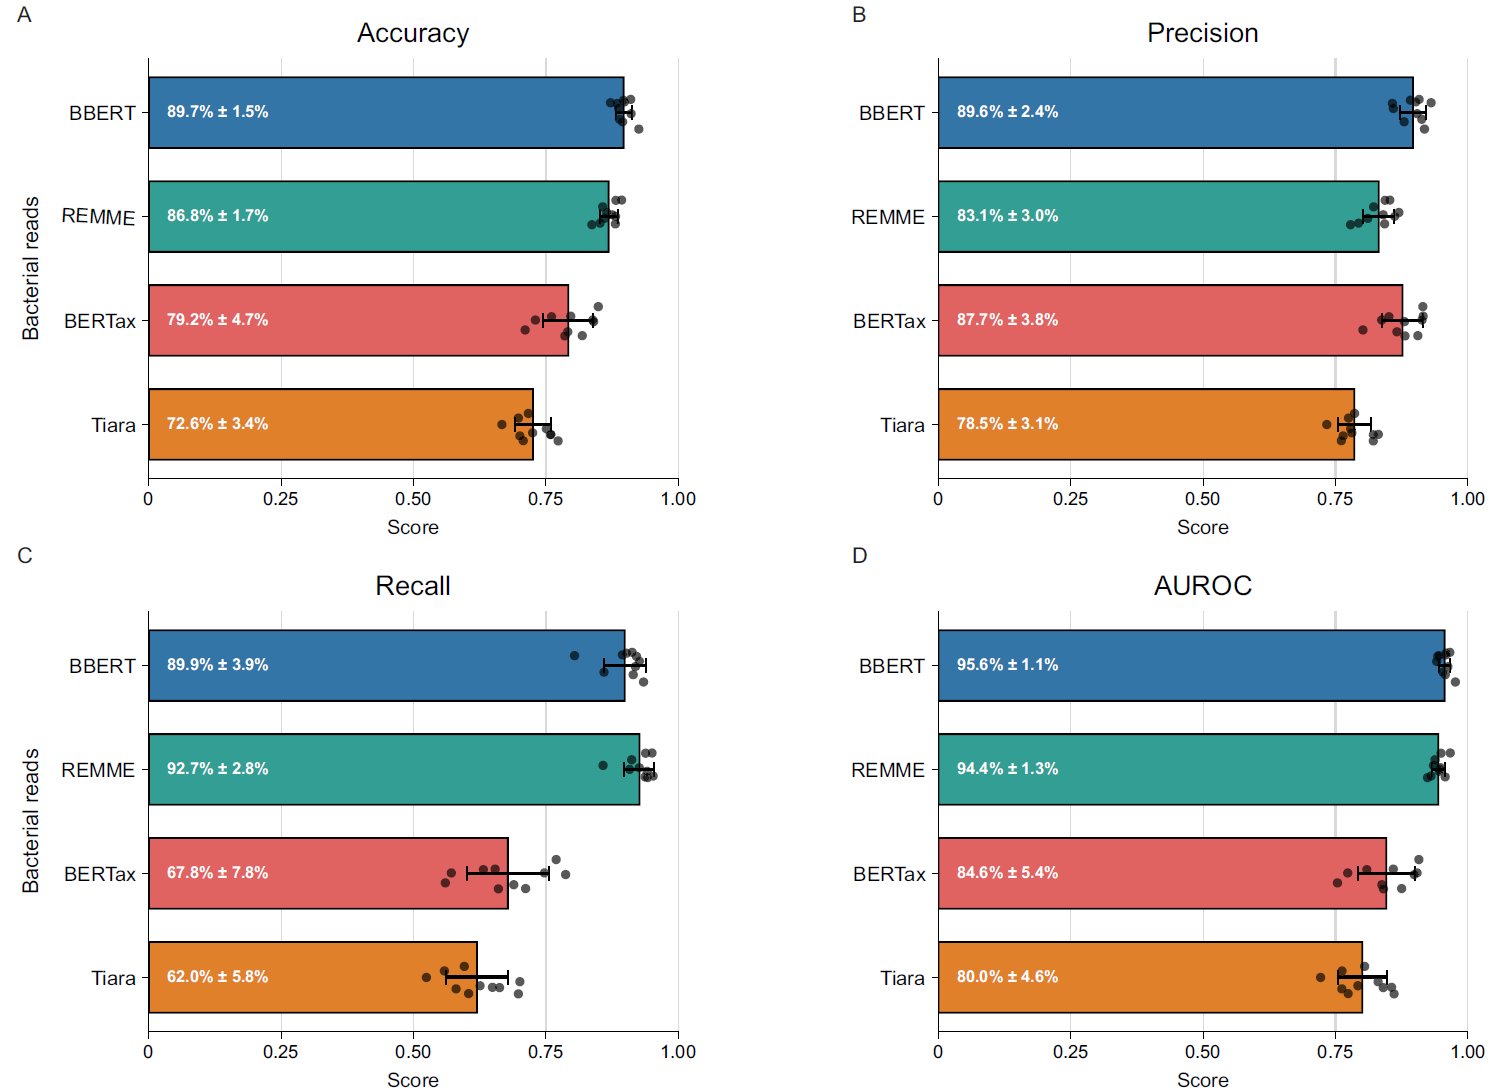
أولاً، في مهمة تصنيف القراءات البكتيرية وغير البكتيرية، أظهر BBERT قدرة قوية على التمييز — كما هو موضح في الشكل أدناه، تفوق أداء BBERT على BERTax و Tiara و REMME المُحسّن في مؤشرات التصنيف القياسية مثل الدقة، والدقة الموجبة (Precision)، وحساسية الاستدعاء (Recall، مماثلة لأداء REMME)، ومنطقة تحت منحنى ROC (AUROC). بلغت متوسط دقة تصنيف المجال لـ BBERT على 10 مجموعات اختبار 89.7% ± 1.7%، بينما كانت 86.8% ± 1.7% لـ REMME، و 79.2% ± 4.7% لـ BERTax، و 72.6% ± 3.4% لـ Tiara.
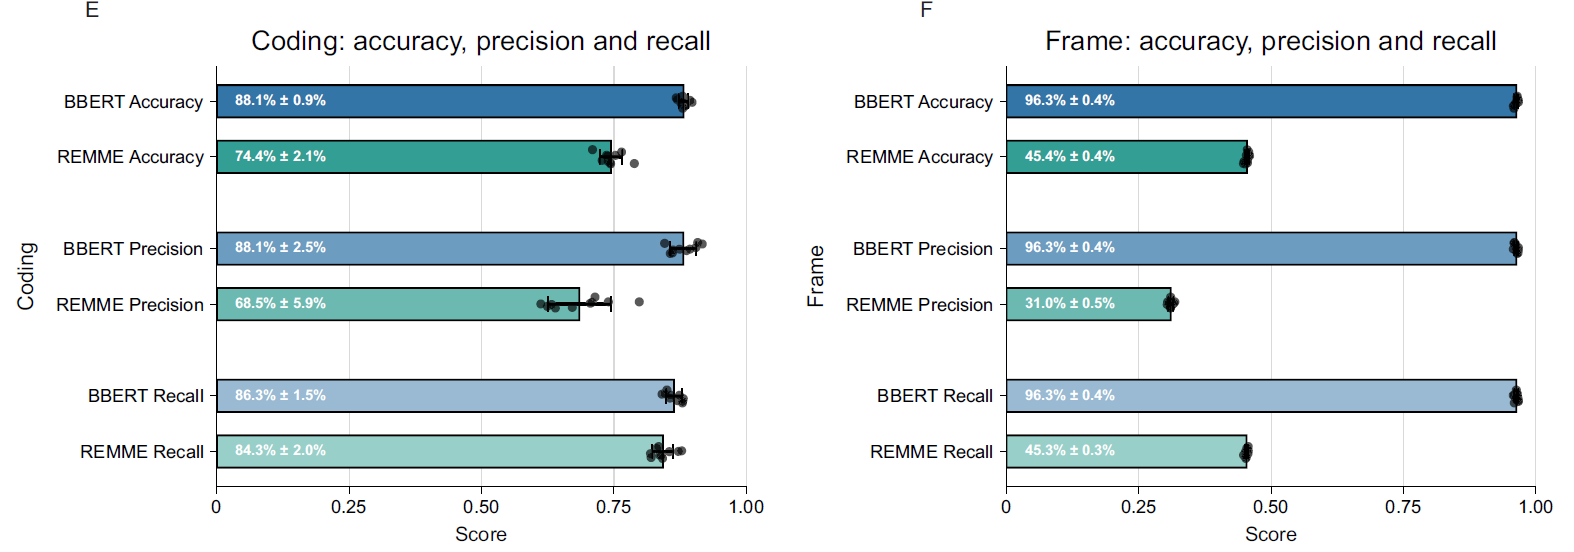
في تحديد التسلسلات المشفرة وأطر القراءة الخاصة بها، تفوق أداء BBERT على REMME، وهي الأداة الوحيدة في فئتها التي تمتلك هذه الوظيفة (الشكل أدناه E، دقة التشفير: 88.1% ± 0.9% لـ BBERT و 74.4% ± 2.1% لـ REMME؛ الشكل أدناه F، دقة إطار القراءة: 96.3% ± 0.3% لـ BBERT و 45.4% ± 0.4% لـ REMME).
من حيث الأداء الحسابي، يُظهر BBERT أيضاً عملية جيدة. يمكن لـ BBERT معالجة 45,912 قراءة في الثانية (reads per second، rps) على عقدة حوسبة مزودة بوحدة معالجة رسومات NVIDIA H200 المخصصة، بينما يحقق BERTax و Tiara 413 rps و 347 rps على التوالي. ومع ذلك، فإن سرعة REMME بعد تحسين الكود تكون أسرع قليلاً، حيث تصل إلى 50,745 rps. عند التشغيل على جهاز كمبيوتر شخصي يعمل بنظام Windows 10 ومزود بوحدة معالجة رسومات NVIDIA RTX 3090، تصل سرعة معالجة BBERT إلى 15,373 rps. وهذا يعني أنه حتى بدون الاعتماد على مجموعات الحوسبة عالية الأداء، يمكن للمستخدمين استخدام BBERT لإجراء التحليلات، وهو أمر يصعب تحقيقه بواسطة معظم الأدوات المماثلة.
② BBERT هو أداة تحديد بكتيري تتمتع بحساسية عالية
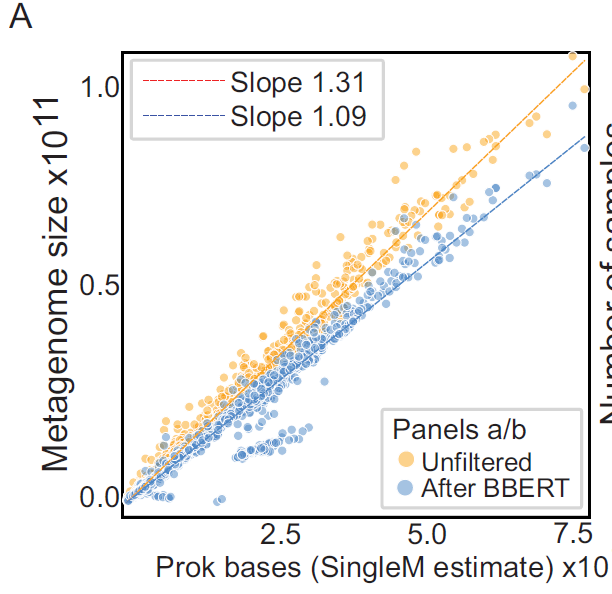
قام الباحثون أيضاً بتطبيق BBERT على 1969 مجموعة بيانات ميتاجينومية تربة عامة منسقة، باستخدام عدد القواعد النووية للكائنات بدوية النواة المقدرة بواسطة SingleM كمرجع، للتحقق بشكل أكبر من أدائه على هذه البيانات الواقعية التي تفتقر إلى التصنيفات الحقيقية. كما هو موضح في الشكل أدناه، في غياب الفلترة، كان العدد الإجمالي للقواعد النووية في بيانات الميتاجينوم أعلى بنسبة 31% من عدد القواعد النووية للكائنات بدوية النواة المقدرة بواسطة SingleM (ميل 1.31±0.01)؛ وبعد الفلترة بواسطة BBERT، تقلص هذا الفارق إلى 9% (ميل 1.09±0.01).
على عكس SingleM، يدعم Kraken2 المقارنة على مستوى القراءة الواحدة، ولذلك أجرى الباحثون أيضاً مقارنة مباشرة بين BBERT و Kraken2. أظهرت النتائج: بالنسبة للقراءات التي حددها Kraken2 بالفعل كمصدر بكتيري، كانت أحكام BBERT متسقة بشكل أساسي معها؛ وفي الوقت نفسه، استطاع BBERT تحديد عدد كبير من القراءات التي لم يتمكن Kraken2 من تصنيفها (كما هو موضح في الشكل أدناه)؛ وفي المقابل، كانت القراءات التي استطاع Kraken2 تحديدها ولم يستطع BBERT تحديدها قليلة جداً.
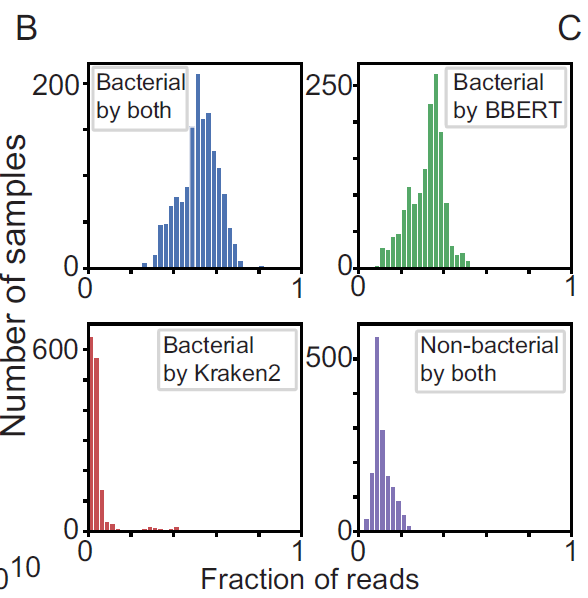
لذلك، يعد BBERT أداة تحديد بكتيري تتمتع بحساسية عالية، فهو قادر على التصنيف على مستوى القراءة مثل Kraken2، دون أن يكون مقيداً بعدم اكتمال تغطية قاعدة البيانات المرجعية.
③ يمكن لـ BBERT ترجمة قراءات الحمض النووي القصيرة مباشرة إلى تسلسلات أحماض أمينية
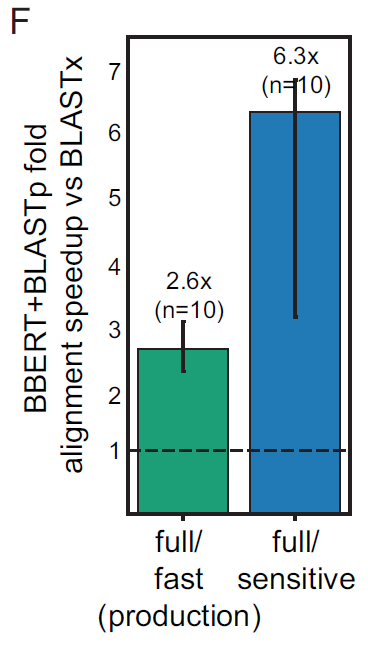
نظراً لأن BBERT قادر على تحديد القراءات المشفرة ذات المصدر البكتيري وأطر قراءتها، فيمكنه أيضاً ترجمة قراءات الميتاجينوم القصيرة مباشرة إلى تسلسلات أحماض أمينية. وجدت الدراسة أن هذه الطريقة توفر نتائج تعليق أساسية متسقة مقارنة بتعليق قراءات الحمض النووي غير المفلترة باستخدام BLASTx، لكنها أسرع في المعالجة: تحسين بحوالي 2.6 مرة في الوضع السريع (fast)، وتحسين بحوالي 6.3 مرة في الوضع الحساس (sensitive) (كما هو موضح في الشكل أدناه). وهذا يعني أن BBERT يمكنه ليس فقط مساعدة الباحثين في فلترة البيانات، بل قد يعمل أيضاً على تحسين تدفق عمل التعليق الوظيفي للميتاجينوم.
④ يسرع BBERT التجميع المبتدأ للميتاجينوم ويقلل من أخطاء التجميع
في جانب تجميع الميتاجينوم، يكون دور BBERT أكثر بديهية. اكتشف فريق البحث أنه في البيانات غير المفلترة، تزيد كميات كبيرة من التسلسلات غير المستهدفة من عبء التجميع وقد تقدم فجوات خاطئة وعدم تطابق. بعد فلترة بيانات الميتاجينوم المحاكية بواسطة BBERT، انخفض متوسط التغطية غير المرجح للجينوم البكتيري من 68.23% إلى 65.22%، بفقدان تغطية يقدر بحوالي 4.4% (كما هو موضح في الشكل أدناه). في الوقت نفسه، انخفض وقت التجميع من 66±8 ساعة إلى 25±2 ساعة، مما يمثل تحسيناً في الكفاءة بحوالي 2.7 مرة.
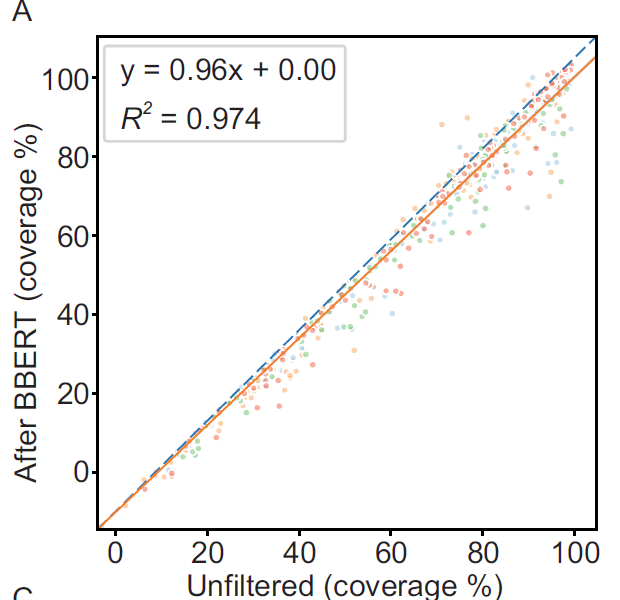
تم تحسين دقة التجميع أيضًا. عند الحساب باستخدام المتوسط غير المرجح لـ 512 مجموعة جينومية، وتطبيع المقاييس المختلفة وفقًا لطول الجينوم المرجعي، لوحظ أن عدد مرات فتح الفجوات لكل 100 زوج قاعدي من التسلسل المرجعي انخفض من 0.51 إلى 0.36، بانخفاض قدره 0.15، أي بنسبة انخفاض نسبية تبلغ 29.3%؛ كما انخفض عدد مرات عدم التطابق من 3.31 إلى 2.64، بانخفاض قدره 0.67، أي بنسبة انخفاض نسبية تبلغ 20.2%. وبشكل إجمالي، انخفضت المقاييس الاثنان معًا بنسبة حوالي 21.4%.
⑤ بيانات الميتاجينوم الحقيقية من عقيدات جذور البقوليات
لتقييم الفوائد المحتملة لفلترة BBERT في مجموعات البيانات الحقيقية، قام الباحثون بتطبيقه بشكل إضافي على بيانات الميتاجينوم لعقيدات جذور النباتات البقولية. انخفض حجم التجميع المشترك بعد فلترة BBERT بنسبة 61%، من 577.6 ميغابايت إلى 222.4 ميغابايت؛ وانخفض عدد القطع المتسلسلة (contigs) بنسبة 57%؛ بينما ارتفع محتوى GC من 40.4% إلى 58.5%.
يتوافق هذا التغيير مع محتوى GC البالغ حوالي 40% في جينومات النباتات البقولية ومحتوى GC البالغ حوالي 62% في جينومات رتبة الريزوبيات (Rhizobiales)، مما يشير إلى أن معظم القراءات التي تمت فلترتها كانت مشتقة من العائل. بالإضافة إلى ذلك، ضاعفت فلترة BBERT قيمة N50 للتجميع، حيث ارتفعت من 0.9 كيلوبايت إلى 1.8 كيلوبايت، وانخفض وقت تشغيل التجميع إلى النصف، كما انخفض استهلاك الذروة للذاكرة من 188 غيغابايت إلى 82 غيغابايت.
الخاتمة
يُظهر BBERT احتمالاً آخر لمعالجة نماذج اللغة الكبيرة لتسلسلات الحمض النووي القصيرة: فحتى في مواجهة قراءات بطول 100 زوج قاعدي تفتقر إلى دعم قواعد البيانات المرجعية، يمكنه إتمام تحديد نطاق التصنيف، والتعرف على الإمكانات الترميزية، والتنبؤ بإطارات القراءة من خلال تعلم خصائص التسلسل نفسه. والأهم من ذلك، أن هذه القدرة لا يمكن استخدامها فقط لتحديد التسلسلات غير المستهدفة في الميتاجينوم، بل يمكنها أيضًا تحسين العمليات اللاحقة مثل التعليق الوظيفي، وتجميع الجينوم، والتجميع الصندوقي (binning).
كما أظهرت الدراسة أن الانحياز في التعرف على العناصر الوراثية القابلة للتنقل (MGEs) وغيرها من التسلسلات الخاصة بواسطة BBERT قد يعكس خصائص تطورية مختلفة بين هذه التسلسلات والجينومات المضيفة. في المستقبل، قد يوفر حساسية نماذج اللغة الكبيرة لأنماط تسلسلات الحمض النووي الفريدة أدوات جديدة لتتبع أحداث الانتقال الجيني الأفقي. ومع التطور المستمر للنماذج ذات الصلة، من المتوقع أن يتوسع نطاق تطبيقها من تصنيف الكائنات الدقيقة إلى مجال أوسع من علم الجينوم البيئي.
المراجع:
https://phys.org/news/2026-10-ai-tool-scientists-bacteria-hidden.html
https://academic.oup.com/nar/article/54/19/gkag1002/8971853?login=false