Command Palette
Search for a command to run...
توليد أكثر من 800 مليون طيف كتلة متوقع لأكثر من 100 مليون جزيء صغير، تقدم جامعة كورنيل نموذج AIMe الذي يدمج القواعد الكيميائية واستنتاج مسارات التفكك وتعلم الشبكات العصبية
في دراسات علم الأيض، يمكن للتصوير الطيفي الكتلي التقاط إشارات ضخمة للجزيئات الصغيرة من العينات البيولوجية المعقدة، لكن اكتشاف الإشارة هو مجرد الخطوة الأولى؛ فالتحدي الحقيقي يكمن في تحديد الجزيء المقابل لها. حاليًا، لا تغطي مكتبات الأطياف المرجعية التجريبية المتاحة للمقارنة سوى أقل من 1٪ من المركبات المعروفة، وبالتالي فإن أكثر من 80٪ من المستقلبات عادةً ما تبقى غير مُعرَّفة في العينات البيولوجية المعقدة النموذجية. وفي الوقت نفسه، يكون الفضاء الهيكلي للجزيئات الصغيرة أكثر تعقيداً بكثير من الحمض النووي الريبوزي المنقوص الأكسجين والبروتينات، فالصيغة الجزيئية الواحدة قد تقابل هياكل مختلفة عديدة جداً، ومن الصعب جداً تغطية هذا الفضاء الكيميائي الشاسع بالاعتماد فقط على التوسيع المستمر لمعايير القياس ومكتبات الأطياف المرجعية.
لمعالجة هذه المشكلة، طور فريق بحثي من جامعة كورنيل إطار عمل ذكاء اصطناعي عصبي-رمزي متعدد الوكلاء يُعرف باسم مستكشف جزيئي الذكي (AIMe)، وهو مخصص لتحليل مطيافية كتلة الجزيئات الصغيرة. يدمج نموذجها الأساسي DeepMS²Reasoner بين قواعد الكيمياء واستنتاج مسارات التكسير وتعلم شبكات الأعصاب، حيث يحاكي عمليات مثل انكسار الروابط الكيميائية ونقل الهيدروجين انطلاقاً من بنية الجزيء ويتنبأ بطيف الكتلة الثانوي (MS²) المقابله. وبذلك يستطيع AIMe تجاوز المطابقة المباشرة التقليدية «مطيافية الكتلة التجريبية – المكتبة المرجعية»، ووضع طيف الكتلة المجهول ضمن مساحة هيكلية أوسع للبحث عن المرشحين ذوي الصلة.
لتعميم هذه القدرة إلى الفضاء المعروف للجزيئات الصغيرة، بنى الفريق أيضاً MS²KOSMOS، حيث تم توليد أكثر من 800 مليون طيف كتل ثانوي متوقع لأكثر من 100 مليون جزيء صغير في قاعدة بيانات PubChem، مما وسّع نطاق البحث في مساحات مطيافية الكتلة بمقدار ثلاثة رتب قدرية تقريباً مقارنة بالمكتبات التجريبية الحالية. بالنسبة لطيف كتلة مجهول واحد، لا يقتصر دور AIMe على إعادة قائمة بالجزيئات المرشحة فحسب، بل يقدم أيضاً المسارات التفصيلية للتكسير ويربط قمم طيف الكتلة المحددة بصيغ وجزيئات شظوية محتملة. بعد ذلك قام الباحثون بتقييم قدرة النظام على تحليل الجزيئات الصغيرة المجهولة وإجراء التعليقات التوضيحية بمستوى قواعد البيانات باستخدام مستقلبات مرتبطة بالميكروبيوم المعوي للفئانات وبيانات مطيافية الكتلة الضخمة من منصة GNPS.
نُشرت النتائج ذات الصلة تحت عنوان "رسم خريطة عالم الجزيئات الصغيرة من أطياف الكتلة باستخدام الذكاء الاصطناعي العصبي الرمزي" على منصة النشر المبكر bioRxiv.
عرض الورقة العلمية:
https://www.biorxiv.org/content/10.64898/2026.08.05.743095v1
الانتقال من مطيافة الكتلة التجريبية إلى فضاء ملياري من الجزيئات الصغيرة
تعتمد بيانات AIMe بشكل رئيسي على ثلاث مهام: تدريب نموذج التنبؤ بأطياف الكتلة، وبناء فضاء قابل للاسترجاع للجزيئات الصغيرة، واختبار قدرة التحليل في العينات الحقيقية.
تشمل بيانات تدريب DeepMS²Reasoner قاعدة بيانات النطاق الثاني لقياس الطيف الكتلي التسلسلي NIST لعام 2020. احتفظ الفريق بأطياف MS² لأيونات البروتنة [M+H]+ وأيونات إزالة البروتون [M-H]-، وقام باستبعاد المركبات المحتوية على معادن والعينات التي تحتوي معلومات هيكلية ناقصة، كما توحد معالجة قمم طيف الكتلة والهياكل الجزيئية. وتم توزيع البيانات بناءً على مفتاح InChHI الكامل بنسبة 80٪ مجموعة تدريب، و10٪ مجموعة تحقق، و10٪ مجموعة اختبار. ولتقليل تأثير تكرار البنى، استبعدت أيضاً أثناء التقييم النهائي أي جزيئات اختبار تمتلك تشابه تامينو (Tanimoto) لبصمة مورغان مع الجزيئات التدريبية تساوي 1.0.
وقد خضع قابلية تعميم النموذج الخارجية للاختبار عبر مجموعتي بيانات مستقلتين هما CASMI 2022 وMassSpecGym ولم تُستخدم أي منهما خلال عملية التدريب. وزادت تجارب الاسترداد الهيكلية من مستوى الصعوبة: لكل طيف كتل تجريبي، إضافة إلى البنية الحقيقية، أُضيف حتى 49 جزيئة من PubChem قريبة الوزن ومتشابهة التركيب كمشتتات. ونظراً لمنطقة CASMI صمم الفريق اختباراً أشد صرامة يشمل جميع المتماكبات الكاملة، فأدرجت كل متماكب PubChem الذي يحمل نفس الصيغة الجزيئية ضمن المرشحين، ليصل إجمالي عدد أطياف الكتلة المرشحة إلى نحو 2.5 مليون طيف.
وبعد اكتمال تدريب النموذج، اتسع مجال الدراسة لتشمل الجزيئات الصغيرة المعروفة الموجودة في PubChem. بالنسبة لأكثر من 105 ملايين مركب عضوي ذي نسبة كتلة/شحنة (m/z) أقل من 1000، تنبأ نظام AIMe بأطياف MS² تحت أنماط التأيين الموجب والسالب بالإضافة إلى أربع مستويات للطاقة التصادمية، مولداً بذلك أكثر من 800 مليون طيف كتل متوقع وتنظيمه داخل MS²KOSMOS لتوفير الأساس لاسترجاع أطياف الكتلة المستقبلية والمجهولة.
يتضمن التطبيق الفعلي استخدام مجموعتين رئيسيتين من البيانات. المجموعة الأولى مشتقة من الميتابولوميكا لعينات براز الفئران الخالية من الجراثيم (GF) والفئران الحاملة لمسببات أمراض محددة كاملة الميكروبات المعوية (SPF)، وقد اختير منها 111 إشارة تعتمد على الميكروبيوم وذات وفرة عالية لكنها لم تتمكن من التعريف بها معايير القياسية أو المكتبات الحالية. أما المجموعة الثانية فتأتي من قاعدة البيانات العامة لأطياف الكتلة GNFS وبعد تصفية حسب حالة الشحن والكتلة الجزيئية وغيرها من الشروط، دخلت 7,144,480 طيف كتل ثانوي توافقياً إلى مرحلة الاسترجاع واسع النطاق.
تعليم النموذج كيفية تكسر الجزيئات
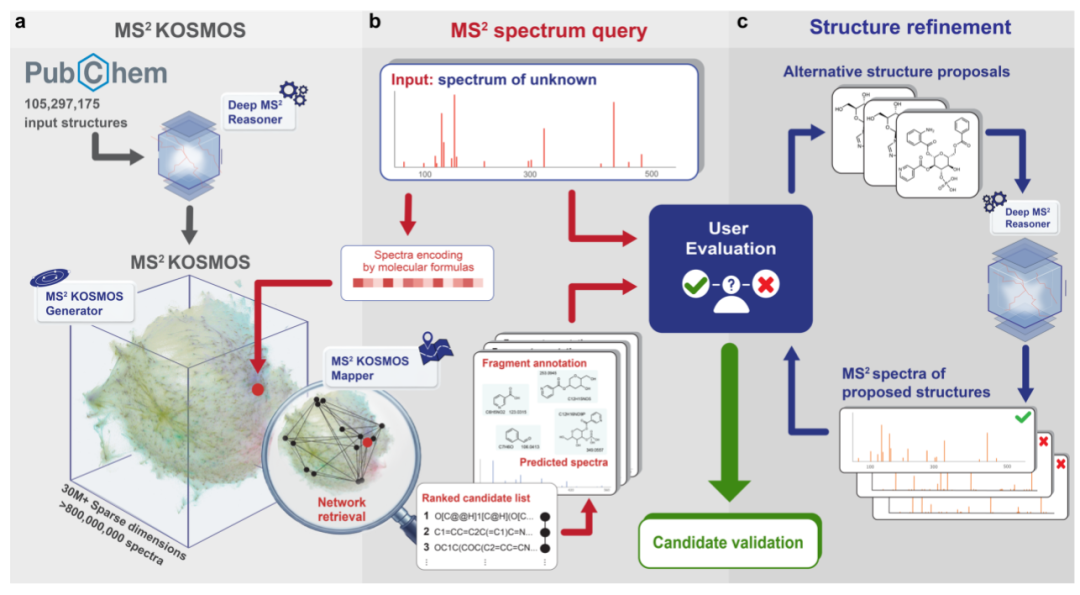
يتكون AIMe من ثلاثة وحدات مترابطة: يتولى DeepMS²Reasoner مهمة التنبؤ بأطياف MS² ومسارات التكسير انطلاقاً من البنية الجزيئية؛ بينما يستدعي MS²KOSMOSGenerator هذا النموذج لإجراء التنبؤات على مجموعات كبيرة من الهياثير الكيميائية وبناء MS²KOSMOS القابلة للبحث؛ ويقوم MS²KOSMOSMapper بمعالجة أطياف الكتلة المجهولة الناتجة عن التجربة والبحث عن الجزيئات المجاورة المحتملة ضمن MS²KOSMOS. وبفضل الانتهاء المسبق من التنبؤات واسعة النطاق، تقتصر العملية الفعلية عند إجراء الاستعلام على حساب أدق للهياثير المرشحة المختارة.
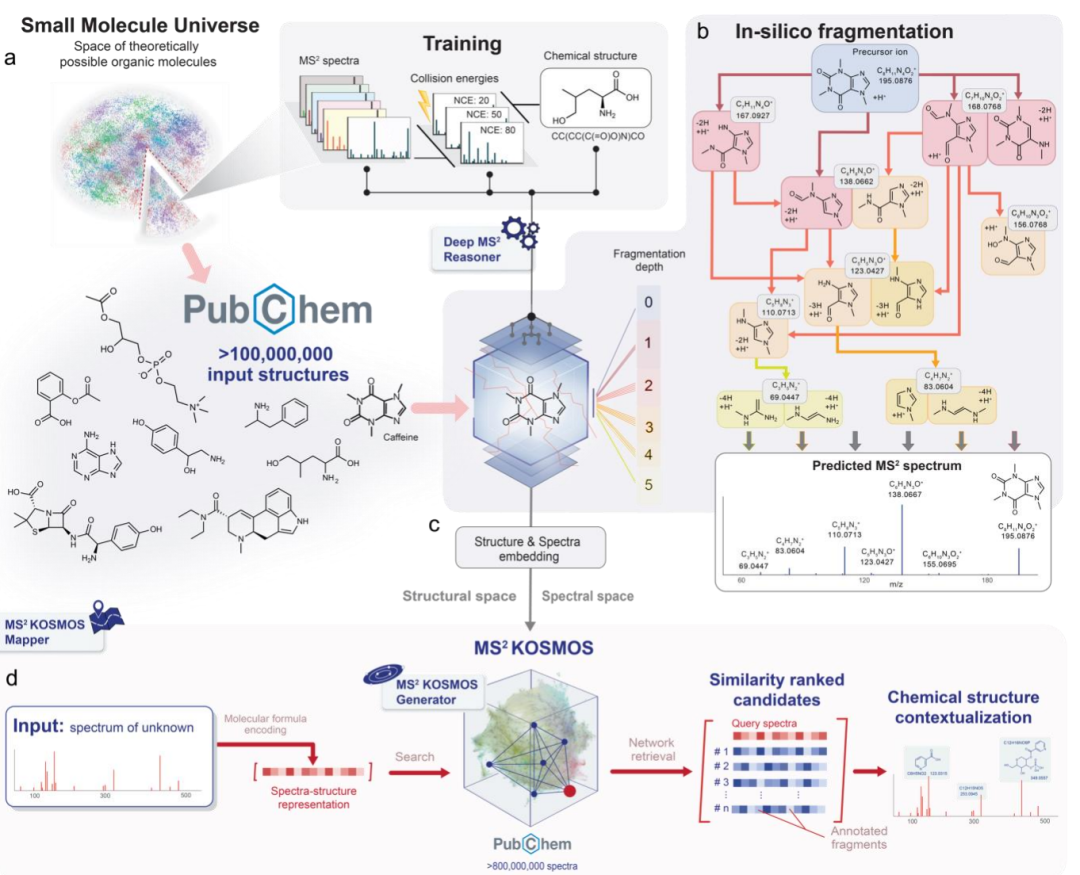
في هذا السياق، يحدد DeepMS²Reasoner قدرة النظام بأكملها على التنبؤ بأطياف الكتلة. فهو لا يتعلم مباشرة «أي قمم تتوافق مع جزيء معين وشدتها»، بل يبدأ من الجزيئ الأم ويحاكي عملية التكسير خطوة بخطوة، ويبني بشكل ديناميكي رسمًا بيانيًا موجهًا بلا حلقات (Directed Acyclic Graph - DAG). تمثل العقد في الرسم البياني شظايا مختلفة، بينما تقابل الحركات الفعلية للتكسير. يأخذ النموذج بعين الاعتبار ثلاثة آليات رئيسية وهي: انقطاع الروابط الخطية، وانقطاع روابط الحلقات، والإزالة؛ كما يسجل تغيرات الشحنة ونقل الهيدروجين. وبما أنه لا يحد مسبقاً من عمق التكسير، فإنه قادر على تمثيل الشظايا المعقدة التي تتطلب كسر روابط متعدد الخطوات، أو فتح الحلقة، أو إعادة التنظيم لتتشكل.
تتم مهمة اختيار مسار التكسير بواسطة مكون الشبكة العصبية المسمى ALEA (مشير تقدير احتمالية الإجراء). يعتمد ALEA على هندسة Graphormer، ويقوم بتعيين الاحتمالات للإجراءات المختلفة للتكسّر ولـ«إيقاف التكسير» بناءً على الذرات والروابط الكيميائية وهياكل الحلقات وحالة الهيدروجين للشظاية الحالية، بالإضافة إلى ظروف التجربة مثل طاقة الاصطدام ونوع الجهاز والأيونات المترابطة (adducts ions). يقوم DeepMS²Reasoner بعد ذلك بنشر هذه الاحتمالات عبر مسار التكسير، ويتم الحصول على شدة قمة الطيف المطابقة من خلال تراكم احتمال الإيقاف النهائي لكل شظية.
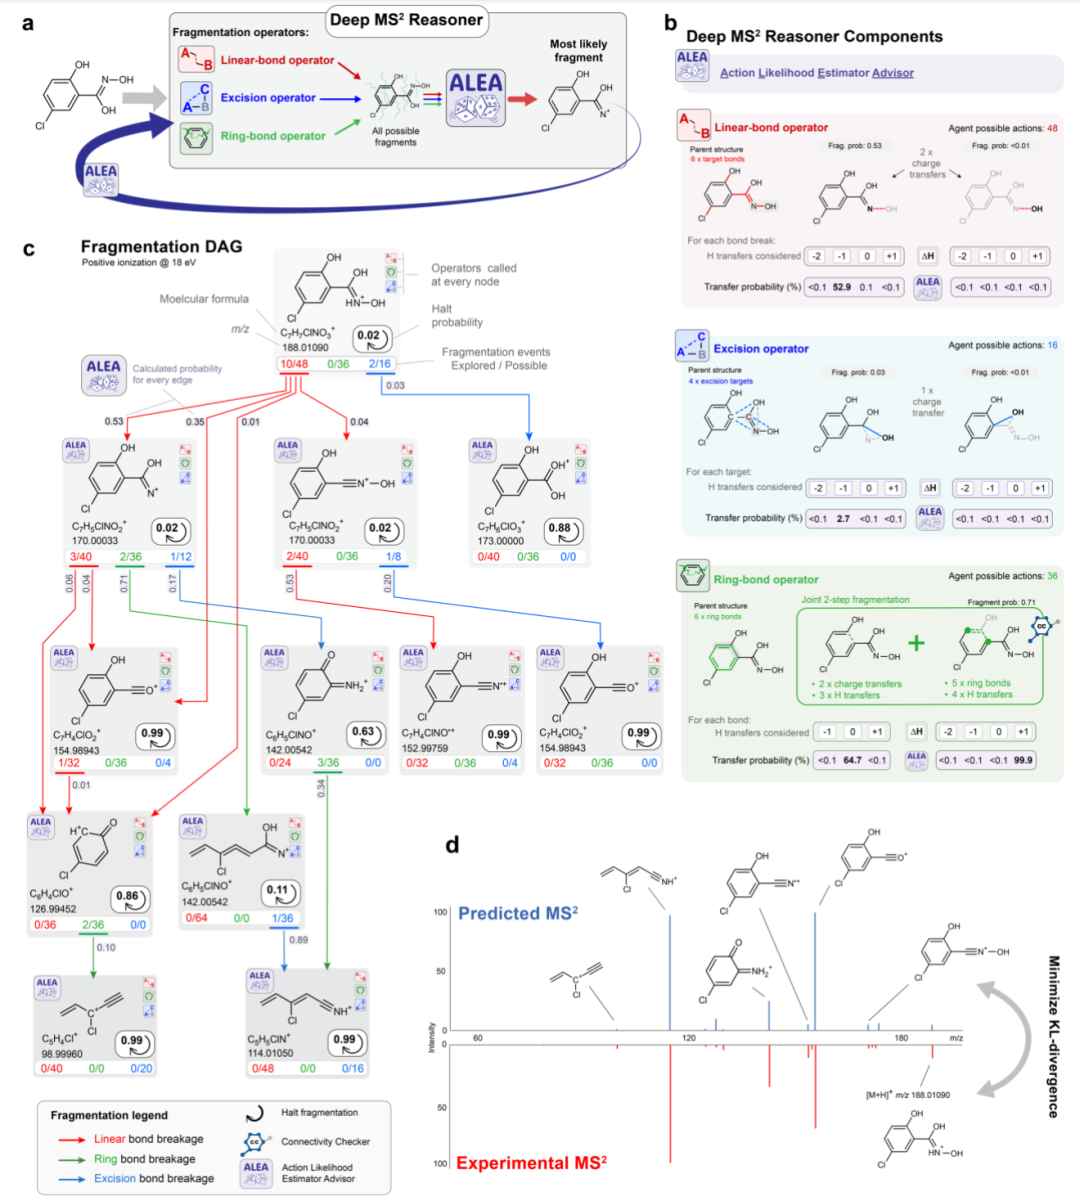
تقوم الشبكة العصبية بتحليل المسارات الأكثر احتمالاً للوقوع، بينما تقوم القواعد الكيميائية بالتحقق مما إذا كانت تلك المسارات ممكنة حدوثاً أم لا. بعد كل خطوة تكسير، يفحص النظام قيود الكيمياء مثل علاقات الاتصال بين الجزيئات وتوازن ذرات الهيدروجين؛ ولا يتم قبول عمليات التكسير غير المنطقية للمرحلة التالية. كما يتم دمج الشظايات المتشابهة هيكلياً وكيميائياً لتقليل البحث المكرر. وفي حال وجود فروع ذات احتمالات منخفضة جداً، لن يستمر النموذج في توسيعها، مما يمنع الحاجة لاستعراض جميع مسارات التكسير المحتملة والتي تزداد بسرعة هائلة مع تعقيد الجزيء.
أثناء التدريب، يكون التركيز الرئيسي لتعلم البارامترات منصباً على نموذج ALEA، حيث تتم باقي عمليات التكشير والتحقق من الجدوى الكيميائية باستخدام قواعد حتمية. يستخدم النموذج تباعد كولباك-لايبلر (KL divergence) لقياس الفرق بين طيف الكتلة المتوقع وطيف الكتلة التجريبي، مع إضافة قيود الانتظام (regularization constraints)، بحيث يعطي أولوية معتدلة لكسر الرابطة الخطية البسيط عندما يمكن تفسير نفس القمة الطيفية عن طريق عدة آليات. كما اعتمد التدريب أسلوب التعلم التدريجي (Curriculum Learning)، بدءاً بجزيئات أصغر ذات مسارات تكسير أبسط، ثم الانتقال تدريجياً لإضافة مركبات أكبر وأكثر تعقيداً، مما يسمح للنموذج بإتقان أنماط التكسير المحلية القابلة للانتقال أولاً.
حلّ DeepMS²Reasoner مشكلة «التنبؤ بالطيف انطلاقاً من الهيكل»، بينما يحل MS²KOSMOS المشكلة الأعمق المتمثلة في «كيف نبحث ضمن مليارات الجزيئات؟». يقوم مولّد MS²KOSMOS Generator بتحويل كل طيف متوقع إلى متجه متناثر (sparse vector) مبني على الصيغ الجزيئية للشظايا، وإنشاء فهرس عكسي (inverted index). وعند مواجهة طيف كتلة مجهول المصدر، لا يحتاج النظام لمقارنة ملايين الجزيئات واحدة تلو الأخرى، بل يجد أولاً المرشحين الذين يشتركون معه في صيغ شظايا معينة، ومن ثم يقوم MS²KOSMOS Mapper بالتنبؤ مجدداً بالأطياف الخاصة بهذه المرشحين وترتيبها وفقاً لشروط تجريبية فعلية مثل طاقة الاصطدام، ويعيد أيضاً تقديم الـ DAG الخاص بالتكسير المقابل لها.
من التنبؤ بالطيف إلى تحليل الجزيئات المجهولة
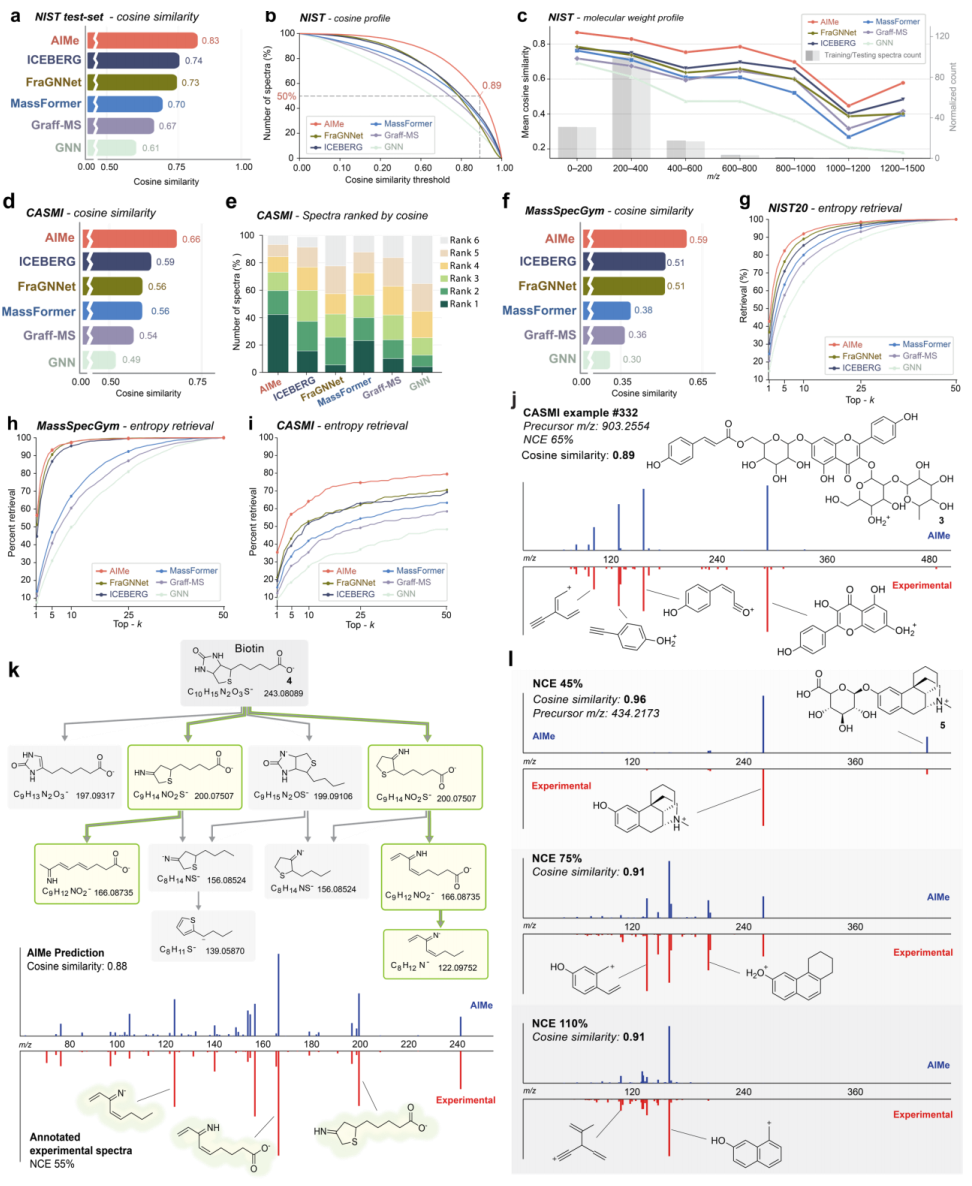
بدأ البحث باختبار أداء DeepMS²Reasoner على مهام أساسية للتنبؤ بأطياف الكتلة. وعلى مجموعة الاختبار المستقلة NIST 2020، بلغ متوسط التشابه الجيبيني (cosine similarity) بين الأطياف المتوقعة والأطياف التجريبية قيمة 0.83، وكانت الوسيط 0.89؛ أما المتوسطات للأطر المرجعية المقارنة فكانت تتراوح ما بين 0.61 و 0.75. وعلى مجموعات بيانات مستقلة تماماً هي CASMI 2022 وMassSpecGym، حقق DeepMS²Reasoner متوسط تشابه جيبي قدره 0.67 و 0.59 على التوالي، وهو الأعلى مقارنة بجميع النماذج المشاركة في التقييم. وخُذ مثالاً CASMI فحسب، ففي أكثر من 40٪ من العينات، قدم DeepMS²Reasoner أطيافاً تنبؤية أقرب نتيجةً للاختبارات التجريبية منها لأي إطار مرجعي آخر.
وبالمقارنة مع مجرد التنبؤ بالطيف، فإن المهمة الأصعب تكون عند محاولة عكس العملية والبحث عن الجزيء الصحيح انطلاقاً من الطيف التجريبي. قام الباحثون بمزج البنية الحقيقية مع عدد كبير من الجزيئات المرشحة القريبة منه وزنياً ومماثلة له تركيبياً لأداء عملية استرجاع المعلومات. وخلال اختبار النظائر الكاملة في CASMI، حققت DeepMS²Reasoner معدلات دقة بلغت 35.6٪ و 64.4٪ و 79.8٪ للمراكز الأولى عشرة والخمسين (Top-1, Top-10, Top-50) على التوالي، وكان كلا المعدلين الأول والثاني أعلى بنسبة تزيد عن عشر نقاط مئوية بالمقارنة مع ثاني أفضل نموذج هو FraGNNet.
كما تم التحقق من قدرة النموذج على معالجة التكسير متعدد الخطوات من خلال دراسة حالات محددة للجزيئات. خذ فيتامين Biotin كمثال، فقد وصل التشابه الجيبيني بين الطيف الذي تنبأ به DeepMS²Reasoneer والطيف الحقيقي إلى 0.88. بعض الشظايا الرئيسية لا يمكن تكوينها بانقطاع رابطة واحد فقط، بل تحتاج إلى سلسلة من العمليات تشمل إزالة المجموعات الوظيفية، وفتح الحلقة، ومتابعة التكسير. وقد استطاع النموذج توفير المسارات متعددة الخطوات المرتبطة بكل شظية، والتنبؤ بدرجات متفاوتة من التكسير تبعاً لتغير طاقة الاصطدام.
أداء DeepMS²Reasoner في التنبؤ بأطياف الكتلة
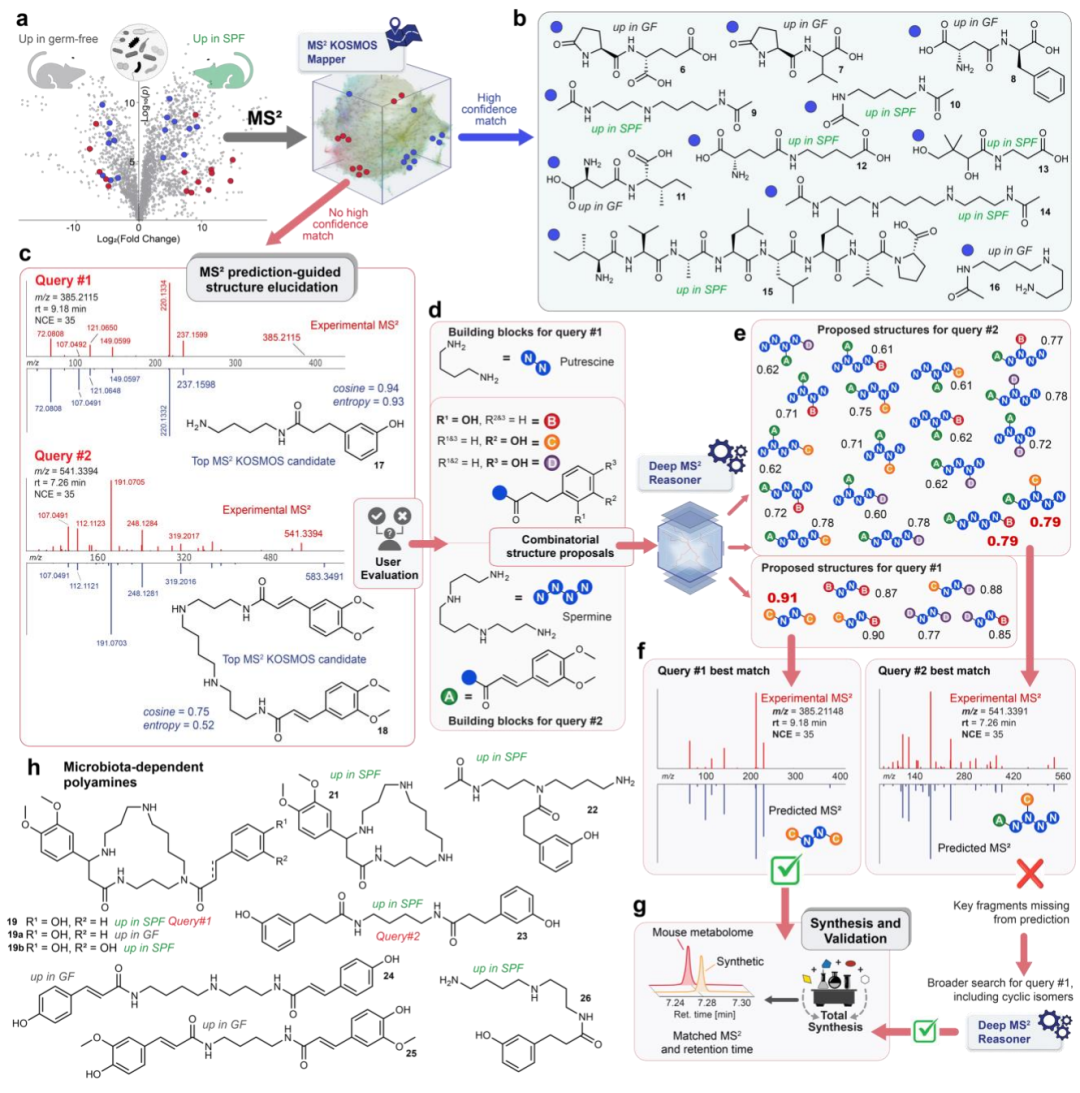
بعد ذلك، استخدم فريق البحث أداة AIMe لتحليل مستقلبات حقيقية مجهولة الهوية. فيما يخص الإشارة المعتمدة على المجتمعات الدقيقة والمشتقة من أيض الفئران وغير المحددة لدى 111 عينة، وجد نحو ثلثها تطابقاً عالي المشابهة مع مركبات معلومة داخل قاعدة البيانات MS²KOSMOS، بينما تشير النتائج الباقية بقوة إلى أنها قد تمتلك هياكل جديدة لم تُوصف سابقاً.
قام الباحثون باختيار مركبين مجهولين إضافيين لتحديد بنيتهما. بناءً على البنى الجزئية التي قدمها AIMe، قاموا بدمج عدة مرشحين محتملين للجزيئات، ثم تنبأوا بأطياف MS² لهذه المرشحين وقارنوها بالنتائج التجريبية. بلغت دقة التشابه الجيبيني لأفضل مرشح أولي لإحدى المواد المجهولة 0.79، لكنها كانت لا تزال تفتقر إلى بعض الشظايا الرئيسية الموجودة في النتائج التجريبية. لذلك، واصل الفريق البحثي النظر في الهياكل الحلقية وحدد مشتقاً نادراً من السبيرمين كبير الحلقة. وتم التحقق نهائياً من كلا الهيئتين المترشحتين من خلال الاصطناع الكيميائي ومقارنة أوقات الاحتفاظ وأطياف MS²، بما في ذلك هيكلاً متعدد الأمينات لم يُبلغ عنه سابقاً في الفئران أو البشر. أظهرت عمليات الاسترجاع الإضافية أن العديد من المستقلبات ذات الصلة موجودة أيضاً في العينات البشرية.
في الختام، وسع البحث تطبيق AIMe ليشمل أكثر من 7.14 مليون طيف كتلي إجماعي في قاعدة بيانات GNPS. باستخدام عتبة تشابه جيبيني تبلغ 0.7، حصل حوالي 2.69 مليون طيف كتلي على تعليقات توضيحية كمرشحين، مما يمثل ثلث إجمالي عدد الطلبات تقريباً؛ وبعد رفع العتبة إلى 0.8، أُضيف ما يقارب 1.27 مليون تعليق توضيحي عالي الدقة إضافية، وهو ما يتوافق مع أكثر من 26 مليون طيف كتلي خام بدون تعليقات سابقة في GNPS. وهكذا، توسع نطاق استخدام AIMe بشكل أكبر من التنبؤ بطيف الكتلة لجزيء واحد ليصل إلى مستوى التعليق التوضيحي للمركبات المجهولة بحجم قواعد البيانات.
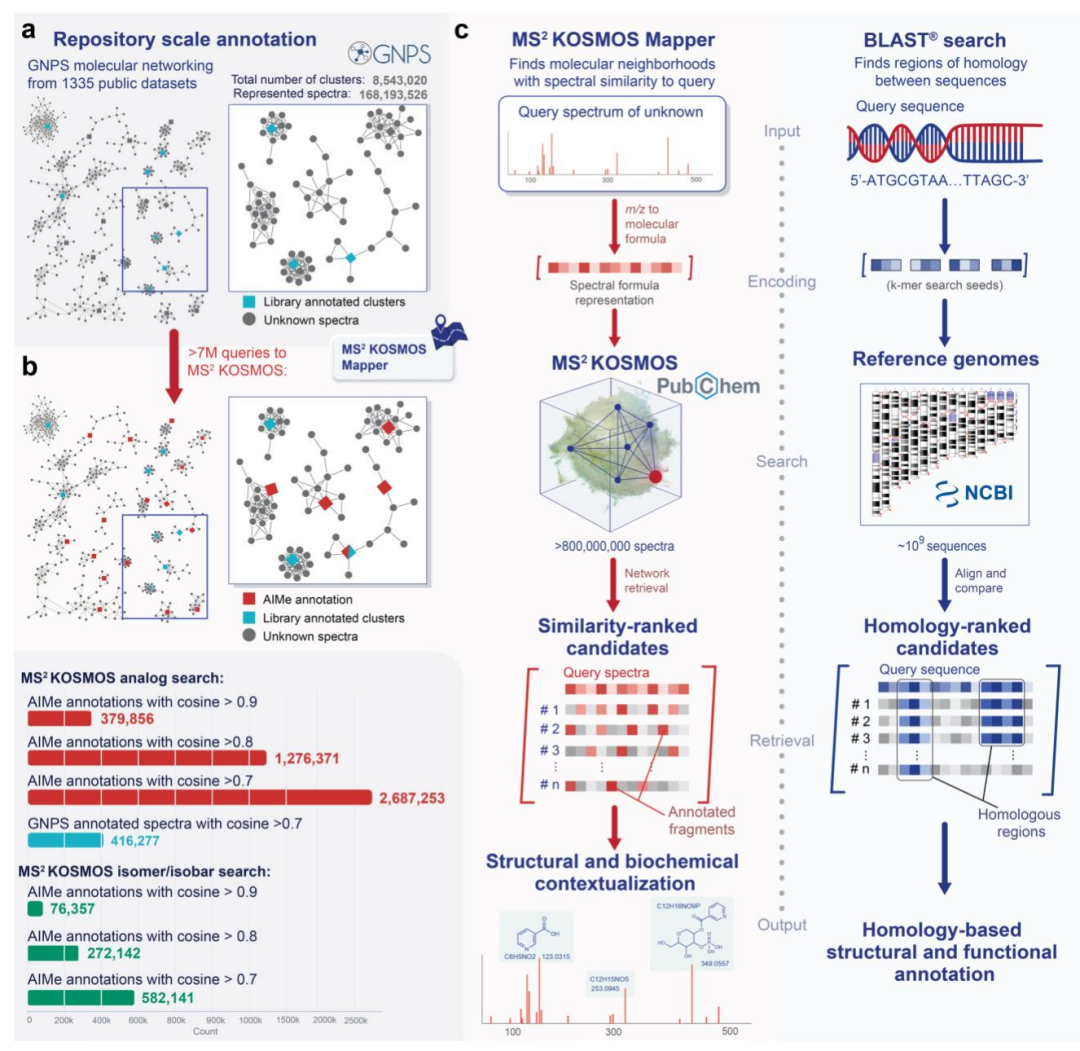 *نتائج التعليقات التوضيحية واسعة النطاق لـ AIMe على قاعدة بيانات GNPS*
لا تعني هذه النتائج أن تحديد تركيب الجزيئات الصغيرة قد أصبح مؤتمتة بالكامل ومع ذلك، كلما زاد الوزن الجزيئي، زادت مسارات التكسير المحتملة بشكل ملحوظ، وفي حين أن تغطية الجزيئات الكبيرة في بيانات التدريب تبقى غير كافية نسبياً، فإن أداء DeepMS²Reasoner في التنبؤ سيستمر في الانخفاض. والأهم من ذلك، إن طيف MS² نفسه غالباً ما يكون غير كافٍ لإجراء تأكيد نهائي للبنية. وفقاً لمعايير علم الأيضيات، عند غياب أدلة مستقلة مثل وقت الاحتفاظ، مطيافية الرنين المغناطيسي النووي (NMR)، أو عينات قياسية، تنتمي نتائج AIMe المقدمة أساساً إلى المستوى الثالث للتعليقات التوضيحية، ويكون دورها أقرب إلى تقليص نطاق المرشحين، وطرح فرضيات بنائية وتفسير أسس التكسير، بينما يبقى التأكيد النهائي بحاجة إلى تحقق تجريبي.
خاتمة
إن أهمية AIMe ليست فقط في تحسين دقة التنبؤ بالطيف الكتلوي، بل تحاول تغيير طريقة تحليل المركبات العضوية الصغيرة المجهولة. في الماضي، كان أمام الباحثين، عندما يواجهون طيف كتلة مجهولاً، خيار محدود يتمثل في البحث عن تطابق مباشر ضمن مكتبة تجريبية محدودة الحجم؛ أما AIMe فإنه يستخدم النموذج أولاً لتحويل فضاء الجزيئات العضوية الصغيرة المعروفة إلى فضاء يمكن بحثه للطيف الكتلي المتنبأ به، ومن ثم يضيّق تدريجيًا دائرة المرشحين اعتماداً على البنية الجزئية ومسارات التكسير. وعلى الرغم من أنه لا يزال عاجزاً عن استبدال الأدلة التجريبية مثل العينات القياسية و NMR ، إلا أنه وفر إمكانية تتبع المزيد من الإشارات التي كانت صعبة التحليل بسبب «عدم وجود طيف مرجعي».
بالنسبة لعلم الأيضيات، ربما تكون هذه النقطة أهم مجرد إضافة مجموعة جديدة من إدخالات المكتبة: فالأطياف الكتلية المجهولة لم تعد تنتهي بنتيجتي «مطابقة» أو «عدم المطابقة»، بل بدأت تصبح نقطة انطلاق لطرح وفحص الفرضيات البنائية.