Command Palette
Search for a command to run...
제한된 쿼리 예산에서 로봇 기억을 더 신뢰성 있게 만드는 법? MIT, 시공간 기억에 불확실성 평가를 도입한 UQ-DAAAM 제시
로봇이 짧은 시간의 단일 작업에서 개방된 환경의 장시간 자율 조작으로 점차 진화함에 따라, 내비게이션, 물체 검색, 시공간 질의응답과 같은 작업을 지원하기 위해 시간과 관점을 넘어 물체와 그 공간적 관계를 저장할 수 있는 장기 기억을 구축해야 한다.
최근 시각-언어 모델(VLM) 기반 장면 설명은 로봇의 의미 기억 구축에 새로운 경로를 제시했지만, VLM 출력에는 노이즈가 존재하며 관측 관점에 따라 의미 불일치가 발생할 수 있다. 물체가 멀리 떨어져 있거나 시야가 가려지거나 복잡한 조도 환경에 있으면, VLM은 매우 확신에 찬 것처럼 보이지만 실제로는 물체 속성을 잘못 설명한 텍스트를 생성할 수 있다. DAAAM과 같은 기억 시스템을 예로 들면, 선택된 관점의 품질이 낮을 경우 최종 기억 항목에 잘못된 정보가 포함될 수 있으며 시스템은 이를 감지하지 못한다.
이러한 과제에 대응하기 위해 MIT 연구팀은 불확실성 점수를 첨단 공간 의미 기억 시스템에 도입하였으며, 이를 UQ-DAAAM으로 명명했다. 고정된 쿼리 예산 제약 하에서 UQ-DAAAM은 이 점수를 활용하여 불확실성이 높은 대상을 능동적으로 최적화한다. 고품질 관점을 선별해 새로운 설명을 획득하고, 다중 관점에서 생성된 설명을 융합하여 통합된 대상 설명을 형성한다. 실험 결과는 불확실성 정량화가 임베디드 인텔리전스 4D 기억 시스템의 신뢰성과 유효성을 향상시킬 수 있음을 보여준다. OC-NaVQA 벤치마크에서 UQ-DAAAM은 기준 방법과 비교하여 불확실성을 현저히 낮추고 더 나은 시공간 질의응답 성능을 달성한다.
관련 연구 성과는 「Remember with Confidence: Uncertainty Quantification for Spatio-temporal Memory with Probabilistic Guarantees」라는 제목으로 NeurIPS에 게재될 예정이다.
연구 하이라이트:
- 대상 수준 불확실성 점수화 방법 제시: 다중 관점 이미지 설명에 대해 대상 수준의 의미 불확실성 측정 지표를 구축함
- 예산 제약 하의 능동적 최적화 및 융합 전략 제시: 추가 VLM 쿼리 예산이 제한된 상황에서 불확실성이 높은 대상을 우선적으로 최적화하고 다중 관점 설명을 융합함.
- 관점 선택 전략에 대한 확률적 보장 제공: 이론적으로 DAAAM 관점 품질 평가 방법과 단일 단계 불확실성 감소 사이의 연결을 구축하고, 이에 상응하는 폐형 갱신 공식을 유도함.
논문 주소:
https://arxiv.org/pdf/2606.08277
데이터 전처리, 장면 재구성, 분할 및 추적
데이터셋 및 전처리
연구자들은 UQ-DAAAM의 시공간 질의응답 작업 성능을 CODa 야외 주행 데이터셋에서 평가했다. 이 데이터셋은 30 Hz 스테레오 이미지, LiDAR(라이다) 프로젝션으로 생성된 깊이 맵, 그리고 전역적으로 일관된 포즈 정보를 제공한다.
모든 실험에서는 전방 카메라(cam0)로 수집된 이미지를 사용했으며, 이미지 중앙 크롭과 크기 조정을 수행해 최종 해상도를 480×640 픽셀로 맞췄다. 깊이 데이터는 3D 원시 추정 LiDAR 프로젝션에서 얻었으며, 필터링을 거쳐 깊이 범위가 [0.05, 20.0] m인 데이터만 유지했다. 비디오 프레임은 센서 데이터 발행 빈도와 일치하도록 10 Hz 빈도로 처리된다.
장면 재구성
연구자들은 Khronos를 사용해 실시간 3D 장면 그래프를 구축했다. TSDF(절단 부호 거리장)의 복셀 크기는 0.2 m, 절단 거리는 0.6 m로 설정했다.
물체 조각(Object Fragments) 추출 매개변수는 다음과 같다: 최소 부피는 0.005 m³, 최대 부피는 50 m³; 각 물체 조각은 최소 8회 관측을 확보해야 하며, 분할 신뢰도는 0.5 미만이면 안 된다.
통행 가능 영역(Traversability Places)의 폭은 0.4~2.0 m 범위로 설정했으며, 동시에 지면 평면에 대한 라벨 프로젝션 기능을 활성화했다.
분할 및 추적
연구자들은 FastSAM을 사용해 개방 어휘 인스턴스 분할을 수행했으며, 이를 TensorRT 엔진으로 컴파일했다. 입력 이미지 해상도는 480×640 픽셀이고, 분할 마스크의 최소 면적은 400 픽셀로 설정했다.
물체 추적에는 ByteTrack을 사용했으며, CLIP 기반 외관 재식별(ReID) 모델을 통해 외관 특징 매칭을 실현했고, 해당 모델 역시 TensorRT 엔진에 배포되었다. 추적 매개변수 측면에서 새 궤적(new track)의 신뢰도 임계값은 0.6으로 설정했고, 궤적 버퍼(track buffer) 길이는 30 프레임으로 설정했다. 물체 궤적은 최소 8회 관측을 누적해야 의미 라벨링 단계로 진입할 수 있다.
UQ-DAAAM 프레임워크: 불확실성 인식에서 능동적 관측 및 의미 융합까지
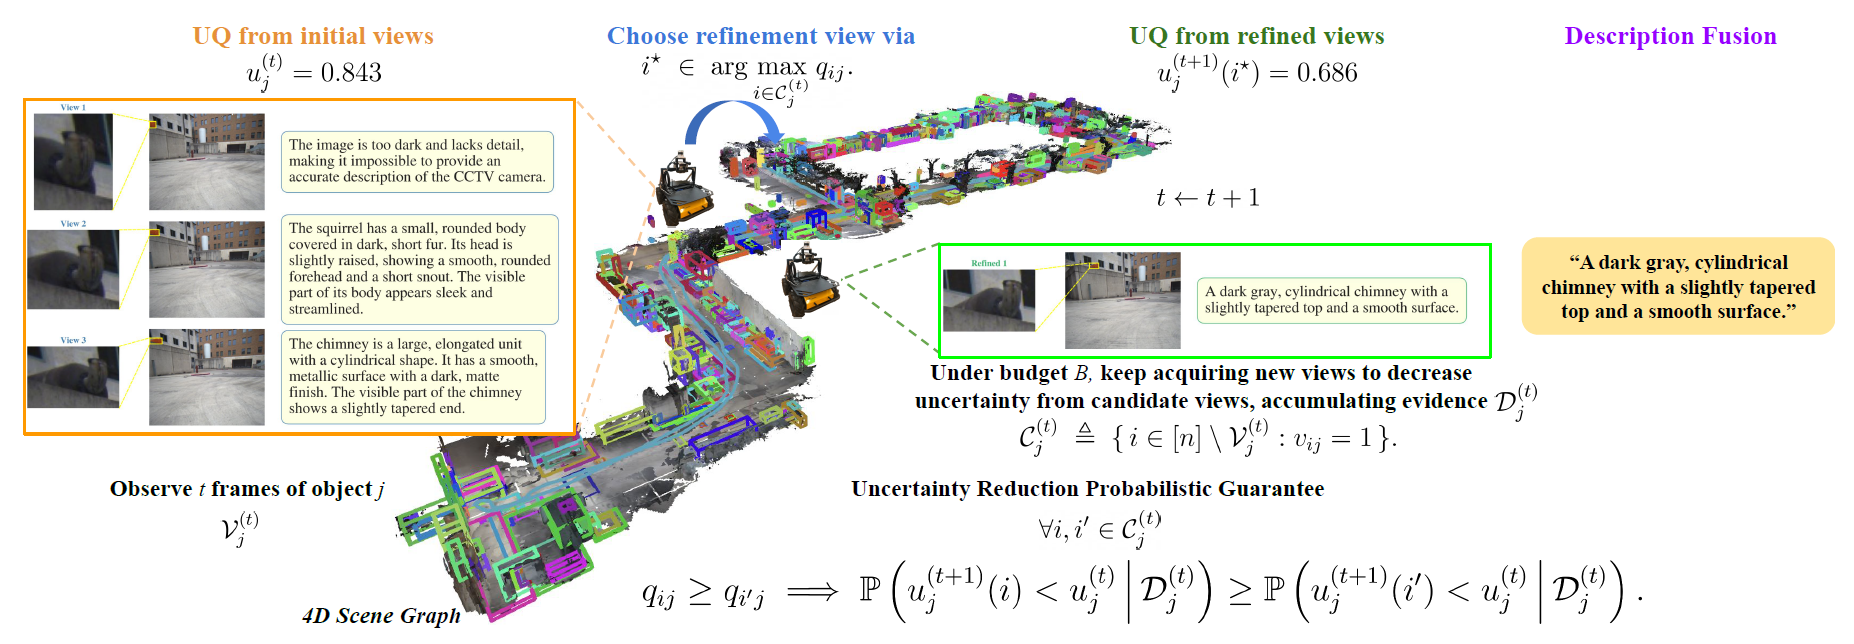
본 연구는 DAAAM 위에 구축되었으며, DAAAM은 RGB-D 데이터 스트림으로부터 실시간으로 4D 장면 그래프를 구축할 수 있다. 아래 그림은 UQ-DAAAM 전체 프레임워크를 보여주며, 구축 과정은 불확실성 정량화, 능동적 관점 선택, 다중 관점 설명 집계라는 세 가지 주요 단계로 구성된다:
① 불확실성 정량화(Uncertainty Quantification)
물체 중심의 의미 불확실성을 정량화하기 위해, 연구자들은 부피 기반 의미 측정(Volumetric Semantic Measurement) 방법을 DAAAM의 다중 관점 로봇 기억 구축 시나리오에 도입했습니다.
본 연구 시나리오에서는 각 물체를 여러 선택된 관점에서 관측하며, 각 관점에 대해 VLM이 자연어 설명을 하나씩 생성합니다. 서로 다른 관점에서 생성된 설명들이 의미적으로 일치하지 않거나, 개별 설명 자체의 내부 일관성이 낮을 경우 시스템의 불확실성은 이에 따라 증가해야 합니다. 따라서 본 연구의 계산 방법은 두 가지 측면을 종합적으로 고려합니다: 관점 간 의미 산포도(Cross-view Semantic Scatter)와 단일 관점 설명의 비일관성(Per-view Incoherence).
서로 다른 관점의 설명들이 의미 방향에서 차이가 클수록, 또는 개별 설명 자체가 더 비일관적일수록 계산된 불확실성은 일반적으로 더 높아집니다. 따라서 시스템은 더 이상 특정 하나의 설명의 신뢰도에만 의존하지 않고, 다중 관점 정보 간 일관성과 개별 설명 자체의 신뢰성을 종합적으로 평가합니다.
① 능동적 관점 선택 (Active View Selection)
초기 불확실성 평가가 완료된 후, 시스템은 물체 수준 불확실성을 미리 설정된 임계값과 비교합니다. 특정 물체의 불확실성이 임계값보다 높으면, 현재 기억에 저장된 의미 해석에 여전히 상당한 모호성이 존재함을 의미하며 추가 관측 증거를 확보할 필요가 있습니다. 이때 시스템은 모든 물체에 추가 쿼리 예산을 균등하게 배분하지 않고, 불확실성이 더 높은 물체를 우선적으로 처리합니다.
이론적으로 추가 관점 선택은 베이지안 최적 실험 설계(BOED) 문제로 모델링할 수 있습니다. 각 후보 관점은 하나의 실험에 해당하고, 물체의 잠재적 의미 상태는 추론 대상이며, 새로운 관점에서 시각 언어 모델이 생성한 설명은 실험 결과에 해당합니다. 이상적인 경우 시스템은 기대 불확실성을 최대한 낮출 수 있는 관점을 선택해야 합니다.
② 다중 관점 설명 집계 (Multi-view Descriptions Aggregation)
불확실성에 기반한 관점 선택이 완료되면, 각 물체는 서로 다른 관점에서 얻은 텍스트 설명 집합과 연결됩니다. 연구자들은 제약이 있는 대규모 언어 모델(LLM) 기반 집계 단계를 통해 이러한 설명들을 하나의 통합된 물체 설명으로 융합합니다. 구체적으로 시스템은 설명의 획득 단계에 따라 순서를 정렬하며, 즉 초기 관점에서 생성된 설명은 앞에, 능동적 최적화 단계에서 획득된 설명은 뒤에 배치합니다. 서로 다른 설명 간 충돌을 처리할 때는 LLM에게 나중에 획득된 설명(즉, 최적화 단계에서 생성된 설명)을 우선적으로 채택하도록 지시합니다.
차이가 초기 관점의 설명들 사이에만 존재하는 경우, 융합된 설명은 모호성을 지나치게 빨리 제거하지 않고 신중한 표현으로 다양한 가능성을 유지합니다. 또한 연구는 LLM에 추가 제약을 부과했습니다: 융합 결과는 최소한 하나의 원본 설명에 이미 포함된 정보만 사용해야 하며, 이는 모델이 환각 정보를 생성하는 것을 방지하기 위한 것입니다.
UQ-DAAAM은 더 나은 시공간 질의응답 성능을 달성할 수 있음
연구는 다운스트림 시공간 질의응답 성능, 불확실성 감소 효과, 모듈 어블레이션, 실행 효율성 등 여러 측면에서 UQ-DAAAM을 평가했습니다.
① OC-NaVQA 태스크 평가
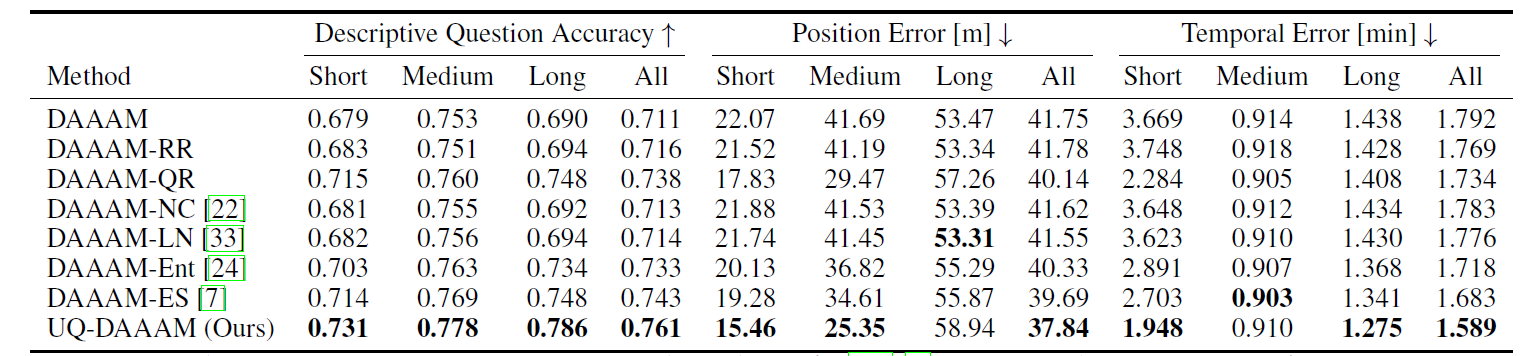
OC-NaVQA 태스크에서 연구는 UQ-DAAAM을 원본 DAAAM 및 다양한 능동적 최적화·불확실성 정량화 기준선과 비교했습니다. 이 중 DAAAM-RR은 추가 관점 쿼리 예산을 무작위 방식으로 배분하고, DAAAM-QR은 원본 관점 품질 점수에 따라 예산을 품질이 낮은 물체에 배분합니다. 또한 인접성 일관성, 다음 토큰 로그 우도, 엔트로피, 증거 점수 등 다양한 불확실성 신호를 기반으로 구축된 방법들도 비교했습니다.
아래 표의 결과에 따르면, UQ-DAAAM은 세 가지 평가 지표 모두에서 다른 기준선 방법보다 우수하며, 특히 질문 정확도와 위치 오차에서 가장 현저한 향상을 달성했습니다. 이는 불확실성 인식을 기반으로 한 능동적 최적화가 고정된 의미 쿼리 예산을 더 효과적으로 배분하여 기억 품질을 향상시킬 수 있음을 시사합니다.
② 불확실성 감소 효과 (Uncertainty Reduction) 평가
다운스트림 태스크의 성능 외에도 연구는 능동적 최적화가 그 직접적인 목표, 즉 물체 수준 의미 불확실성을 낮추는 것을 달성했는지를 직접 평가했습니다. 연구에서 사용한 주요 평가 지표는 불확실성 감소율(URR)이며, 그 정의는 다음과 같습니다: 초기 단계에서 불확실하다고 판정된 후 능동적 최적화 이후 불확실성이 임계값 이하로 내려간 물체의 수를 초기 불확실 물체 총수로 나눈 비율.
아래 그림의 불확실성 감소 결과는 불확실성에 기반하지 않은 두 가지 능동적 최적화 기준선과 비교할 때 UQ-DAAAM이 뚜렷한 우위를 가짐을 보여줍니다. 능동적 최적화 예산이 (B=2)로 고정되었을 때, UQ-DAAAM의 URR은 92.3%에 도달합니다. 관점 품질 기반 최적화 방법(DAAAM-QR)은 34.2%이고, 무작위 최적화 방법(DAAAM-RR)은 5.6%에 불과합니다. 또한 UQ-DAAAM은 능동적 최적화 이후 불확실성 분포를 왼쪽으로 뚜렷하게 이동시켰는데, 이는 이 방법이 더 많은 물체에서 더 큰 폭으로, 더 안정적으로 불확실성을 감소시킬 수 있음을 나타냅니다.
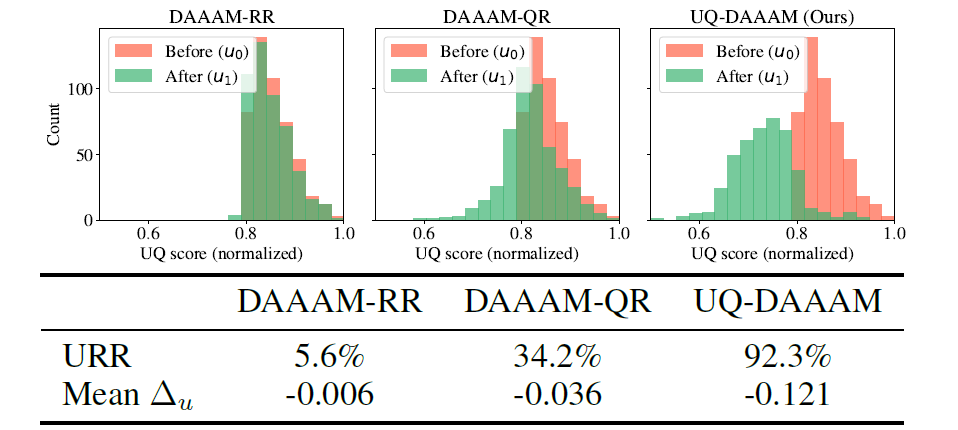
이러한 결과는 본 논문에서 제안한 불확실성 인식 능동적 최적화 방법이 현저히 더 높은 최적화 효율을 가짐을 나타냅니다.
① Ablation 실험(Ablations)
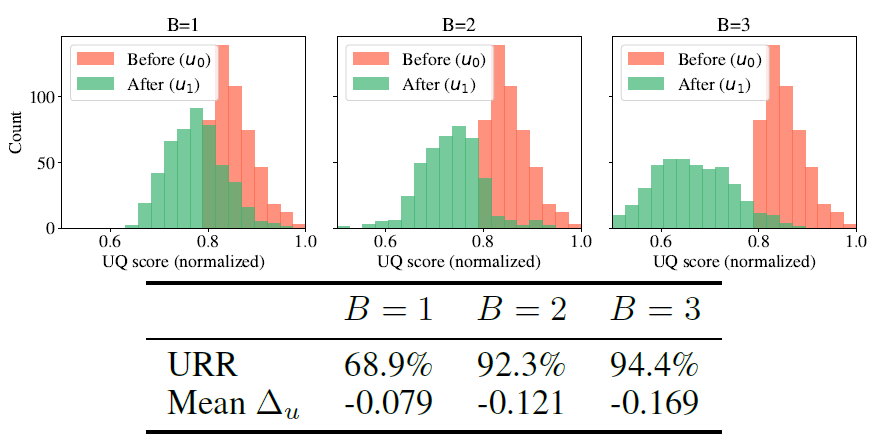
연구는 여러 Ablation 실험을 통해 UQ-DAAAM의 성능 요인을 추가로 분해했다: 먼저, 단일 객체에 대한 추가 최적화 예산을 (B=1)에서 (B=3)으로 늘릴수록 불확실성 감소 효과는 계속 개선되었지만, 한계 수익은 점점 줄었다. 아래 그림과 같이 대부분의 수익은 (B=2)에서 이미 달성되었으며, 하위 OC-NaVQA 성능도 같은 추세를 보여, 소수의 추가 시점이 대부분의 객체에서 의미적 모호성을 해결하기에 일반적으로 충분하다는 것을 시사한다.
둘째, 최적화 대상 선택에서는 완전한 불확실성 지표가 교차 시점 설명의 이산도만 사용하거나 단일 시점의 비일관성 가중치를 고려하지 않는 방안보다 더 우수했으며, 교차 시점의 의미적 불일치와 단일 설명의 품질을 동시에 고려하는 것이 더 효과적인 불확실성 판단을 제공할 수 있음을 보여준다. 최적화 시점 선택에서는 무작위 선택이 시스템 성능을 크게 낮췄고, 객체 관측 방향에 기반한 전략과 시점 품질 점수화 전략의 성능은 비슷했으며, 품질 가중 점수화가 후보 시점을 추가로 선별할 수 있었다.
다중 시점 설명 융합 실험은 융합 전략 역시 최종 기억 품질에 영향을 준다는 것을 보였다. 단일 최선의 설명만 사용하는 경우, 초기 설명만 또는 최적화 단계 설명만 융합하는 경우, 그리고 충돌 처리 규칙이 없는 일반 LLM 융합과 비교할 때, 논문에서 제안한 제약된 단계 인식 융합 방법이 가장 좋은 성능을 보였다. 이는 능동적으로 더 많은 관측을 확보하는 것이 전부가 아니며, 서로 다른 단계의 정보를 구별하고 충돌하는 설명을 처리하는 방식이 추가된 증거가 신뢰할 수 있는 기억으로 효과적으로 전환되는지를 결정한다는 의미다.
능동 최적화 임계값 측면에서는 실험이 객체 수준 불확실성 분포의 다른 분위수에 해당하는 설정을 비교했다. 결과는 임계값을 10번째 백분위수에서 20번째 백분위수로 조정했을 때 성능이 크게 개선되었고, 30번째 백분위수로 추가 조정했을 때도 향상되었지만, 40번째 백분위수가 가져오는 추가 수익은 이미 제한적이었다. 연구자들은 이를 바탕으로 기본 임계값이 의미적 질의 비용과 하위 작업 수익 사이에서 비교적 좋은 균형을 이룬다고 판단했다.
결어
UQ-DAAAM은 로봇의 장기 시공간 기억을 위해 불확실성 인식 접근법을 제공한다. 시스템은 비전-언어 모델이 생성한 설명을 더 이상 신뢰할 수 있는 사실로 직접 취급하지 않고, 교차 시점의 의미적 차이와 단일 시점 설명의 품질을 통해 잠재적 모호성을 식별한다. 이후 능동 관측을 통해 증거를 보충하고, 제약된 설명 융합을 통해 더 안정적인 객체 기억을 형성한다. 향후 연구자들은 UQ-DAAAM을 활용하여 이동형 로봇 팔과 같은 다양한 유형의 로봇을 제어하고, 그들의 불확실성 정량화 기술을 다른 분야에 적용하기를 희망한다.
참고 문헌:
https://arxiv.org/pdf/2606.08277 https://news.mit.edu/index%2ephp/2026/clearing-up-robot-fuzzy-memory-1105