Command Palette
Search for a command to run...
온라인 튜토리얼丨40개 언어 지원/1시간 분량 녹음 처리, 엔비디아가 Nemotron 3.5 Transcribe 오픈소스 공개, 명령 제어형 음성 인식·번역·오디오 Q&A 구현

회의 녹음을 텍스트로 변환한 뒤에도 여전히 여러 문제가 남을 수 있습니다. 여러 사람이 발언할 때는 어떻게 구분할까요? 전문 용어를 잘못 알아듣지는 않았을까요? 자막이나 번역까지 제작해야 한다면 녹음에서 바로 필요한 결과를 얻을 수 있을까요?
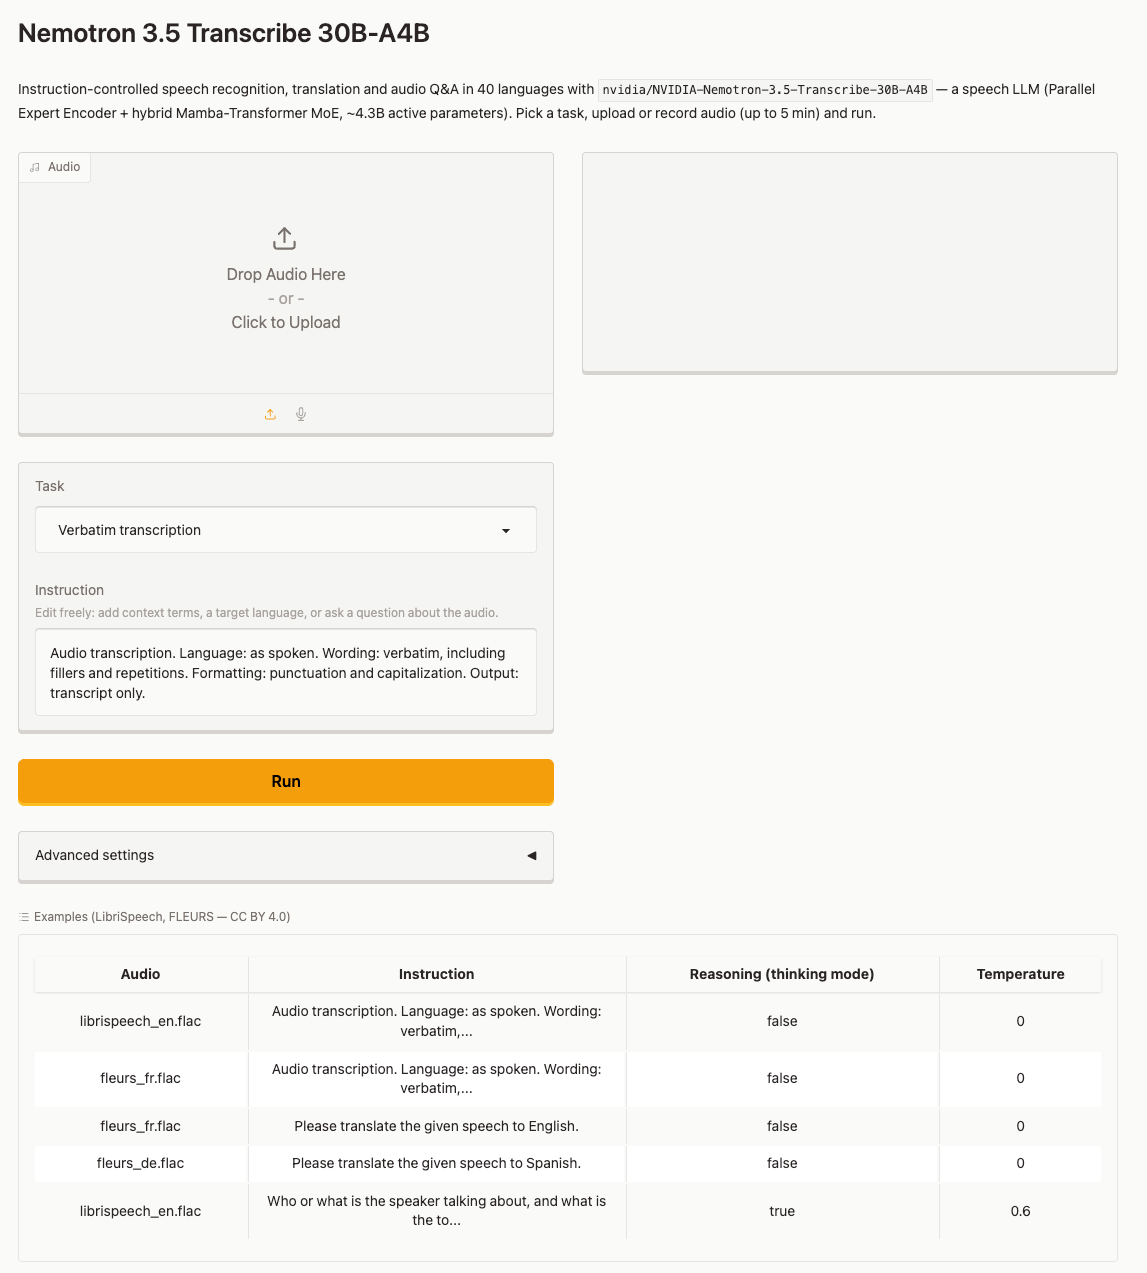
NVIDIA가 출시한 Nemotron 3.5 Transcribe는 이러한 다양한 요구를 지시문으로 처리하려 합니다. 사용자는 모델에게 충동어와 반복을 유지하도록 요청하여 전사본을 생성할 수 있으며, 표현을 정리해 더 읽기 쉬운 텍스트를 출력하도록 할 수도 있습니다. 모델은 화자 표기, 음성 번역, 언어 인식 및 오디오 질의응답도 지원합니다. 공식 모델 카드에 따르면 40개 언어를 지원하며, 약 1시간 길이의 녹음까지 처리할 수 있습니다. 언어와 작업에 따라 지원 수준에는 차이가 있습니다.
Nemotron 3.5 Transcribe는 Mamba-2와 Transformer를 혼합한 MoE 아키텍처를 채택했으며, 총 매개변수 약 34B, 각 Token 처리 시 약 4.3B 매개변수 활성화, 오디오 인코더를 포함합니다. NVIDIA가 공개한 평가에 따르면, 모델은 영어, 장시간 오디오 및 다국어 음성 인식 벤치마크에서 경쟁력 있는 성과를 거두었습니다. 오프라인 오디오 처리를 목표로 하며, 내부적으로 청킹 메커니즘을 사용한다는 이유로 실시간 스트리밍 전사 모델로 간주할 수 없습니다.
현재 HyperAI에는 「NVIDIA-Nemotron-3.5-Transcribe-30B-A4B:지시 제어 음성 인식, 번역 및 오디오 질의응답」이 게시되어 환경 구성이 완료되어 배포 장벽을 크게 낮췄습니다 ⬇️
온라인 실행:
추가 온라인 튜토리얼:
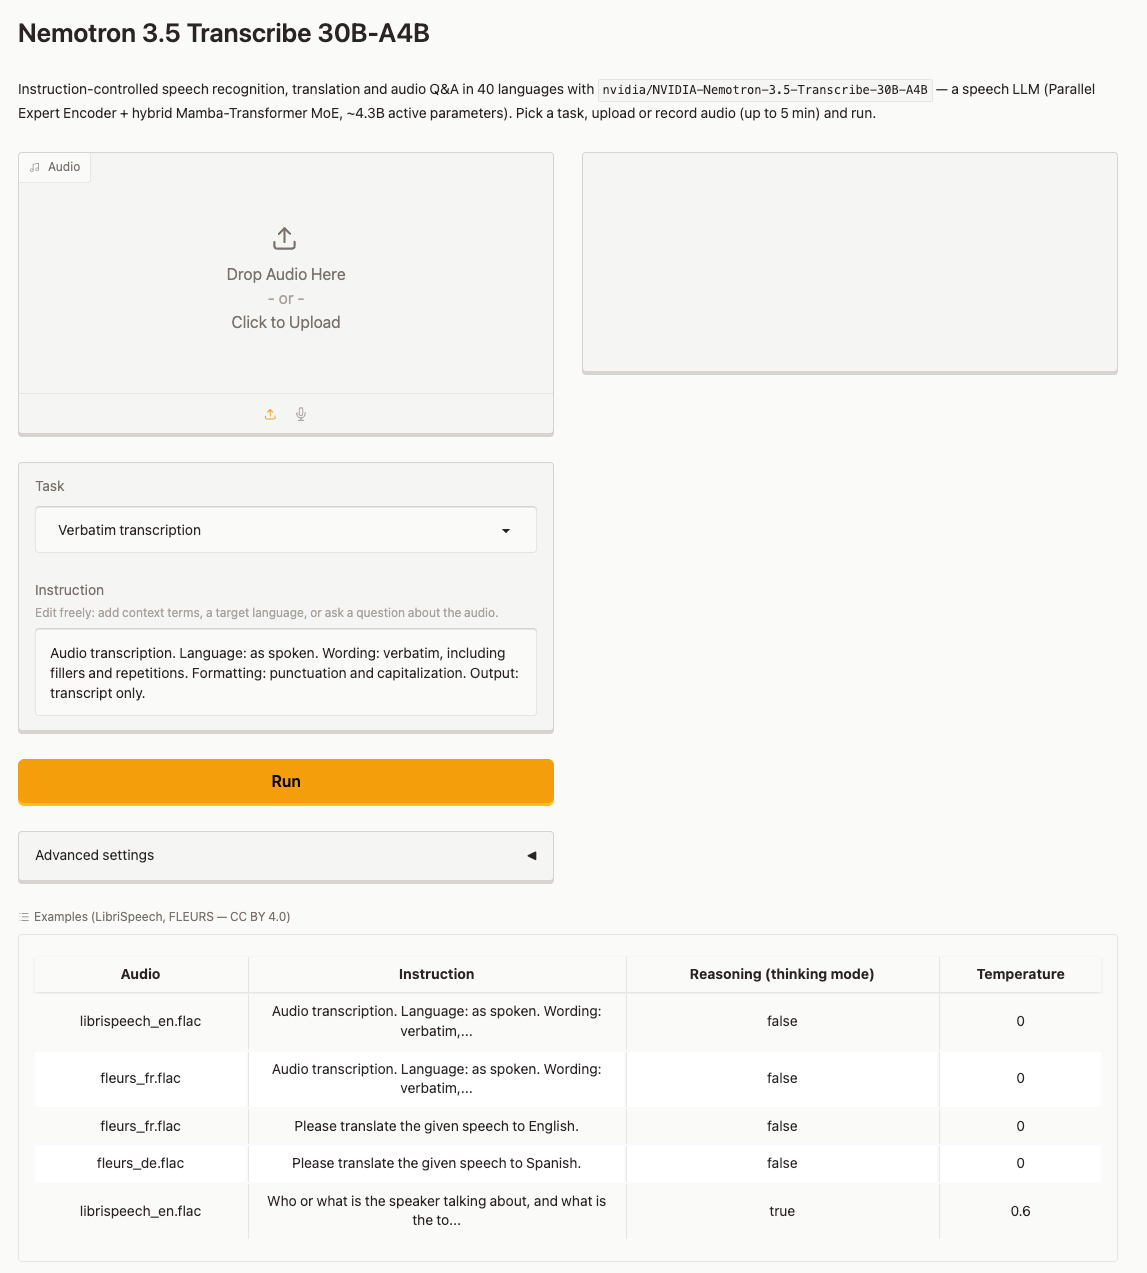
Demo 실행
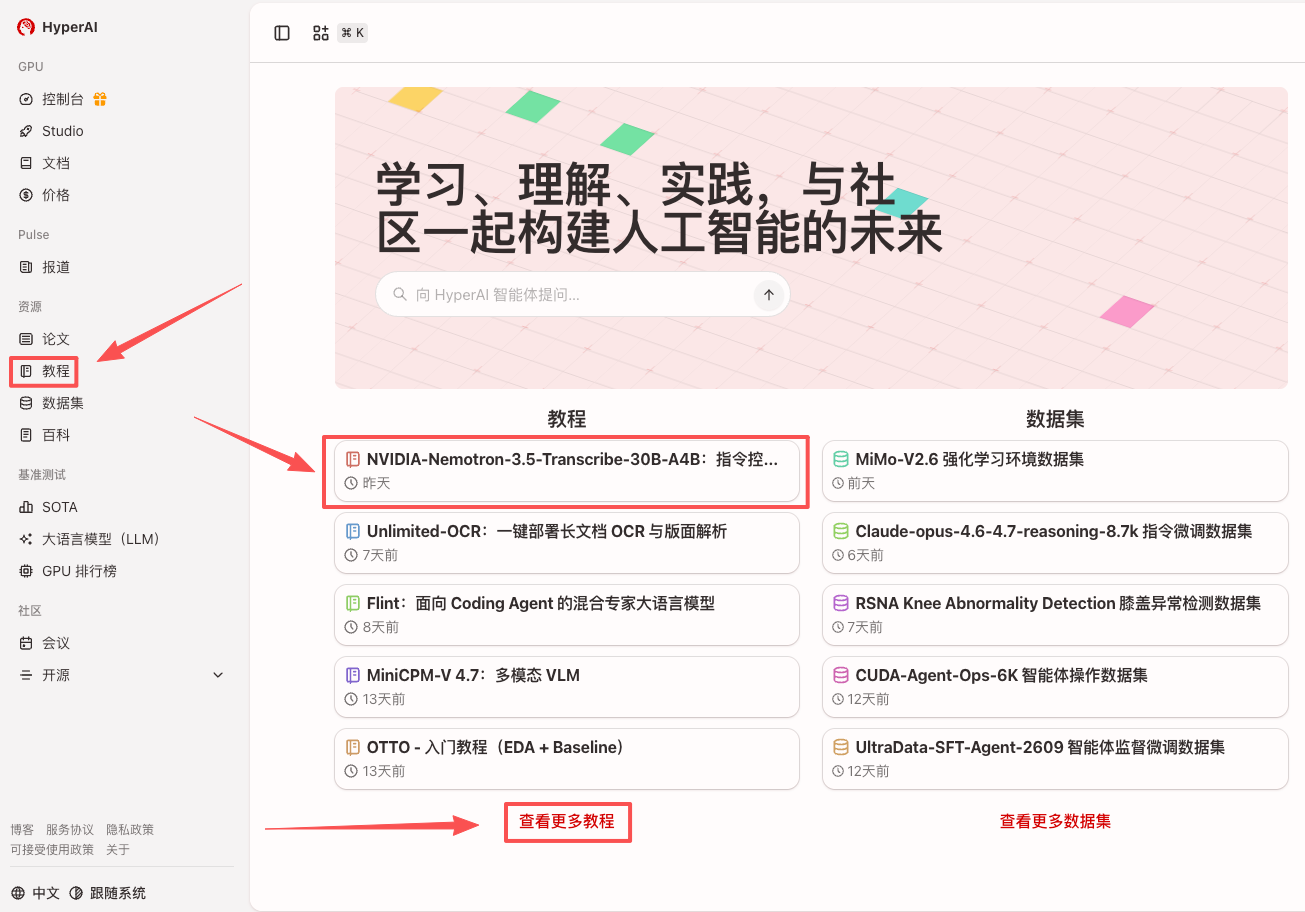
- hyper.ai 홈페이지에 접속한 후 「튜토리얼」 페이지를 선택하거나 「더 많은 튜토리얼 보기」를 클릭한 다음 「NVIDIA-Nemotron-3.5-Transcribe-30B-A4B:지시 제어 음성 인식, 번역 및 오디오 질의응답」을 선택하고 「이 튜토리얼 실행」을 클릭합니다.
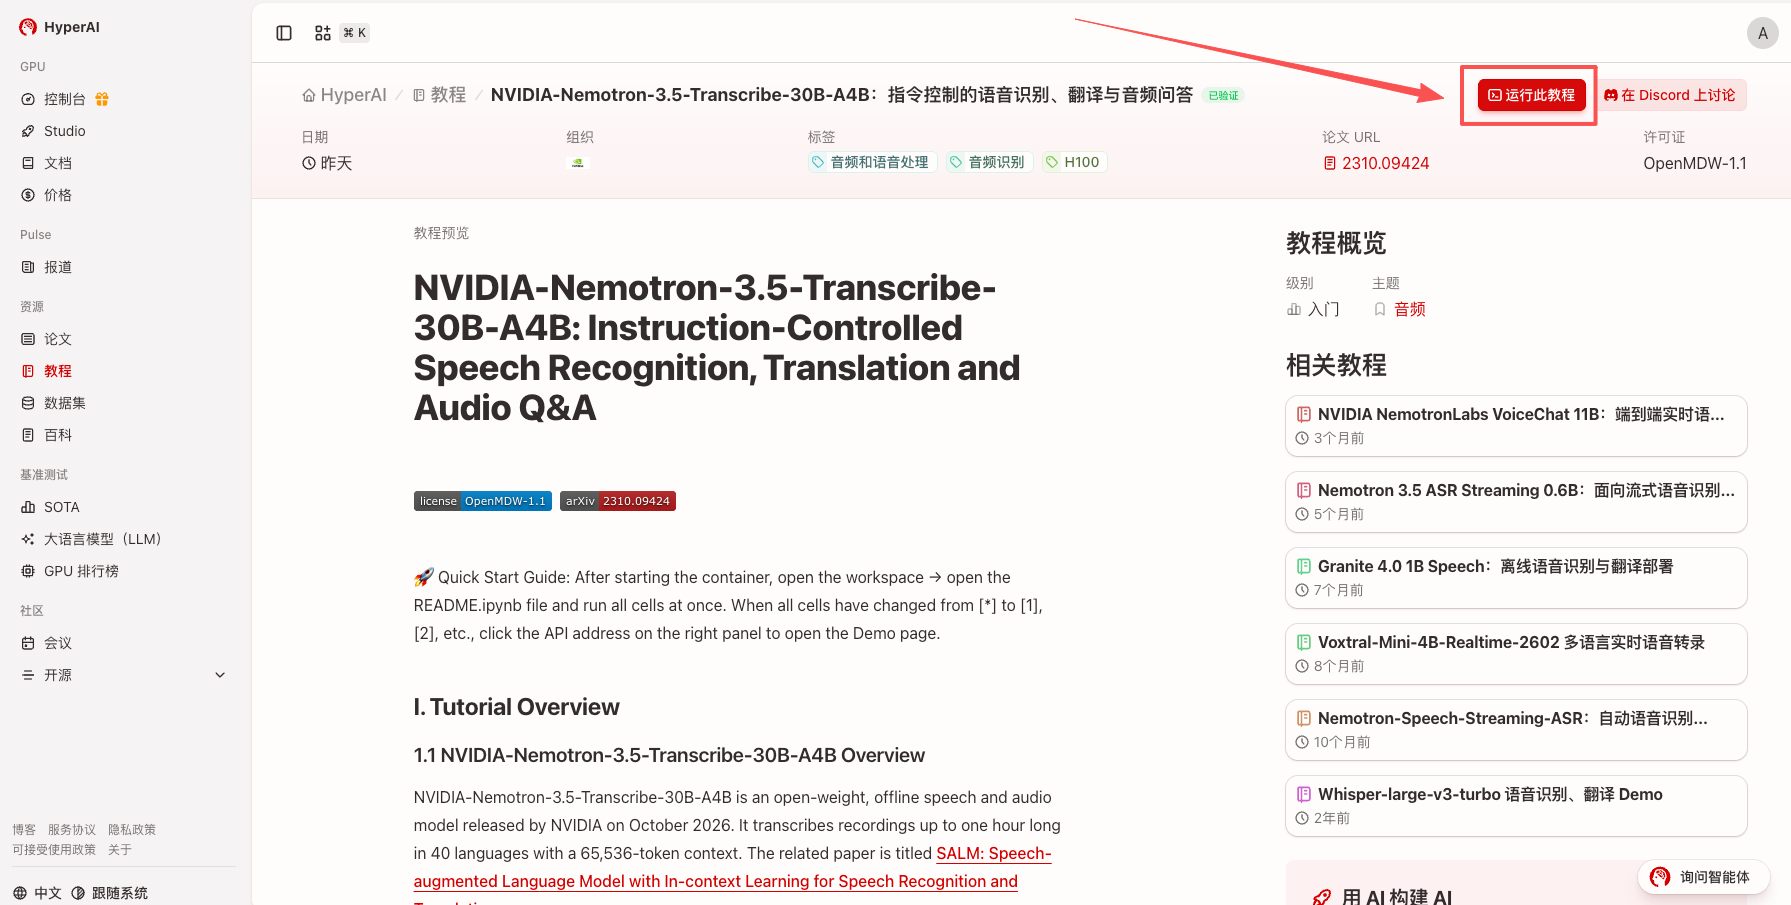
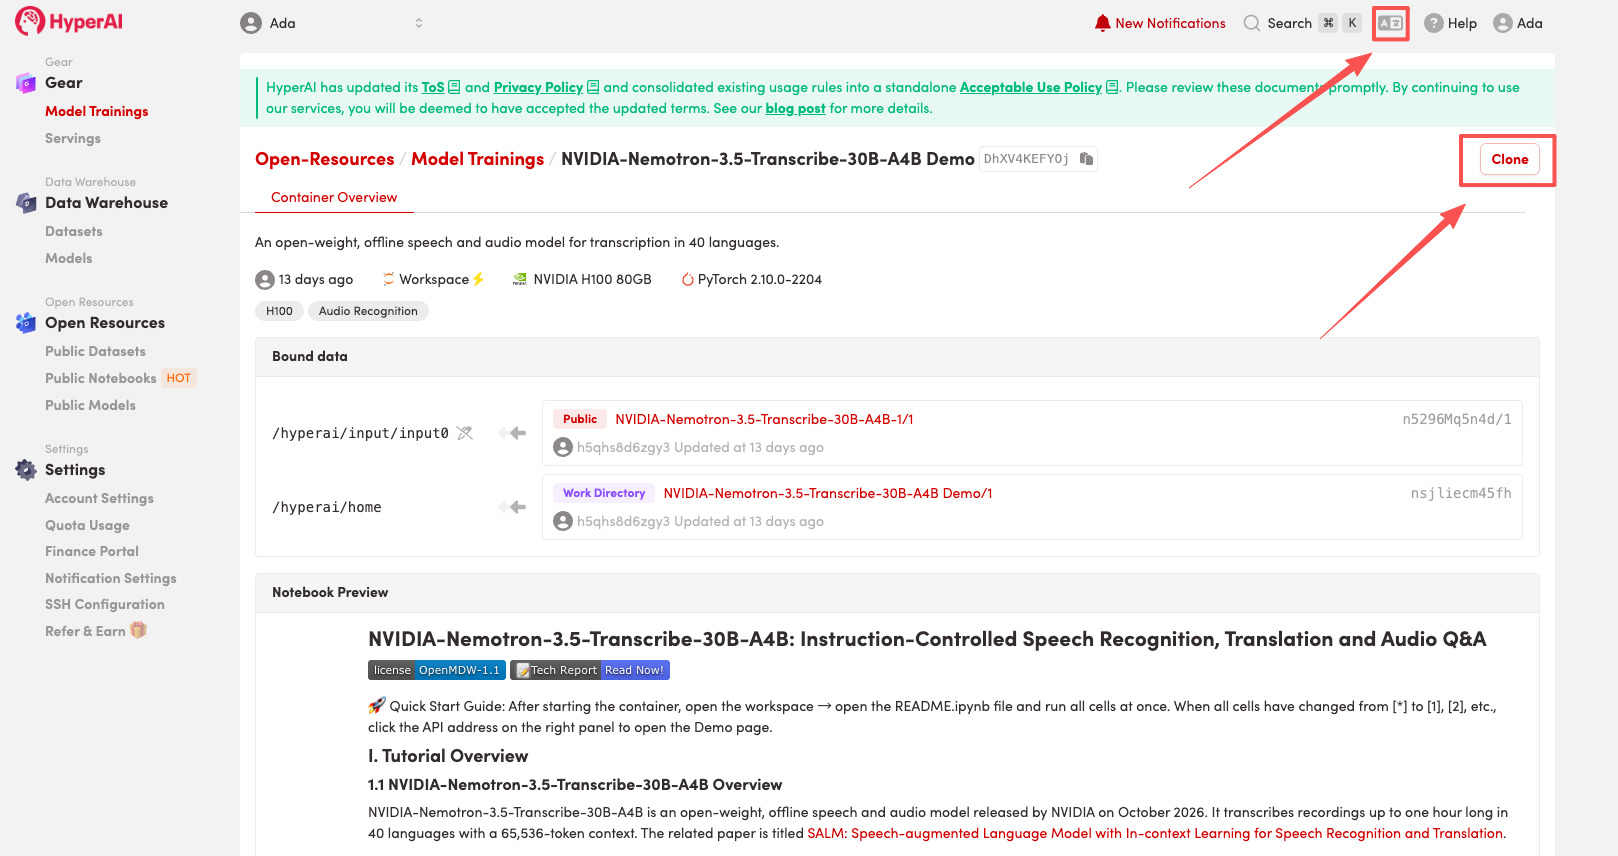
2.페이지가 전환된 후 오른쪽 상단의 「Clone」을 클릭하여 해당 튜토리얼을 자신의 컨테이너로 복제합니다.
참고: 페이지 오른쪽 상단에서 언어 전환을 지원하며, 현재 중국어와 영어 두 가지 언어를 제공합니다. 이 튜토리얼 문서는 영어를 예로 들어 단계를 보여줍니다.
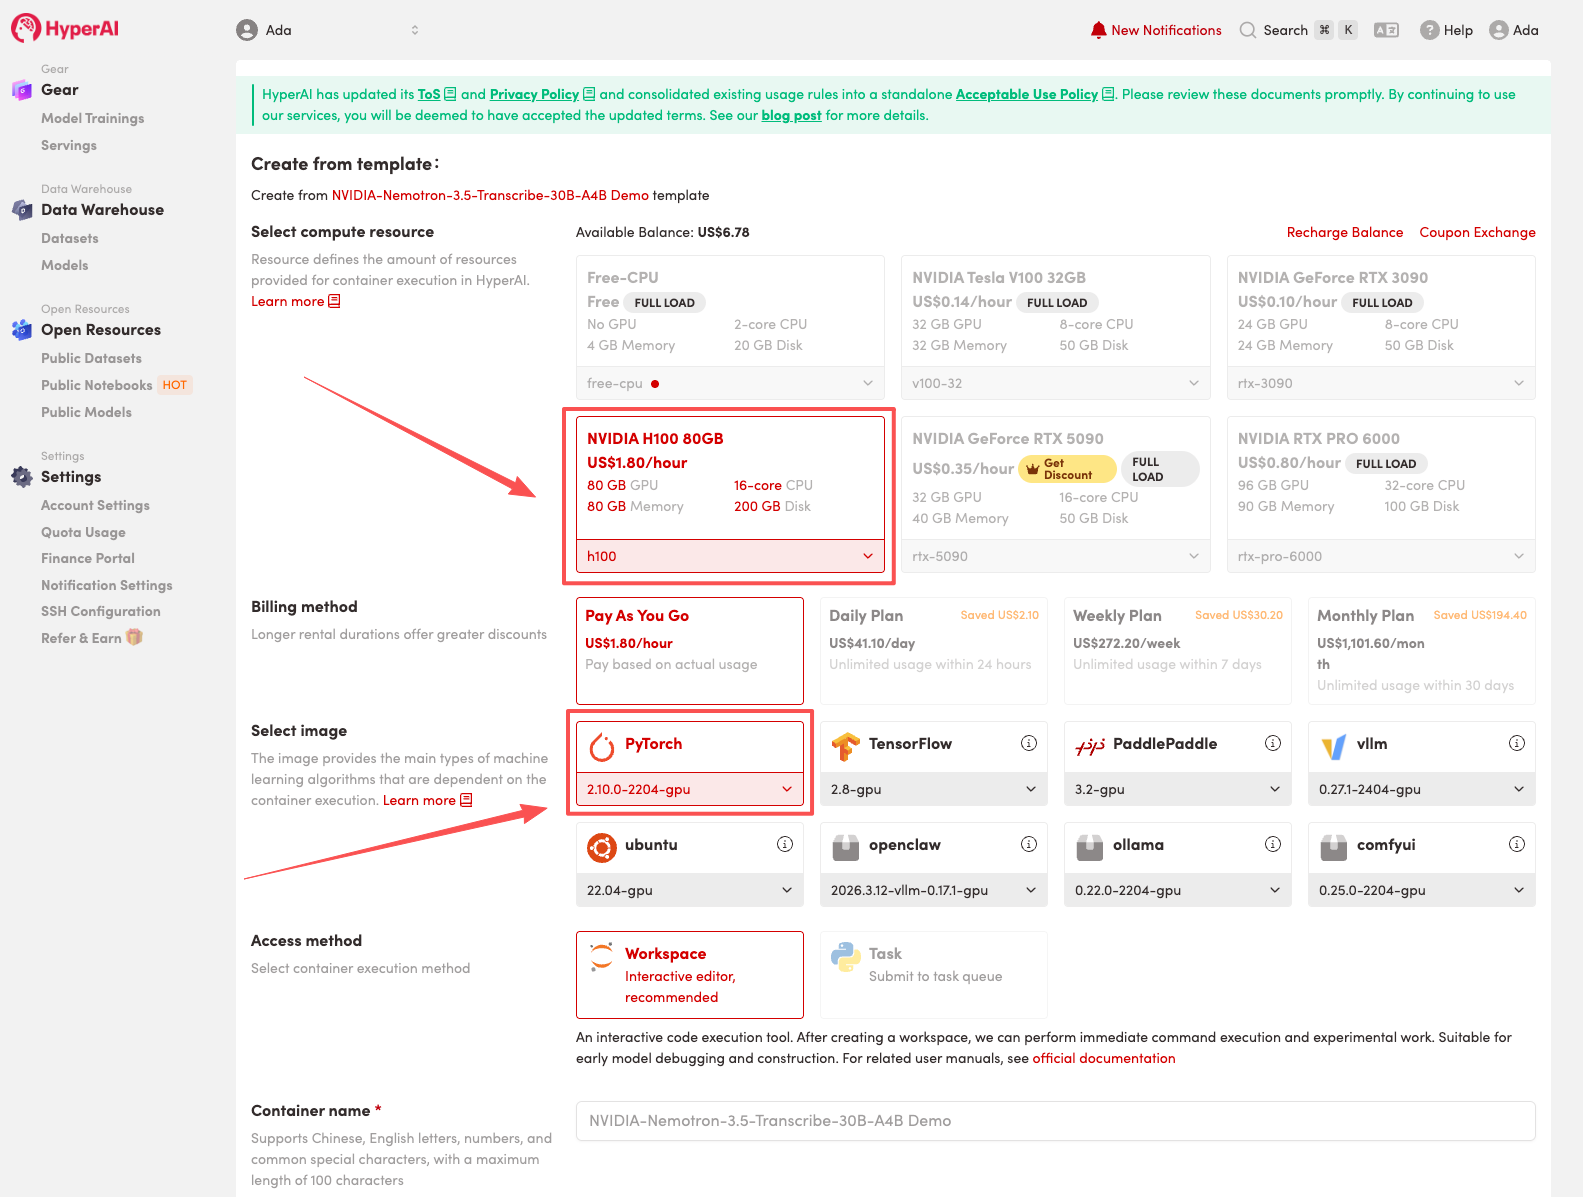
- 「NVIDIA H100」 및 해당 이미지를 선택하고 「Continue job execution(실행 계속)」을 클릭합니다.
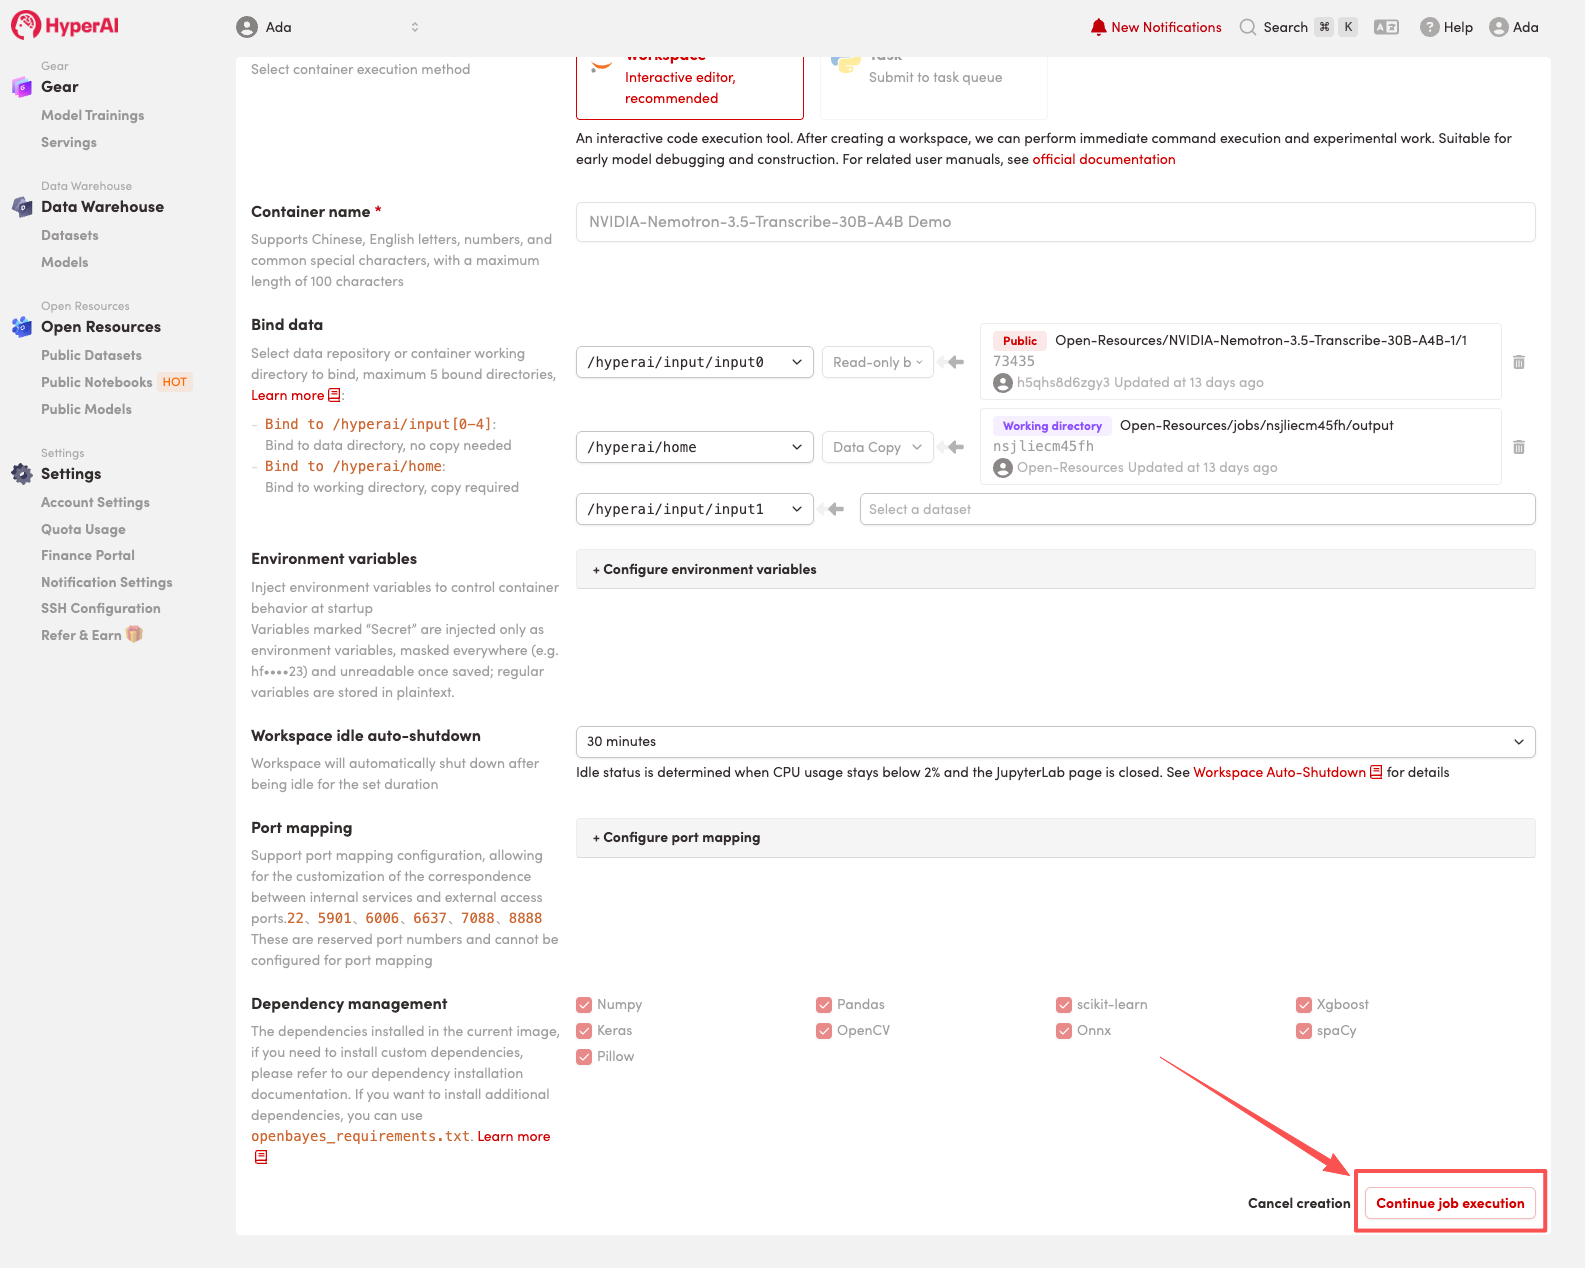
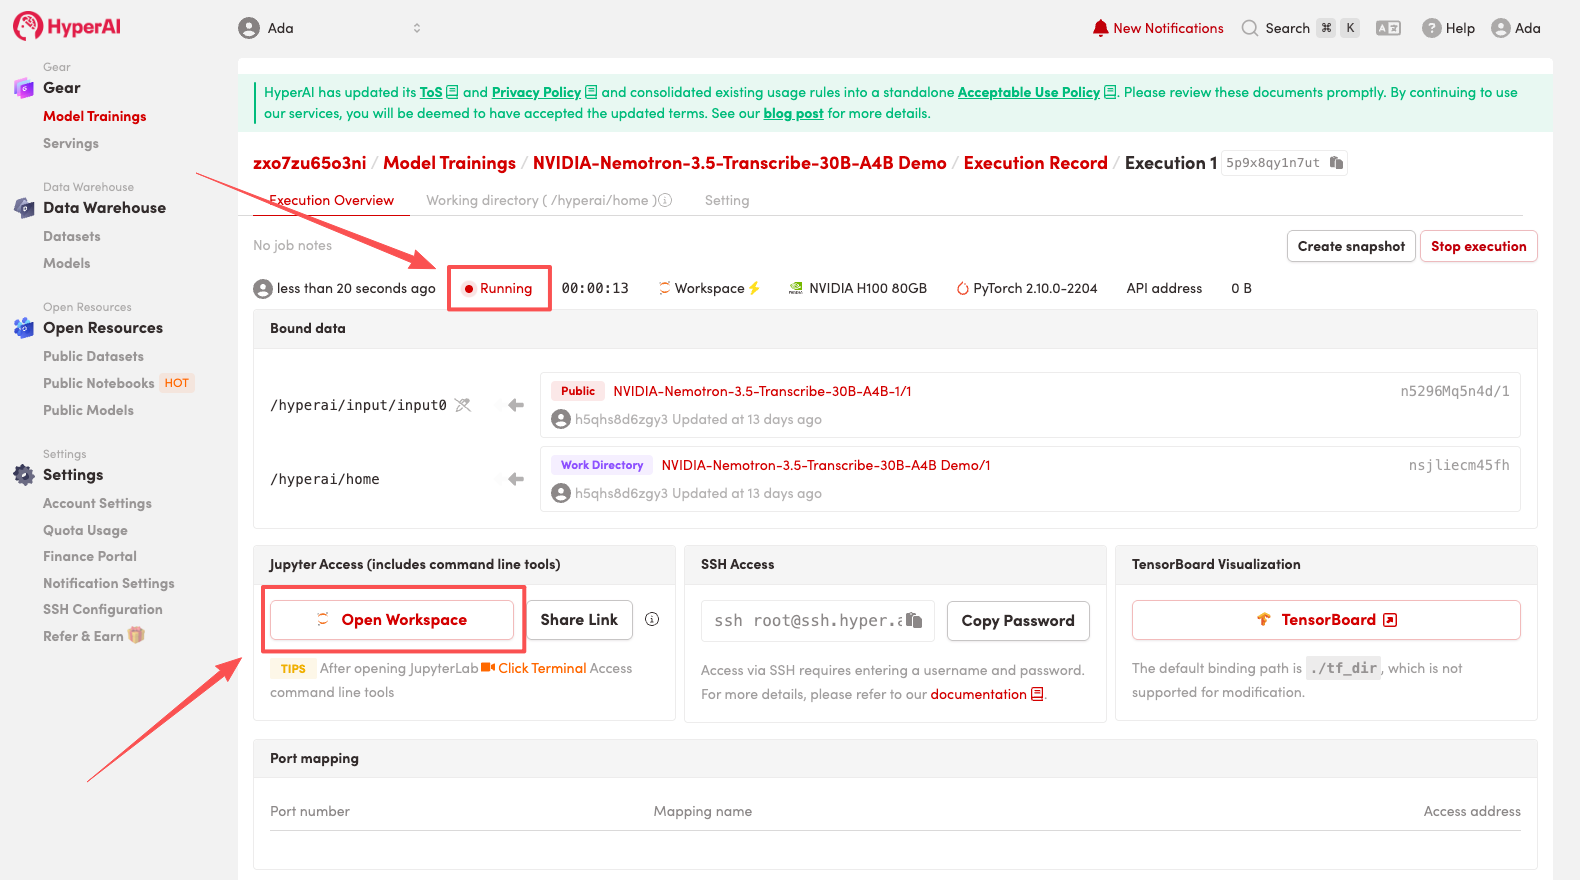
4.리소스 할당을 기다렸다가 상태가 「Running(실행 중)」이 되면 「Open Workspace」를 클릭하여 Jupyter Workspace로 진입합니다.
효과 시연
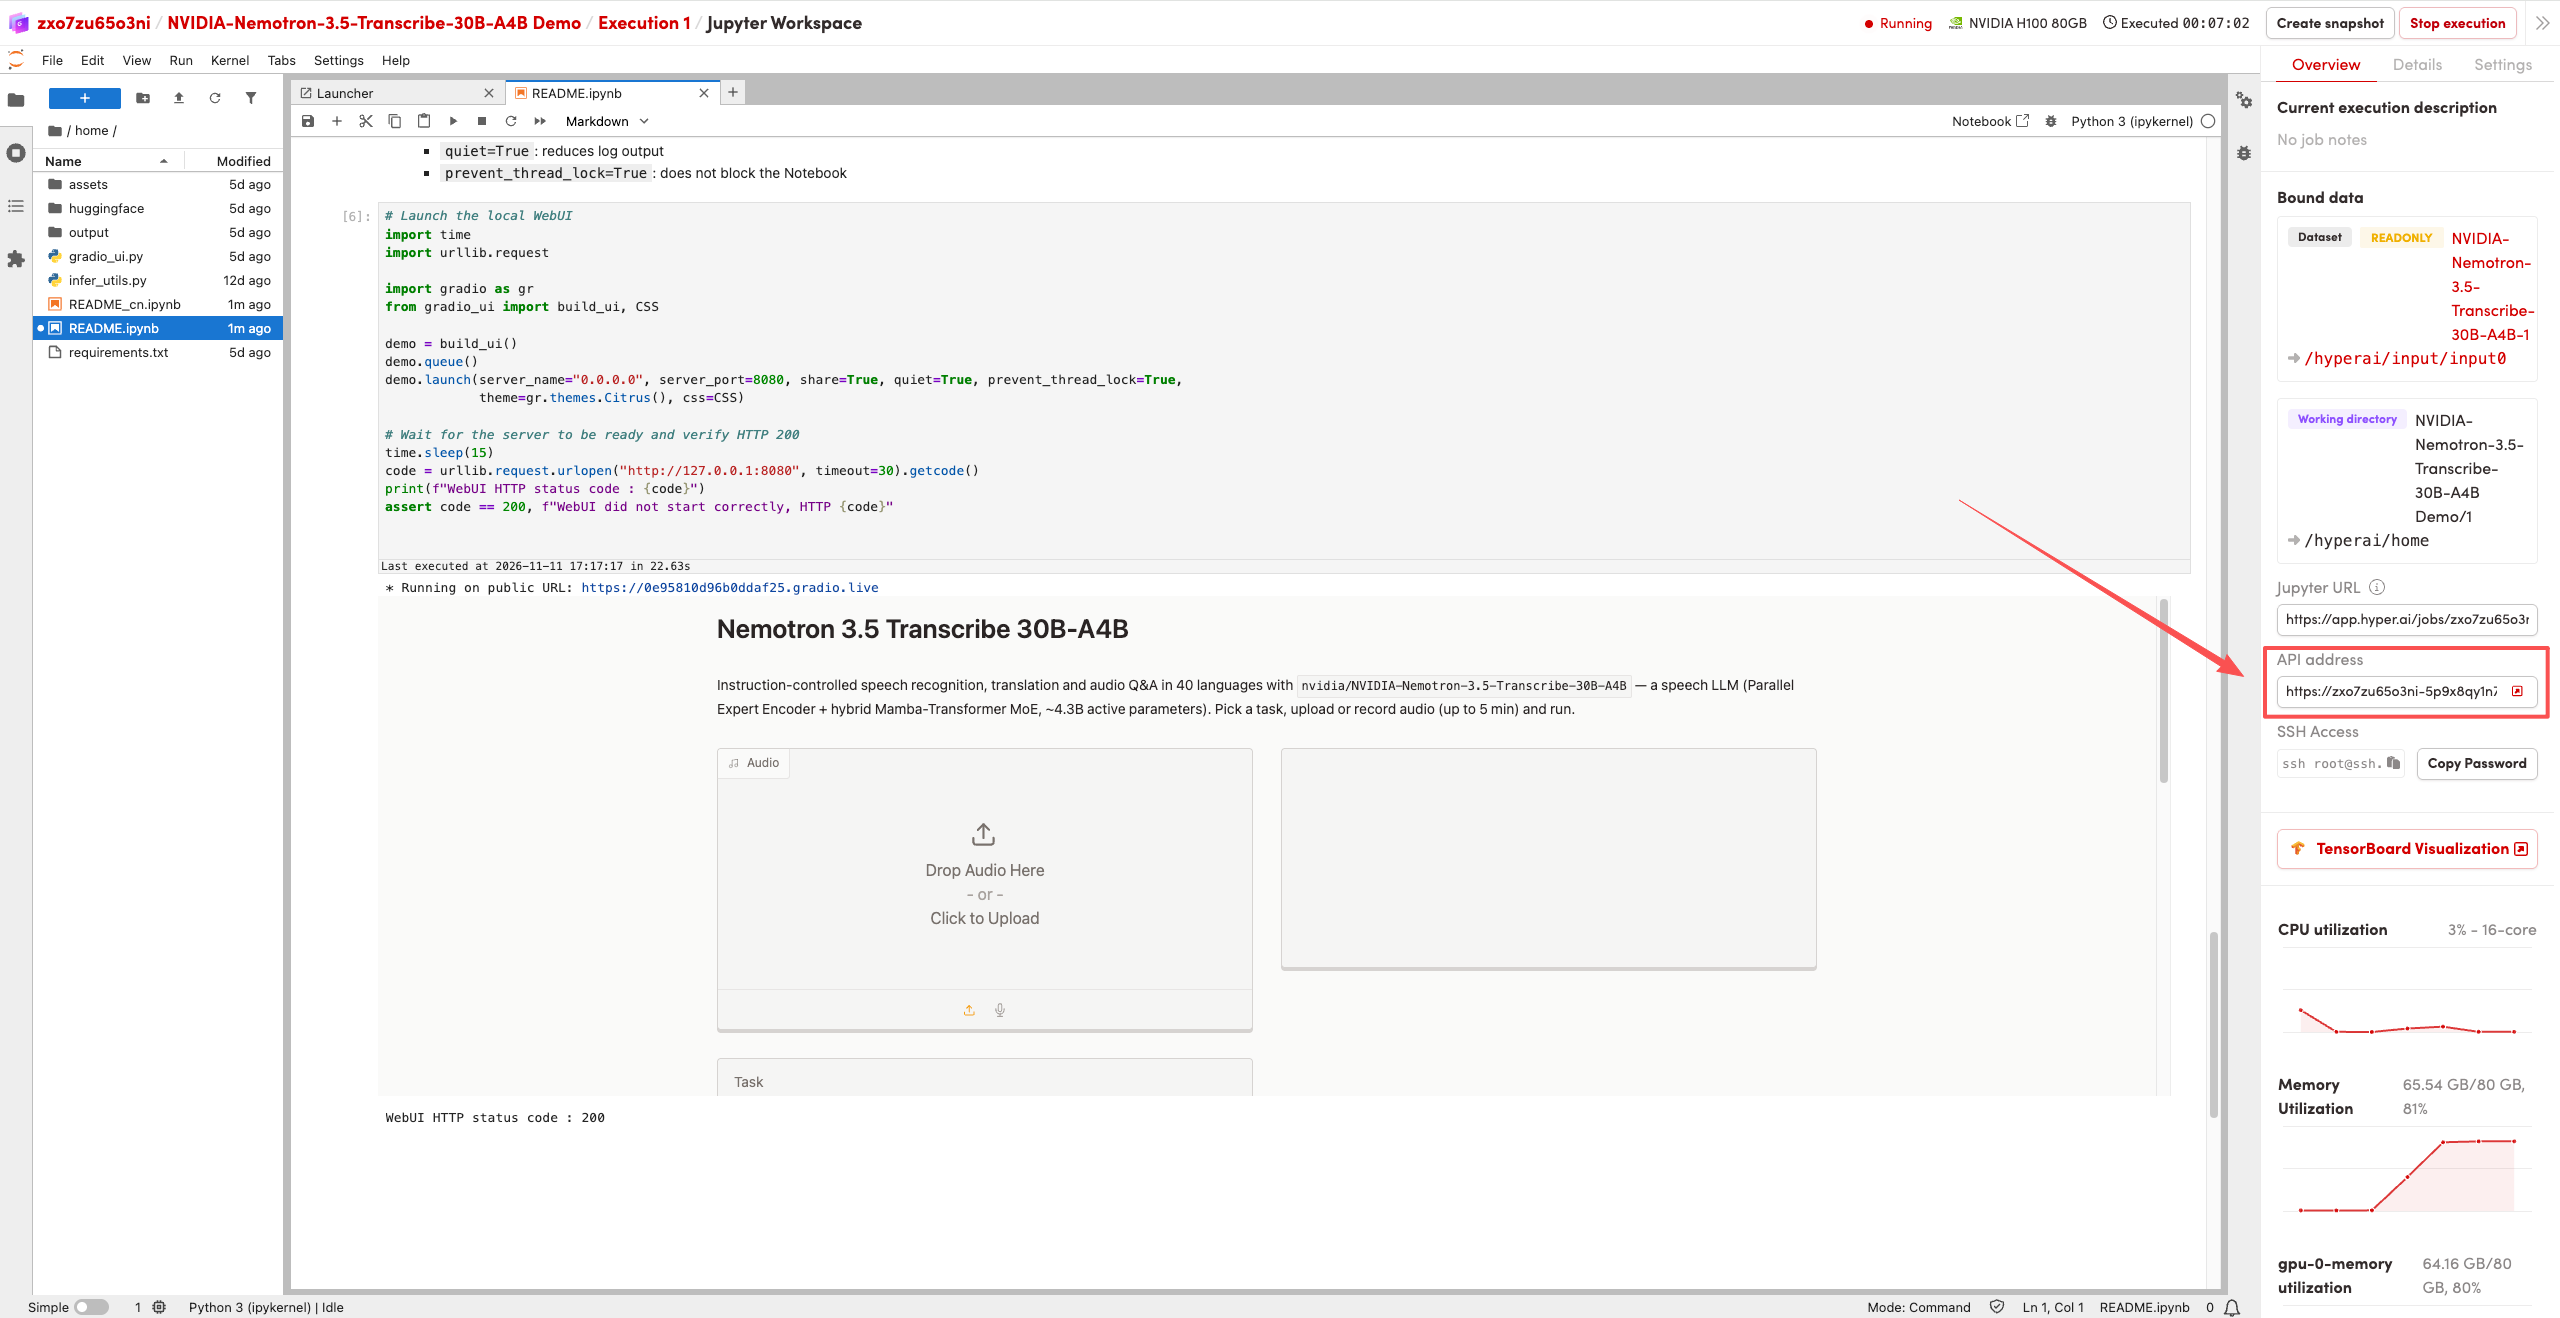
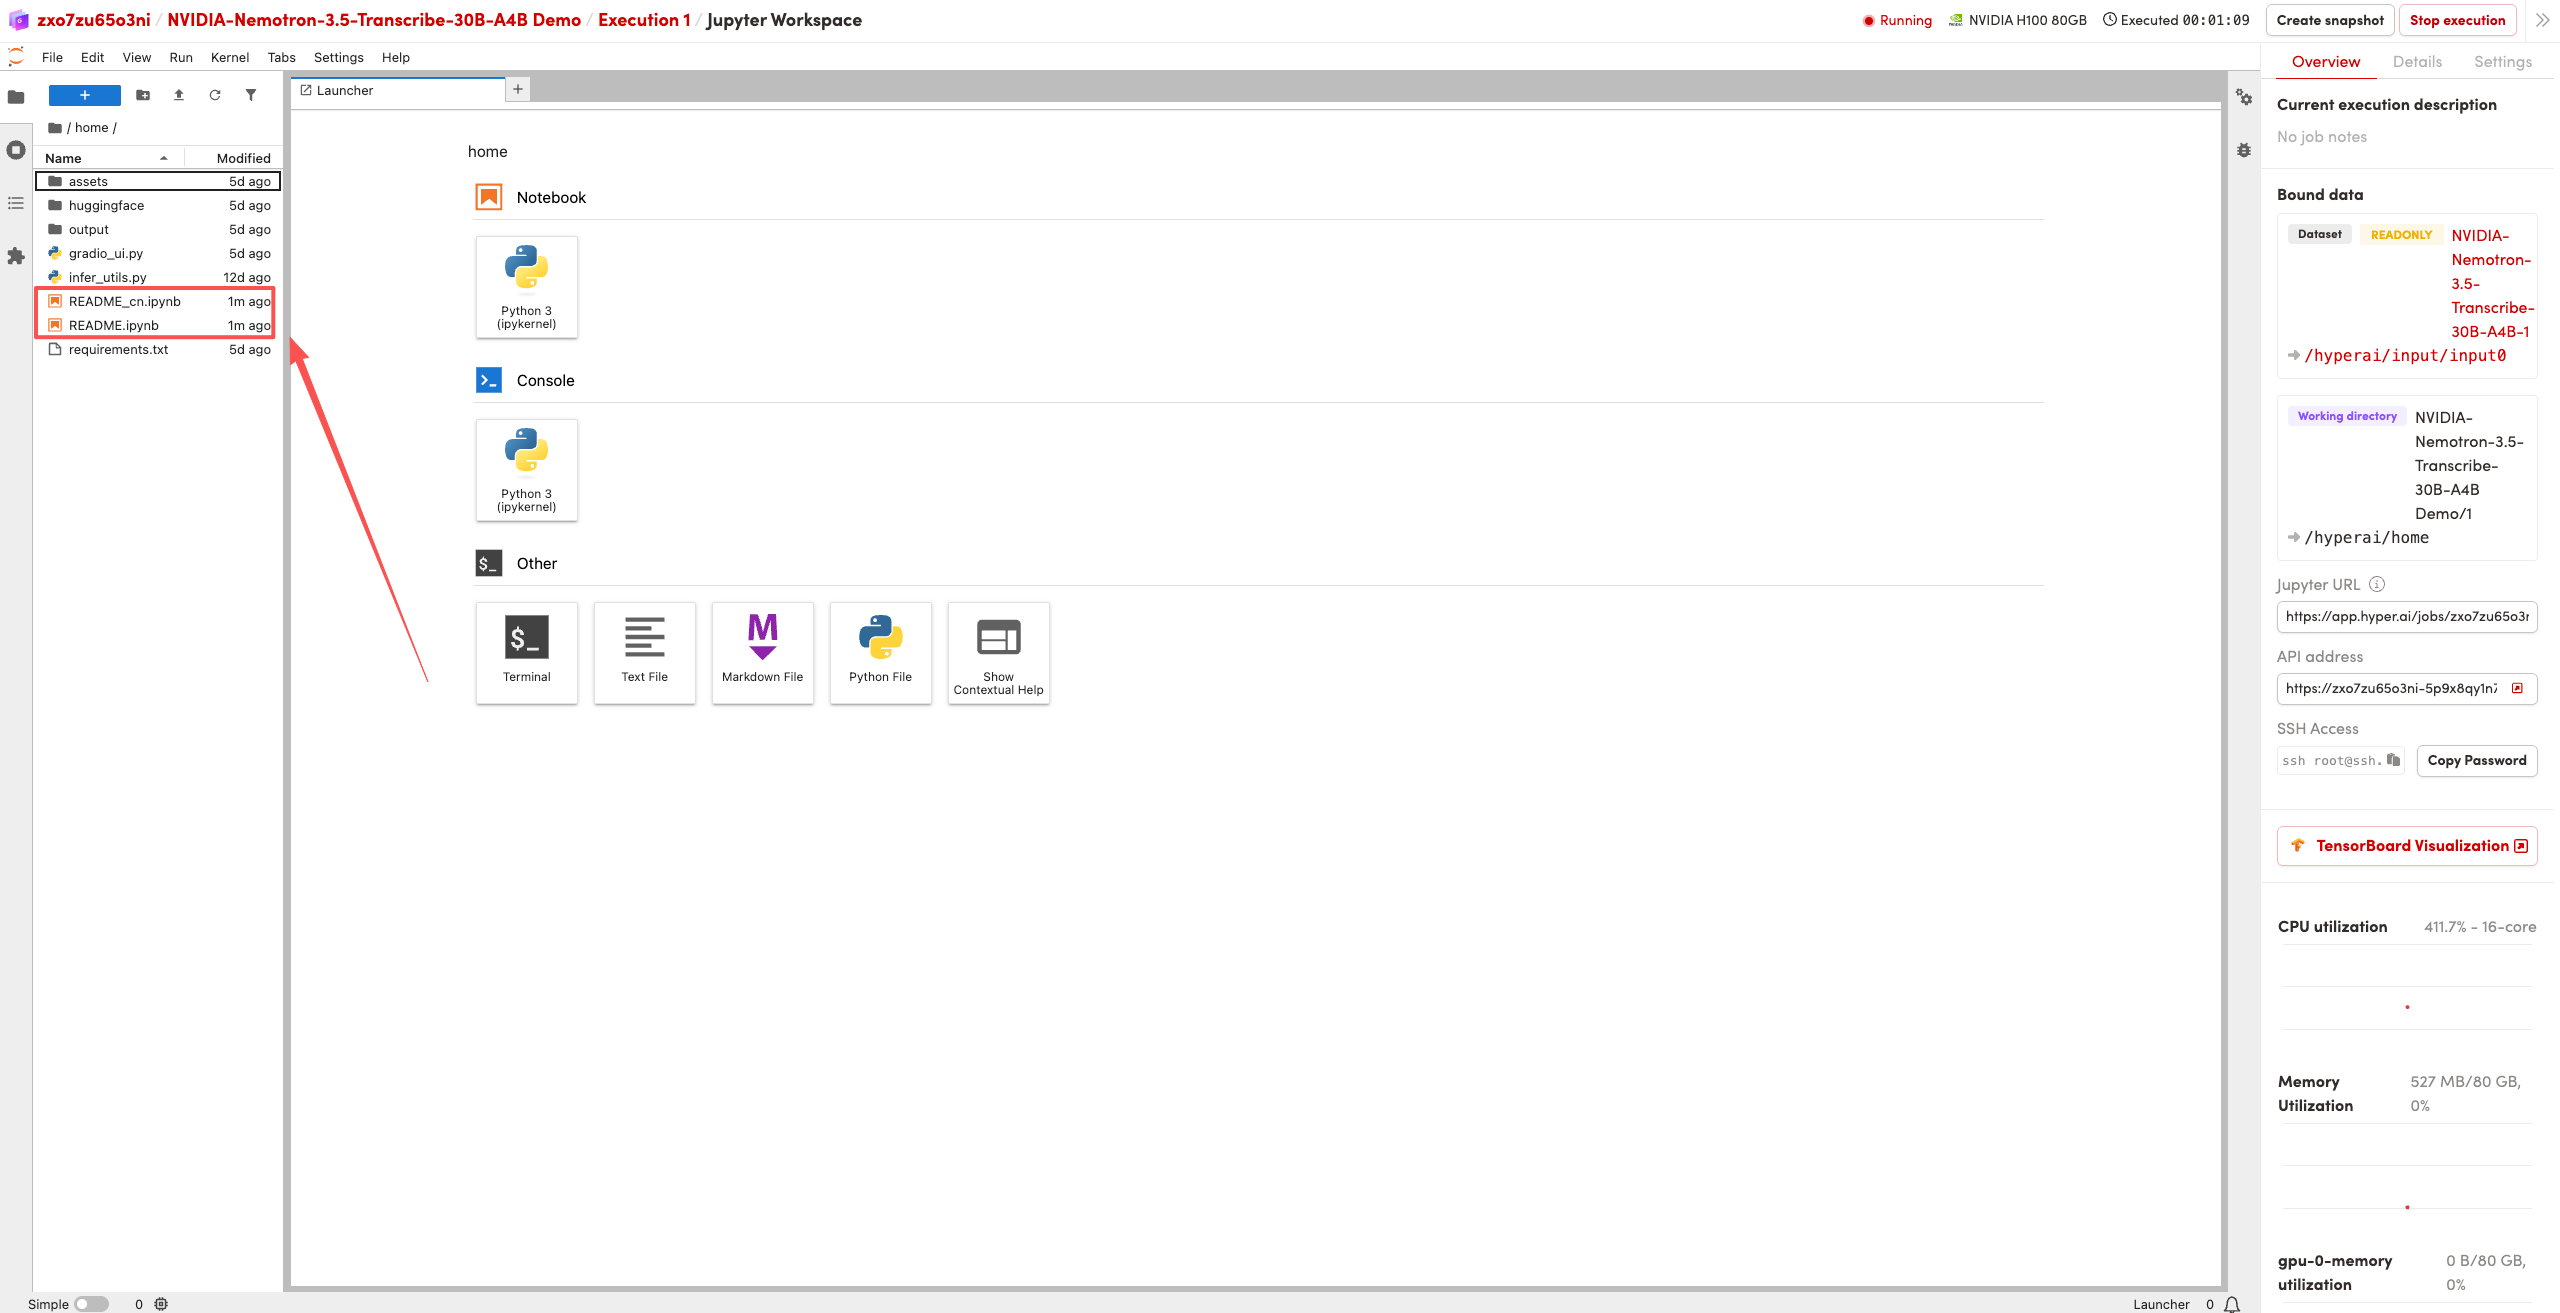
1.페이지가 전환된 후 왼쪽의 README 파일을 클릭하고, 진입한 후 상단의 Run(실행)을 클릭합니다.
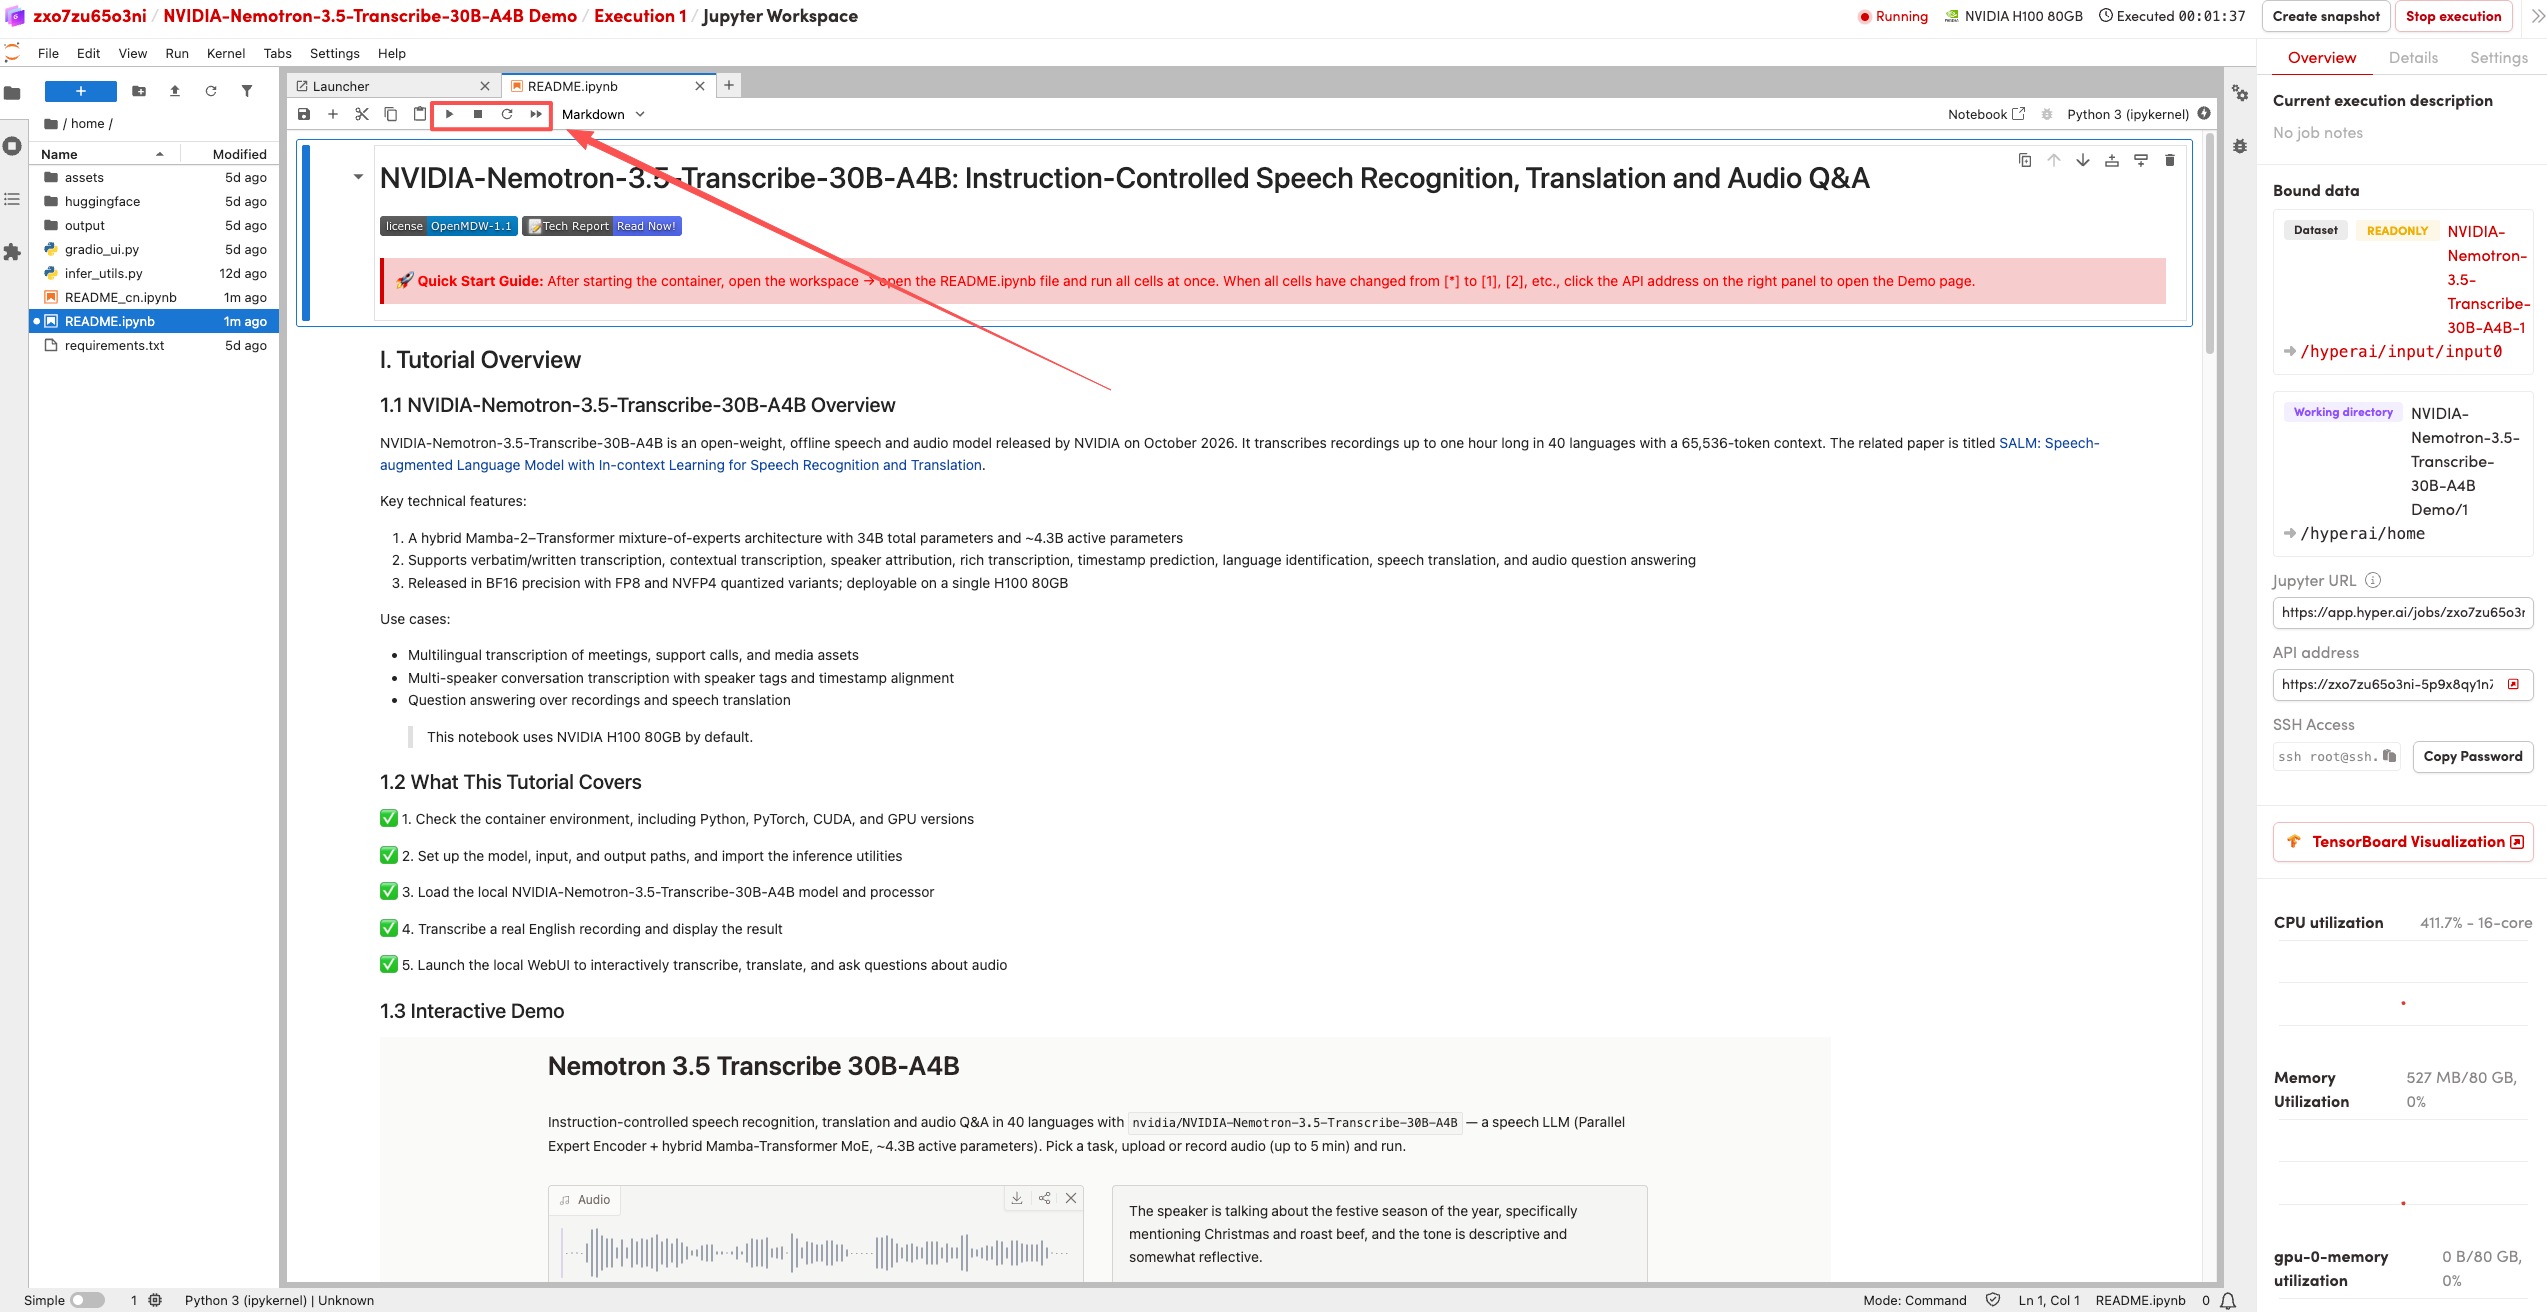
2.실행이 완료되면 오른쪽의 API 주소를 클릭하면 demo 페이지에 접근할 수 있습니다.