Command Palette
Search for a command to run...
약물 유사 분자에서 표적 특이성 화합물까지, 미국 피츠버그 대학교가 분자 지문 검색으로 표적 약물 발견 가속
传统药物发现是一项极具挑战性的工作,其核心目标是在庞大的化学空间中,识别出具有特定理想性质且能够作用于特定靶点的分子。从最初的研发构想到最终获得上市批准,一款新药的开发成本超过 26 亿美元,耗时超过 12 年。其中一个根本性挑战在于,如何在包含 1023-1060 个分子的庞大化学空间中高效搜索,从而找到同时具备目标生物活性、理化性质和可合成性的化合物。
近年来,生成式人工智能为分子设计带来了新的可能。通过学习已有分子的结构和性质,生成模型能够探索潜在的化学空间,提出具有特定理化性质或生物活性特征的候选分子。然而,如何将模型生成的分子转化为化学结构有效、实际可获取,并且具有真实生物活性的化合物,仍是这一领域面临的重要问题。
在此背景下,来自美国宾夕法尼亚州匹兹堡大学的研究团队提出了一种全谱生成式先导化合物发现(Full-Spectrum Generative Lead Discovery,FSGLD)流程,这是一种由深度学习驱动的高效药物先导化合物识别方法。 FSGLD 的核心是多尺度 DRUG-GAN 模型,能够在三个不同场景下,通过生成式模型指导药物分子的发现,包括:
(1)生成随机的类药性化合物;
(2)生成具有靶点特异性的化合物;
(3)生成具有共同化学结构的靶点特异性系列化合物。
在针对三类药理学特征各异的靶点开展的评估中,FSGLD 在识别靶点特异性候选化合物方面展现出良好的应用潜力。此外,研究还建立了一套用于热力学积分(TI)计算的计算流程,在保持计算精度的同时,将计算时间缩短了 80% 至 90%。
相关研究成果以「A Full-Spectrum Generative Lead Discovery (FSGLD) pipeline via DRUG-GAN: A multiscale method for drug-like/target-specific compound library generation」为题,已刊登 ScienceAdvances。
研究亮点:
-
FSGLD 流程不仅可以利用生成式模型设计具有类药性和靶点特异性的化合物,还能对候选化合物进行系统、高效的筛选和验证
-
研究人员构建了一个具有实用性和可扩展性的框架,有望降低临床前药物发现所需的时间和成本
-
通过该流程生成的化合物并非仅停留在理论层面的候选分子,而是具备进一步开展实验验证的可行性,能够为学术研究人员和制药行业从业者带来切实价值
论文地址:
https://www.science.org/doi/full/10.1126/sciadv.aei5257
数据集:针对三种应用场景的不同数据集
FSGLD 针对不同的先导化合物发现任务设计了三种应用场景, 因此采用了不同的数据集和训练策略。
对于场景 I, 研究人员依据 Lipinski 五规则并结合多样性筛选,从 DrugBank 数据库(https://go.drugbank.com/) 中收集了 7,002 种药物,构建类药性化合物数据集。
对于诱饵分子集,研究人员使用 Open Babel 计算了 ZINC 数据库类药性子集中 19,212,639 个分子的分子量(MW)和脂水分配系数(logP)。随后,研究人员利用内部开发的程序,从中筛选出 284,552 种分子量和 logP 值与 DrugBank 化合物最为接近的 ZINC 化合物。接下来,使用 SYBYL-X 2.1.1 软件,基于分子指纹(FP)对这些化合物进行聚类,以最大限度地提高其结构多样性。最终,研究人员选取 9998 种分子,构建诱饵分子集。
为了训练和验证 dcGAN 的判别器,研究人员采用十折交叉验证方法([75]),将所有选定的类药性分子(7002种)和诱饵分子(9998种)划分为训练集和测试集。
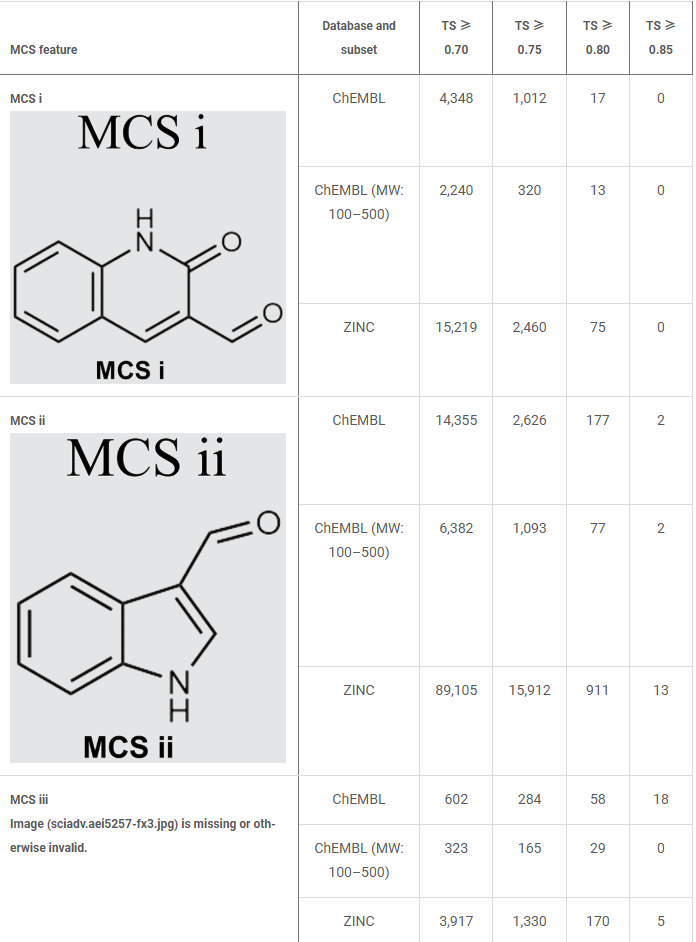
对于场景 II 和场景 III 中靶点偏向型化合物的生成, 研究人员从 ChEMBL 数据库中收集了 1,896 种 CB2 活性化合物(Ki/IC50 低于100 nM)和 2996 种 CB2 非活性化合物(Ki/IC50 大于或等于100 nM),用于训练 cdcGAN 模型。此外,研究人员还对收集到的 CB2 活性化合物的化学结构进行了人工检查,并识别出其中最常见的三个最大公共子结构(MCS),如下表:
在模型训练过程中,所有分子均使用 Open Babel 2.3.1 版本软件转换为 MACCS 分子指纹(168位)。为了开展进一步验证,研究人员获取了 CB1 的 X 射线晶体结构,并构建了 CB2 的同源模型。
FSGLD 프레임워크: DRUG-GAN을 핵심으로
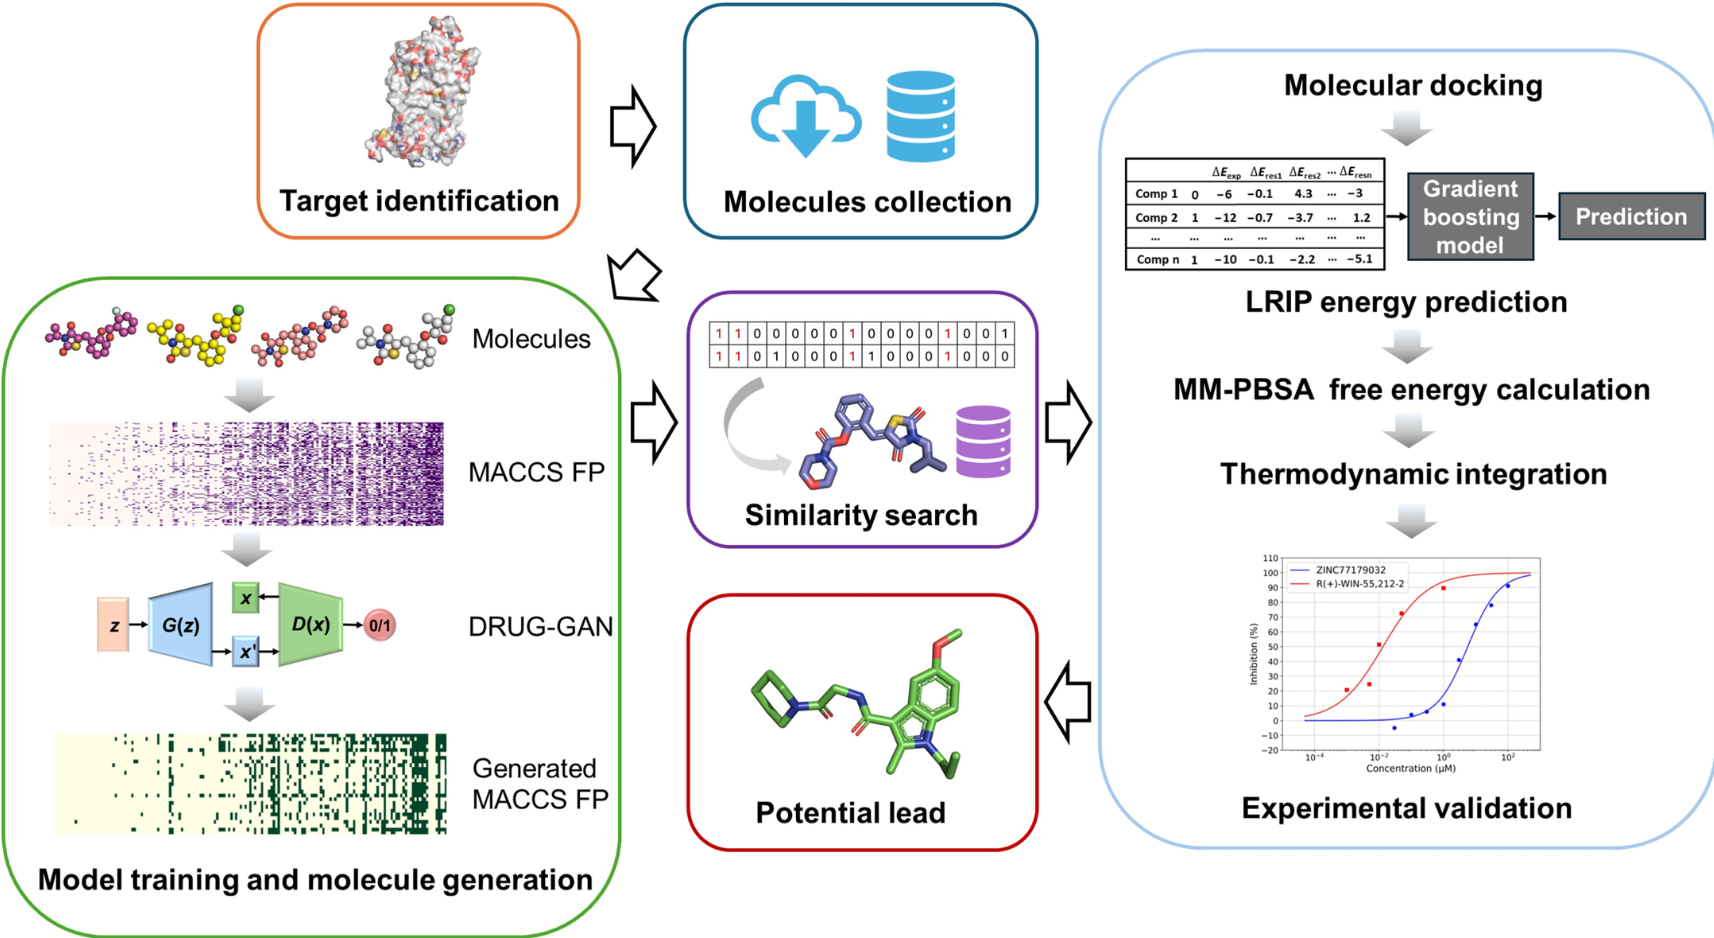
FSGLD의 핵심은 DRUG-GAN이며, 주요 아이디어는 완전한 분자 구조를 직접 생성하는 것이 아니라 분자 지문의 분포를 학습하여 특정 특징을 가진 지문을 생성하고, 이를 쿼리 조건으로 삼아 대규모 화학 데이터베이스에서 구조적으로 유사한 실제 화합물을 검색하는 것이다. 그 프로세스 개요는 다음과 같다:
이 설계는 SMILES 문자열 또는 분자 그래프 기반의 전통적인 생성 모델과 다르다. MACCS 분자 지문은 분자의 구조적 특징을 간결한 형태로 표현할 수 있어 상대적으로 제한된 데이터셋에서 학습하기에 적합하다. 그러나 분자 지문은 단일 분자와 일대일 유일 대응 관계를 형성할 수 없고, 화학적으로 유효한 분자 구조로 직접 변환할 수도 없다. 따라서 DRUG-GAN이 생성한 지문은 ChEMBL, ZINC 등 데이터베이스와의 유사성 매칭을 추가로 수행해야 실제 후보 화합물을 얻을 수 있다.
모델 아키텍처 관점에서 연구자들은 판별기를 구축하기 위해 심층 합성곱 신경망(DCNN)을 사용했으며, LeNet-5, AlexNet, ZFNet, VGGNet 등 네 가지 주요 DCNN 아키텍처를 탐색했다.
다른 발견 목표에 따라 DRUG-GAN은 세 가지 응용 시나리오로 설계되었다.
시나리오 I은 표준 dcGAN을 채택하여 DrugBank의 약물유사성 분자 지문을 실제 샘플로 사용하고, 약물유사성 분자의 특징 분포를 학습한다. 생성기는 랜덤 노이즈에서 시작해 새로운 분자 지문을 생성한 뒤, 유사성 검색을 통해 ZINC 데이터베이스에서 대응하는 화합물을 찾는다. 이 시나리오는 주로 약물유사성 특징을 가진 화학 공간을 탐색하는 데 사용된다.
시나리오 II는 표적 특이성 정보를 추가로 도입하여 조건부 생성적 적대 신경망(cdcGAN)을 채택한다. 모델은 CB2 활성 리간드와 비활성 리간드를 두 유형의 학습 데이터로 사용하여 CB2 활성과 관련된 분자 지문 특징을 학습하고, 이를 통해 CB2 표적 편향성을 가진 지문을 생성한다. 이후 연구자들은 생성된 지문을 쿼리 조건으로 삼아 ChEMBL 및 ZINC 데이터베이스에서 후보 화합물을 검색하며, 편향 없는 약물유사성 분자 탐색에서 표적 지향적 발견으로의 확장을 실현한다.
시나리오 III는 분자 설계의 제어 가능성을 한층 높인다. 연구자들은 생성기에 마스크 레이어(Mask Layer)를 도입했으며, 구체적으로 Lambda 레이어를 통해 사전 정의된 MCS에 해당하는 분자 지문 특징 비트를 고정하여, 생성된 지문이 지정된 구조적 특징을 유지하면서도 다른 특징 비트에는 변화가 허용되도록 한다. 이 방식으로 모델은 CB2 표적 편향성과 특정 골격 특징을 모두 갖춘 화합물 시리즈를 생성할 수 있으며, 히트 화합물 확장 및 이후 리드 화합물 최적화를 지원한다.
후보 화합물 생성 이후, FSGLD는 계층적 계산 스크리닝 프로세스도 구축했다. 먼저 분자 도킹을 통해 후보 분자와 표적 수용체의 결합 상태를 평가하고, 이후 표적 특이적 LRIP 점수 함수를 사용해 스크리닝하며, 이어서 분자 동역학(MD) 시뮬레이션, MM-PBSA 결합 자유 에너지 계산 및 열역학 적분(TI) 계산을 수행한다. 현재 단계의 스크리닝을 통과한 화합물만 다음 단계로 진행할 수 있다. 최종적으로 연구자들은 우선순위가 높은 후보 분자에 대해 실험 검증을 수행하여, 생성, 검색, 계산 스크리닝, 실험 평가로 이어지는 전체 프로세스를 완성한다.
성과: 약리학적 특성이 서로 다른 세 가지 표적 평가에서 모두 우수한 성능
실험자는 세 가지 시나리오를 통해 모델의 성능을 평가했다:
시나리오 I: 약물유사성 화합물 생성
연구자들은 유일성(Uniqueness), 신규성(Novelty), 다양성(Diversity), 유사성(Similarity), 유효성(Validity)의 다섯 가지 차원에서 DRUG-GAN과 이미 발표된 세 가지 생성형 모델—ORGAN, OR(W)GAN, ORGANIC—을 포괄적으로 비교했다.
다음 표와 같이 MACCS FP 공간에서 DRUG-GAN은 기준 모델로 사용된 다른 생성형 모델보다 여러 주요 지표에서 우월했다. 특히 DRUG-GAN의 유일성과 신규성 점수는 모두 1.00으로 만점을 기록했다. 이는 생성된 모든 분자 지문이 서로 다르며, 모두 학습 데이터에 존재하지 않는다는 것을 의미한다. 다양성 점수는 0.73으로 ORGAN(0.77) 및 ORGANIC(0.76)과 유사한 성능을 보였으며, OR(W)GAN(0.63)보다는 높았다. 또한 DRUG-GAN이 생성한 분자 지문과 7002개의 참조 약물 간 평균 유사성은 0.25로 가장 낮았다. 이는 이 모델이 약물유사성 특징을 유지하면서 명확한 구조적 차이를 가진 분자 지문을 생성할 수 있음을 나타낸다.
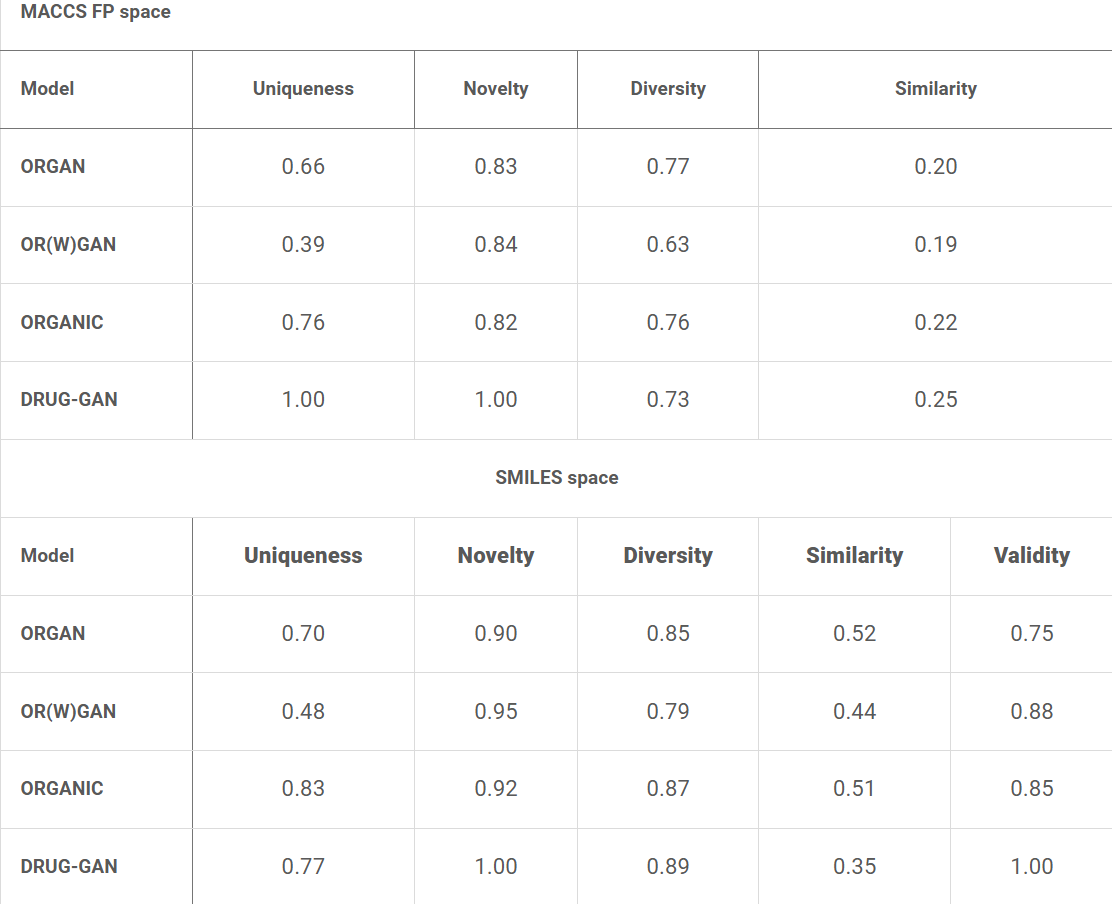
FP 공간 평가 결과와 일치하게, DRUG-GAN은 SMILES 공간에서도 뛰어난 성능을 보였다. DRUG-GAN의 신규성 점수는 여전히 1.00을 유지하여, 디코딩된 모든 분자가 훈련 데이터셋에 나타나지 않았음을 나타낸다. 예상대로, 여러 다른 분자 지문이 동일한 분자 구조로 디코딩될 수 있기 때문에, 그 유일성 점수는 FP 공간의 1.00에서 SMILES 공간의 0.77로 감소했다. 그럼에도 불구하고, DRUG-GAN의 유일성은 ORGAN 및 OR(W)GAN보다 높았으며, ORGANIC보다 약간 낮았다. 동시에 DRUG-GAN은 0.89의 점수로 높은 다양성을 유지했으며, 생성된 분자와 참조 약물 간 유사성은 상대적으로 낮아 0.35의 점수를 기록했다. 이는 화학적 타당성을 희생하지 않으면서 화학 공간을 확장한다는 이 모델의 설계 목표와 일치한다.
이러한 결과를 보다 면밀히 평가하기 위해, 연구자들은 미국 식품의약국(FDA)이 승인한 2,252개 약물을 분석했으며, 이들의 분자량(MW) 범위는 100~1000 Da였다. 승인된 약물들의 평균 분자량(MW), 지질/물 분배 계수(logP) 및 위상별 극성 표면적(TPSA)은 각각 358.0 Da, 2.8, 89.3 Ų이었다. DRUG-GAN이 검색한 분자들은 이와 유사한 약물유사성 특성을 보였으며, 평균 분자량은 382.9 Da, 평균 logP는 2.0, 평균 TPSA는 76.0 Ų이었다.这些数据表明,FDA가 승인한 약물과 비교할 때, DRUG-GAN이 검색한 분자들은 전체적으로 분자량이 약간 더 크지만 극성은 상대적으로 낮아 잠재적으로 유리한 물리화학적 특성을 나타낸다.
시나리오 II: 표적 특이적 화합물 생성
약물유사성 후보 화합물 생성 외에도, DRUG-GAN은 표적 특이적 화합물을 생성할 수 있는 능력을 갖추고 있다. 이 능력을 입증하기 위해 연구자들은 카나비노이드 수용체 2(CB2)를 예로 들어 연구를 수행했다.
생성된 분자 지문과의 유사성이 85% 이상(TS ≥ 0.85)인 186개의 ChEMBL 화합물 중 169개의 분자량(MW)은 100~500 Da 사이에 있었으며, 그중 104개 화합물은 생체활성 실험에서 CB2 활성을 갖는 리간드로 보고되었다. 이들의 억제 상수(Ki)는 10 μM 미만이었다. 검색된 화합물에서 낮은 Ki 값을 가진 분자의 집적은, DRUG-GAN이 생성한 분자 지문 쿼리가 목표 표적과 관련된 생체활성 데이터베이스로부터 CB2 활성이 알려진 화학 구조 유형을 효과적으로 검색할 수 있음을 나타낸다. 또한 연구자들은 ZINC 데이터베이스에서 DRUG-GAN이 생성한 분자 지문 쿼리와의 TS가 모두 0.85 이상인 161개의 화합물을 검색했다.
이후 연구자들은 검색된 화합물들을 CB1 및 CB2 수용체와 각각 분자 도킹하여 결합 친화력을 예측했으며, 그 결과는 아래 그림과 같다:
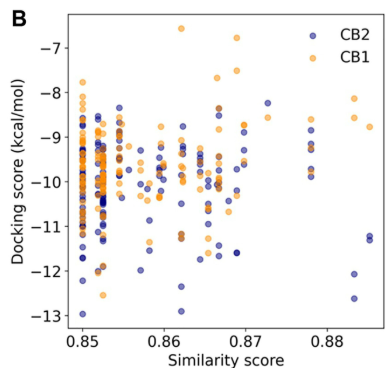
전반적으로, DRUG-GAN이 생성한 분자 지문 쿼리로 검색된 화합물들은 CB2에 대해 비교적 우수한 예측 결합 능력을 보였다. CB2 수용체와의 분자 도킹 점수 평균은 −10.10 kcal/mol로, 시나리오 I의 판별기 훈련에 사용된 미끼 분자의 평균값 −8.29 kcal/mol보다 우수했다. 각 검색된 화합물의 도킹 점수를 짝지어 비교한 결과, 연구자들은 이러한 화합물들이 전반적으로 CB2에 대한 결합 선호성을 보이며, 상당수의 화합물이 CB1보다 CB2에 대해 더 우수한 예측 결합 능력을 나타낸다는 사실을 추가로 확인했다.
시나리오 III: 표적 특이적 계열 화합물 생성
시나리오 III에서 연구자들은 세 개의 사전 정의된 MCS를 생성기에 도입하여, 마스크층을 통해 특정 골격 제약을 갖는 CB2 후보 화합물을 생성했다.
MCS i: 퀴놀린 디온 핵심 구조
MCS i에 대해 연구자들은 ChEMBL 데이터베이스에서 사전 정의된 부분 구조를 포함하고 생성된 분자 지문 쿼리와의 TS가 0.75 이상인 49개의 화합물을 검색 및 확인했다. 아래 그림에서, 7개의 화합물은 이미 높은 CB2 활성(Ki 10 μM 미만)을 보이는 것으로 보고되었다.
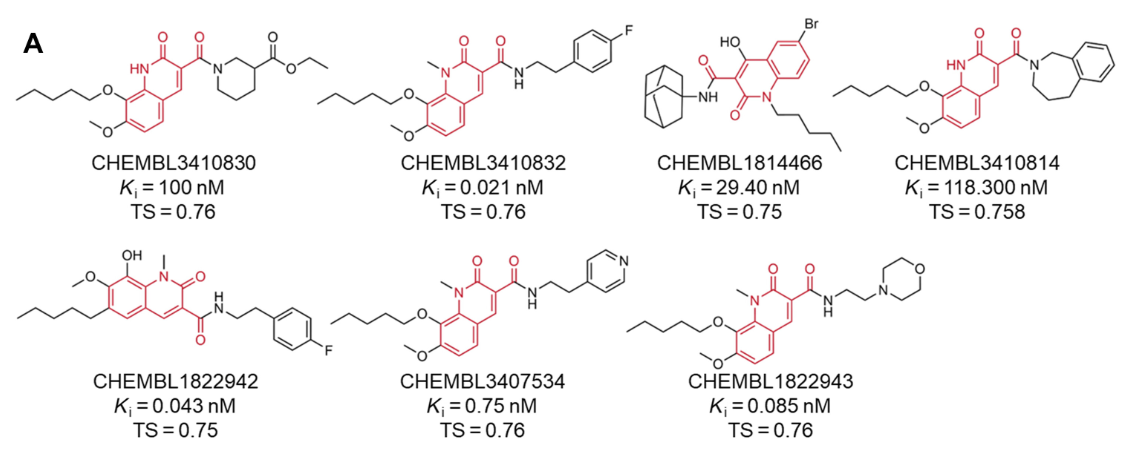
ZINC 데이터베이스에서는 연구자들이 MCS i 부분 구조를 포함하고 TS가 0.75 이상인 32개의 화합물을 검색 및 확인했으며, 일부 대표적인 후보 화합물과 이에 해당하는 TS 값은 아래 그림과 같다:
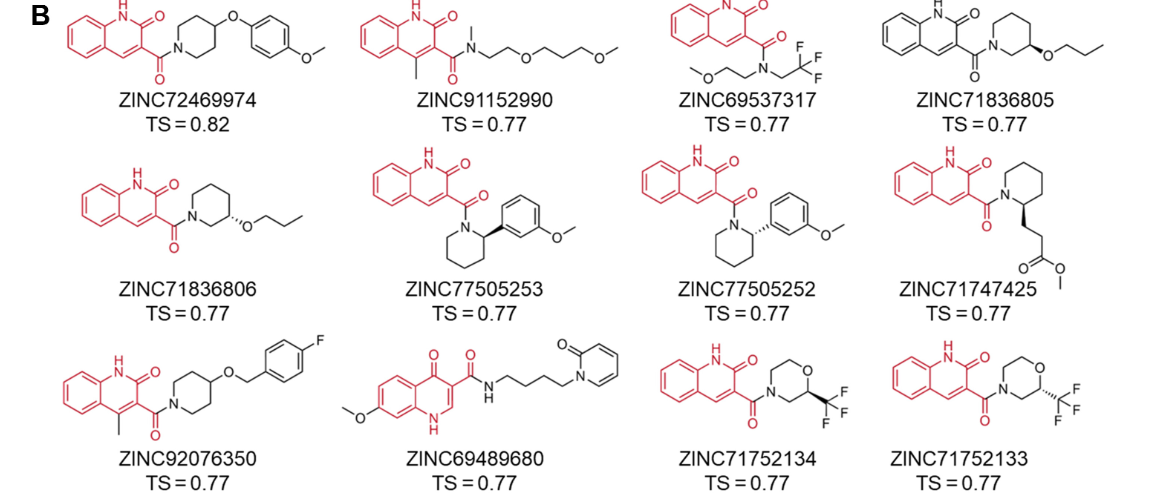
이 후보 화합물 대부분은 CB2에 대한 예측 분자 도킹 점수가 CB1에 대한 도킹 점수보다 우수했으며, 이는 분자 도킹 기반 후보 화합물 우선순위 평가에서 CB2 결합 선호성을 가질 수 있음을 시사한다.
MCS ii: 인돌 카복사미드 핵심 구조
MCS ii에 대해 연구자들은 ChEMBL 데이터베이스에서 사전 정의된 부분 구조를 포함하고 생성된 분자 지문 쿼리와의 TS가 ≥ 0.80인 24개의 화합물을 검색하고 확인했습니다. 이 중 8개의 화합물은 강한 CB2 결합 친화력을 보였으며(아래 그림), 골격 제약형 DRUG-GAN 전략이 CB2와 관련된 화학 구조 유형을 효과적으로 검색할 수 있음을 추가로 입증했습니다.
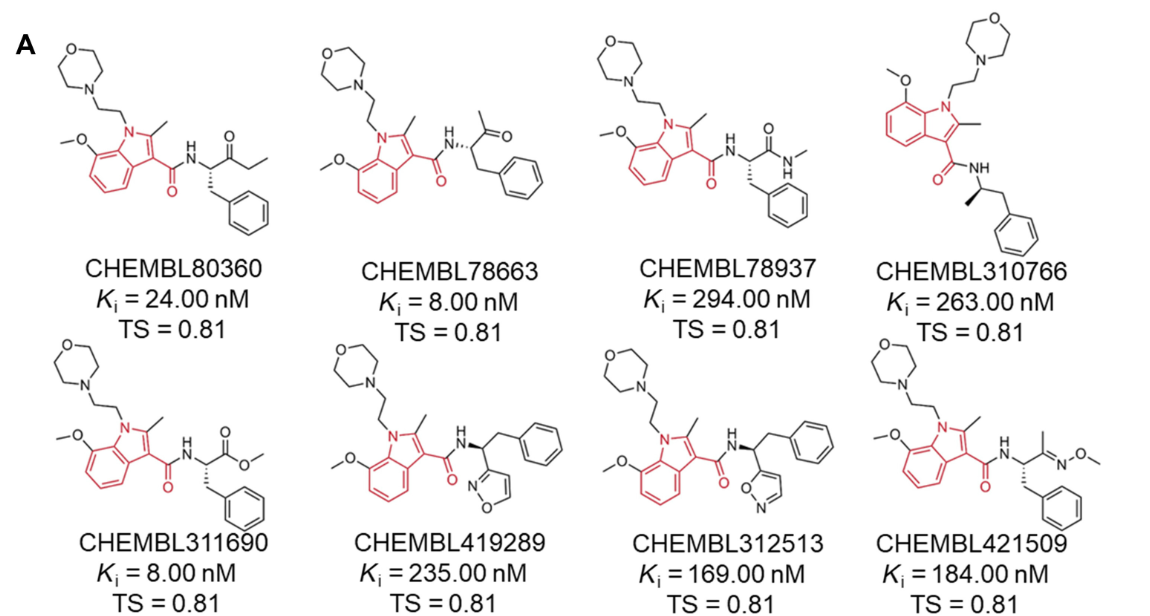
ZINC 데이터베이스에서는 MCS ii 부분 구조를 포함하고 TS ≥ 0.80인 9개의 화합물이 발견되었습니다(아래 그림). MCS i 후보 화합물과 마찬가지로, 이들 화합물 중 대부분은 CB2에 대한 예측 분자 도킹 점수가 CB1에 대한 도킹 점수보다 우수하여, CB2 표적 스크리닝을 추가로 진행할 잠재력이 있음을 시사합니다.
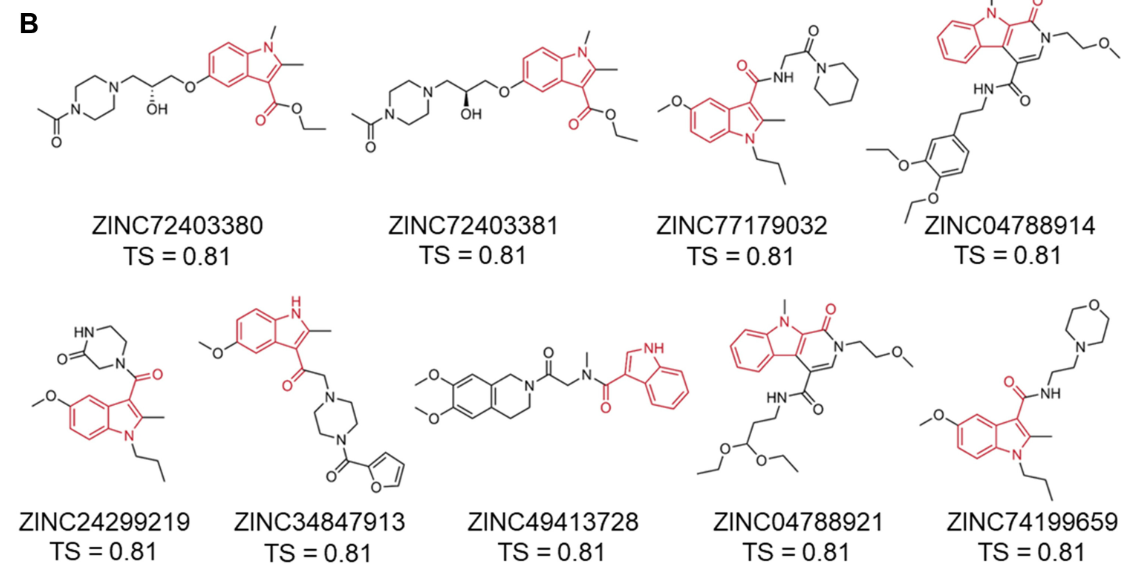
MCS iii: 인돌 술폰아마이드 골격
MCS iii에 대해 연구자들은 처음에 TS ≥ 0.75 조건에서 ChEMBL 데이터베이스에서 165개의 화합물을 검색했습니다. 그러나 FP2 분자 지문 분석을 통해 최종적으로 MCS iii 부분 구조와 완전히 일치하는 화합물은 단 2개만 확인되었습니다(아래 그림).
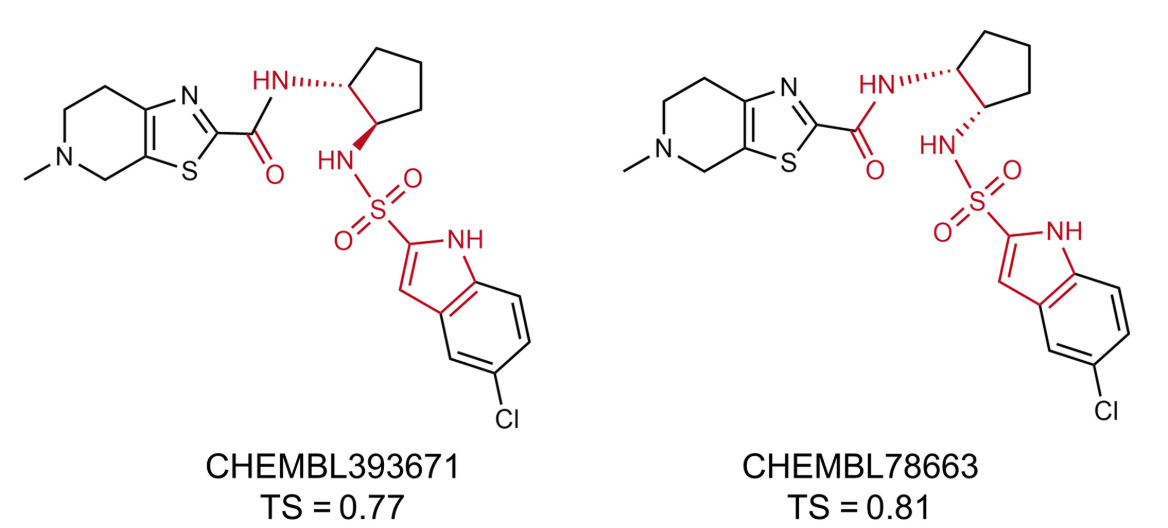
또한 ZINC 데이터베이스에서는 TS ≥ 0.75인 검색된 모든 화합물이 검증을 통과하지 못했으며, MCS iii 부분 구조와 완전히 일치하는 화합물은 확인되지 않았습니다.
종합 결과는 골격 제약형 DRUG-GAN 전략이 CB2와 관련된 화학 구조적 특성을 유지하는 동시에, 확장 탐색 리간드가 대표하는 화학적 공간을 넓혀 구조적으로 차별화된 새로운 후보 화합물을 발견할 수 있음을 보여줍니다.
결론
잠재력 있는 후보 화합물을 우선적으로 스크리닝하기 위해 FSGLD는 검색된 화합물을 평가하기 위해 분자 도킹, 표적 특이적 LRIP 점수, 분자 역학(MD) 시뮬레이션, MM-PBSA 결합 자유 에너지 계산 및 열역학 적분 계산을 포함하는 계층적 워크플로를 사용하며, 일부 후보 화합물에 대해서는 실험적 검증을 수행합니다. 이러한 보완적 방법들을 하나의 통합 워크플로로 결합함으로써 FSGLD는 후보 리드 화합물을 우선적으로 스크리닝하고 후속 실험 평가를 위한 근거를 제공하는 데 유용한 연구 프레임워크를 구축했습니다.
단백질 구조 예측 및 공동 접힘 방법이 계속 발전함에 따라, 연구자들은 FSGLD 프레임워크의 정확성, 견고성 및 적용 범위도 이에 따라 향상될 것으로 예상합니다. 향후 연구에서는 이온 채널과 핵 수용체 등 더 넓은 표적 패밀리에 대해 DRUG-GAN과 FSGLD를 추가로 평가하고, 데이터가 제한된 상황에서 모델의 성능을 더욱 향상시키기 위해 첨단 소표본 학습 및 소규모 데이터셋 학습 전략을 도입할 것입니다.
참고 문헌: